
Хабр Курсы для всех
РЕКЛАМА
Большая витрина: от крупнейших школ до частных авторов. Сравнивайте по цене, длительности, формату и выбирайте самый подходящий курс!

и какие задачи или проекты вы реализовали на таком сетапе?

Пет проекты с нуля на раз два делает и быстро. Например Rust сервер который по REST API предоставляет доступ к Key-Value Кешу в RAM

Апи над квкешем - это поделка даже не уровня джуна а лабы студента. Какие проекты, которые приносят пользу и решают реальную задачу/проблему или может даже деньги приносят вы таким образом сделали?
Это мой стандартный smoke тест для ИИ агента на локальном GPU )
ну ок, а что реального то сделано? смок тест както не про реальную проблему
Какие-то публичные тексты я не запускал. Проверял на нескольких своих разных скилах, проекта, идеях. Работает более мене. Раньше (предыдущие попытки в течении нескольких месяцев) вообще не работало ничего, либо сильно медленно - либо вообще в бесконечные циклы входило.

Вы так и не ответили на вопрос. Речь не о публичности тестов, а о реальном выхлопе.
Ну, показали вы, что модель работает шустро, а что именно создано?
Пока что не создавал. Просто запустил Proof of concept. Из моих ответов это вроде видно.

Тогда стоит убрать упоминание о "полноценном кодинг агенте" из заголовка

Ну справедливости ради, 99% программистов и без ИИ ничего не покажут, какие проекты они написали приносящие пользу

Причем тут проекты с деньгами, к чему этот комментарий глупый вообще? Это типа тейк что нейронка ничего не может накодить стоящего? Приносят деньги и сложность проекта - вещи никак не коррелирующие, не говоря уже о пользе для конкретного человека, кому llm сильно упрощает жизнь при решении множества мелких и не очень задач.
это коммент для тех кто читает статью и думает, что ну вот то теперь можно засетапить себе "полноценный кодинг-агент" за три копейки и начать пилить проекты на нем. Среди читающих думаю и всякие эффективные менеджеры, которым было бы неплохо узнать что от этого пользы проектам околонуля.

Это скорее тейк про то что кулибины из LocalLlama (как и автор статьи) занимаются хобби ради него самого, а не для дела. Пока. Может через годик это поменяется, но вряд ли раньше

На работе потребляю около 100 миллионов токенов за 1 рабочий день. QWEN не использую - наивная шибко. Переделывать много. Нужно GLM 5.3 Flash

Glm 5.3 flash очень хорош, недавно делал небольшого ботика который слушает стрим и публикует ссылки на играющие песни в тг канал, отлично все развернул на моем проксмоксе, по сути я выдал ssh и заполнил .env

Или даже готовить спеки на полноценной 5.3, а уже имплементация на 5.3 Flash.
Все-таки для сложных неочевидных даже мне взаимосвязей 5.3 Flash частенько не хватает. А вот по готовой спеке - милое дело.

QWEN не использую - наивная шибко. Переделывать много.
Про которую Qwen речь? Про qwen-3.8-flash-next?
Как я понял у вас есть сомнения в качестве такого ИИ агента. Тогда можно поднять его уровень.
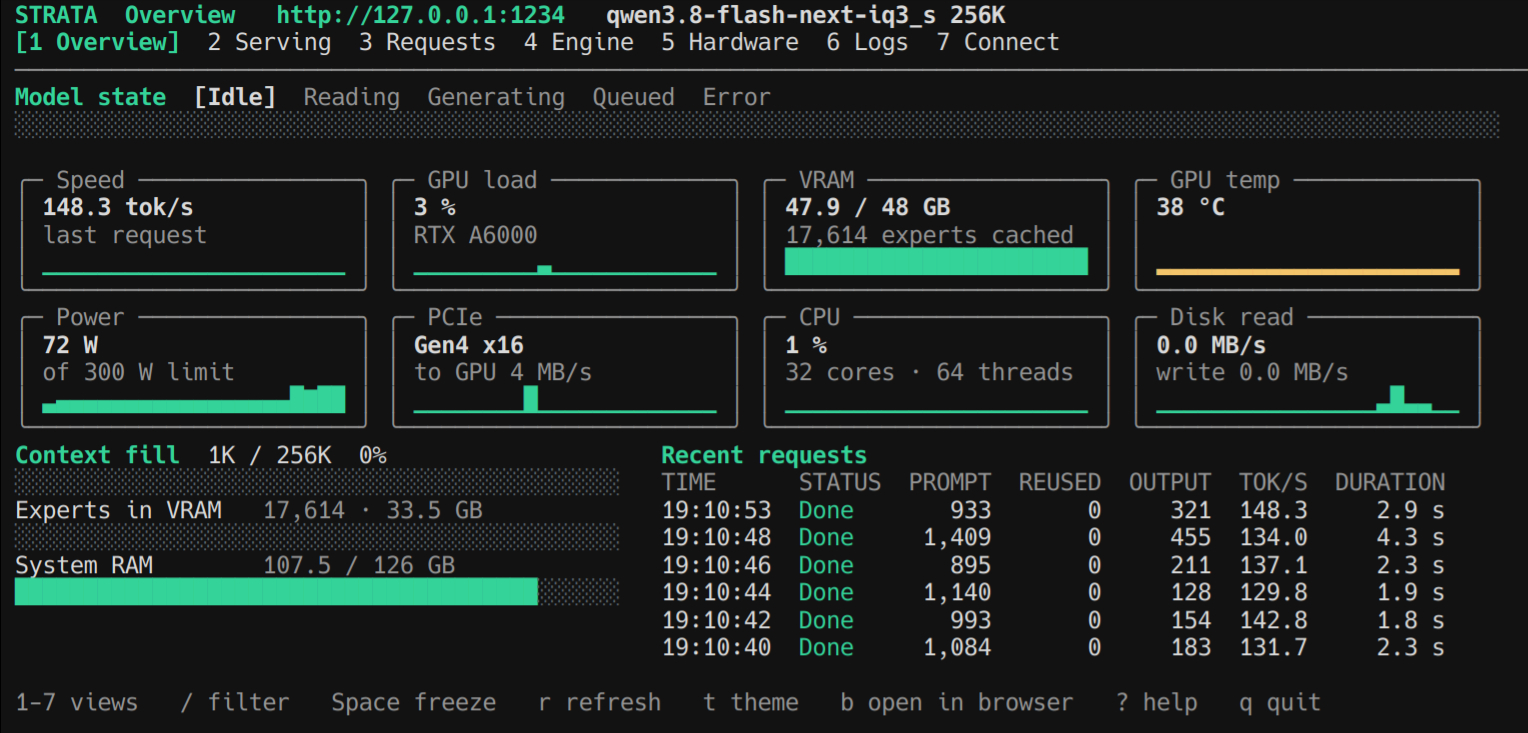
Вы можете через Strata взять Qwen 3.8 Flash Next 125B (рекомендую резонинг ставить LOW или MEDIUM иначе будет в 2-3 раза дольше обрабатывать задачу) в квантовании IQ3_S с контекстным окном 128К и запустить её на видеокарте с 16 ГБ VRAM. В видеопамять попадут наиболее активные слои, а все менее активное будет выгружено в RAM и на SSD. Я сам вчера запускал такую конфигурацию, выдаёт около 60 токенов в секунду. При этом модель такого класса уже сопоставима с GPT Luna 6. То есть просто замените в моей статье модель на Qwen 3.8 Flash Next 125B и получите сопоставимое качество работы кодинг-агента с Codex + Luna 6 Max. Вот ниже пруфы:
И кстати я потом поднял контекст до 256КБ и ризонинг ставил максимальный - ощутимо качество решение задач выросло скорость генерации инференса не изменилась! Понятно что субъективно про качество. Но всеже предлагаю каждому попробовать и оценить свои собственные ощущения и оценить результаты.

я прочитал статью и зашёл в комменты, чтобы про Strata написать :)

Так вот со Strata и надо было начать, а то они не понмают что это за новый движ: чего ты не 48 гб юзаешь vram, а 16 ?о_О, начинать всегда надо хоть с минимальной базы, а дальше уже свой кейс описывать.

Для страта ризонинг ниже xhigh это антипатерн.

У меня 512К в Strata, и то в притык хватает на пару багофиксов одного экрана ;) С аналогичной моделью на RTX3090 скорость 25-30 токенов / с.
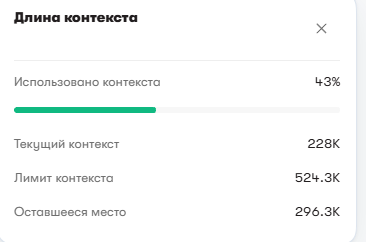

попробуйте формат nvfp4 на vllm, он дает ощутимый прирост, но условия спартанские
до этого был на llamcpp
tensorrt не осилил :)

Вообще как думаете (я уже наверное всех достал этим вопросом), имеет смысл сейчас покупать RTX 5060 Ti 16Gb или просто тупо подождать несколько лет когда все нормализуется и возможно за ту же цену можно будет купить карту с большим количеством памяти или отдельное APU устройство, чтобы уже без танцев с бубнами? При условии что ни для каких целей кроме "поиграться" мне это не нужно, да и "поиграться" вполне можно используя бесплатный дипсик?
Преимущества - автономность, чувство причастности к "настоящим айтишникам" (забавно), возможность делать на карте то, что на онлайн моделях делать запрещено; недостатки - цена самой карты и необходимость танцев с бубнами из-за ограничений объема памяти, на 16 гигах модель наверное (?) будет в среднем глупее чем на бесплатном чатботе.
И еще отдельная мысль про агентов. Собственно я никогда не пробовал ими пользоваться, но представил что я хочу, как лично мне было бы удобнее - и понял, что это должна быть некая среда разработки, где ИИ сначала предлагает аннотированные изменения, я вижу их в неком диффе (буквально старый код слева, новый справа, с комментариями ИИ что это и зачем), и там я могу попробовать скомпилировать новое без удаления старого, что-то принять, что-то отклонить, по чему-то попросить точечно откорректировать, и только когда мне всё понравится - принять измененную версию за основную. Преимущества - я буду знать что происходит в коде:)

Чтобы "поиграться" можно взять карты AMD AI или Intel ARC
А они по цене почти такие же.
AMD на 32 Гб примерно 60% от NVidia такого же объема. Про 16 я не подумал, да, там разница не такая уж чтобы большая

AMD AI дадут вам 128 гб видеопамяти (пусть и не такой быстрой как в видеокартах) когда сборка из видеокарт за те же деньги максимум 32гб
Эта штука стоит около 350т.р. Да, я думал о такой, но для "поиграться" дороговато:(

А толку? Если все эти 128 заполнить, то там скорость будет 0.8 токена в секунду.
в реальности все не так плохо
по цифрам разрыв может достигать х8 в сравнении с топовыми видеокартами, но на практике я максимум х4 замечал в процессе работы
как по мне это допустимая цена учитывая что места достаточно что бы запустить реально серьезную модель для работы и еще осталось место под кеш который действительно проводит черту между разовыми запусками и полноценными кодовыми агентами
20-50 т/с хватает с головой для работы, размер контекста гораздо сильнее чувствуется на реальных задачах чем более медленная работа (к слову с видеокартами kv-кеш зачастую в ОЗУ из-за чего фактическая скорость работы все же ниже при запуске реальных кодовых агентов с субагентами и тд)
8х от 0.8 будет 6.4 а не 64. Никто не спорит, что на 30-50 жить можно, вот только этот AMD AI столько не выдаст с полной утилизацией 128Гб, даже близко.
меньше слушайте тех кто даже не держал такое железо в руках
я владелец AMD RYSEN AI на 128гб и цифры выше это реальность причем на топовых локальных моделях под 90гб, всякие коротыши на 10-16гб разгоняют до 120 т/с с квантом q6

я где-то читал, что квантование выше q4 сильно сказывается на качестве выдаваемых ответов. так ли это?
разница меж q4 и q6 заметна
разница между q6 и q8 практически незаметна
к слову разница между q2 и q4 небо и земля, полноценные кодовые агенты нужно строить минимум на q4, хотя если нужна "аварийная википедия" например то q2 допустимо (запуск на том же телефоне) но один хрен нужно хотя-бы примерно разбираться в теме а не бездумно верить тому что возвращает q2

deepseek свои модели уже выкладывает в нативных fp4+fp8 (fp4 до 96% модели) + fp8 engram. Наверно скоро станет стандартом, и всем этим многообразиям квантования придет логичный конец.

На strix halo 128гб можно запускать qwen3.8-flash-next. С префилом 1.8к т/с и декодом до 60-90 т/с в зависимости от задачи. При этом возможно разместить в памяти 524тыс. токенов под контекст, что хватает на 2-4 параллельных сессий. Очень хороший движок под это дело https://github.com/peonist-ai/halogen-flash-server

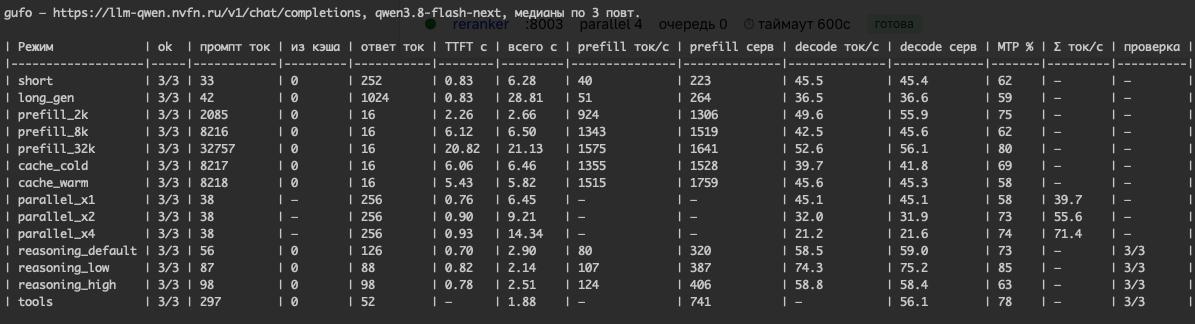

там выше в треде писали именно про AMD RADEON AI на 32 гига, если я правильно понял, а не про мини-ПК на процессорах Ryzen AI)

Уж лучше арендовать комп на vast.ai чтоб с моделями ИИ поиграться
Там хоть конфигураций много. Это хватит чтобы понять -- для инференса слишком дорогие карты надо, проще подписка пока она дешевая.
Про модель не скажу, но выбирайте по пропускной свободности VRAM, чем она выше тем инференс быстрее будет. Не смотрите на TFLOPS метрику… И если денег не жалко берите 32GB это позволяет более крупные, а значит более умные модели запускать, а если не по средствам, то 16GB.
5060 16gb - это хорошо, но всеравно мало и любая адекватная модель хочет больше. Мой вариант две 5060 уже сильно лучше - Q4 кванты того же qwen3.8 27b уже с нормальным контекстом 200к+ и скоростью под 50-60тпс. Любая одна на 32гб - уже шикарно, но цена неадекватна.
Но все это разбивается об экономику - 5060 16гб сейчас это 65к+ даже на авито и это год опенкодовской сорокабаксовой подписки с нормальными моделями, которые можно просто использовать и не думать а с какими параметрами запустить чтобы сегодня то оно еще лучше отработало, а попробовать ли новый ниференс который вон там на гитхабе вроде как под конкретно мою карточку сделали, а не взять ли вот этот вариант модели один из сотен, но этот вроде говорят лучше - все это дикая срань для тех у кого просто дико большой вагон времени.
Для себя вывел, что это имеет смиысл если у вас либо задача, когда надо молотить чтото несложное без остановки дома и вам никаких лимитов подписак не хватит (было у меня такое), либо вы занимаетесь кишками инференса и ллмками дома (мой текущий вариант) и вам надо иметь доступ к железу прямо здесь и сейчас. Вариант что человек отбитый и занимается неправоправной деятельснотью с помощью расцензуренных моделек опустим.
А про агентов и ваша хотелка видеть код слева и спрва - это называется ветка в гите и диф между ветками

…это год опенкодовской сорокабаксовой подписки с нормальными моделями, которые можно просто использовать и не думать…
Даже немного завидую такому непоколебимо-незамутненному оптимизму умению игнорировать нарастающий гавноворот.
расшифруйте, что именно я игнорирую, а то под "гавноворот" у меня сейчас многовато кандидатов и лишь малая часть из них както связана с ИИ

А что вы предлагаете, не пользоваться дешёвой подпиской сейчас, а вместо этого купить за втридорого видеокарты?
Если пузырь лопнет, то можно ожидать падения цен на железо для локального запуска, так что в данный моменты выглядит так, что выгоднее сидеть на дешёвой подписке до момента пока этот аттракцион невиданной щедрости не закончится. А там и железо глядишь будет сильно более доступно

В целом вы правы, но порой я задумываюсь что сейчас оно доступно, а что будет в будущем не очень понятно. Может и цена начать подниматься и доступ станет меньше, да и какая-нибудь регуляция может начать палки в колеса вставлять. Хз конечно что будет. Возможно перспективнее иметь свою модель.
Если сейчас ваша работа с ллм позволяет получать достаточный профит, чтобы купить свое железо, то почему бы и не прикупить? Но тут вот что подумалось, в связи с увольнениями в IT может статься так что через условный год пользоваться ллмкой может и не получится ввиду смены сферы деятельности или профит от ее использования в локальном исполнении будет ничтожен, надо ли оно будет?
Сейчас собирать хороший сетап под локальный агентный ллм на квен3.8 или брать подписки на топ модели это как выбирать брать ли свою машину или ездить на такси - одно другое не отменяет, и у каждого свои плюсы и минусы. Считайте бюджет и оценивайте профит

человек отбитый и занимается неправоправной деятельснотью
"правоправность деятельности" по мнению людей, регулирующих доступ к фронтирам - нынче понятие ооооочень плавающее

Да подписка это хорошо, но есть нюанс, так у вас остается видеокарта, а подписка дает тыкву и кучку не кому не нужного кода, просто поиграться че-то дороговато выходит.
если подписка дает тыкву, то и локальная карточка не нужна, так как тут будет тыква, но только за кратно больше денег)
Подписка сейчас как раз позволяет с помощью хорошей модели за относительно дешево реализовать чтото, что принесет деньги и позволит уже купить карточку "чтоб была". А то будет как у автора этого поста - получил какието трехзначные тпс на каличной переквантованной модели, но не сделано ни одного реального проекта который бы принес денег на этом сетапе

Простая аналогия. Своя карта - это огород. Хотите - растите тыкву, хотите сорняки, хотите ягоды или картошку. Можно вообще ничего не растить. Подписка - это огород в аренду, при этом владелец ничего кроме тыкв и осоки выращивать не разрешает. А денег хочет постоянно. Такой тренд, однако. Еще и инспектора постоянно набегают, грядки топчут...а нет ли запрещеночки у вас?

...Всё равно не хватит чтобы зиму пережить. А в магазине всегда есть еда, но за деньги.
Личная карточка ни разу не подписка по возможностям.
Сравнивать скорее надо огород и теплицу в аренду (с автоматической регулировкой темпераутры, досветкой и т.п.)
Также своя карта устаревает. У меня вот 3090 24GB - супер же! Но уже несколько раз при экспериментах с NIM контейнерами напарывался на "архитектура не поддерживатеся". На какой-нибудь 4060 - поддерживается, но там памяти меньше.
Да, я ее очень активно использовал, когда StableDiffusion появился. Но чем дальше, тем больше я предпочитаю подписки. А какую-нибудь Gemma4-31B, не говоря уж о более мелких моделях, я и через разные сервисы на халяву поюзаю. На мелкие модели (не хуже, чем вы на своей карте запустите) free tier вполне норм.

Любая локальная модель будет хуже нижнего тира по цене 0.1-0.2$ за лям инпута. По подпискам вообще жир дают сейчас.
Как это и было с бумами майнинга дефицит железок будет преодолен, новые железки будут лучше заточены под нейрозадачи лучше соотношение цена/качество.
Видюха купленная сегодня потеряет в цене за это время.
При текущей скорости развития существует серьезная неопределенность на ближайшие годы годы.

Ну это же не так, за 0.1$ , 0.2$ будут доступны только самые слабые модели. Некоторые локальные очевидно будут не хуже.
OpenAI: GPT-6 Luna In $0.10
Anthropic: Claude Haiku 5.5 In $0.10
DeepSeek: DeepSeek V4.1 Flash 1017 ~0.1-0.2
Z.ai: GLM 5.3 Flash ~0.1-0.2
Последние две открытые модели для запуска требуют несколько сотен гб VRAM.
Как какой нибудь Qwen 3.8 может быть не хуже слабо представляю.
Qwen 3.8 27B - конечно хуже, но он работает на видюхе более мене сносно
Можно через Strata запустит Qwen 3.8 Flash Next 128B - вот он уже вполне на уровне GPT Luna и тд. Там суть в чем - активные слои грузятся в 16GB RAM остальное в RAM и на SSD - у меня выдает приличную скорость инференса
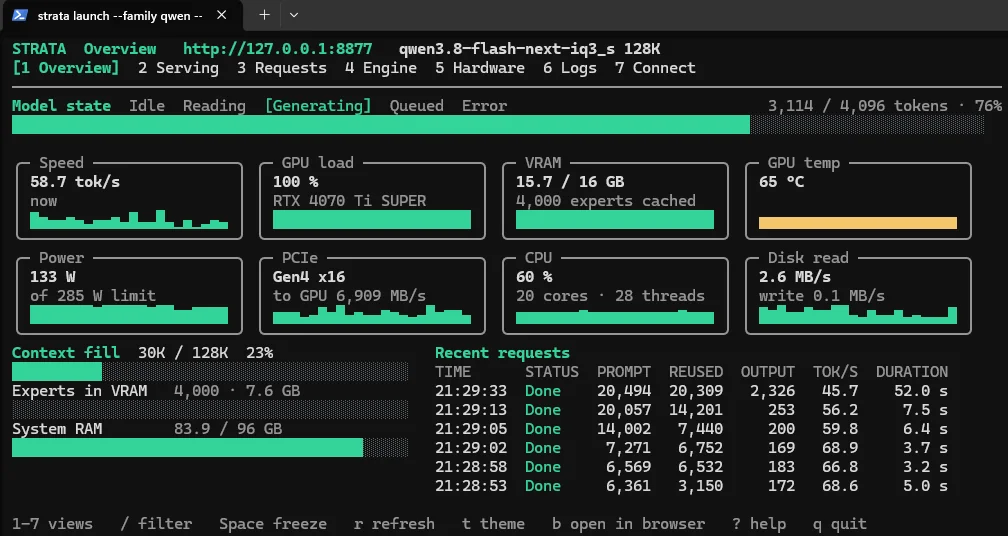
Опечатался в 16 GB VRAM а все что не влезло в RAM и SSD

Тут скорее вопрос адекватности этого вот всего.
Смотрите, со скоростью 59 tps (как на вашем скриншоте) за год непрерывной работы у вас будет ~1.9 млрд токенов (59*60*60*24*365).
На Deepseek flash 4.1 с учетом кеша - это как один раз за пивом сходить. У меня за последний месяц 259 млн токенов на их апи, $7.05.
А чтобы купить железа для запуска того же DS на той же скорости (а офф api китайцев дает сильно больше ваших 59 tps) - нужно очень много денег.
Получается, что локальная модель - это исключительно ради приватности, когда вы не верите никому вокруг.

вы не те цифры сравниваете, ваши 259млн токенов это скорее всего условные 90% кеша, 9% input и 1% decode - собственно эти самые сгенерированные токены, именно их нужно сравнивать по цене (они самые дорогие) и по скорости.
p.s. соотношения кеш/prefill/decode зависят от задачи, бывает 98% кеша, а бывает 80%... а токены генерации обычно это 1-2% от общих
Если считать, непрерывно работающий локальный агент за сутки будет обрабатывать порядка 200-300м токенов, т.е. в сутки экономит порядка $12, вроде бы не много, но за год набегает стоимость сервера на китайских комплектующих

человек отбитый и занимается неправоправной деятельснотью с помощью расцензуренных моделек
Может просто пробует новые идеи и подходы на своих уникальных данных, и не хочет все это сливать Альтману и Амодею

бу 3090 с 24гб
@NeoCode2, имеет смысл сейчас покупать RTX 5060 Ti 16Gb
16гб не имеет смысла покупать от слова совсем.
Адекватная производительность и функционал для агентских задач минимум требует суммарно 32гб хотя бы 2 gpu лучше 1 но это дороже в разы (и это с оговорками, например контекст будет ограничен примерно 190к, терпимо). Любые решения, работающие на меньшем объеме vram - не подходят для агентских задач. Агрессивная квантизация ломает модели, все что меньше 4bit не рекомендую (будут проблемы именно в агентских задачах), помню игрался с какой то моделью с ternary bit (хитрая квантизацияqwen3.6-35b-a3b) так вот она держалась какое то время в агентском окне но все равно ушла в повторы и глюки. это беда всех файнтюнов, они фиксируют модель на простые задачи вопрос-ответ но не на длинные сессии в 100к токенов (а это обязательное требование агентских задач)
Еще, работа агента на cpu не имеет смысла, так как даже если с помощью слабой gpu можно ускорить генерацию (незначительно), prefil (анализ входных токенов) будет неадекватно медленным, в сотню раз медленнее gpu, а это десятки минут и даже часы на то что бы модель просто начала работать по вашей задаче, собрав информацию.
p.s. даже на gpu (потребительских) обычная фаза размышлений qwen3.8-27b - лучшей модели для таких объемов vram, длится 5-8 минут, т.е. вы пишете вопрос, оно думает, получает агент новую информацию - думает и так в любой момент, задачи решаются десятки минут, а сложные - часы).
Если думать только о деньгах - свой gpu сервер для этой модели имеет смысл либо если у вас очень уж личные данные или странные задачи, либо работает этот агент часами в сутки ежедневно.
Если ваши задачи - считанные сотни миллионов в сутки токенов, то лучше купите подписку или api и пользуйтесь условной glm 5.3 flash (или deepseek flash или что хотите, вроде новая kimi flash должна быть дешевой и лучшей), только советую надежных посредников а не мутных со своим эндпоинтом (подсадят трояна незаметно, украдут все что плохо лежит), вроде бы в наших реалиях openrouter наилучший вариант, а если подписка то топайте к opencode zen (они вроде тоже криптовалютой позволяют оплатить и даже vpn не понадобится).

Для агентского программирования -
от 24 (Qwen3.8-27B-UD-Q4_K_XL) например та же 3090 за сравнимые деньги будет сильно лучше.
лучше 32(Q6_K_M),
48 совсем хорошо (Q6_K_XL).
Память добиваем контекстом.
Для чатика любая MoE и карта от 8GB

Qwen3.8-27B-UD-Q6_K_XL с контекстом 80k (с полноценным 16-битным KV-кэшем, без кастрирования) прекрасно влазит в 2 x RTX4060Ti 16GB. При правильный настройках выдает 17 t/s генерации на обычной llama.cpp. Это "базовый минимум".
2 x 24 GB - это уже "роскошный максимум": Q8 + 256k контекста, которые не факт что понадобятся.

Никто не знает будущего, но говорят дальше будет только хуже. Следующее поколение надо ждать минимум года через полтора. По слухам, готовят выпуск RTX 5080 Super с 24Гб VRAM, но цена будет конской, скорее всего.
Как вариант, посмотри на Tesla V100 с 32Гб - дешево и сердито. А так люди вполне нормально запускают LLM на 16Гб VRAM(есть всякие хитрые GCQ-RCO с 3.5 битным квантованием). Если есть много обычной RAM(32, а лучше 64Гб ОЗУ и больше), то можно использовать Strata + Qwen 3.8 flash next 125b. Он будет намного умнее чем Qwen 3.8-27b и моделя из статьи(все-таки 125 миллиардов параметров). Яндекс(Алиса) говорит на 5060Ti выдает около 70 токенов/с.
это должна быть некая среда разработки, где ИИ сначала предлагает аннотированные изменения, я вижу их в неком диффе
Просто ставишь GIT и всё. И там смотришь диффы и прочее.
там я могу попробовать скомпилировать новое без удаления старого, что-то принять, что-то отклонить, по чему-то попросить точечно откорректировать, и только когда мне всё понравится - принять измененную версию за основную.
Это уже прошлый век, сейчас агенты стали настолько продвинутыми, что стали умнее обычных программистов. Просто даешь задачу и идешь гулять, не надо ничего сравнивать. Можно отменить изменения через Git reverse. Главное написать задачу грамотно.
Скачай бесплатный Opencode и можешь вдоволь поиграться с агентами бесплатно, не надо никаких видеокарт. Сейчас там есть бесплатный дипсик.

Да, стоит. А потом уже можно и отдельное устройство для больших моделей, которые сейчас очень дороги. Цена, вероятно, упадет, но самое главное - вы будете понимать как всё это работает и что вам нужно. Например, хватит ли вам скорости в 30 токенов или нет. Сколько нужно памяти и скорость чтения.
Модель будет примерно так же работать - они очень сильно продвинулись. Огромный плюс специализация и возможность подбирать модель под себя. Сейчас появилась moss - она без цензуры, рисует русские слова и рисует блоки по координатам.
Агенты это самая мякотка. Я установил Гермес и то что теперь комп сам себя может настроить это уже очень круто и экономит время и нервы.

Есть надежда на нормализацию и снижения цен на память? Даже не знаю, что должно произойти для этого. Либо ИИ пузырь схлопнется (очень маловероятно) либо в технологиях производства памяти случится какой-то прорыв (еще менее вероятно).

Насытится рынок ДЦ. Рано или поздно это случится
атропики выйдут на ipo, если у них после этого останутся хоть какие то деньги, то все они уйдут в покупку памяти. И всю доступную память они будут скупать, дабы не плодить конкурентов.

Я помню времена когда б/у железо 3090 стоило $5k. И это было относительно недавно.
Так что железо, как ни крути, дешевеет - потому что выходит новое и выпускают его постоянно.
Рано или поздно рынок насытится - потому что деревья не растут вверх вечно.
Для поиграться купите подписку на Клод за 20 долларов. Вам этого с головой хватит на всё.
Всё что на локальных GPU сейчас - это боль, страдания и костыли.
чувство причастности к "настоящим айтишникам"
В сущности ваш вопрос сводится к том - сколько денег вы готовы потратить на это чувство.
Чисто экономически смысла особого нет. Как ни крути, но будет выходить все более мощное железо, а старое будет дешеветь.
За стоимость такого железа можно купить пару лет GLM 5.3 Flash - урезанной версии, которая все равно будет мощнее и быстрее чем такой сетап.

Вы, прямо, проговорили мои мысли за меня! Насчёт "приобщиться к атишникам". И я играюсь агентами прямо сейчас, вторую неделю отлипнуть не могу. Рекомендация от профана: Google Antigravity

Поиграться можно только с 24Gb , все модели которые можно запускать на 16-ти очень глупые, что касается агентов - зарегистрируйтесь бесплатно на z.ai - glm5.3Flash каждый день подкидывает бесплатные лимиты в их десктопном терминале и работает как полноценный агент с песочницей.

Поиграться хватит и Tesla P100 (16GB) / Tesla P40 (24GB) / Tesla V100 (32GB). Стоят на авито от 10 до 60 т.р.
Придётся повозиться с охлаждением, либо искать в корпусе RTX.
P100 выдаёт 20-90 токенов в зависимости от модели, квен 9B работает шустро. Окно 256к достижимо. На V100 можно запускать модели больше и быстрее: https://serverflow.ru/blog/stati/videokarta-nvidia-tesla-v100-32gb-obzor-kharakteristik-i-testirovanie-na-llm-modelyakh/
P и V серии всё ещё актуальны и для ML (cuda 12/13), и для графики (vulkan 1.3), не смотря на то что их поддержка кончилась этим летом.
У меня вот на работе есть 8xH100 и я наблюдаю "горький катаклизм". Полгода назад казалось, что запас немеряный, и тут выходит следующая модель, которая по всем бенчмаркам уделывает текущую, надо бы ее поставить, но ... она не влезает без квантования, а квантование ухудшает качество, так что уже надо просить второй сервер.
Т.е. это постоянная гонка. Через пару лет сегодняшнее железо станет доступнее, но актуальные модели на нем скорее всего будет уже не запустить.
Чем больше модель, тем меньше потери от квантования.
Поэтому не так страшно.
Согласен, надо тестировать, там прирост все же в процентах, если падение качества от квантования будет сравнимо, то может и смысла нет. А если меньше - то есть.
По опыту - все очень сложно. Для агентской работы, где точность инструкций важна, я особенно внимательно при выборе кванта смотрю на последнюю буковку.
Q4_K_S может запросто оказаться хуже для таких задач нежели Q3_K_XL.
Хотя, как правило, все равно лучше взять модельку поменьше (к примеру, 40B вместо 70B) зато менее квантованную.

Qwen3.8-27B-GSQ-RCO-IQ3_S-mtp.gguf у меня на такой же карте выдает 70t/s на пустом контексте. Запускаю в llama.cpp с контекстом 131072.
Это достаточно комфортно и Qwen3.8-27B на мой взгляд значительно превосходят любые модели для локального запуска.
Если что - вот моя конфигурация:
llama-server.exe -m Qwen3.8-27B-GSQ-RCO-IQ3_S-mtp.gguf --n-gpu-layers all --spec-type draft-mtp --spec-draft-n-max 2 --gpu-layers-draft all -c 131072 -ctk q4_0 -ctv q4_0 -ctkd q4_0 -ctvd q4_0 --parallel 1 --flash-attn on --temp 0.6 --top-k 20 --top-p 0.95 --host 0.0.0.0 --port 8080 --reasoning on --fit off --load-mode none --cont-batching --chat-template-kwargs “{“reasoning_effort”:“medium”}”
уточнение: мониторы подключены к встроенной видеокарте, поэтому RTX4070TI SUPER всю память может отдать для llm.

а prefiller модель не пробовали? там у исты есть qwen 3.8 27b prefiller, как будто бв идея что он стримится с ссд только для префилла.
Спасибо, будет время, опробую.

"“{“reasoning_effort”:“medium”}” " на некоторых задачах "low" или даже "off" лучше работает.

Это достаточно комфортно и Qwen3.8-27B на мой взгляд значительно превосходят любые модели для локального запуска.
Вообще, да, но в данном конкретном случае - нет. IQ3_S квант от Strata действительно вышел удачным, по их заявлением такой же по качеству, как оригинал, а оригинал изначально лучше чем Qwen3.8-27B.
Я использую FP8 кванты Qwen3.8-27B, но по первым тестам GSM8K/MMLU/HumanEval могу сказать, что именно этот квант от Strata явно лучше. Как будет на самом деле (в работе) покажет время.
Ну а скорость, небольшая конечно, но вполне терпимо /s

Интересно, сколько из этих 125 t/s потом съедают лишние круги с тестами: даже в динамическом кванте на Q2 модель чаще путает имена и синтаксис. При ~3B активных можно попробовать Q4 (или хотя бы Q3) и вынести часть экспертов в оперативку. В llama.cpp это --n-cpu-moe, в LM Studio есть опция выгрузки весов экспертов на CPU, но она грубее и уносит всех экспертов сразу. Скорость просядет, но для агента это может окупиться. Было бы любопытно увидеть Q2 и Q4 на одной задаче: сколько прогонов тестов уходит в каждом случае.

А какова была цель этого упражнения:
- Экономия?
- Безопасность?
Если вы не сидите в закрытом контуре, работая с закрытой информацией, зачем все это?
Фронтирные модели все равно будут впереди.

А разве экономия и безопасность это мало? В локальную модель можно кидать все что угодно, вплоть до персональных данных, как по мне это уже само по себе весомый довод в их пользу. Понятно, что фронтирные модели впереди - это очевидно, но локальные модели уже могут ОЧЕНЬ многое и если они справляются с моими задачами, то почему бы их не использовать?
Я готовлюсь к апокалипсису ) Собираю автономный набор выживальщика )

Ну это наверное как каршеринг и свой автомобиль!

Запускаю Qwen flash next 170b ISTA-DASLab/Qwen3.8-Flash-Next-GSQ-RCO-GGUF iq3_s (это не тоже самое что iq3, а намного лучше) 90 токенов в секунду на 5080 16 gb vram через Strata(Стриминг с использованием vram + ram + ssd памяти)

Смысла использовать на данный момент что то кроме страты нет. Qwen3.8-FN намного лучше и быстрее и 27b квенов и moe 35b версий.

А оперативки сколько? 64?

Страта с 64 озу вполне нормально летает. С 96 аще огонь
да, но челы запускают это и с меньшим кол-вом озу
запустит то можно, толку то? если она задачи решать не сможет
а так, лучшая из слабых у LiquidAI, у них модельки от 0.45b c vision (примерно 1gb ram), даже может давать какие то ответы, но ни одна их модель даже 24b не подходит для задач терминальных и агентских, даже опасно, они вам снесут фотки по ошибке и скажут ой извините.
Сможет конечно. Я каждый день использую Flash Next для своей работы (бэкенд на Python). А вот как раз модели от каких-то ноунеймов, которые вы советуете, я бы не рекомендовал использовать. Я бы понял и принял ваш тейк, если бы он прозвучал полгода назад - до выхода Qwen3.6 27B(Или qwen fn), - но сейчас он неактуален
Вы серьёзно сравниваете какую то ноунейм микромодель на 0.45b параметров с огромной MOE на 177b (125b + 52b ngram - это доп параметры, которые лежат на ssd)? У меня этот квен в квантовании Q3_XXS GSQ-RCO решал весьма сложные задачи, и не только в написании кода. Например, он делает мне вордовские отчеты по лабам с ГОСТовым форматированием для института, это сложнее кода. Он решил проблему с драйверами АМД на моём компе, которые постоянно вылетали в ошибку. Как и предыдущий комментатор писал, ваше утверждение очень плохо устарело примерно на полгода.
Cyber-Tiel-Coder и Tiel-Coder это хорошие модели, но далеко не лучшие. Мне кажется вы вполне могли бы запускать MOE модельки с контекстом в 200+ если его квантизировать в q8 и возможно уменьшить размер батча. Kак по мне пусть скорость будет ниже, но модель поумнее (квантизация Q2 это совсем грустно, почему не Q4 для 16Gb VRAM?). Ну и искренне советую попробовать Qwen Flash Next на Strata, если у вас есть 64Гб RAM, она точно будет сильно лучше того, что вы сейчас используете.
Охотно верю, но арендовать на vast.ai 64GB GPU за пару баксов в час мне смысла нет.
Так вам 64гб ОЗУ нужно для strata, видеопамяти хватит и 16гб.
У меня обычной RAM 96 GB и 16GB VRAM. Надо попробовать, но если запустить Q2 версию модели у меня, то сколько токенов в секунду будет выдавать? Просто модель очень крупная и квантование до Q2 ее меньше деградирует. Я просто скорость люблю - ждать решение задачи по 30-60 минут не мое. Я привык ждать 1-2 минуты ну максимум 10.

На таком железе порядка 50t/s, более чем комфортно и в чате, и в коде.
Strata
Model qwen3.8-flash-next-iq3_s
Context 262,144 tokens
KV cache 8-bit, streamed: 32,768 positions per layer in VRAM, the rest in RAM
GPU NVIDIA RTX A2000 12GB + NVIDIA RTX A2000 12GB, 24 GB
CPU AMD Ryzen 7 5700G with Radeon Graphics, 16 threads
RAM 63 GB
Проверил! Ребят это бомба
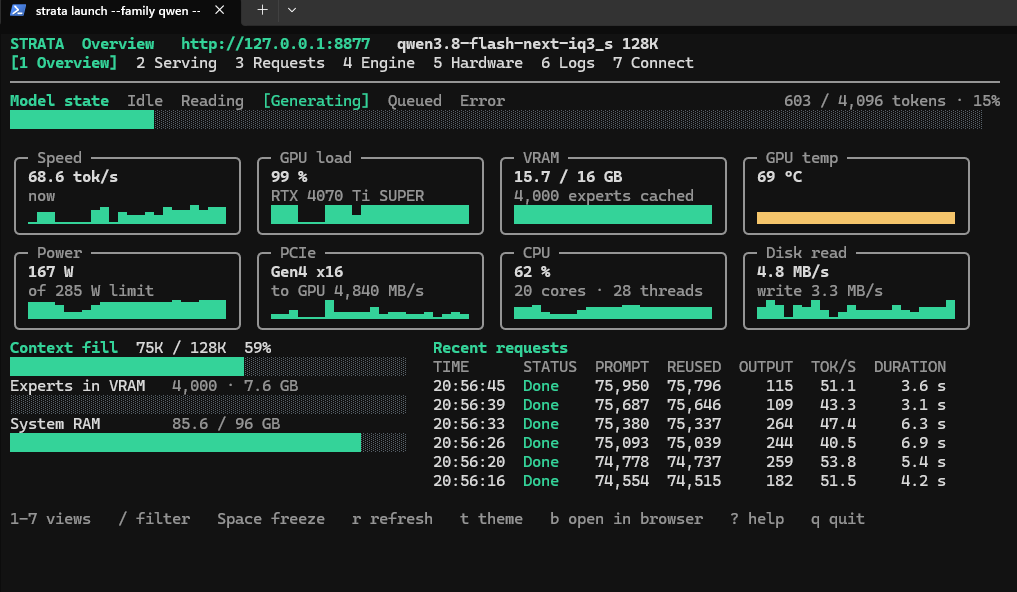
Я в своем сетапе заменю на эту модель и на этот способ запуска - она реально умная модель как OpenAI Luna 6 Max. Это бомба!
До 200к контекст можете поднять в принципе, я разницы в скорости с 128к контекстом не заметил. У меня amd rx7800xt 16gb vram + 64gb ddr4. Скоростя decode примерно такие же, только префил 500t/s вместо 1200+ t/s на нвидии. Если вам не лень, можно статью запилить про страту. А то очень много людей у нас про эту штуку не знают и продолжают плодить статьи про то как они запустили какой нибудь старый qwen3.5 9b на своём компе, и что он почему то кодит хуже чем фронтирная гпт Астра, в итоге называя локальные модели неспособным говном.
Меня в Страте как-то дезориентировало переход в windows на приложение. Питоновскими скриптами было и удобнее, и с нескольких машин можно gui использовать. Нормально всё в json конфигурируется, а монолит этот на контексте выше 32к у меня падает.
В общем не понял прикола, оставил обвязку на питоне и обновляю только engine. Всё работает, скорость на новых движках заметно прибавляется.
Ну я разницы в скорости между win приложением и win терминалом не заметил, у меня также не было с приложением никаких проблем на крупных контекстах 128-200к. На линуксе тоже скорее всего всё то же самое будет. Интерфейс конечно там пока не ахти, прям уродливый. Скорее всего будут его переделывать в будущем, но даже так установка и настройка моделей у меня проходит быстрее и удобнее терминала. В приложение также встроен агент, вроде бы на основе deepseek harness, но по моим тестам он намного лучше оригинального deepseek harness и opencode, примерно на уровне hermes agent (имхо лучший локальный агент), но интерфейс хуже и магазина плагинов пока нет. Я просто подключаю strata приложение к hermes. На картах АМД обязательна ручная донастройка движка, прописывание доп. аргументов в env секцию в json конфиге модели может ускорить префилл в 2 раза и генерацию процентов на 20-30.

Еще одна статья-"Какъя" где автор собрал из вторсырья картинг, а потом из коментов узнал про Strata и что можно гонять на спорткаре даром.
А ей уже месяца полтора как...
Согласен. Каждый варится в своем соку. Поэтому я и пишу - получаю фитбек и на нем развиваюсь. Разве это плохо?
Если цель засветиться на широком ресурсе, то да хорошо. Если принести реальную пользу людям, то хорошо бы сделать ресёч в области самоварения, чтобы не подавать свой компот холодным и прокисшим.
Хотя может из коментов еще кто-то про актуальные супер-движки типа Strata узнает, тоже неплохо...
Да нет особой цели, просто сам копаюсь, пишу, что нарыл. Вы же видите, что я не рекламирую никакие сервисы или телеграм-каналы. Для души, в общем. И как приятный бонус, получаю фидбэк и узнаю, что есть что-то ещё круче, лучше, современнее, востребованнее и вообще маст-хэв. В общем, фан, а как побочный эффект, польза для меня и моего саморазвития.

Если внимательнее взглянуть на статистику Steam, можно увидеть, что видеокарты с 16 и более Гб памяти имеют ~32% пользователей, тогда как 8 Гб и менее ~55%
И цены на 16+ сейчас, прямо скажем, пугающие...

А на Gemma-4-e2b и контексте 8192 вышло бы больше :) А по факту, вы какое то недоразумение сделали, зато скорость токенов большая, прям как в анекдоте про женщину, которая машинисткой на работу устраивалась и говорили, что умеет печатать 300 слов в минуту.
Насколько я понял, для хорошего кодинга нужна максимально доступная модель. Q4 это минимум. У вас есть 96Гб оперативки. Было бы интересно увидеть сравнение Qwen3.8-27B в оперативной памяти с 5 т/с и что угодно быстрое. Что бы понять, насколько выгоднее брать процессор и много памяти, что бы потом не выискивать ошибки в коде. Ну и вообще ревью на код в этих двух вариантах. Спасибо.
Не пробовали модель Ornith 1.5 35B? Ещё лучше - посмотрите её народные apex-оптимизации. У меня на ноутбуке выдает 50 ток/с

Странные комментарии в то время, как на реддите обсуждают и сравнивают движки Strata, Basalt, Infernix и запускают Qwen 3.8 FN 122B на 16Гб Vram и 32 RAM.

Да я тоже откровенно говоря в шоке с таких статей. Думаешь - ну вот хоть что то может быть интересное. А тут чел МОЕ модель на 3б активных параметров запускает. Это так же скучно как колупать собачий кал в песочнице.

Критикуя - предлагай, напишите статью, которая будет по-вашему мнению интересная тогда можно сравнивать, а так вы просто обыкновенный сноб.

Да я бы и просто перевод про реальный опыт настройки и использования подобных моделей на обывательском железе с удовольствием почитал бы.
А то попробовал на днях qwen 3 30b moe, ну, ерунда это. В качестве агента не пойдет, туповата даже с пошаговым подробным промтом, разве что как конфиденциальный чатик для всяких простеньких вопросов еще сойдёт. Как справочник.
модель годовалой давности? Что вы от неё хотите то?
Поставьте страту и пользуйтесь.
Да поставил бы, но у меня 32 gb ram & 8 gb vram. Вроде как для страты такой сетап слабый.
Gyro S запуститься, gyro M наверно будет впритык.
https://www.reddit.com/r/Qwen_AI/comments/1xg89md/qwen_38_flash_next_strata_what_are_your_speeds/
Вот тут скорости на разных конфигах.
У себя на 3060 12 + 32gb ram gyro M в притык выдает 15-20т/с. В интернет лезет, тулзы вызывает. Gyro S показался туповатым.

Для страты смотрите вот сюда - https://www.reddit.com/r/LocalLLaMA/comments/1x5p822/qfn_q_2_strata_configs_for_8gb_vram_and_32gb_ram/
Но я лично поднял квен 3.6 мое на лламе с 128к контекста, конфиг ровно как у вас - 8гб видеопамяти (2070с) и 32гб обычной. Префилл 150-190 т/с, ответы - 15-19 т/с. Да, не сахар, но на лламе это практически максимум что можно выжать.
Могу написать о том как дела обстоят с AMD под Linux и что реально можно сейчас интересного получить на этом, и что на самом деле важно для выбора железа именно под AMD на бытовом железе

По статистике, большинство домашних пользователей использует комп как печатную машинку с браузером, и не тратит 1000 бакинских на отдельную видяху, обходясь встроенной. Вы сильно путаете понятия "домашний пользователь" и "геймер".

По началу из названия статьи я думал что она о чем то интересном (типа Strata оптимизировали для 4070TiS). А оказалось тут банальный запуск 35B-A3B в самых шакальных квантизациях :(((

И вот из каждого утюга кричат эти стандартные рассказы, что нужно взять MOE, MTP, чтобы всё работало быстро. У меня по факту MTP реально ускорение даёт только в режиме чата. Как только запускаю с агентом - скорость сразу в 3 раза падает(без MTP не падает). Тем временем в llama cpp завезли горячий кэш экспертов. И вот он даёт реальное ускорение во всех сценариях. Но в подобных статейках про это почему-то совсем не пишут.

В models.json у обеих моделей contextWindow равен 65536, а maxTokens — 32768. В контракте OpenAI, который в конфиге указан как openai-completions, max_tokens — предел ответа, и сумма входных токенов с этим пределом не должна превышать окно модели. Если сервер соблюдает это правило, на сам запрос остаётся около 32 тысяч токенов, а не 65535. Тогда 10–14 тысяч токенов тяжёлого системного промпта — это уже около трети или почти половины входа, а не 15–20%. Размер plan.md и момент вызова /new лучше считать от этого остатка.

Топ,я тоже такое делал,но для создания проверки качества кода. У меня тоже 4070 Ti Super
Давайте объединим усилия,если это возможно

Стоимость железа и импакт, который оно дает несопоставимо сейчас со стоимостью подписок. В подписках есть бесплатные модели, каждая из которых порядком сильнее тех что можно развернуть на локальном пк за адекватные деньги. Подберите ту, у которой есть инструменты для работы с песочницей на вашем пк, отдельно соберите песочницу и будет вам счастье.

Взгляните в сторону ninfer еще, у меня на 50 серии дает ощутимый прирост , до 30% против llama.cpp , при чем субагенты работают из коробки, я гонял 3х полет нормальный . И это при том , что модель целиком в gpu (еще и 1.5 под мониторы система отжирает).
Пробовал на qwen 3.8 Q4 - полет нормальный, Q6 тоже, но мне большие контексты нужны. До 480К у меня спокойно влазит.
В целом 3.8 27B уже вполне раболчая лошадка, парсеры вот мне пишет без лишних вопросов , как claude "а вам разрешили? а авторские права ... " , к слову безцензурная модель работает веселей в целом. Меньше в раздумьях можно/нельзя. Скорость работы - в пару раз быстрее Opus , по качеству - в целом хорошо , ну для моих задач приемлимо, работает и ладно . Мне для внутреннего контура .
Среди реальных задач вот тестировал, у меня есть много частей проекта ,каждый со своей документацией. Часто приходится будить claude контексты, чтобы просто задать 1 вопрос ... А так я попросил каждый конекст написать краткий прогревочный навигатор , даю его локальной модельке и прошу ответить. Она сама прогревается , отвечает или грепает.
Делал тесты сравнения на разных моделях. Опус по своей же документации сделал навигатор + экзамен на 400 вопросов. Сам ответил и сравнил с тем как экзамен прошла локальная модель. Результат лучший 98% на qwen 3.8 27B , в то время как хайку 5.5 для этой задачи набирает 90% при этом есть раздел "вредные/деструктивные советы" вот у хайку они есть ,а у qwen нету. Т.е. в такой задаче локальный Qwen работает очень качественно и бесплатно считай со скоростью до 150 t/s. Эдакий ленивый rag без заморочек, в реальном времени, по сути. Но в 480К контекста влазит очень немало.
Сделал для llama парковку в бинарник , т.е. я могу задать вопрос с паркованным контекстом, поднимается все до первого ответа с весами за 7 секунд. Это реально очень удобно и полезно.

Тоже стараюсь разделять работу агентов и моделей, отдельно выделяю шаг анализа, который собирает контекст по проекту, что в итого можно изменить и предлагает выбор при необходимости, а уже потом можно запускать агента разработчика с более менее понятными шагами

Движок strata попробовали, но форк polystrata пропустили мимо, а он как раз для мелких моделей 26-35B, с ним qwen 35B q4, а не Q2, выдаст те же 120+ т/с. Также 27b медленно работает, с mtp явно больше 30 т/с должно быть, при этом опять же стоит заморочиться с движком, например bellama бережнее относится к контексту и сохраняет большую точность при k5v4, к тому же он позволяет задать небольшой блок последних Иоаннов контекста в полном качестве f16.

Спасибо, интересный опыт.

Ваш путь интересен, но в нем много ограничений.
Спасибо за мнение, но я выберу подписку за 20$, и топовые фронтир модели в придачу.
Проверил на NVidia RTX 4060 Ti 16ГБ работает 100-125 токенов/с

>> По статистике, среди рядовых пользователей настольных компов самая распространенная видеокарта имеет 16 ГБ видеопамяти.
Что за статистика? По результатам опроса на сайте опросы.ру, 100% жителей России имеют доступ в интернет.
взял 7900 xt 20Gb - хочу попробовать локальный инференс для кодинга, думал о strata но может есть варианты по лучше?

Кстати, сейчас на старом добром Codingame наступил киберпанк – появилась возможность не самому решать задачи, а прикрутить агента. И, кстати, сейчас ещё и контест начинается, где агентам тоже можно и нужно быть.
Вот было б интересно, как далеко локальный агент сможет пройти сквозь толпу клодов.


125 токенов в секунду на RTX 4070 Ti SUPER: как я заставил локальную LLM работать полноценным кодинг-агентом