Представьте: нейросеть почти идеально выучила правильный ответ. Ошибка ещё существует, а градиент по логиту правильного класса уже превратился в машинный ноль. А в другом случае ученик в точности повторяет учителя — и всё равно получает ненулевой сигнал ошибки.
Обе истории связаны с привычными softmax и cross-entropy.
22 октября 2026 года Джонатан Баррон (Jonathan T. Barron), Дэн Гнанапрагасам (Dan Gnanapragasam) и Майкл Тшаннен (Michael Tschannen) из Google DeepMind опубликовали препринт A Fix for Softmax and Cross-Entropy. Авторы разобрали два численных дефекта (в статье они названы Softmax Collapse и Softmax Cancellation) в таких стандартных библиотеках, как PyTorch и JAX, и предложили исправления, сохраняющие исходную математику.
Неужели все нейросети всё это время обучались неправильно? Нет, такой вывод из работы не следует. Но история интересная: иногда для изменения поведения обучения достаточно иначе записать школьную дробь. Давайте посмотрим на числа, графики и код.
По-моему, описанное тут заслуживает места в учебных курсах — рядом с устойчивым вычислением сигмоиды и защитой от переполнения в том же softmax.
Что разберём:
От задачи классификации до градиента: пример с котом и собакой.
Вторая ошибка: ученик совпал с учителем, а градиент остался.
Начнём с задачи: учим модель отличать кота от собаки
Представим себе, что модель распознает фотографии. Например, к ней на вход поступает фотография кота. В обучающей выборке правильный ответ известен: кот.
Модель пока может ошибаться, но мы хотим подобрать её параметры  так, чтобы на таких фотографиях вероятность кота росла, а штраф за ответ уменьшался.
Сначала модель выдаёт два числа — логиты  и
 .
Softmax превращает их в вероятности  и
 , сумма которых равна единице. Затем cross-entropy вычисляет loss, то есть штраф за ответ.
Для нашей фотографии это минус логарифм вероятности кота: чем она ближе к единице, тем меньше штраф.
Дальше идём в обратную сторону.
Находим градиент — вектор частных производных штрафа, который показывает, как штраф меняется при небольшом изменении каждого логита.
Через эти производные и устройство самой модели вычисляем градиенты по её параметрам. По ним оптимизатор обновляет .
Логиты получаются из фотографии и текущих параметров. Но ошибка в производных по логитам может передаться дальше, в обновление параметров.
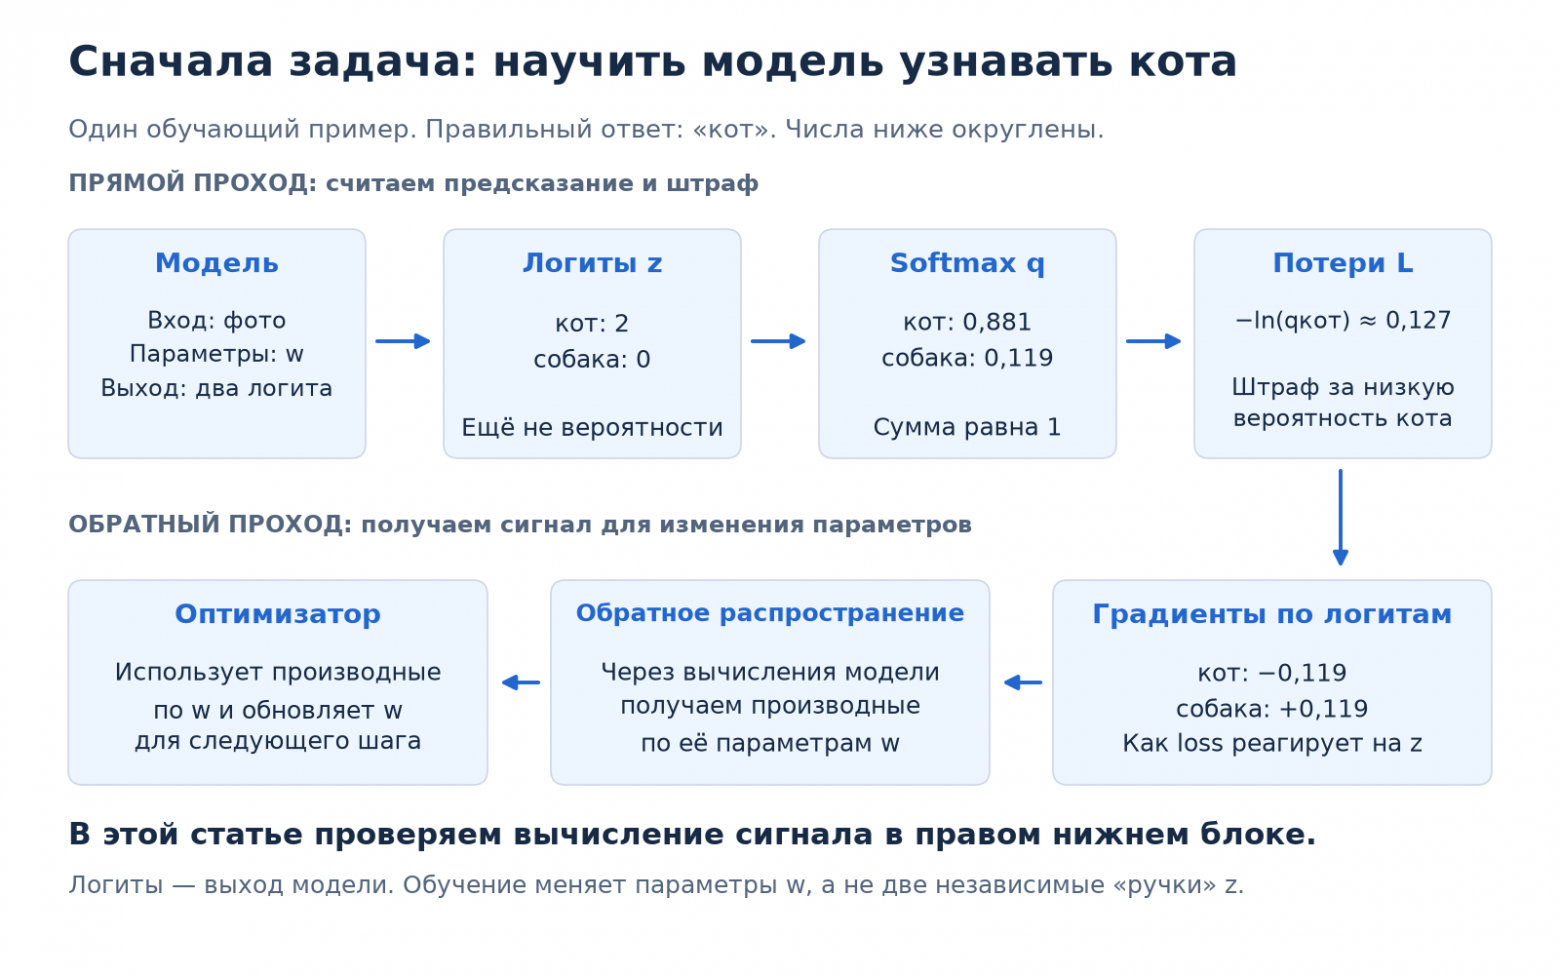
Схема 1. Прямой проход даёт вероятности и штраф. Обратный проход вычисляет производные, по которым оптимизатор меняет параметры модели.
Вот теперь можно поставить вопрос статьи точно: правильно ли компьютер вычисляет эти производные, когда ответ уже очень уверенный?
Для проверки не нужна целая нейросеть. Достаточно остановиться на готовых логитах и сравнить ожидаемый градиент с вычисленным.
Для двух классов получается знакомая сигмоида
Обозначим разницу логитов через  . Вероятность кота выражается через сигмоиду:
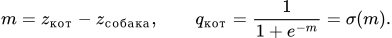
В точной арифметике вторая вероятность — 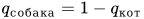 . Если
 , классы равновероятны; чем больше , тем увереннее модель выбирает кота. В бинарной логистической регрессии эта разность выражается через входные признаки и обучаемые коэффициенты. У нейросети до логитов могут стоять сотни слоёв, но последний участок вычислений тот же.
Правильный ответ — кот, поэтому:
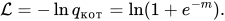
Производная по равна  . Логит кота входит в со знаком плюс, логит собаки — со знаком минус. Отсюда две компоненты градиента по логитам:
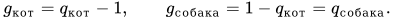
Возьмём пока спокойный пример: логиты [2, 0], то есть  . Получаем вероятности примерно [0,881; 0,119], loss около 0,127 и градиент [−0,119; +0,119].
Знаки имеют простой смысл. Если при прочих равных чуть увеличить логит кота, штраф уменьшится: производная отрицательная. Если увеличить логит собаки, штраф вырастет: производная положительная. При обычном градиентном спуске мы двигаемся против градиента. Всё ожидаемо, пока никаких численных фокусов.
А где здесь защита от переполнения?
Она решает другую задачу. Например, логиты [1020, 1000] имеют ту же разность 20, что и [20, 0]. Но попытка напрямую посчитать  и
 переполнит
float32: вместо конечных чисел получим бесконечности, а при нормировке — NaN.
Известный приём — вычесть из всех логитов максимум до вычисления экспонент. Из [1020, 1000] получится [0, −20], а экспоненты будут равны 1 и примерно 2,06·10⁻⁹. Обе прекрасно помещаются в float32.
Почему это можно делать? Мы делим все экспоненты на один и тот же множитель. Доли в общей сумме от этого не меняются. Для двух классов:
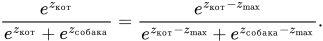
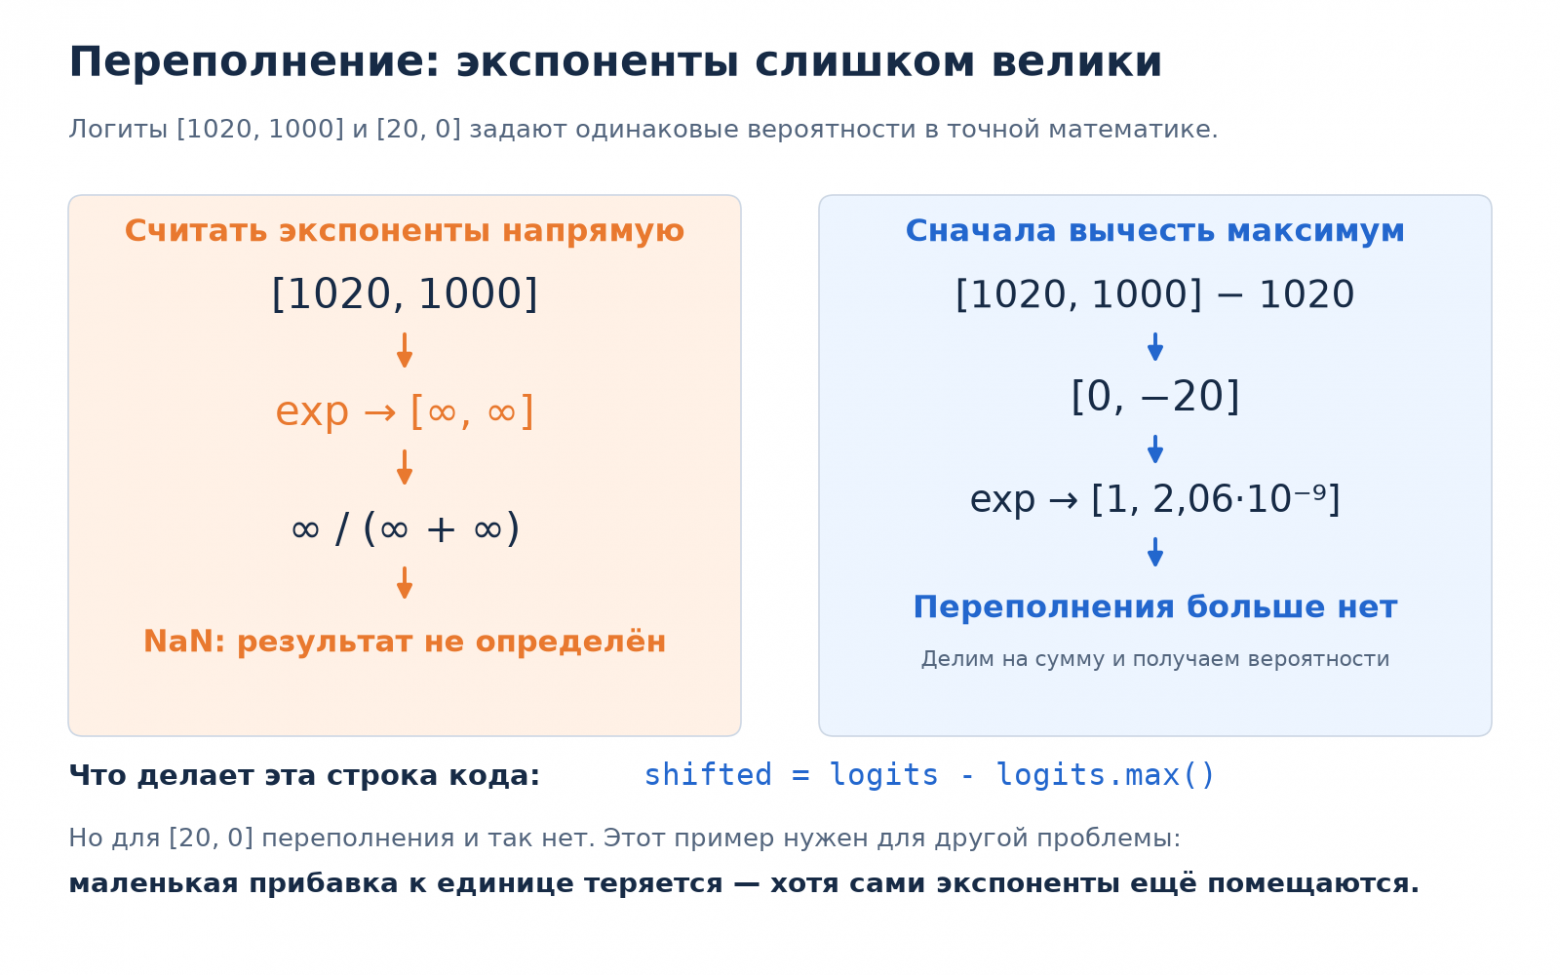
Схема 2. Сдвиг [1020, 1000] → [0, −20] сохраняет вероятности и позволяет вычислить экспоненты без переполнения.
Общую сторону вопроса уже разбирали на Хабре в статье «Откуда в обучении берётся nan: численная нестабильность в ML и почему всё считают в логарифмах» в блоге OTUS. Там речь о переполнениях, NaN и вычислениях в логарифмах.
В примере [20, 0] переполнения вообще нет: даже  помещается в
float32. Мы всё равно используем стандартную защиту с вычитанием максимума. Но она не спасает от следующей проблемы — потери маленькой прибавки рядом с единицей.
Первая ошибка: исчезает одна компонента градиента
Теперь модель стала увереннее: логиты [20, 0], правильный ответ по-прежнему кот. Обозначим маленький относительный вес второго класса через  :
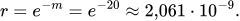
Тогда 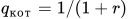 . Это число очень близко к единице, но математически всё ещё меньше неё. Значит, штраф ещё положителен и градиент ещё не равен нулю. Ожидаем две компоненты: примерно [−2,06·10⁻⁹; +2,06·10⁻⁹].
Посмотрим на обычное вычисление первой компоненты:
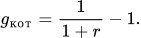
У float32 примерно семь значащих десятичных цифр. Само число хранится без проблем. А вот сумма  округляется до 1: прибавка слишком мала по сравнению с единицей. Дальше получаем
 . Потерялся не диапазон для хранения маленького числа, а его вклад в сумму с большим.
Вероятность собаки softmax вычисляет отдельно, как  . Она остаётся примерно равна , хотя вероятность кота уже округлилась до единицы. Вот откуда эта асимметрия: одна компонента пропала, а другая сохранилась.
Исправление действительно из школьной алгебры. Приводим дроби к общему знаменателю:
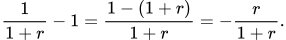
Теперь маленькое число находится в числителе. Даже если знаменатель округлится до единицы, результат останется примерно равен  . Математика та же, машинный результат другой.
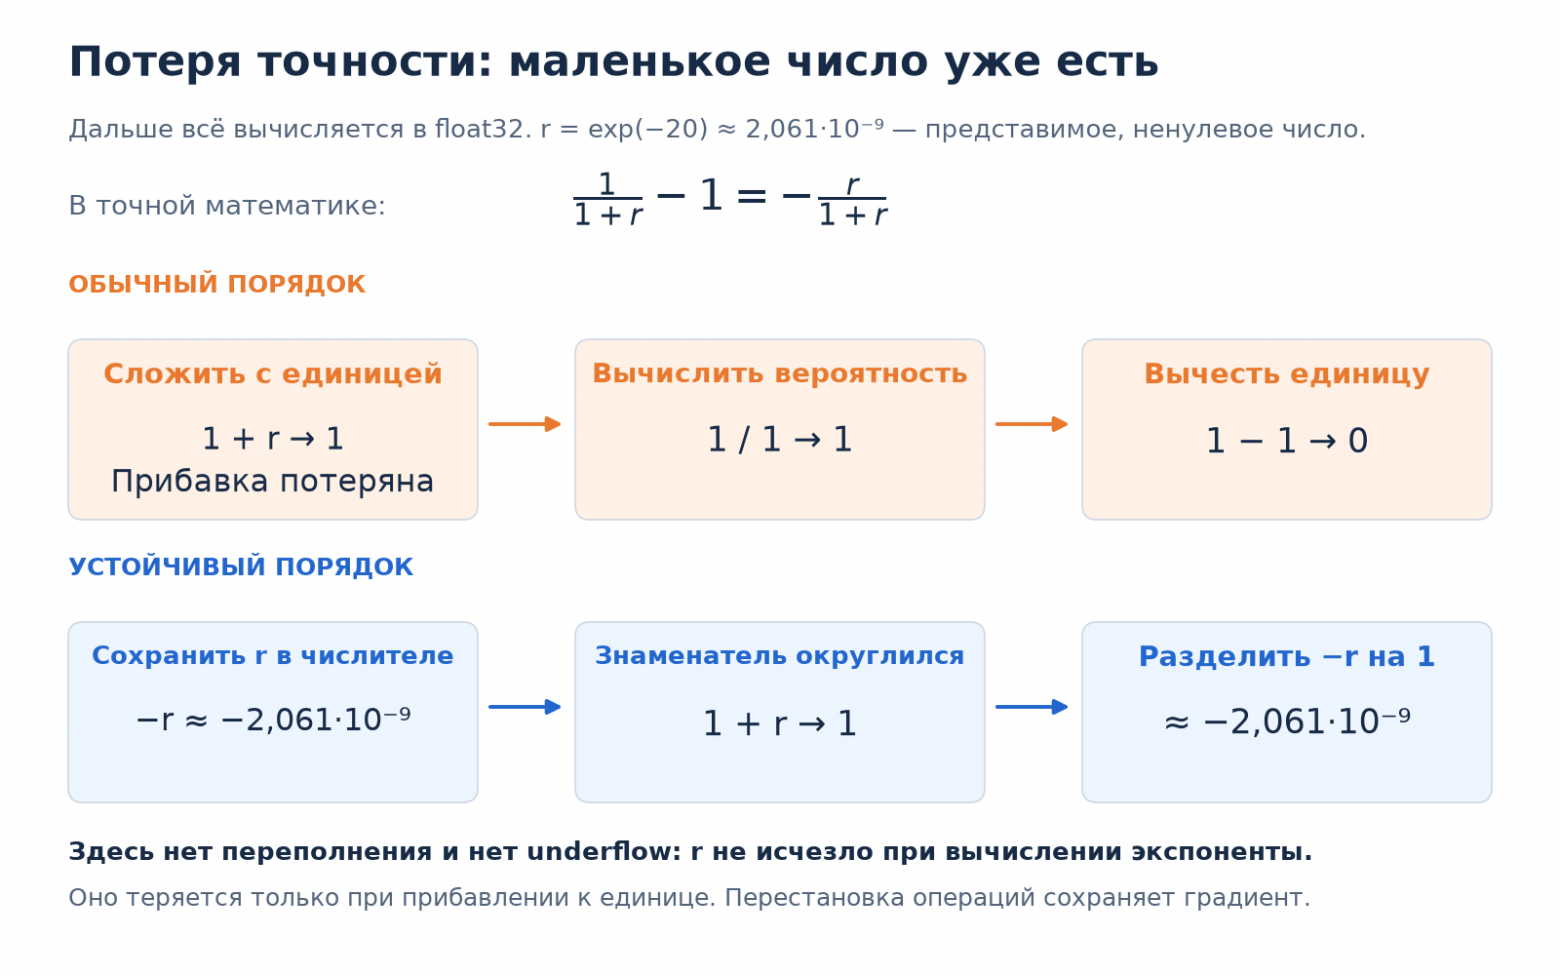
Схема 3. Обычная запись сначала теряет r в сумме 1 + r, затем даёт ноль. Равная ей дробь −r / (1 + r) сохраняет маленькую отрицательную компоненту.
Теперь проверим это на Python
Мы уже знаем, что именно проверяем и какой ответ ожидаем. В коде первый класс — кот, второй — собака; target = 0. Строка shifted = logits - logits.max() — та самая защита от переполнения. Затем считаем softmax и вычитаем единицу из вероятности правильного класса:
import numpy as np

logits = np.array([20.0, 0.0], dtype=np.float32)

# Обычная схема softmax с защитой от переполнения.
shifted = logits - logits.max()
e = np.exp(shifted)
probs = e / e.sum()

# Производные cross-entropy по логитам, target = 0.
grad = probs.copy()
grad[0] -= np.float32(1.0)

print(f"Вероятности: {probs}")
print(f"Градиент:    {grad}")
print(f"Сумма градиентов: {grad.sum():.6e}")
Вероятности: [1.0000000e+00 2.0611537e-09]
Градиент:    [0.0000000e+00 2.0611537e-09]
Сумма градиентов: 2.061154e-09
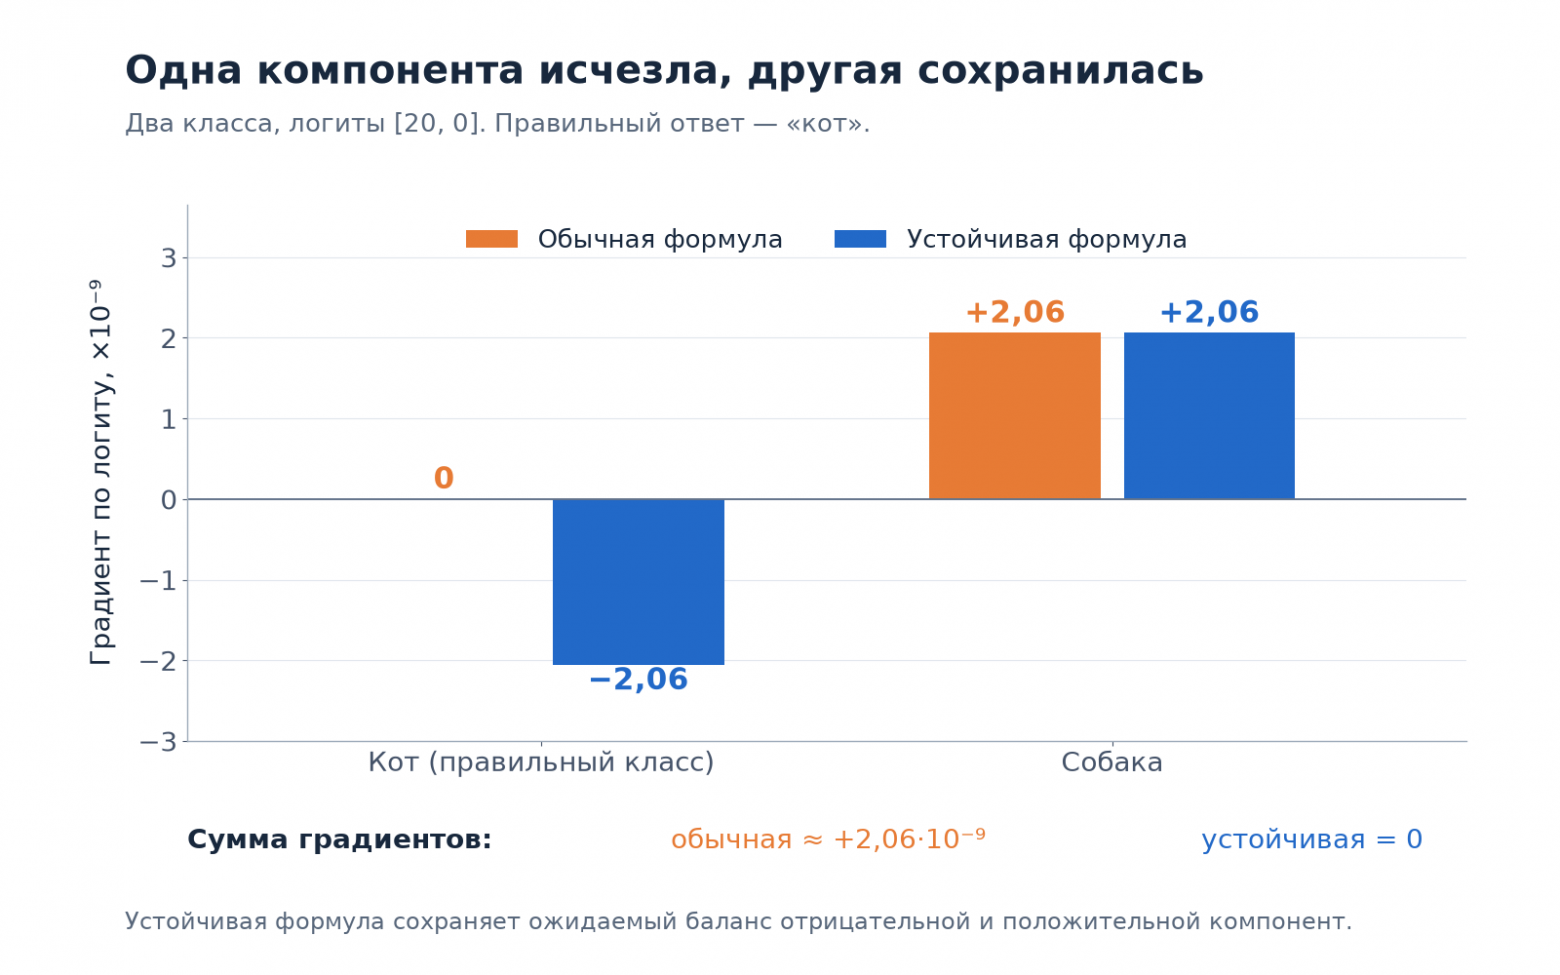
Рис. 1. Для логитов [20, 0] правильный градиент содержит две противоположные компоненты. В обычном вычислении float32 отрицательная компонента исчезает, а положительная остаётся. Собственный численный пример; значения округлены для подписей.
У кота ожидалось примерно −2,06·10⁻⁹, а получилось ровно 0. У собаки положительная компонента осталась. Это и есть Softmax Collapse в нашем примере. Исчезновение одной компоненты не означает, что обучение всей сети остановилось: сигнал от остальных классов продолжает идти назад, но он уже искажён.
Сумма производных здесь удобна как проверка вычисления, а не как цель обучения. В точной арифметике она равна нулю: прибавление одной константы ко всем логитам не меняет ни вероятности, ни loss. В примере ожидаемые минус и плюс взаимно компенсируются; машинные 0 и плюс — уже нет.
Это проверка конкретной вычислительной схемы NumPy. Она объясняет механизм; поведение вашего ядра PyTorch или JAX нужно измерять в вашей среде. А вопрос «может ли такая крошечная ошибка заметно повлиять на обучение?» разберём отдельно, на экспериментах авторов.
Если классов больше двух
Вместо собаки могут быть тысячи других ответов. Обозначим правильный класс индексом  . Его логит —
 , вероятность —
 , производная потерь по логиту —
 . Относительный вес всех конкурентов теперь нужно сложить:
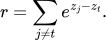
Формулы остаются теми же: 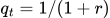 и
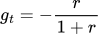 . Для графиков удобно снова выразить через отрыв :
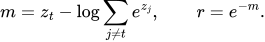
В бинарном случае это наша прежняя разность двух логитов. При множестве классов отрыв считается от всех конкурентов вместе, а не только от ближайшего. Чем больше , тем меньше и тем ближе вычисление к проблемной области.
Где проходит обрыв
У float32 23 явно хранимых бита дробной части и ещё один неявный ведущий бит для нормальных чисел. Шаг между единицей и следующим большим числом равен  . При округлении к ближайшему прибавка меньше
 уже теряется.
Для этой схемы вычислений приблизительный порог можно записать так:
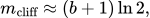
где  — число явно хранимых битов дробной части.
Формат вычисления | Битов дробной части | Порог отрыва |
|---|---|---|
bfloat16 | 7 | ≈ 5,54 |
float16 | 10 | ≈ 7,62 |
float32 | 23 | ≈ 16,63 |
float64 | 52 | ≈ 36,74 |
Это пороги арифметики конкретной операции. Наличие весов в bfloat16 не означает автоматически, что softmax и loss тоже вычисляются в нём: смешанная точность может выполнять чувствительные операции в float32. И сама таблица не заменяет измерения библиотечного ядра.
Как выглядит потеря градиента на графике
Сравним обычную запись 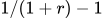 с уже разобранной устойчивой дробью
 . По горизонтали увеличиваем уверенность модели, по вертикали смотрим на модуль градиента правильного класса.
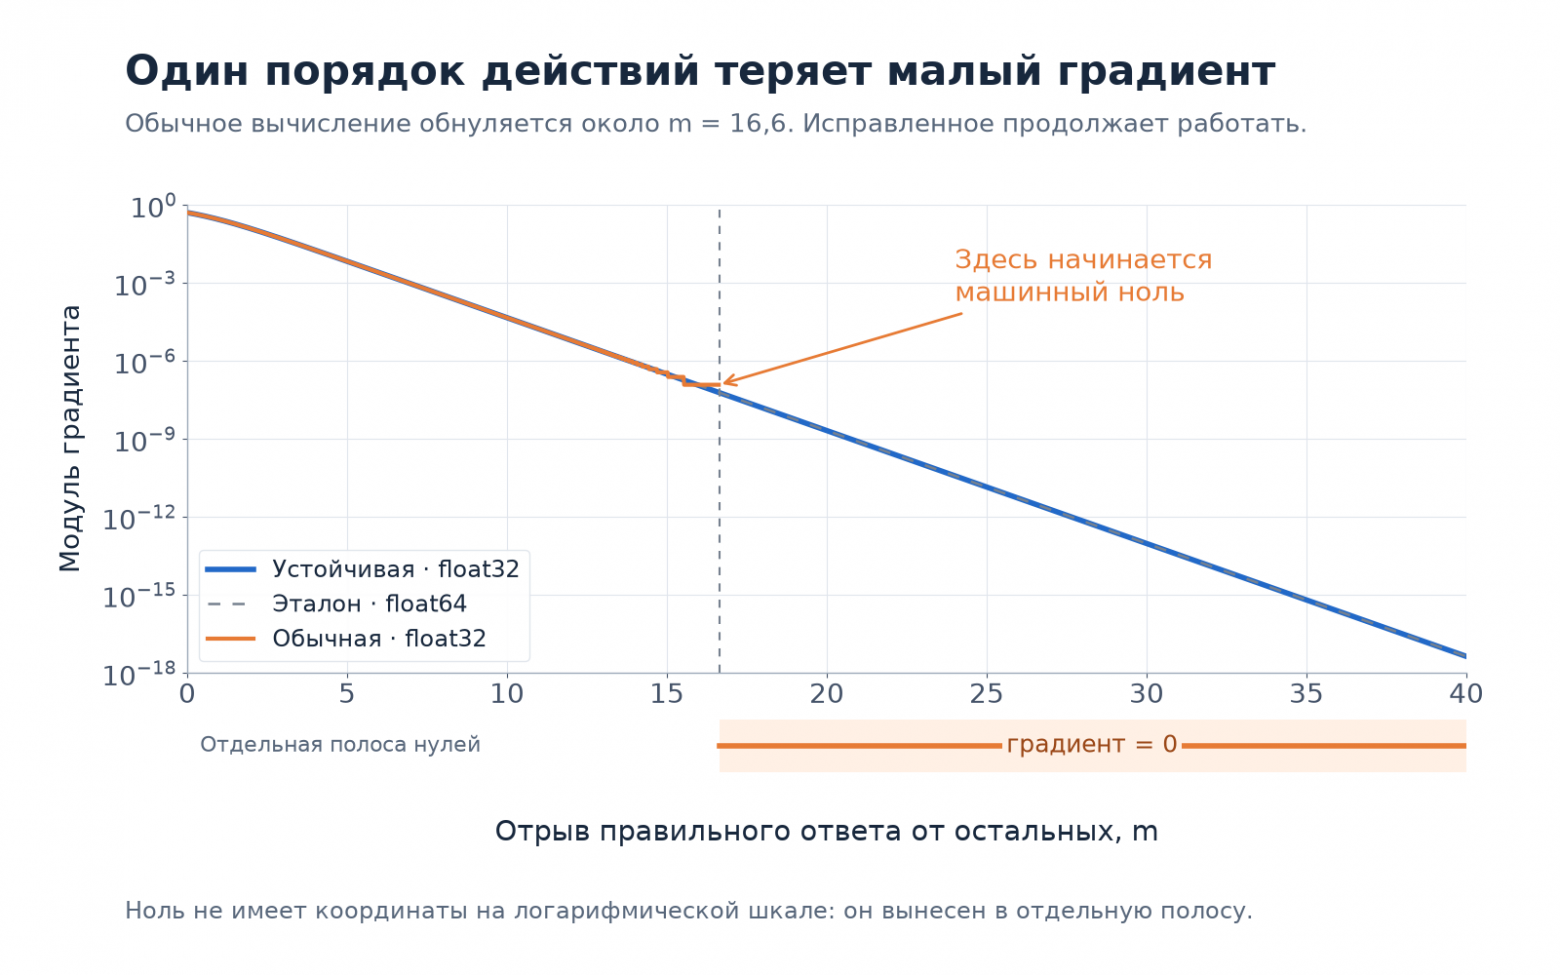
Рис. 2. Модуль градиента правильного класса в зависимости от отрыва m. В обычной схеме float32 градиент обнуляется около m = 16,6. Устойчивая формула продолжает уменьшаться вместе с эталоном. Машинный ноль показан отдельно: на логарифмической оси он не имеет конечной координаты.
Проверим несколько точек с графика:
import numpy as np

m = np.array([10, 15, 16, 17, 20, 30], dtype=np.float32)
one = np.float32(1.0)
r = np.exp(-m)

usual = one / (one + r) - one
fixed = -r / (one + r)

for margin, a, b in zip(m, usual, fixed):
    print(f"m={margin:2.0f}: usual={a: .6e}, fixed={b: .6e}")
m=10: usual=-4.541874e-05, fixed=-4.539786e-05
m=15: usual=-3.576279e-07, fixed=-3.059022e-07
m=16: usual=-1.192093e-07, fixed=-1.125352e-07
m=17: usual= 0.000000e+00, fixed=-4.139937e-08
m=20: usual= 0.000000e+00, fixed=-2.061154e-09
m=30: usual= 0.000000e+00, fixed=-9.357623e-14
Бесконечной точности это не даёт. Если уже сама экспонента станет слишком мала для формата, возникнет underflow — округление к нулю у нижней границы представимых величин. Исправление убирает преждевременную потерю сигнала при прибавлении к единице, но не расширяет диапазон чисел компьютера.
Вторая ошибка: Softmax Cancellation
Теперь немного меняем задачу. При дистилляции обучаем сеть-ученика повторять ответы фиксированной сети-учителя. Например, учитель выдаёт для фотографии 70% на кота и 30% на собаку. Мы хотим, чтобы ученик воспроизвёл именно это распределение, а не обязательно довёл вероятность кота до 100%.
Здесь  — вероятность класса у учителя,
 — у ученика, а
 — логит ученика. Вместо одного правильного класса используем такие «мягкие» метки. Функция потерь:
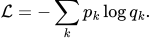
Её производная по логиту ученика:
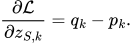
Когда ученик повторяет вероятности учителя, подталкивать его дальше незачем: градиент должен стать нулевым. При этом сама cross-entropy обычно не равна нулю: она равна энтропии распределения учителя. Нулевыми при совпадении становятся градиент и KL-дивергенция — мера различия двух распределений.
Но вероятности могут вычисляться разными путями: например, для учителя через деление экспонент, а для градиента ученика — через экспоненту от log_softmax. В точной математике результаты одинаковы; при округлении младшие разряды могут различаться.
Для численной проверки возьмём три класса и одинаковые логиты учителя и ученика [2, 1, 0].
import numpy as np

z = np.array([2.0, 1.0, 0.0], dtype=np.float32)
shifted = z - z.max()
e = np.exp(shifted)

p = e / e.sum()                         # путь через softmax
q = np.exp(shifted - np.log(e.sum()))   # через log_softmax

noise = q - p
print(noise)
print(f"Норма: {np.linalg.norm(noise):.6e}")
[ 0.0000000e+00  1.4901161e-08 -1.4901161e-08]
Норма: 2.107342e-08
Логиты совпали, а вычисленный градиент — нет. Это не означает, что компьютер способен получить ненулевой результат из x - x: здесь вычитаются числа, которые уже немного различаются из-за разных вычислительных путей.
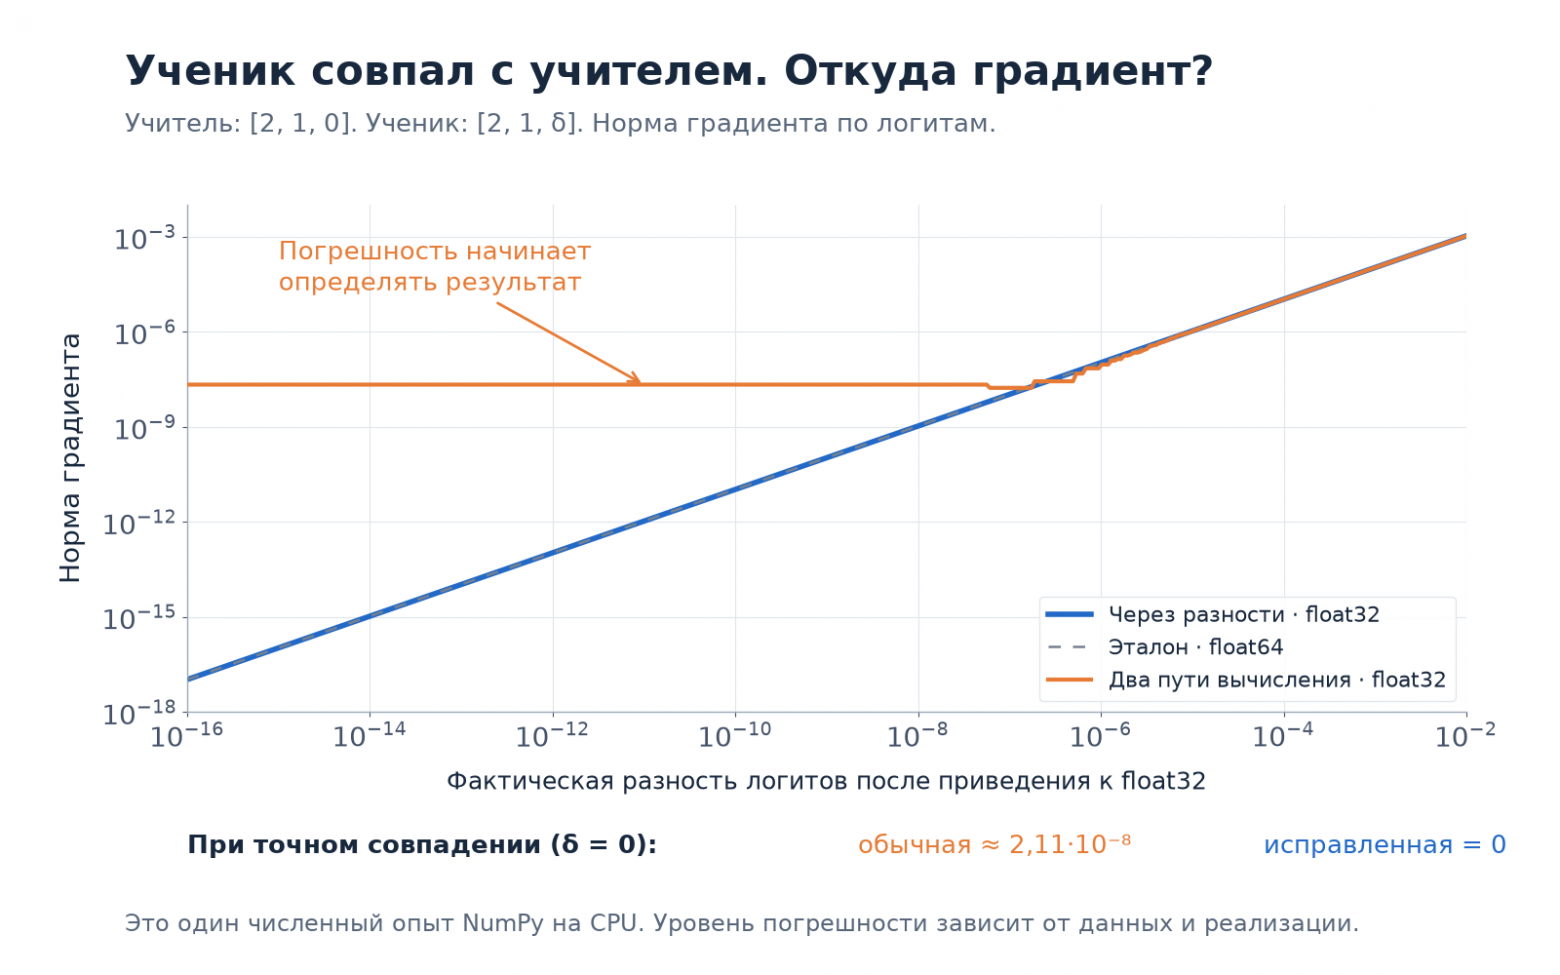
Рис. 3. Учитель имеет логиты [2, 1, 0], ученик — [2, 1, δ]. По горизонтали — фактически представимое различие логитов float32; по вертикали — норма градиента. При сближении моделей погрешность обычного вычисления начинает определять результат. Точное совпадение показано отдельно. Уровень погрешности зависит от данных, формата и реализации.
Исправление: сначала сравнить логиты
Авторы предлагают вычислять маленькую разность вероятностей через разность логитов. Разберём по шагам, чтобы обозначения не превратились в стену символов.
Шаг 1. Находим различие ученика и учителя.
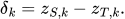
Шаг 2. Вычитаем среднее различие, взвешенное вероятностями учителя. Полученные величины обозначим  :
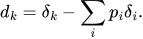
Шаг 3. Вычисляем малую поправку к вероятности. Для удобства обозначим общий нормирующий член через  :
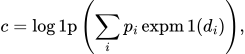
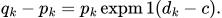
expm1(x) вычисляет  , а
log1p(x) —  . Их специальные реализации сохраняют точность при малом
x, когда прямое вычисление через прибавление или вычитание единицы её теряет.
В точной арифметике здесь снова та же самая разность  . При совпадении логитов сразу получаем нулевые
 , затем
 и . Последняя операция —
expm1(0), которая возвращает машинный ноль.
Проверка исправления при совпавших логитах: короткий NumPy-код
import numpy as np

teacher = np.array([2.0, 1.0, 0.0], dtype=np.float32)
student = teacher.copy()

e = np.exp(teacher - teacher.max())
p = e / e.sum()

delta = student - teacher
d = delta - np.sum(p * delta)
c = np.log1p(np.sum(p * np.expm1(d)))
gradient = p * np.expm1(d - c)

print(gradient)  # [0. 0. 0.]
Это локальная демонстрация для близких логитов, а не готовая функция обучения. Для больших различий нужны дополнительные меры устойчивости; полную реализацию следует смотреть у авторов.
Почему маленькая ошибка может влиять на обучение
Казалось бы: градиент порядка одной стомиллионной — кому какое дело? Но величина шага зависит не только от самого градиента, но и от оптимизатора.
Например, Adam нормирует накопленный сигнал на оценку его недавнего масштаба:
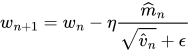
Здесь — параметры модели,  — скорость обучения,
 и
 — оценки среднего градиента и среднего его квадрата с поправкой на начальное смещение. Малое
 ограничивает влияние очень маленького знаменателя. Индекс
 обозначает шаг обучения.
При Softmax Collapse искажённый градиент по логитам проходит через сеть и влияет на градиенты по параметрам. Его последствия зависят от модели, остальных примеров в батче и состояния оптимизатора. Один маленький численный пример ещё не доказывает заметного изменения обучения — здесь уже нужен эксперимент.
Авторы связывают такую асимметрию с Slingshot, или эффектом «Рогатки»: после периода низкого loss возникают резкие всплески. В экспериментах работы исправление численной схемы убирает эти всплески и меняет дальнейшее обучение.
На рисунке ниже сравниваются два режима. Weight decay — регуляризация, которая понемногу уменьшает параметры модели; в верхнем эксперименте она включена, в нижнем — нет.
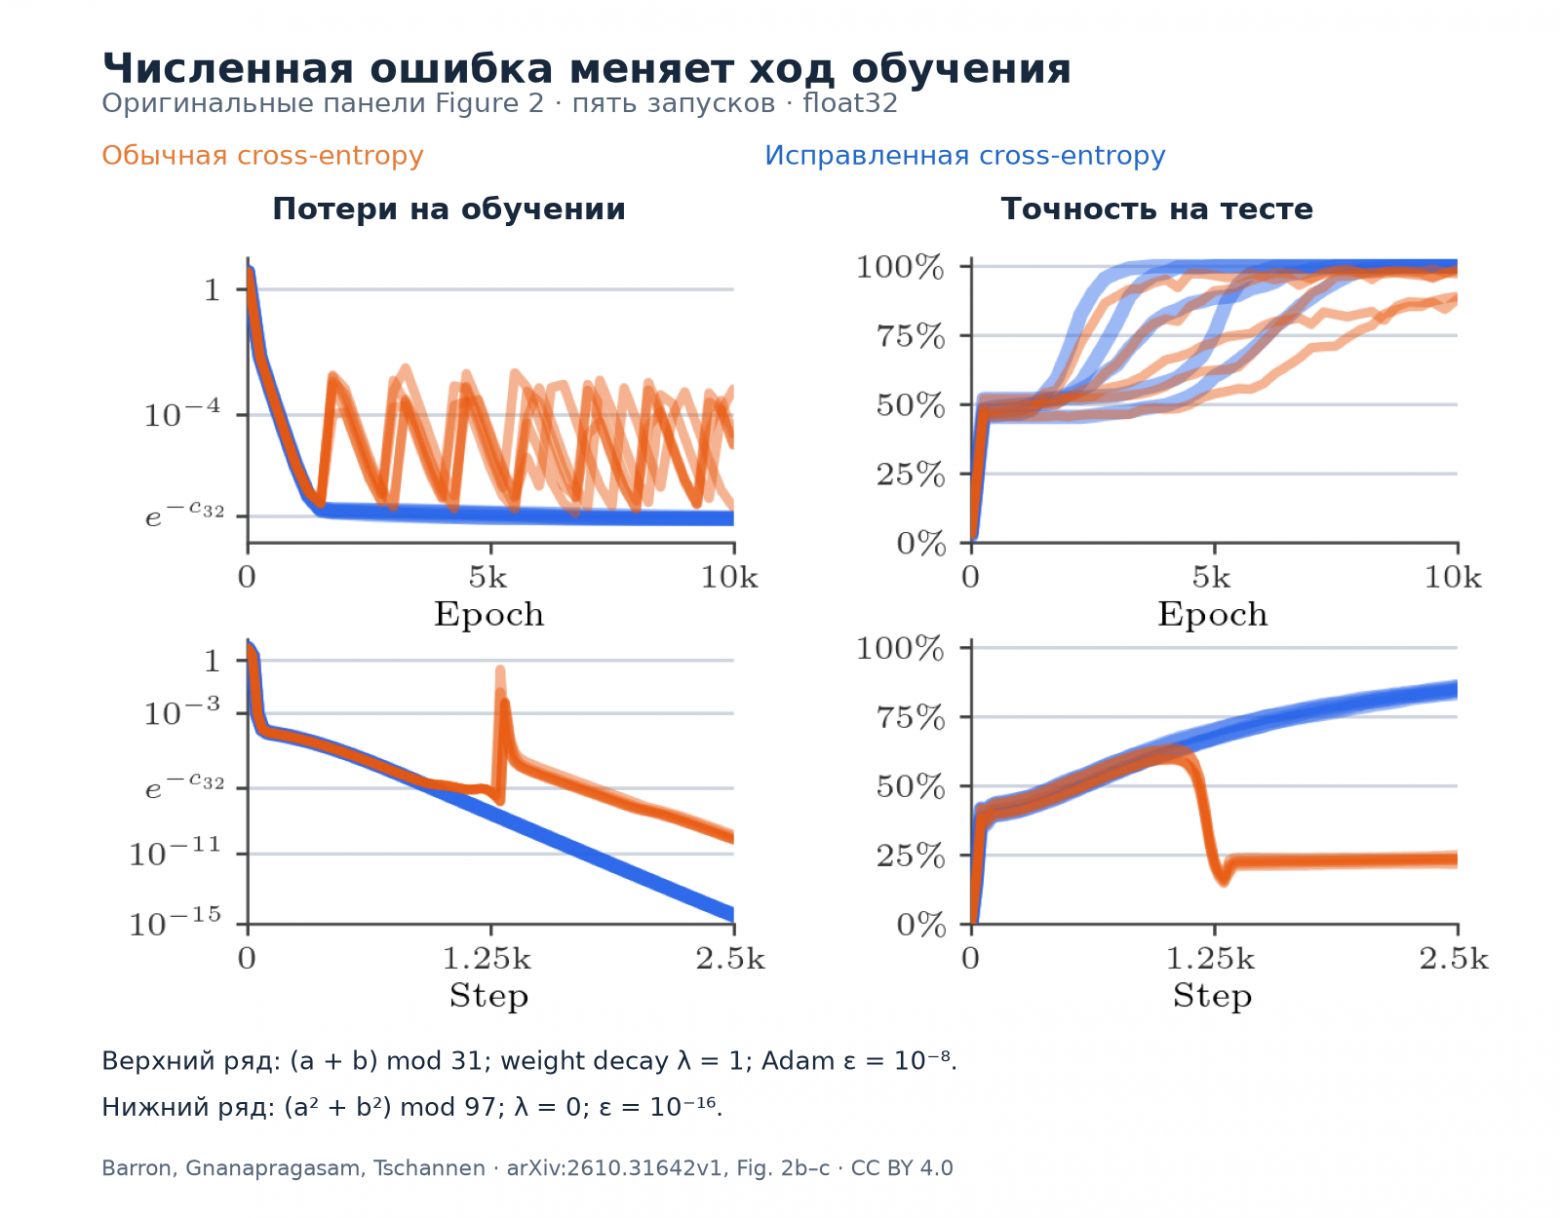
Рис. 4. Оригинальные панели Figure 2b,c работы Barron, Gnanapragasam и Tschannen; добавлены русские пояснения. Слева — loss, справа — тестовая точность. Сверху: сложение по модулю 31, weight decay λ = 1, Adam ε = 10⁻⁸. Снизу: (a² + b²) mod 97, λ = 0, ε = 10⁻¹⁶. Вычисления float32, пять запусков с разными начальными состояниями генератора случайных чисел (seed). Epoch означает эпохи обучения, Step — шаги, c₃₂ ≈ 16,6 — порог точности. Источник: раздел 4 препринта, CC BY 4.0. Это данные авторов, а не наша репродукция обучения.
Это более сильный результат, чем один искусственный пример с двумя числами. Но он не доказывает, что любой всплеск loss у любой LLM вызван именно softmax. В работе рассматриваются определённые модели и задачи; перенос вывода на вашу систему требует отдельного эксперимента.
Как записать loss, чтобы сохранить маленькую величину
Для одного примера с правильным классом cross-entropy математически можно выразить через всех конкурентов. Сначала вычислим:
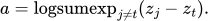
Здесь logsumexp означает «логарифм суммы экспонент», вычисленный устойчивым способом. Затем:
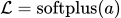
Функция softplus(a) — это устойчивая реализация  . Малую прибавку не нужно сначала складывать с единицей обычной операцией, теряя её до вычисления логарифма.
Ниже — учебная реализация для случая, который мы исследуем: правильный класс имеет максимальный логит. Она возвращает loss и градиент по логитам явно, чтобы их можно было проверить. Это не замена библиотечному autograd, не поддержка всех режимов cross-entropy и не исправление дистилляции.
Проверенный NumPy-пример для уверенного правильного ответа
import numpy as np

def confident_hard_ce(z, target):
    z = np.asarray(z)
    if z.ndim != 1 or z.size < 2 or z.dtype not in (np.float32, np.float64):
        raise ValueError("Нужен 1D-массив float32/float64, K >= 2")
    if not np.isfinite(z).all():
        raise ValueError("Все логиты должны быть конечными")
    if not isinstance(target, (int, np.integer)) or not 0 <= target < z.size:
        raise ValueError("target должен быть целым числом от 0 до K - 1")
    target = int(target)
    if z[target] != z.max():
        raise ValueError("В этом примере правильный класс должен быть лидером")

    other = np.arange(z.size) != target
    d = z[other] - z[target]
    if not np.isfinite(d).all():
        raise ValueError("Разности вышли за диапазон выбранного формата")

    log_r = np.logaddexp.reduce(d)       # log(sum(exp(d)))
    zero = np.zeros((), dtype=z.dtype)
    loss = np.logaddexp(zero, log_r)    # softplus(log_r)

    grad = np.zeros_like(z)
    grad[other] = np.exp(d - loss)
    grad[target] = -grad[other].sum()  # не вычисляем q_t - 1
    return loss, grad

z = np.array([20.0, 0.0], dtype=np.float32)
loss, grad = confident_hard_ce(z, target=0)
print(loss)        # 2.0611537e-09
print(grad)        # [-2.0611537e-09  2.0611537e-09]
print(grad.sum())  # 0.0
np.logaddexp(a, b) устойчиво вычисляет логарифм суммы двух экспонент. Метод reduce последовательно объединяет весь массив конкурентов. Градиенты конкурентов считаются из малых экспонент, а градиент целевого класса — как их отрицательная сумма.
Ограничение на максимальный целевой логит здесь намеренное. Этот фрагмент демонстрирует конкретный режим; для произвольных ответов, батчей, весов классов и автоматического дифференцирования нужна полноценная реализация.
У авторов на странице проекта есть код JAX и интерактивная демонстрация. Для внедрения я бы начинал именно с полной вычислительной схемы и проверки её поведения в нужной библиотеке, а не с копирования одной дроби в производственный код.
Никто не замечал раньше?
Замечали. Более того, работа DeepMind ссылается на предшественников.
Prieto и соавторы, ICLR 2025 исследовали Softmax Collapse и предложили StableMax. Он меняет саму функцию, заменяя экспоненциальное преобразование другим. Здесь же исправление сохраняет математические softmax и cross-entropy, меняя порядок вычислений.
Liu и соавторы в мае 2026 года уже изучали нарушение нулевой суммы градиентов и его связь со Slingshot. Ещё раньше устойчивость softmax и log-sum-exp систематически разбирали Blanchard и Higham.
Новость — в конкретных исправлениях двух дефектов и исследовании их последствий для обучения. Это не первое открытие того, что компьютерная арифметика округляет числа.
Бежать ли переписывать прод?
Я бы начал с измерений. Особое внимание имеет смысл уделить дистилляции с почти совпадающими распределениями, очень уверенным предсказаниям и длительному обучению после запоминания выборки. В последнем случае может наблюдаться grokking: способность обобщать появляется заметно позже, чем высокая точность на обучающих данных.
Но ни большой словарь LLM, ни используемый формат весов сами по себе не дают готового ответа о наличии проблемы. Нужно знать распределение отрывов и фактический формат чувствительных операций.
Label smoothing, или сглаживание меток, уменьшает давление в сторону бесконечной уверенности: целевой ответ получает вероятность меньше единицы. Это может снижать вероятность попадания в проблемный режим, но не исправляет численную формулу. Температура тоже меняет уверенность: при фиксированных логитах высокая температура смягчает распределение, низкая делает его острее. Универсальной защиты из этого не получается.
Практическую проверку я бы построил так:
Подать уверенный правильный ответ, например
[20, 0]вfloat32. Посмотреть на loss, все компоненты градиента и их сумму.Для дистилляции дать ученику и фиксированному учителю одинаковые логиты. Проверять нулевой градиент, а не нулевую cross-entropy.
Повторить опыт для почти совпавших логитов. Сравнить с вычислением повышенной точности и убедиться, что малая добавка сохранилась уже в самих входных данных.
Записать версии библиотеки, устройство и фактический dtype операции. Проверить отдельно нужные режимы смешанной точности и компиляции.
При замене реализации сравнить качество, устойчивость и время обучения в одинаковых условиях. Более точная формула не обязательно быстрее оптимизированного библиотечного ядра.
Выводы
Мне в этой истории нравится сочетание масштаба и простоты. Мы обсуждаем современные нейросети, а ключ к одному из дефектов помещается в школьное преобразование дроби.
Математически одинаковые выражения могут давать разные машинные результаты. В одном случае маленькая величина теряется рядом с единицей, в другом — сохраняется в числителе. Для дистилляции помогает тот же общий подход: вычислять малую поправку непосредственно, пока округление не уничтожило полезную информацию.
Это хороший повод проверить несколько численных инвариантов в своей среде. И гораздо более конкретный вывод, чем «все нейросети всё время обучались неправильно».
А вы встречали необъяснимые всплески loss или дрейф ученика при дистилляции? Особенно интересны воспроизводимые примеры с версиями библиотек, устройством и форматом вычислений.
Источники и воспроизводимость
Barron, Gnanapragasam, Tschannen. A Fix for Softmax and Cross-Entropy, arXiv v1, 22 октября 2026 года, CC BY 4.0.
Страница проекта: формулы, JAX-код и интерактивная демонстрация. Код может обновляться отдельно от arXiv v1.
Prieto и соавторы. Grokking at the Edge of Numerical Stability, ICLR 2025.
Liu и соавторы. Работа о Slingshot и нулевой сумме градиентов, 2026.
Blanchard, D. J. Higham, N. J. Higham. Accurately computing the log-sum-exp and softmax functions.
Все пять NumPy-примеров проверены на CPU: Python 3.12.1, NumPy 2.5.1, явный float32. Три схемы поясняют ход вычислений. Рисунки 1–3 — собственные численные иллюстрации, рисунок 4 использует результаты авторов исследования с указанием источника.