
Хабр Курсы для всех
РЕКЛАМА
Большая витрина: от крупнейших школ до частных авторов. Сравнивайте по цене, длительности, формату и выбирайте самый подходящий курс!

Да, если о качестве самостоятельной работы ИИ еще долго будут спорить, то в одном аспекте точно сформировался консенсус: ИИ очень сильно снижает порог входа новичков в IT именно как в отрасль. Плюс фактом своего появления мотивирует людей вообще интересоваться как IT, так и AI в частности. Опять же, судить о качестве знаний бесполезно. Кто то глубоко ныряет и сразу минует стадии "иллюзий и самообмана", а кто то дальше вайбкодинга не уходит. Но людей понимающих язык айтишников становиться всё больше и общая грамотность растет.

общая грамотность растет
Немного сомнительно. Это как познания в сетевых технологиях, после начала активных блокировок не сильно-то много добавились у тех, кто и не интересовался ранее, знают VPN, ну прокси, дипиай. И бабулька, что навайбкодит календарь посевов, не отличит int от str. Грамотность на уровне знания аббревиатур.

Просто грамотность переходит немного в другую область? Я владею современной машиной и очень приблизительно разбираюсь что там внутри. И часть этих значений получил в автомастерских где разъясняли что делают, а часть самостоятельно (управлением авто упростили - я могу купить его и пользоваться - так как я им теперь владею то начинаю интересоваться как он работает, как за ним ухаживать и как делать его комфортнее). Скорее всего я знаю сильно меньше чем среднестатический шофер 30 лет назад. С другой стороны этот среднестатический шофер с 40 летним опытом и в современной машине мало что поймет) но грамотность вождения уже тоже перешла в другую степь (в повышение комфорта водителя и пассажира) + больше людей понимают в авто чуть больше чем раньше.
С ai так же. У меня сейчас больше 15 лет стажа и я люблю писать сам код и ковыряться во всех смежных областях. Но может оказаться так что через 15 лет я тоже перестану понимать что там внутри. Но чуть большая доля населения смогут себе навайбкодить приложуху или фильм с сериалом) Смонтировать крутой ролик своему внуку на др из фоток на айфоне за 10 лет и все такое
Сумбурнентко получилось)

Я владею современной машиной и очень приблизительно разбираюсь что там внутри.
Боюсь, что в таком случае это она автомастерская владеет Вами. Вы за ремонт прокатило сколько заплатили?

Разбираться приблизительно сейчас достаточно, а если сервис идёт с услугой "прокатило/не прокатило", то надо искать другой сервис.
Даже старые автомобили бывают весьма сложно устроены, а знание устройства конкретного автомобиля или даже марки в целом не всегда помогает в ремонте другого авто (знаю пару совсем уж катастрофических случаев, когда люди, всю жизнь ездящие на жигулях и на пенсии пересевших на иномарки, гробили свои новые авто своими жигулёвскими привычкам: да я всегда такое масло лил, ой, да она и на 80 будет нормально ездить и т.д., а потом "вот раньше машины делали, не то, что сейчас").
Или вот представим у вас масло уходит. Причин может быть тысячи. Ок, предположим в сервисе мотор перебрали и починили. Будете сами внутрь мотора снова лезть, чтобы проверить, что всё ли поменяли, что в прайсе записано?

Немногие программисты сильны в ассемблере, и я не знаю никого, кто силен в машинном языке. С этой точки зрения это "грамотность на уровне знания аббревиатур".

Основным скиллом, необходимым для работы с нейроночкой, становится ревьюшный скилл. А ревьюить не любят даже опытные IT-шники и "умение читать чужой код" всё время отдельно прописывалось в требованиях. Что уж говорить про новичков, которым будет предлагаться сразу читать длинные портянки. А без чтения портянок ты остаёшься вайбкодером гарантированно.
Я тут решил Chrome extension навайбкодить, который PCM звук записывает с микрофона во временный буфер, потом применяет эффект эхо и нормализации, а потом кодирует его в OPUS -> OGG. Написать подробный промпт, зарядил, подождал, оно высрало, всё работает. Код я читал конечно поверхностно, что-то модифицировал, типа имён кнопок. Несколько раз потом этот extension через те же или другие нейроночки дорабатывал методом написания вайб-промптов. Через неделю работы задумался - а чего оно так медленно кодирует PCM семплы в OPUS? Может там своя реализация кодека, а может неоптимально написано, а может на JavaScript быстрее и не бывает? Ну думаю спрошу у нейроночки прямо - нельзя ли быстрее?
А оно и говорит - конечно можно, у тебя семплы из буфера в реальном времени виртуально "проигрываются" плеером на реальной скорости и кодируются, а можно же сразу их кодировать не проигрывая прямо из буфера! Вот это поворот, а мужики-то не знали. Вот блин, кто бы мог подумать, что в первоначальном промпте стоило написать даже и то, что надо делать хорошо, а плохо не делать)

Согласен. Я конечно пробовал сам программировать(на внутриигровых языках), но моя голова похоже очень слабо для этого подходит. Но зато могу точно описать чего именно хочу и так же точно описать что конкретно не так. Это тоже навык, которым владеют далеко не все.

Anthropic, до свидания! Китайские братья, здравствуйте!
Почему не OpenAI?

Подписка есть и пользуюсь ей с начала лета, но я думаю это вопрос времени, когда забанят. OpenAI ведь тоже собралась на IPO (где-то в 1 или 2 квартале 2027)

Китайским братьям пока далеко до Опуса 5.5, увы.
Это 100% так, но тот же Кими по моему первому опыту использования находится примерно на уровне с Опусом 4.8. Жаль конечно, что придется даунгрейдиться по способностям и уровню разработки, но например когда был даже Опус 4.6, то мне его возможностей хватало, поэтому есть надежда, что смогу адаптироваться и на Кими, а через полгода гляди и они достигнут текущего уровня Опус 5.5 (очень надеюсь).
Проблема в том, что китайские модельки жрут токенов, как не в себя. На эквивалент 20$ подписки Клода/Кодекса мне надо будет отдать около 80$ на подписку Кими или GLM

Glm тратит мало.
Кими быстро расходуется, да

Сейчас пробую Devin. У него есть занятный режим - Fusion, когда сложный вопрос или задачу он отдает старшей модели, остальное - младшей. Сейчас у меня в качестве старшей стоит Opus 5.5 medium, а младшей - SWE-2. И вот такое комбо показывает себя хорошо на моих задачах Go/C++. SWE-2 это улучшеный Kimi K3 и он у них бесплатен до конца ноября.

Я после аналогичного бана сделал две вещи: перешёл на гермеса чтобы больше не быть в вендорлоке и юзаю гпт. ГПТ после опуса ощущается сильно иначе, у них словно разные "характеры": если опусу чем меньше говоришь тем лучше будет выход, то с гпт надо наоборот максимально точно обложить все инструкциями и тогда результат будет примерно одинаков. Плюс гермес из коробки умеет в мультипровайдерную разработку поэтому эксперементирую с комбайном мечты отдавая разные этапы разных задач разным моделям
Ну и сидя на гермесе я больше не боюсь что мне забанят гпт или еще какого провайдера: потому что я просто поменяю часть моделек на другие и продолжу работать в том же инструменте что и раньше

Я купил подписку opencode go за 10 баксов и там kimi 3.1 pro выжрал половину месячного лимита за 1 запрос... Но вот deepseek v4.1 flash 1017 буквально "нюхает" лимиты. За 2 дня сожрал всего 2% месячного лимита! И не сказать что он тупой.

deepseek в целом самый честный по ценообразованию. нет всей этой заманухи с лимитами, сбросами, постоянными перепаковками тарифов, нет соблазна настроить автоматизации через попдисочные аккаунты (что запрещено у большинства). есть их родное облако, есть куча альтернатив на openrouter по +/- такой же цене.
цены у deepseek тоже адекватные. за 20$ в месяц можно сделать весьма много (особенно если не работать в peak hours по Пекину) и не надо ждать обнулений если немного не хватило, закинул еще немного и завершил задачи
ну по бенчмаркам некоторые на уровне 5.5, другой вопрос что glm и kimi тормозят жутко в их родном облаке (а в неродных честная оплата по токенам). нормально по скорости работают deepseek и qwen, но они не так приблизились как kimi. думаю, в следующей итерации отставание китайцев будет еще меньше, а пока для интерактива можно использовать chatgpt и deepseek. ну или можно пользоваться моделями антропик через openrouter если очень сильно надо, но платить придется не по подписочному прайсу
По бенчмаркам там все дартаньяны, а на деле разница огромная на сложных задачах. Но китайцы конечно догоняют на огромной скорости.

Там вроде на след неделе 4ый Квен выходит. По крайней мере в локально-ИИшном мире превьюха 4ого была очень даже прорывной. Так что будет интересно посмотреть, на что это будет похоже в большом формате.

последний месяц для кода использую исключительно ds flash 4.1, если нормально формулируешь - кодит чётко.

После IPO перестанут банить, щас для вида делают, а потом надо будет дебит с кредитом бить и показывать активность пользователей инвесторам

По ощущениям у OpenAI дает больше ресурсов, у китайцев GLM и Kimi очень быстро улетает лимит, у GLM только GLM-5.3-Flash можно юзать без ожидания, что весь 5ч лимит может улететь за 30мин, но GLM-5.3-Flash у меня и локально с нормальной скоростью работает
Значит, обрезали лимиты на Glm
В августе не мог упереться в лимиты

А на каком железе локально запускаете GLM-5.3-Flash?

GLM-5.3-Flash у меня и локально с нормальной скоростью работает
Можно подробности? Интересует конфигурация железа, ссылка на веса, на которых работает модель, длина контекста, а также скорость (входные / выходные токены в секунду) и количество одновременно обрабатываемых запросов. Например, держит ли одновременно 4 сессии по 200k токенов каждая? Это довольно частый случай при мультиагентной разработке.

codex тупее будет

В эпоху мейнфреймов разработка программного обеспечения на языке Ассемблер требовала профильного, преимущественно математического образования. Со временем порог входа в профессию снизился, что привлекло специалистов из других областей, имеющих непрофильное образование и даже включая гуманитарные науки. С появлением нейросетей процесс разработки стал еще более доступным, позволяя пользователям без специальной подготовки создавать программные решения под свои задачи. Эта тенденция отражает позитивное развитие технологий, направленное на упрощение и повышение качества жизни.

Да, они пока еще ужасно пишут код на Ansible, который потом просто невозможно переиспользовать нигде более
Можно вас попросить предоставить пару примеров/задач по коду код на Ansible, с которыми нейронки не справляются или справляются плохо?
Дело в том что я в том числе занимаюсь тем чтобы они таки могли делать это нормально и таких примеров обычно не хватает.
Я посмотрю, что можно сделать.
Они никогда не пытаются думать так, чтобы тот же плейбук можно было переиспользовать например для других хостов с минимальной степенью вариативности. Роли пишут аналогично. Скиллы оказываются полезными, но я думаю для написания качественного ансиблового кода нужно все же понимание специфики управления инфрой.
Особенность программного кода в том, что он в некоторой степени универсален и упирается в цикл обратной связи "код-фича". Если фича работает как надо, значит код верный. С инфрой все по-другому - никто никогда в интернете не комментирует почему ансибловый код написан так, а не иначе (но это важная информация). Выходит нейронки учились уже на готовом и без понимания причин почему написано именно так, отсюда и проблемы.
В качестве отправной точки для написания ансибловых скиллов рекомендую использовать документ вот этого товарища: https://github.com/robertdebock/ansible-role-ulimit/blob/master/.cursor/rules/ansible.mdc (он его складывает в каждую роль и в целом правила выглядят достаточно разумно)
Спасибо, за ссылку, но я не скилами это решаю. Поэтому нужна конкретная задача/пример.

Принимаются задачи только на Ansible, или любая с чётким, коротким и понятным описанием? Я сейчас решаю одну такую скиллами и интересно сравнить результаты.
Любые задачи, которые не решаются текущими фронтир моделями в связке со скилами и прочим.
Пожалуйста: create a Visual Studio 2026 extension in .vsix format for syntax coloring of Herb Sutter’s Cpp2 (cppfront). Достаточно просто?
Суть примерно такова (я в процессе изучения и могу ошибаться), но вы в промпт это не добавляйте для чистоты эксперимента. У Visual Studio 2026 свой способ делать такие вещи (подключать новые языки): LSP (Language Server Protocol). И она, Студия, постепенно умирает. Многие перелезли с неё на VS Code, а у него свои механизмы. Зачем VS Code нужен Майкрософту я честно не понимаю. Убить десктопные приложения? Они их и так порезали, но зачем делать ДВЕ IDE? Ну да ладно. Грамматика Cpp2 автором, насколько я понимаю, не формализована. Но есть комьюнити, которое это сделало, правда не в декларативном формате (типа BNF), а в каком-то новом (для меня) tree-sitter. Который, вроде бы, императивный/колбечный (ему текст, он разбивку). Соответственно, задача сводится к тому, чтобы найти готовую императивную имплементацию грамматики Cpp2 под tree-sitter (она есть), обернуть её в сервер LSP, и запаковать как расширение.
На втором этапе можно добавить этот текст в качестве подсказки.
Спасибо за пример, правда это винда, придется скакать туда-сюда, но что-нибудь придумаю. Я уже проходил подобное, но с написанием плагина под Apache NetBeans 29.
в каком-то новом (для меня) tree-sitter
Он во всю применяется в Neo/Lazy и прочих вимах, работает через построение AST.
Скажите, а вы точно уверены,что это не решается фронтир моделями? Вы пробовали? Просто по описанию ничего сложного.
@ImagineTables да, задача оказалось не сложной. Закинул ваш первый запрос своему карасику, расширенное описание даже не понадобилось. Он сам нашел аналог на гитхабе (под другую IDE), вытащил из исходников принцип работы, стянул с MS их xsd схемы и написал свой плагин. Никаких доп скилов по этой теме я не указывал.
Написал код он с первого раза, я перезагрузился в win10 и проверил. Все работает. Сделана базовая подсветка синтаксиса, модель предложила сделать покрытие больше, но я не стал тратить время дальше т.к. это лишь тест.
На все про все ушло 48 минут. При этом в фоне у меня шел обсчет из другого проекта.
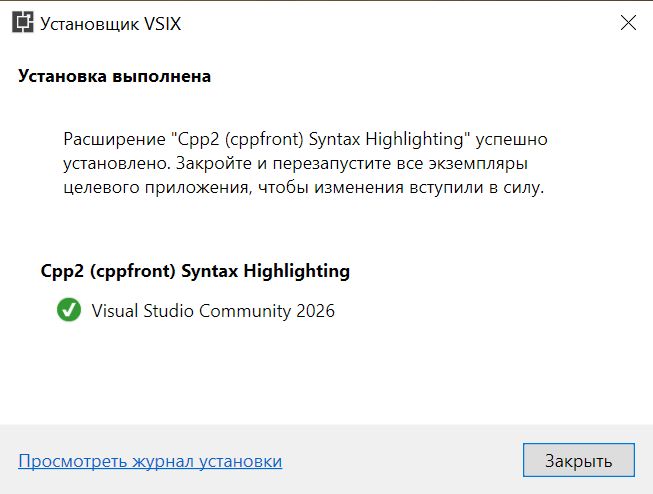
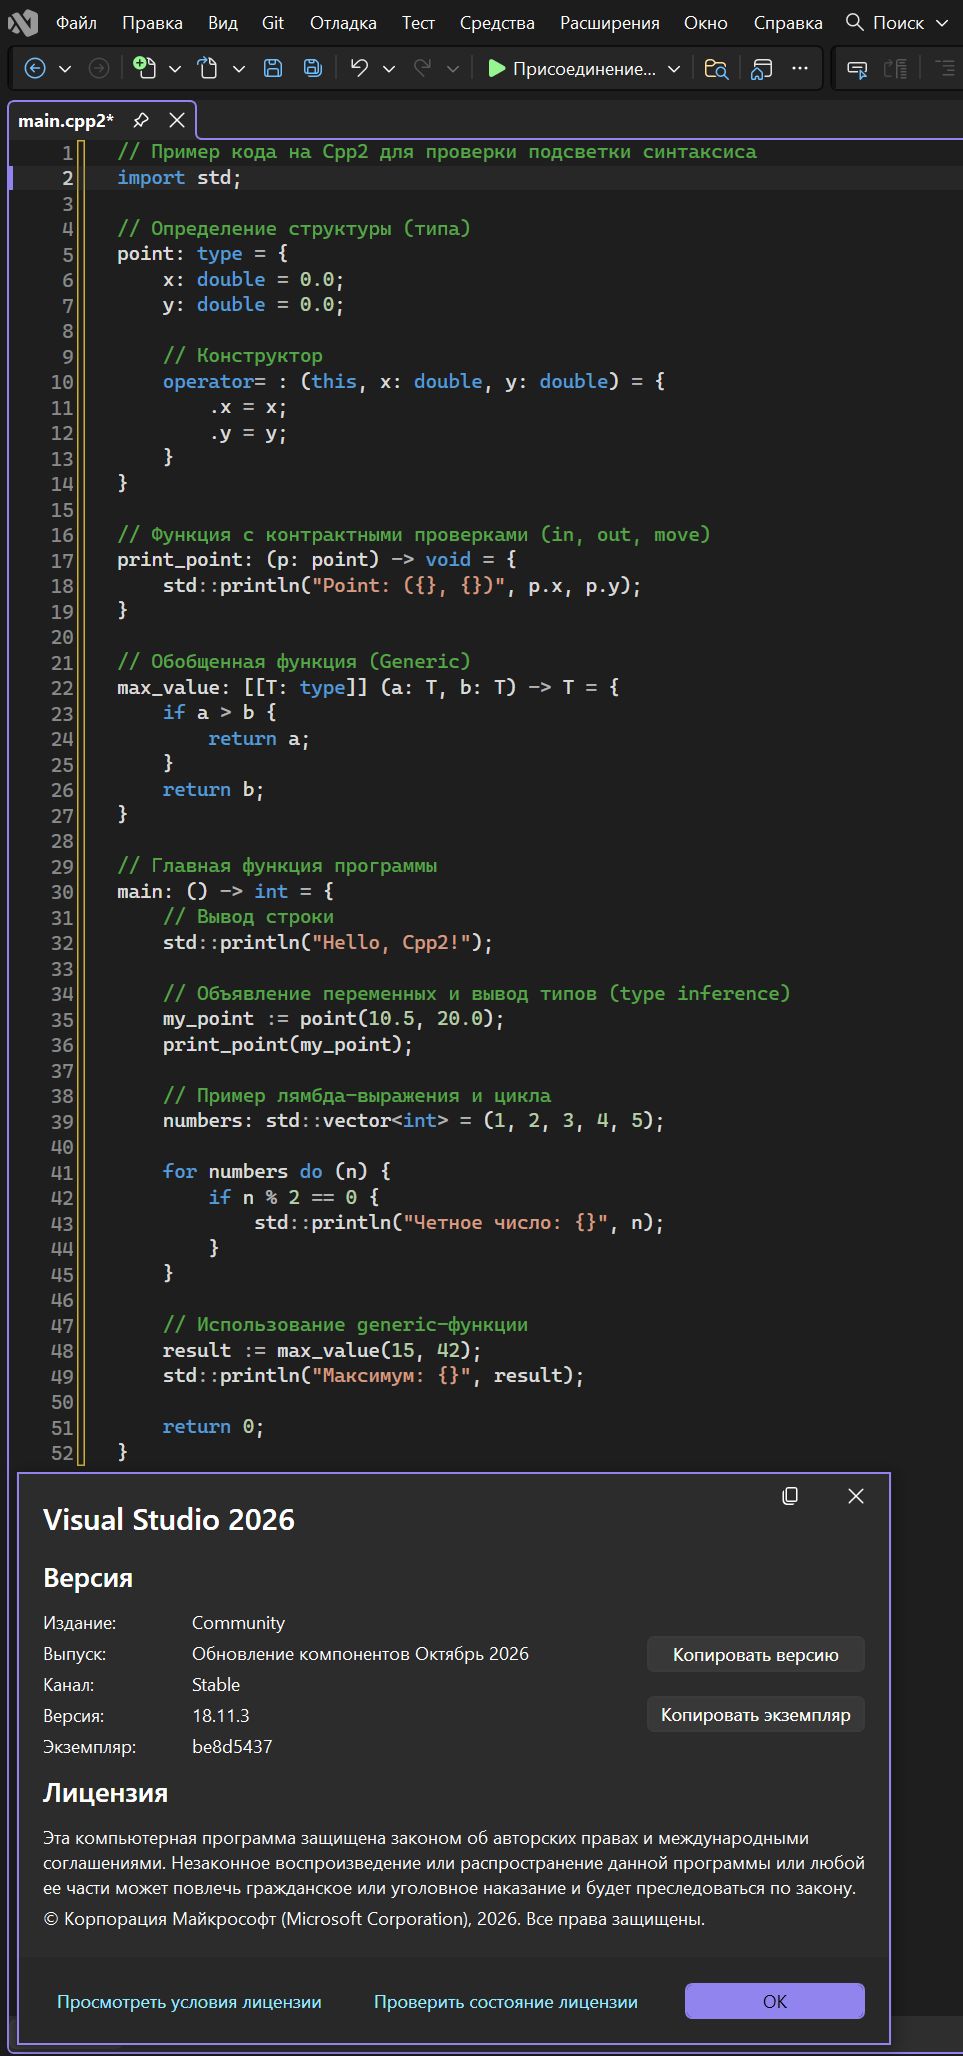
Скачать плагин можно здесь. Код не открывал ни разу, поэтому отказ от ответственности полный, окончательный, и бесповоротный :)

потому что подсветка вещь довольно элементарная.
А вот поиск определений, отладка и пр. ...
«Программа закончена не тогда, когда она делает то, что просили. Программа закончена тогда, когда она, помимо этого, ещё и не делает то, что не просили.» ©
Скажите, а вы точно уверены,что это не решается фронтир моделями? Вы пробовали?
Нет, я не пробовал. Я решал по старинке, и в любом случае планирую разобраться до конца. Мне было интересно сравнить, спасибо вам за возможность такого сравнения. Пожалуй, надо будет пересмотреть своё отношение к передовым моделям. А вы под «карасиком» что имели в виду, если не секрет?
Нет, я не пробовал.
На будущее, просьба (не только к вам, а ко всем), кидать только проверенные задачи, с которыми не справляются облачные фронтир модели.
А вы под «карасиком» что имели в виду, если не секрет?
Одну из собственных доработанных локальных моделей. Я такие модели просто называю Karasique. Исходные модели, из которых делается карасик, обычно относятся к Qwen, Gemma или Mistral семействам в различных дистиллят комбинациях.

С кодом не проще, там ровно та же история. Ведь генерённые плейбуки тоже работают - в тех условиях, в которых их сделали, верно? Это называется функциональные и нефункциональные требования, функциональные ИИ реализует прекрасно, но вот когда речь заходит о том, что сложно непротиворечиво сформулировать и протестировать - надёжность, безопасность, масштабируемость, учитывание особенностей текущей команды/бизнеса, etc. - тут ИИ пока не выдаёт вообще ничего адекватного.
Видимо поэтому вайбкод поделки залетают моментально, а вот сделать их продуктом, который при этом можно сопровождать и развивать, получается далеко не всегда
вайбкод поделки залетают моментально
Смотря какое значение слова тут имеется в виду — «залетать» или «залететь»...

Жалко одно, что китайские друзья не могут за эти же 20$ дать по лимитам Opus/Sonnet аналоги 😥

Я бы сравнил это с ездой на поезде и на автомобиле: На поезде комфортнее всего - ты спишь, а он едет. Но вариантов куда ты можешь приехать намного меньше, чем на автомобиле, а тем более пешком.

У китайских друзей две проблемы:
1) Они отстают от Opus и даже Sonnet, но это и так все знают.
2) У них эффективно меньше лимиты. По токенам, конечно, больше, у того же z.ai несколько сотен миллионов токенов на среднем тарифе на 5-часовой лимит. Но это полностью нивелируется тем, что китайским нейронкам приходится думать гораздо больше на тех же задачах. И эти миллионы токенов очень быстро улетают.
На том же Claude Max x5 физически нельзя выжрать ни 5-часовой, ни недельный лимит 1-2 параллельными сессиями даже если гонять их 24/7. Если нет субагентов и если специально не кормить ему в контекст многомегабайтный файл, а потом ждать час чтобы слетел кеш токенов. А просто какая-то долгая задача типа сложного рефакторинга, где 30% времени он думает, а 70% времени ждёт пока что-то скомпилируется и пройдут тесты. Исчерпание 5-часового и недельного лимита у Claude это проблема либо Pro, либо sub-agent heavy сессий. А на Max x20 5-часовой лимит можно выжрать было только ultracode на десятки и сотни агентов.
А у z.ai на среднем тарифе (он, конечно, стоит не 100$, а 80$, но будем считать его аналогом, потому что он посередине в линейке) при работе над сложной задачей в ОДНУ сессию и БЕЗ субагентов 5-часовой лимит кончается примерно за час. Допустим, ты каждые 5 часов ему пишешь "Продолжай", недельный лимит в таком режиме исчерпывается примерно на третий день. После этого ты должен сидеть 4 дня без ИИ. При этом в дашборде у тебя несколько сотен миллионов токенов и вроде как тебе дали гораздо больше токенов, чем в Клоде, но ты почему-то сидишь с потраченными лимитами и без сделанной задачи.
При этом на максимальном тарифе за 160$ обещают лишь в 2.5 раза выше лимиты, то есть если верны их же маркетинговые материалы, то даже на максимальном тарифе 5-часовой лимит будет стабильно улетать раньше окончания окна (на максимальном Claude Max x20 5-часовой лимит сжечь был тот ещё челлендж, не удивительно, что его недавно отменили).
Выходит, что Антропики дают чуть ли не больше токенов (в пересчёте на сделанные таски), чем китайские братья.
Короче, я бы просто зарегал новую учётку в случае бана, ознакомившись с гайдами как снизить шансы в этот раз (недавно была статья).
При этом мне очень не нравится тенденция, что две крупнейших ИИ компаний решают, что "легально" делать с помощью их моделей, а что нет. Как недавно случилось с запретом реверса (который при соблюдении пары условий легален и в самих США, и в большинстве других стран).
В августе лимиты glm были очень свободные. 80$ тариф на 3 месяца со скидками получился по 56$ в мес. В один поток, без агентов израсходовать невозможно совсем. Если только по 3-5 агентов параллельно.
Ещё есть flash, но он тупой
Сильно урезали с лета? Я давно не попробовал
Их просто утром не надо использовать чтобы не попасть в китайский час пик

абсолютно все задачи и на работе, и в пет-проектах делаю на glm-5.3-flash, субагенты - minimax-m3.1-flash, офигенно все получается
да, у меня есть несколько обвязок для ревью/правок замечаний, но работает все отлично, и по лимитам шикарно (глм за 80, минимакс за 20)
кто жалуется на лимиты - либо не настроил себе харнес и полагается на дефолт в клоде/кодексе, либо не разобрался в чем-то, потому что лимиты просто космические в глм/минимакс

Это временно, как я понимаю там уже почти предел умности модели достигнут, дальше только оптимизация. То есть через год у Китая будет высокоуровневая модель, а может и раньше, а у антропик и опенаи будет что то чуть получше и поудобнее, но сама модель особо не вырастет. Как в период бума процессоров уперлось все в то что полупроводник нельзя больше уменьшить тем способом который раньше использовался, так и тут мы уже уперлось в то что добавление весов и запуск запроса по промту как правильно ковырять в носу на 500 видеокартах не так сильно влияет на результат и это неэкономично. Я боюсь предположить, но возможно даже у нас к тому времени будет такая модель как у этих топовых сейчас. В общем я все инструкции и правила и скилы сохраняю в резервной копии, и вам советую.
предел умности модели достигнут,
Возможно. Но предел скорости ещё нет
Кстати, Kimi сам тормозной, но запустить десяток команд power shell одновременно он научился, а вот за Клодом я такого не замечал

сама модель особо не вырастет.
Что-то у меня нет ощущения что развитие замедлилось, скорее наоборот.
С другой стороны, я с вами соглашусь в том, что и китайцы быстро движутся вперёд, их модели уже достаточно «умные» для многих применений. Не исключено, что няня с какого-то уровня профита для большинства применений от дальнейшего развития просто не будет
Я бы даже сказал, что развитие ускорилось. По крайней мере последние месяца 3 (что в закрытых релизах, что опенвейт) ИМХО прогресс был больше чем за пол года перед этим, если не больше.
Не исключено, что няня с какого-то уровня профита для большинства применений от дальнейшего развития просто не будет
А что такое "няня" в этом контексте? Не слежу за нынешним сленгом в LLM.
А я бы поставил на то, что ограничение на реверс уберут. Потому что их могут пытаться засудить и за наличие ограничения и за его отсутствие, но перспективы у отсутствия ограничения выглядят получше. Скорее всего их сейчас просто кто-то из крупняка взял на понт, нужно было быстро решать, и они нарешали, а чуть позже наступит отходняк.

Я на уровне почти хобби пишу код на дипсике.
Очень удобно и производительно, учитывая что я только проверяю нужную функцию. Но сегодня дипсик решил ограничить количество портянки ответов. По моим представлениям размер одного чата уменьшился до 3-7% от того, что я две недели назад получал.
Одним словом зашёл в АйТи и тут же вылетел.

так количество текста не всегда означает его качество, если по качеству осталось на таком же уровне, то это даже лучше - компактнее ответ
Некоторые промпты не могут быть уложены в сжатый ответ.
Если говорить о генерации кода, то сейчас дипсик стал на уровне даже ниже, чем когда он появился.
Даже просто вывести в тхт список от 00000 до 10000 он не может. А именно с этого промпта я начал знакомиться с подобными моделями.
Для работы нужно было выводить подобные списки и я не хотел делать их по старинке в ручном режиме.

"Напиши однострочник на bash или python для генерации такого-то списка".
Такое ведь может? А если агент - попросить выполнить. А если где-то в скиллах описать, что "если есть задача что-то генерировать по алгоритму, то напиши код, который это сгенерирует, и выполни" - может быть будет ещë быстрее и точнее.

Как можно по представлениям оценить что-то с точностью 3-7%?
Я использовал также промпты, что и в других чатах и измерял полученный ответ (количество строк кода на котором происходил лимит). Сами проверить можете. Посмотрите свои чаты, которые пару недель назад вели. Они гораздо более объемными будут.
Сейчас написать код более 700строк нельзя, сразу лимит и блокировка чата. Год назад мне писал более 2000 строк и в одном чате по 15-20 вариаций такого кода выводилось.
Вы там бесплатный вебовый, что-ли используете? Тогда удивительно, что раньше лимитов таких не было.
Да, удивительно. Хороший инструмент был. Для хобби он оптимальным был, мощно и не затратно.
С документацией я даже на работе пару раз применял. Помогал обратить внимание на сноски в тексте. При обычном просмотре их обычно не успеваешь заметить из-за спешки.
Ну дело конечно хорошее, но жаловаться, что вам не дают миллион токенов контекста и 384К токенов на выходе на халяву ну... как-то слегка нагло что-ли, учитывая, что они не шибко в целом то и много денег хотят.
Плюс утверждая это о модели в целом, а не бесплатном доступе в вебе.
Да и какая-нить агентская сессия на 100кк токенов (понятно, что 90+% из кеша) будет стоить ну... центов 50. Если так сильно надо и чата вам хватало, думаю баксов в 5 в месяц уложитесь.
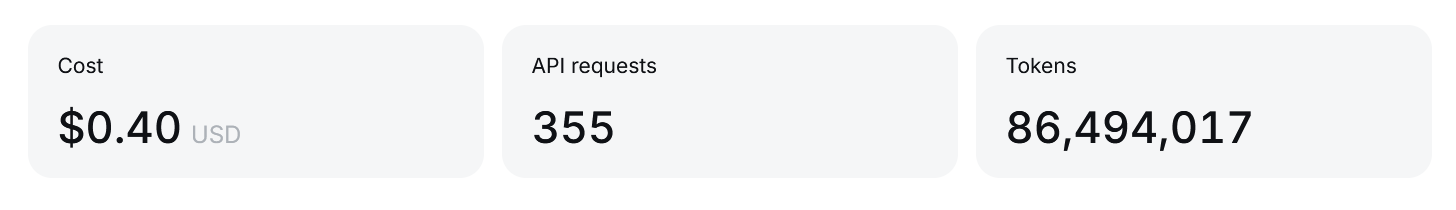
Там вроде ничего не менялось, как было 384К лимит, так и остался. Может это то, в чем вы это используете свой лимит включило? обычно там есть настройки макс токенов и тому подобного.

Одним словом зашёл в АйТи и тут же вылетел.
понимаю Вас, я тут тоже недавно решил влететь в сферу музыки - открыл Suno, нажал "сгенерировать трек", а оно мне аж 3 выдало! ууу класс, думаю, чуть поменял промпт, нажал еще разок. В общем, мой первый альбом уже почти готов был, как лимит закончился. К сожалению, карьера музыканта оборвалась /s
В своём случае я говорил о самоиронии. У нас просто сисадмины все стали называть себя "спецами из айти", потому что почти все проблемы стали решать, если конечно же интернет не отключили.
в таком случае, только поддерживаю такую иронию. Просто сейчас всё сложнее понять, где ирония, а где реально заряженные агентами айти-спецы, магистры кнопки "ok". Провел некоторое время в комментариях на ютубе и уже отвык, что на Хабре здравый смысл пока еще жив
Меня самого забавляет вайбкодинг вне хоббийного применения. Конечно же в качестве входа в дисциплину программирования для студентов и школьников это мощный помощник. Но когда "специалист" заканчивается вместе с токеном, это печально.
Когда-то давно у меня по должности был допуск к самостоятельной работе на Наире. В тот же период руководитель отдела мне сказал, что я никогда не буду программистом, ибо мышление у меня не свойственное, да и в точных науках я не доцент. И я такую критику воспринял подобающе. А сегодня, когда есть самописцы кода только убедился в этом.
Скоро начнут собираться группы бывших вайбкодеров с синдромом отмены. Потом болезнь добавят в МКБ. Но скорее всего раньше придёт чебурнет.

Когда пишу фронт через нейронку - все классно, но я мало что понимаю во фронте, а когда пишу инфру, то вижу какой мрак мне накидывает клод/дипсик и где отстрелю себе ноги, если пущу это в прод.

Да, нейронки лучше всего работают в тех областях, в которых вы не разбираетесь.

Не только. На фронте и в инфраструктуре попросту разная цена ошибки.
Для фронта стратегия “позволить нейронке творить всё что хочет, а если упадёт - попросить исправить” работает прекрасно, результат получается хуже чем у опытного фронтендера, но дешевле и пользователи всё равно схавают. А если хоть немного понимать в UX, то результат может получиться даже лучше чем у “опытных” фронтендеров.
Для инфраструктуры такая стратегия однажды приведёт к удалению БД.

Проблема вылезет при попытке масштабировать такой фронт. Нейронка наплодит дублей компонентов и спагетти-стейтов. Через полгода добавление новой кнопки будет занимать неделю

Через полгода добавление новой кнопки будет занимать неделю
Или миллион токенов. Но ведь это будет через полгода, кто ж сейчас планирует на такие длительные сроки?

У фронта нет состояния которое нужно хранить, через полгода его можно будет переписать с нуля с учётом всех граблей
Не будет, каждую новую кнопку на фронте можно делать с нуля, как будто вокруг неё ничего нет. Люди с таких проектов разбегаются, но нейронки упорные и выгорать не умеют.
странно, cloudflare/aws падает всего несколько раз в код из-за нагенерированного ИИ кода. это прям очень мало по сравнению с вашей оценкой
Дипсик пока вообще плох в терраформе, даже простые модули путает
Но давайте критически взглянем, что же реально поменялось? А поменялось многое: сегодня даже люди гуманитарными специальностями способны навайбкодить собственные приложения без погружения в технические детали. Подобный бестолковый вывод кочует по всем АИ статьям. Конечно же, ни один экономист и hr 10 лет назад не смог бы нанять пакистанца на апворке и сваять приложение за цену чуть ли не дешевле, чем придется потратить на токены сегодня и такого же качества; да, написано оно будет не за пару вечеров и потока промптов, а за пару недель с поломанным английским в зуме, но результат будет плюс минус таким же. Нет, для экономиста и hr-а это никогда не являлось препятствием. Реальные, изменения лежат совершенно в другой плоскости, и они максимум эволюционные.

Поддерживаю! Всем любителям говорить "а что вы без своего ИИ сделать руками сможете, если его завтра отключат", предлагаю вспомнить как в своё время абсолютно так же говорили про "а что вы без своего интернета/компьютера/электричества сделать руками сможете, если его завтра отключат".
Если у слесаря забрать его инструменты (например отвёртку и ключи), а у токаря забрать станок, они тоже мало что смогут сделать. Современные LLM - это такой же инструмент. Есть возможность пользоваться - однозначно надо пользоваться! Особенно в сейчас, когда технологический процесс шагает семимильными шагами

Так у всех батхерд вызывает лайвкодинг без подстановок.
как в своё время абсолютно так же говорили про "а что вы без своего интернета/компьютера/электричества сделать руками сможете, если его завтра отключат".
(Ворчливо:) Ох уж мне эта молодьож. Ничо уже без компьютера не умеет,


Раньше инструменты вмешались в рабочий компьютер, работать без интернета вполне можно если заранее скачать необходимую документацию. Практически все рабочие инструменты были детерминированными и не требовали много ресурсов.
С ЛЛМ ситуация различаеться, слишком много ресурсов требуется, что в итоге приводить к зависимости от провайдеров.
Есть ощущение, что с разработкой специализированных чипов появится возможность массового запуска локальных моделек с приемлемым качеством работы. Такая же история была и с криптой: сначала майнили на обычных видеокартах, а потом появились специализированные чипы и карточки стали не нужны. Я даже помню этот короткий период, когда на авито можно было купить за смешную стоимость топовые видеокарты, но всем было понятно, что они фактически трупы из-за круглосуточной работы на 100% загрузки в течение нескольких лет. Никто их и не брал.
Железячная отрасль это реальный сектор экономики, а он развивается с достаточно большим лагом к технологическому сектору, поэтому начало массового распространения "домашних" чипов стоит ждать через год или полтора. Там гляди и нейросетевые монополисты начнут из-за этого загибаться, если к этому моменту не изобретут наконец свой AGI

отсутствие опыта работы с перфокартами явно не стало нашей слабой стороной
Слабой не стало, но программисты прошлого за счёт необходимости "семь раз отмерить, а потом один раз отрезать" допускали меньше ошибок в программах. У меня нет доказательства, я опираюсь лишь на субъективную картину - современные программы и устройства тупят нещадно.
У меня дофаминовые волны чередуются с паническими атаками - я не понимаю до конца, как работает программа, не знаю её архитектуры. В эпоху ручного программирования я мог забыть какую-то часть проекта, если не касался её месяц или более, но беглого взгляда на код хватало, чтобы быстро всё восстановить в памяти, и достигалось это годами практики написания программ, которые самому же и придётся поддерживать. До недавних пор я никогда не задумывался о том, как это получалось, но сейчас понимаю, что это подсознательная смесь из культуры форматирования, именования и структурирования кода, которую среди прочего я перенимал из тех проектов, над которыми работал (включая открытые проекты). Код который генерирует ИИ - мёртвый. Что в моих проектах, что в чужих, которые я читал. Я вроде и понимаю, что там происходит, но не могу в него "погрузиться". Можете называть это как хотите.
Согласен. Тут походу да, конец эпохи. И от этого у многих бомбит. Всем в руки дали очень мощный инструмент.
И ваши волны, это только на руку ИИшке, это прям что-то из наркомании. Бури эмоций.
Нейронка пишет просто усредненно и без контекста бизнес-логики. Так сказать решает задачу в лоб, без задела на будущее расширение. Поэтому код и выглядит чужеродным и тяжело читается
Потому что для полного соответствия надо чтобы у модели были знания (в контексте) о компании, еë бизнесе, целях и задачах, о ближайших конкурентах и т.п., потом надо знать о своëм месте в этой компании, обязанностях, знать инструкции, в т.ч. кучу местных для служебного пользования, всякие кодстайлы, изучить все репозитории в компании (доступные) и документацию, и т.д. Вот тогда результаты будут максимально похожи на те, что выдаëт конкретный программист в этой компании.
Проблема в том, что далеко не всë это есть в виде документации - часть знаний и требований рождаются в созвонах, совещаниях и брейштормах, и даже при обычном ежедневном общении сотрудников между собой, и с руководством. Порой эта информация так и остаëтся в головах людей, и люди считают эту информацию как будто "это и так всем понятно", но модель-то это не знает.
Если же всë это скормить в контекст модели - окажется, что это слишком большой объëм информации. У людей эта " оперативная" память со временем записывается в долговременную, и человеку не нужно напрягаться, чтобы это помнить и применять, он почти подсознательно это знает и использует. Агенты в какой-то степени так тоже умеют, но это всë равно нужно сильно допиливать под свои задачи.
Если же всë это скормить в контекст модели - окажется, что это слишком большой объëм информации.
Поэтому я перешел на вот это.
Крупные компании со временем могут обучать ИИ под конкретно свою организацию. Что даст контекст без увеличения требований к железу, а то и уменьшит их.

Я вроде и понимаю, что там происходит, но не могу в него "погрузиться". Можете называть это как хотите.
Предполагаю, что это связано с тем, что у нейросети в весах зашито множество архитектурных подходов, методик, паттернов, стандартов. И если человек обычно придерживается одного выбранного подхода, то нейросеть, вероятно, будет выбирать подходы/паттерны/etc с некоторой долей случайности.

Лучшие практики ему в контекст. Вообще странно что даже на сайте agents.md нет конечного стандарта "что такое хорошо" на каждый стек. Столько статей и книг понаписано про совершенный код, управление сложностью и знаниями. Вероятно, дело времени когда указываешь стек и тип приложения, и агент просто берет стандартный шаблон. И тогда читабельность будет, и проверяемость и скорость. Как ява после ассемблера
Точно также, как бухгалтеры не стали тупее из‑за того, что пересели в 1С с бумажек и ручного обсчета ведомостей с кулькулатором
К сожалению стали. Пару раз пришлось отказаться от аутсорсинга таких специалистов. Спрашиваешь "Ну вот одно число (совпадает) минус второе число (совпадает), умножаем на процент = должно получиться столько? -ДА! - А почему в вашем отчете другое? - 1С так посчитала..."

Ну так это тоже самое что и Клод вам портянку выдаст, проверять все нет возможности, иначе зачем он тогда нужен, вот и бухгалтер не проверяет все цифры в отчете, если все пересчитывать (восстанавливать контекст), то какой тогда смысл от автоматизации с помощью 1с? Мне это тоже конечно не всегда все нравится, но наверное такова цена прогресса.

вот и бухгалтер не проверяет все цифры в отчете
А когда налоговая ошибку найдет, он тоже скажет "так 1С посчитала" ?
Он так конечно может сказать, но это не убережет его от штрафа)
Нюанс 1С и нейронок в том, что в случае первой вывод на одинаковых данных всегда будет один и тот же, а вот у нейросетей вывод не детерминирован. Иными словами они могут одну и ту же задачу с аналогичными вводными решить по-разному.
С обычными инструментами автоматизации у вас есть доверие к ним, что они будут работать как вы ожидаете (не всегда оправдывается, но хотя бы их косяки будут проявляться постоянно и предсказуемо), а вот взаимодействие с нейронкой упирается скорее уже в веру, что она не накосячит. У меня сейчас так с Кими - я ей вообще не верю и проверяю каждый шаг. Клоду до этого верил. Делал ли он все ровно как мне надо? Не знаю, думаю это вопрос риторический
С обычными инструментами автоматизации у вас есть доверие к ним, что они будут работать как вы ожидаете (не всегда оправдывается, но хотя бы их косяки будут проявляться постоянно и предсказуемо), а вот взаимодействие с нейронкой упирается скорее уже в веру, что она не накосячит.
Мне кажется для обычного пользователя принципиальной разницы нет - и то и другое вне сферы его контроля и тем более компетенций.
А нюанс в том, что независимо от инструментов, человек обычно несет ответственность за результат своей работы, сделанной с помощью этих инструментов. И в этом плане пока мало что поменялось.
Пример с бухгалтером, кстати, очень примечательный - 1С нынче тоже могли дописать нейронками.

Потому что 1С знает про decimal, а большинство программистов - нет?

А это точно их отчет, а не ваш? Они ж его код не писали, с чего бы они отвечать должны за расхождения?..

Потому, что они бухгалтеры. Проф бухгалтер - это злобный зверь, который видит где там цифра на пол процента поехала. С другой стороны и с 1С я уже не помню когда сталкивался с тем, чтобы врала напропалую.
Чаще ситуация когда проф бухгалтер видит что цифра не та, что он ждет и или сам на несколько расшифровок или в обнимку с 1С программистом выкапывает тот документ, в котором оператор не ту аналитику поставил. Правится аналитика, перезакрывается месяц, цифры встают куда надо и все довольны.
Все более массовый не проф бухгалтер пропускает отчет дальше, что ведет к переплатам или штрафам при кросс проверках.
Проф бухгалтер - это злобный зверь, который видит где там цифра на пол процента поехала.
Я бы сказал не на полпроцента, а на одну копейку, пусть даже в отчете с десятизначными числами.
Ну “на копейку” я не готов утверждать, а вот ошибку в 50 рублей в стоимости дня отпуска не видя таблицу для расчета среднего и околопроцентную в себестоимости (опять же, без сопроводительной таблицы) при мне ловили.
Знаете, я когда только открыл ИП в 2010 году, отчётность была гораздо сложнее чем сейчас. И сдавать надо было в бумаге. В первый же год я накосячил в отчётности на 76 копеек. Пришлось доплачивать какие-то микроскопические пени, раза 4 ездить в ФНС и ФСС со стопками бумаги и разговаривать с множеством безразличных людей,.
Я не бухгалтер, но свою отчетность с тех пор проверяю до копейки.
Я до сих пор помню аналогичный случай со мной из за одной копейки. Прислали бумажным письмом(при наличии электронной отчётности), потом ещё два раза пришлось распечатывать и сдавать в бумажном виде. Пени не насчитали, хотя срок прошёл, видимо сумма не дробилась.
С тех пор ввели округление до рубля и единый счёт(но не для всего к сожалению).
Не помогает. Подавал на вычет на днях в упрощенной форме за 24 год. Это когда сам никаких доходов не вводишь, налоговая просто складывает поданные декларации. Так по итогам суммы всплыл недоплаченный рубль налога. Доначислили и его и 16 копеек пени. Хотя все декларации были у них в руках, по хорошему должны были прислать прошлой осенью, чтобы я доплатил в декабре.

У меня в голове такой вот интересный вопрос:
Раньше разработка ПО обрастала слоями. Сверху машинных кодов - ассемблер. Сверху ассемблера - ЯП высокого уровня. Поверх него библиотеки, а потом и фреймворки. Потом контейнеры, микросервисы, их взаимодействие.
Все для того, чтобы сделать какую-то бизнес фичу не нужно было погружаться в алгоритмы сортировки, или в работу pnp переходов. А вместо этого можно было взять несколько кубиков, добавить своей логики и получить готовое решение.
Но в таком подходе есть и минусы. Помимо того, что разработчики вместе с библиотеками и фреймворками получали знания и опыт разработчиков фреймворков, обернутые в удобный интерфейс, ещё они получали какие-то решения, в том числе и компромиссные, которые никак не соотносятся с прикладной задачей, которую вы решаете сейчас.
Например, вы можете подключить библиотеку для работы с кубернетес на 20 мегабайт, а можете выполнить обычный rest запрос. А может быть вам нужно посмотреть запущен ли контейнер, и это можно посмотреть в /proc прочитав файл. И не выполнять миллион машинных операций, порождаемых чепросом через API
Для человека сложно в голове держать большой контекст. Да ещё контекст того, о чем ты понятия не имеешь. А если разбираться с каждым вопросом с нуля, то это занимает много времени.
Но теперь, с появлением ИИ разработки это стало как будто бы не очень большой проблемой.
Так вот вопрос в том, повернет ли индустрия к тому, что вместо того чтобы писать ещё больше кода, обрастающего слоями - начать писать код, который выполняет ровно нужные задачи? Чтобы размер приложений снова измерялся не в гигабайтах, а в килобайтах, а работали они годами на процессорах 8Мгц от батарейки для часов? Ну или хотя бы чтобы обновление ПО не требовало обновления железа раз в пару лет.

Насколько я вижу, cмысл в слоях всё равно остаётся:
1. Вам нужен слой обеспечивающий портируемость между платформами. Писать свой ASM код под каждый процессор не имеет смысла для даже для ИИ
2. Так же никуда не деться от протестированности кода. Популярное решение всегда будет более надёжным чем написанное на коленке, просто в силу того что его увидело больше глаз (настоящих или искусственных)
Про популярные решения , которые более надёжные, чем самоделки я с вами согласен.
Но тут у меня тоже есть некоторые опасения. Раньше такие решения появлялись из "сделанных на коленке", а потом годами обрастали мясом. Может быть они не всех на 100% устраивали, но ими пользовались. Потому что целиком сделать примерно тоже самое было долго и дорого.
Теперь же это условно быстро и не очень дорого.
Не получится ли так, что вместо популярных отлаженных решений мы получим миллион похожих, но разных, с разными проблемами? И выбрать из них будет невозможно. И вместо этого вы будете делать миллион первое свое решение.
Еще один парадокс: надёжное решение это то, которое не изменяется. Но это же значит, что оно не развивается. С одной стороны вы точно знаете, что если его взять, то оно будет работать точно так, как нужно. А с другой - там не будет ничего нового. Иначе это сломает совместимость.
Вам нужен слой обеспечивающий портируемость между платформами. Писать свой ASM код под каждый процессор не имеет смысла для даже для ИИ
А почему нет? Ассемблер куда компактнее чем какое-нибудь средненькое UI-приложение, не говоря уже про большие.
Да и необходимость портируемости под вопросом, когда срок жизни приложений исчисляется неделями и месяцами максимум - их быстро заменят десятки новых
Думаю вернутся к легковесным узкоспециализированным библиотекам под конкретные задачи

Уже есть такие результаты. Например, драйвер дисплея для ESP, который поднял FPS с 7 до 60.
> и я не хочу снова работать по‑старому
Не Антропиком единым.
У китайских моделей реально беда с контекстным окном на долгих сессиях, заявленные миллионы токенов испаряются за пару часов активного дебага

Сначала блокировка прозвучала, как гром среди ясного неба, как ушат холодной воды перевернули. А сейчас думаю: ну, во‑первых, не на помойке я себя нашел, чтоб лезть обратно к Антропикам окольными путями после их расистской выходки. Во‑вторых: а на ту ли я дорожку свернул, что понадеяся на «дядю»?
Рвботал как-то полгода назад руками, руками автоматизировал рутину и ничего, не умирал. Даже больше скажу, уставал точно так-же как и с ИИ, только контроль над свой же кодовой базой был детальный. Сейчас вот думаю, завтра понедельник, я открою свою либу, а она уже не "моя". Полагаю, теперь буду только точечно применять ИИ и больше для учебы самого себя.
Проблема в бизнесе и капитализме.
Бизнес требует "быстрее и ещë быстрее, пусть с багами, потом поправим". Бизнес хочет чтобы каждый стал фулстеком - пофиг, что ты не программировал на каком-то языке - бери агента, "прогроммировай!.jpg"
Берешь, пишешь запросы, краем глаза смотришь что код похож на то что надо, проверяешь что он работает, проходишь ревью, как-то с тем же агентом правишь недоработки, отдаëшь на тесты (да скорее всего сам же тестируешь - ведь ты теперь и швец и жнец и на дуде игрец).
В итоге - быстро - да, один человек с агентом сделал всë вместо 3-4 человек - да, можно сократить "лишних" (по мнению бизнеса) - да. Но - в итоге нет никого, кто знает, что там в коде происходит, и сопровождать это без ИИ и без сохраненных сессий работы с агентом уже очень сложно.
При этом на специалиста будут вешать не 2-3 проекта параллельно, а с десяток (сбер уже так сделал, судя по публикациям тут на хабре). Но переключение контекста выматывает сильнее гораздо, чем написание кода в одном проекте. И рулить агентами, которые пилят разные проекты - путь к очень быстрому выгоранию.
В общем, пока не очень веселая картина складывается. Посмотрим.
Вопрос только в том какую ценность имеет ваш софт, а не в том как вы его пишете или может быть вообще украли. Поделитесь, что за софт, в чем его ценность?

Поэтому надо развивать свой ИИ и свои инструменты. Искать пути и способы к устойчивому развитию в технологиях. Чтобы в один прекрасный день, когда вас забанят, заказчик на которого вы работайте не столкнулся с резким падением качества вашей работы.

ИИ учится на коде хороших программистов, если сами хорошие программисты перейдут на ИИ, есть риски, что этот ИИ скатится до быдлокода как например у большинства библиотек Arduin-щиков, у которых вроде работает, но не из-за понимания в коде много мусора и он может глючит на шаг-влево-вправоот нестандартного использования.
Для примера: производительность ПК выросла, появилась куча готовых универсальных библиотек и фреймворков, хорошие программиты для ускорения написания перешли на них, как результат теперь программа вроде обычного блокнота может жрать ресурсы почти как старый полноценный офис вместе с ОС.

Ещё можно попробовать Antigravity, подписку продают за 200 рублей на 18 месяцев. Лимиты у 3.8 flash достаточно большие. Жалко Argon только недоступен

там расово верный акк нужен в гугле, иначе только веб-версия работает, а токен дает 400 ошибку

a) Antigravity (desktop) и Antigravity IDE - Electron приложения. Элементарно патчатся, чтобы не срубаться на неправильно регионе. Это локальная проверка. С agy (которая cli) - действительно сложнее, но не очень-то и хотелось
b) Есть опции покупки refresh token. Т.е. вы через Cockpit Tools запускаете Antigravity или Antigravity IDE. В этом случае ни через браузер, ни через что-то иное аккаунт не перейдет в неправильный регион. Но и риски выше - продавец ведь вам токен выдал, может и сам пользоваться...
c) Поскольку проверка локальная (см п.1), мне Antigravity написал локальный прокси к самому себе. Т.е. Claude Code или что угодно идет через локальную проксю, меняющую все на "как бы Antigravity". Уже который месяц так работаю через аккаунт, который однажды переключислся на РФ и "отвалился" в нативной (не патченной) Antigravity.

Наивно полагать, что китайцы не сделают тоже самое. Но делать они это будут с изюменкой - сначала перетащат к себе основную массу пользователей (бесплатный доступ, постоянно растущее качество), а потом начнется следующий этам эншитификации - постепенное искусственное зарезание функционала (отупление) для зарубежных пользователей и повышение цены. В итоге, получится как в старом анекдоте: мыши будут плакать, колоться, но будут продолжать жрать этот китайский кактус. Так как подругому просто нельзя.

Тут вы правы, спрос рождает предложение. Там возможно уже видят наплыв массово успешно проходящих верификацию местных представителей некоренного населения) Всего лишь очередной раунд противостояния.

Я переключил Claude код на API Qwen (Qwen, Deepseek,GLM 19 моделей , за 68$ мес) , которая сингапурский Alibaba. И в принципе он продолжает нормально работать, подцепил MCP и все остальное. У меня именно в claude code было много незавершенных проектов, которые надо завершать.
Параллельно, я использую OpenClaw. Как план B, остается только DeepSeek, и, к счастью, на Alipay залить и нормально платить рубли занимает 20 минут. Вот что бан животворящий делает. (((
Также был проведен анализ Google и ChatGPT. Они также забанят за какое-то время, также влетают. Google у меня уже в бане, и Ai Pro недоступен. Ну, а ChatGPT – дело времени.

Спасибо за статью!
от себя хочу сказать, что всегда был интернет-предпринимателем. Не инженером, не кодером. И всегда страдал от необходимости обращаться то к одним то к другим (вы уж простите). А сейчас руки развязались и я могу в одного сделать себе и дашборды и парсилки и чёрта в ступе. Думаю ли я о том, что тупею? Да, мне однозначно нужно читать длинные тексты, чтобы не отупеть и что-то делать руками.

Чёт никто ни разу не упомянул Opencode - неужели никто не пользуется? Все живут в облаках? У меня на работе развернута своя инфраструктура и Opencode у каждого на РМ - с хорошим харнесс Deepseek V4.1 работает прекрасно!
Конечно не сравнивал с облачными решениями типа Claude/Codex - может их LLM и правда без контекста творят магию, хотя очень сомневаюсь).
Но дома себе для пет-проектов подключил Opencode Go и юзаю тот же Deepseek V4.1 по привычке (только на работе окно 256 к, а тут 1024 к). Собрал себе с нуля харнесс (3 mcp + 10 скиллов + молифицированный primary-агент) и за 10 баксов результат отличный! Пробовал Kimi K3 - очень много токенов кушает...в подписке много моделей разных, пока нет желания более дорогие юзать.

Claude Desktop стал для меня единым интерфейсом ко всему. Через него я смотрю мердж реквесты в Gitlab и там же прошу ответить коллегам, через него я делаю изменения в коде и выпускаю релизы, с его же помощью я дебажу проблемы на серверах и «грепаю» логи.
а потом народ удивляется, почему компании несут миллиарды openai/anthropic/google/китайцам/.. на развитие проприетарного ИИ. а США признало еще годы назад ИИ наиважнейшим направлением и дает ему зеленый свет везде и всюду.
Это же какая власть скапливается у провайдеров инференса ИИ? Так или иначе, рано или поздно, агенты с полным доступом ИИ к компьютеру пользователя будут установлены, включены и будут работать. И в минимальном виде это будет бесплатно, не потому что компании заботятся о людях, а потому что это следующий уровень контроля (выше чем просто иметь доступ к системам обновления на каждом компьютере в мире или ключам корневых сертификатов всего интернета) и главное юридически, пользователи самолично принимают (сначала спросят 'можно ли', потом по факту установки ОС, без вариантов отказаться, например домашним ревизиям, т.е. большему количеству, как будут организации выкручиваться хз, очень небольшое их количество сможет настроить ветку контроля обновлений и правильного доступа к данным и контролю утечек)




Жизнь после блокировки: нейронки изменили мою профессию и я не хочу снова работать по‑старому