Комментарии 22

Главное, что я для себя вынес из этих экспериментов, это неоднозначность влияния размера квантов и режима рассуждений на результаты. С чем это связано, я пока не знаю и не уверен, что готов разбираться.
Там особо нечего разбираться, достаточно понимать 3 основных момента:
Внутри модели разные слои вносят разный вклад в качество. Какие-то слои можно смело жать в Q2, какие-то не стоит сжимать ниже Q4.
В современных методах квантования используют калибровочный датасет. На словах он мультиязычный, а на деле, зачастую, на каждые 100 примеров будет 90 на английском, 5 на китайском, 3 на арабском и 2 на русском. Такая калибровка хороша для тех кто общается с моделью на английском. Для сохранения качества общения и рассуждения модели на русском нужно собирать свой калибровочный датасет и калибровать. Ну или искать кто это уже сделал и выложил.
Помимо квантования самой модели есть квантование KV-кеша в инференсе. И вот если там указать квантование K-части меньше FP8, то как бы удачно не была квантована сама модель, вы получите тупняк на среднем/большом контексте, в режиме рассуждения и периодическое зацикливание ответов.

Спасибо!
Глянул строку запуска llama.cpp, там действительно k-часть КV-кэша сильно пожата. А я после экспериментов с TurboQuant как-то и не обратил на это внимания. C:\Users\user.unsloth\llama.cpp\build\bin\Release\llama-server.exe -m --alias -c 65536 --fit on -ctk q4_0 -ctv q4_0 --jinja --host 127.0.0.1 --port 8080 --reasoning off
По поводу разного пожатия слоёв я в курсе. С учётом того, что у меня были кванты от Unsloth, которые вроде как умеют в это дело со своими UD, на эту часть я и не подумал.
Что касается языка, то т.к. бенчмарк на английском, то тут бы я не стал волноваться.

Я недавно игрался с GGUF-сборками, где разные тензоры пожаты с разным битрейтом, это реально дает лучший баланс между потреблением VRAM и качеством кода
Это ровно то, что делает упомянутая в тексте модификация GSQ-RCO.
NVIDIA-Nemotron-3.5-Bolt-74B-A9B-UD-Q3_K_XL.gguf весит 36Гб? Как вы ее запустили на 16Гб видеокарточке?
Магия MoE =). Я это упоминал в тексте. В интернетах полно статей с деталями типа этой.
Активные параметры весят около 9B, поэтому они спокойно влезают в 16 Гб VRAM

Все эти модели обойдет квен 3.8 флеш Некст
На вашем оборудовании можно запустить кодер модель, из которой вырезали половину экспертов
С движком страта, это даст примерно 60 ток в сек, с контекстом 130к
Цифры набросал ориентировочные
Сам запускаю полноценную версию q3
С 5080 + 64гб оперативки, даёт более 100 ток в сек
Но если честно, в этом 0 смысла, если только не нужна версия без цензуры, или если есть запрет на облачные модели
И.к. запуск кст электричество и уменьшает ресур железа, которое сейчас стоит недешево
Поэтому проще купить даже подписку за 20 баксов на чат гпт и использовать их модели
Причем это прям в разы выгоднее, если использовать условную луну
У меня была задача, для которой нужно было обработать более триллиона токенов( по большей части на вход )
Я посчитал, что на моем железе, это займет несколько лет
А если использовать луну, то обойдется примерно в 1.5к баксов
Если переводить их в лимит моей подписки за 200 баксов, то выйдет даже меньше недельного лимита
Вот и думайте ...)
Все эти модели обойдет квен 3.8 флеш Некст
Уже обошёл. За 8,5 минут. На RTX 6000 Pro. О чём и сказано в тексте.
С движком страта, это даст примерно 60 ток в сек, с контекстом 130к
Этот движок также упомянут в тексте.
Поэтому проще купить даже подписку за 20 баксов на чат гпт и использовать их модели
Не проще. О чём сказано в тексте.
Кстати, а вы его вообще читали?
Статью я прочитал. А вот вы мой комментарий, похоже, прочитали по ключевым словам. Вы тестировали Flash-Next на RTX 6000 Pro. Я предложил другую модель — Coder с половиной экспертов — непосредственно для вашей 4070 Ti Super через Strata. Это не тот эксперимент, который описан в статье. Потратить 150 часов на попытки «раскрыть» 27B, а в ответ на предложение проверить альтернативную связку сказать «эти слова уже есть в тексте» — это скорее техническая некромантия, чем поиск практичного инструмента. Поэтому перед вопросом «а вы вообще читали?» стоило разобраться, что именно вам предложили.
Я предложил другую модель — Coder с половиной экспертов — непосредственно для вашей 4070 Ti Super через Strata
Спасибо. Про эту модель я узнал в начале октября. Практическое подтверждение того, что она работает на моей модели видеокарты я видел ещё неделю назад тут.
Но материал для этого write-up'a у меня копился с начала сентября. Поэтому я и довёл его до публикации вместо продолжения бесконечного scope creep. Новая блестящая игрушка в виде Strata Qwen3.8-Flash-Next Coder от меня никуда не убежит. А если в процессе тестирования обнаружится что-нибудь любопытное, я не премину описать это здесь.
в ответ на предложение проверить альтернативную связку
С учётом написанного выше, а также в самом тексте, условная энтропия этой информации для меня равна 0.
это скорее техническая некромантия, чем поиск практичного инструмента
Практичный инструмент я уже нашёл. О чём и сообщил в тексте.
Я предложил другую модель — Coder с половиной экспертов
Она сломана, нельзя просто так выкинуть половину экспертов. Это неудачный эксперимент. Прежде чем предлагать, попробуйте сами санчала.

Адресовано комментаторам: квант 0 попробуйте, говорят вапще пушка))). Не понимаю почему у всех паранойя запихать в бюджетную видеокарту модели а-ля qwen 3.8 next flash и умиляться этому? Автор потратил честные часы на сравнение моделей в разных кванта, хирургии reap и. т. п. - респект 100%!
ПЫСЫ на своей железке dgx spark игрался с reap - ну такое себе, Вырежая редких экспертов легко похерить и нужных экспертов,
Спасибо.
Не понимаю почему у всех паранойя запихать в бюджетную видеокарту модели а-ля qwen 3.8 next flash и умиляться этому?
Поговаривают, что делать это с помощью "ванильной" Strata небезопасно, т.к. она тутже начинает скачивать не пойми что. Автор ролика предлагает свою версию, откуда удалён код на Python и лишние поползновения в Интернет.
на своей железке dgx spark игрался с reap - ну такое себе
А что за модель была? Может её и вправду криворукий хирург лоботомировал. Я свою случайно нашёл, но потом в интернетах натыкался на восторженные отзывы о ней. Вот эта версия: barozp/Qwen3.6-28B-REAP20-A3B-GGUF
Поговаривают, что делать это с помощью "ванильной" Strata небезопасно, т.к. она тутже начинает скачивать не пойми что
Очередное "услышал звон и не знает где он". Есди посмотреть на код страты внимательнее, то увидете что там буквально вшиты предлагаемые репозитарии конкретных моделей и файлов с конкретными расширениями. Буквально вот пример из кода:
DSV41_ISTA_REPO = "ISTA-DASLab/DeepSeek-V4.1-Flash-1017-GSQ-RCO-GGUF"
DSV41_ISTA_ENGRAM = "DeepSeek-V4.1-Flash-Engram-IQ4_NL.gguf"
DSV41_ISTA_SHARD = "DeepSeek-V4.1-Flash-1017-GSQ-RCO-{quant}-{i:05d}-of-00004.gguf"
DSV41_DSPARK = "dspark-DeepSeek-V4.1-Flash-1017-Q8_0.gguf"
DSV41_ISTA_FILES = {
"DeepSeek-V4.1-Flash-1017-GSQ-RCO-IQ1_M-00001-of-00004.gguf": (39358830464, "6e3f0d5ff53d00428ec32c079db9e8255cb410ccaa435e5342aaa8a47fe1339d"),
"DeepSeek-V4.1-Flash-1017-GSQ-RCO-IQ1_M-00002-of-00004.gguf": (39176113248, "34d68c99fdae9948f9f0af0dafe308e805ce0a78d2c48641b24cc57242fdc0af"),
"DeepSeek-V4.1-Flash-1017-GSQ-RCO-IQ1_M-00003-of-00004.gguf": (39997334720, "a08468c83955e0c4d3a9eb3f7b86c45b7bbac55d99c4640039a296a8a4b327ea"),
"DeepSeek-V4.1-Flash-1017-GSQ-RCO-IQ1_M-00004-of-00004.gguf": (2188841824, "b05f26a92325aa6845cebcb3ec1f93d2e65ebf89bdc3f805695960d2f0681832"),
"DeepSeek-V4.1-Flash-1017-GSQ-RCO-IQ2_XS-00001-of-00004.gguf": (39535776992, "4c65307992ab586c527ca1f6f64062aa96a33b23c02b7fed103f45f75e854798"),
"DeepSeek-V4.1-Flash-1017-GSQ-RCO-IQ2_XS-00002-of-00004.gguf": (39494617536, "933461a974fcccee741bf2f9798201e72ab4aa3f8a952be56f849896ca6ea30e"),
"DeepSeek-V4.1-Flash-1017-GSQ-RCO-IQ2_XS-00003-of-00004.gguf": (39423838496, "bbf91fa346a85ebaf32dd4fd5c456b534d780d381e54f46ac90783a481373240"),
"DeepSeek-V4.1-Flash-1017-GSQ-RCO-IQ2_XS-00004-of-00004.gguf": (36771591232, "e5b2f8781fab688cd4bc3bc7a69651b5dbb90ed94965657c6bead8bb4774f3cf"),
"DeepSeek-V4.1-Flash-1017-GSQ-RCO-IQ2_XXS-00001-of-00004.gguf": (39075714624, "d46efb67ccffd8fb5d7f18b423896381b9e06d8491e161c370ddf3b05b07e050"),
"DeepSeek-V4.1-Flash-1017-GSQ-RCO-IQ2_XXS-00002-of-00004.gguf": (39388449504, "cec1b2c3da429dc768b8bb9bc4dc4403d81f74d34db660a6a34ee3e555bf2c70"),
"DeepSeek-V4.1-Flash-1017-GSQ-RCO-IQ2_XXS-00003-of-00004.gguf": (39246891616, "9d9c2140fcb134a0b9a74dedd0e5167e68077af6d08ce7f856bce112f0a35dd3"),
"DeepSeek-V4.1-Flash-1017-GSQ-RCO-IQ2_XXS-00004-of-00004.gguf": (20527837312, "9b790a2297ed3cdede379fc984f4a52bb95f3b23724c797af11d1fa6a69db059"),
"DeepSeek-V4.1-Flash-Engram-IQ4_NL.gguf": (110595290816, "eb19f30d368d393784e1fc54fdfaffc427ebb2110bf3762fdf5a8fbb9a2d740a"),
}
Разработчики моделей периодически обновляют их выкатывая модели лучшего качества, а т.к. они хостятся на HF, то эти обновления попадают в те же самые файлы. Вот их и обновляют. это касется всех моделей на HF, тот же Qwen официальный также обновляется внутри одной версии.
Автор не разобрался в вопросе и напридумывал себе.

Отлично! Статья понравилась. В работе локальных llm есть свое очарование и шарм, вне зависимости от практичности. Это само по себе увлекательное занятие. Пишите ещё!
REAP вроде бы звучит круто но на практике отрезает именно тех редких экспертов, которые нужны для сложных задач. MoE и так спасает по потреблению, не уверен, что стоит его дополнительно лоботомировать

Ускорение REAP20 на 42% при минус 20% весов, похоже, не про вычисления: активных параметров на токен у обеих около 3B. Скорее дело в памяти. 35B-A3B в Q4_K_M весит порядка 21 ГБ, урезанная около 17 ГБ. При 16 ГБ видеопамяти и контексте 64k целиком не влезает ни одна, но у урезанной в оперативку уходит заметно меньше экспертов. На карте с 24 ГБ разница, подозреваю, была бы куда скромнее.
И про разброс. На 509 задачах при точности около 50% стандартная ошибка порядка 2,2 п.п. на каждую модель, а у разности двух моделей уже около 3,1, так что 53,8% против 51,1% пока в пределах шума. Сказать, что заметной просадки после вырезания экспертов нет, можно, а вот «лучше» без парного теста по тем же задачам (того же Макнемара) не показать. Numpy 325 показывает ещё один источник шума: если один и тот же код то проходит, то нет, нестабилен сам тест. Отсюда же может быть и часть из 32 задач, которые решил Q2, но не решил Q6. Какая стояла температура? Если не ноль, интересно прогнать тот же Q6 второй раз и посмотреть, сколько «уникальных» задач он найдёт сам у себя.
«лучше» без парного теста по тем же задачам (того же Макнемара) не показать.
Это слово прокралось от общего впечатления при сравнении точности и скорости. Но на будущее постараюсь не забыть, спасибо.
Какая стояла температура?
Рекомендованная производителем 1.0 (link).
Если не ноль, интересно прогнать тот же Q6 второй раз и посмотреть, сколько «уникальных» задач он найдёт сам у себя.
~ 8.2 часа, конечно, не вызывают энтузиазма. Но в беклог добавлю. Тем более, что, судя по новым результатам, не грех будет и продолжение сделать. Ибо там очередной шок-контент. По крайней мере для меня.

Да это правильно, попробовать. Например у 27 модели заметил разницу в продолжительности и качестве размышлений при смене размера батчей. А сборки от DavidAU радикально сокращают время решений одних и тех же задач + смена режима размышлений через чат (в начале сессии желательно). Кстати в strata последней версии касперский находит трояны в js при установке, видимо это только в харнесс и видимо поведенческий анализ срабатывает.
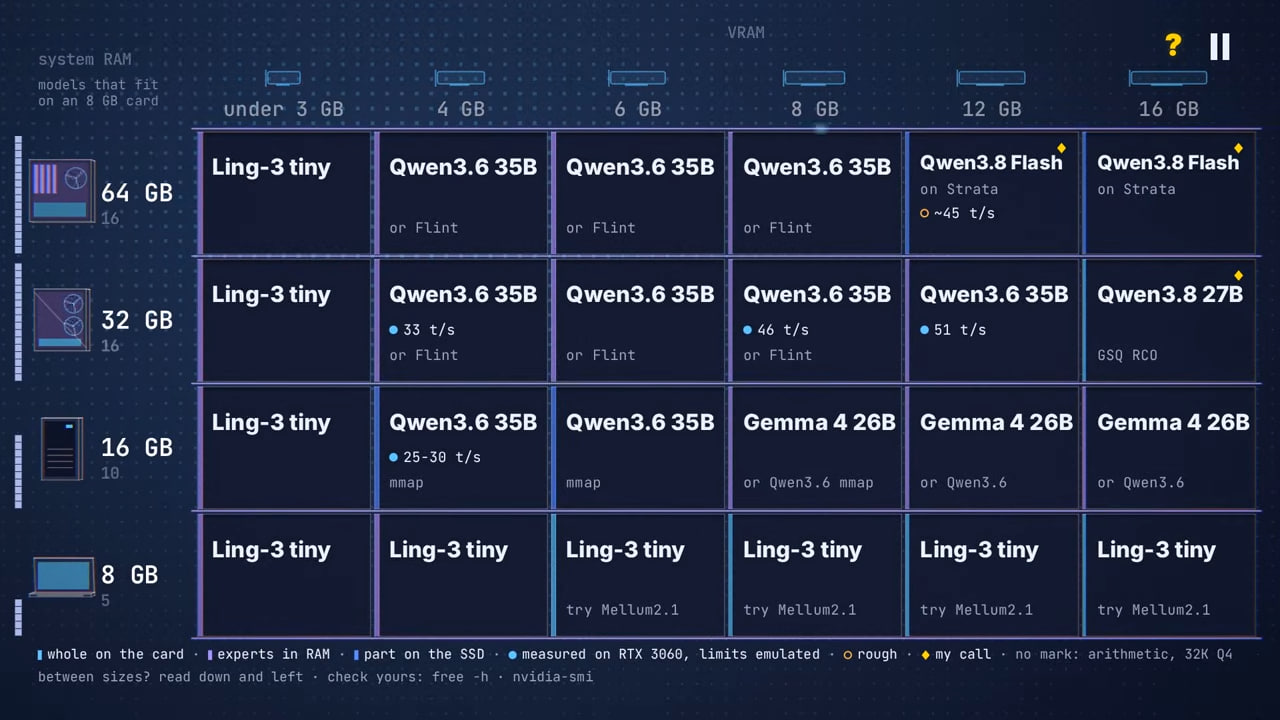
Вот тут хороший обзор настроек под каждое сочетание VRAM & RAM (YouTube).
Зарегистрируйтесь на Хабре, чтобы оставить комментарий
«Don't fear the REAPer» или как DS себе локальную LLM выбирал