Привет, Хабр! На связи команда виртуализации Astra Cloud. Пока коллеги рассказывают про новые фичи нашей облачной платформы, мы тоже хотим показать, что не стоим на месте.
Сегодня речь пойдет о хранилище BREST_LVM в нашем ПК СВ «Брест», который является ядром Astra Cloud Platform. Мы совместили формат QCOW2 с классическим LVM так, чтобы диск ВМ занимал ровно столько места, сколько ему реально нужно, и при этом спокойно жил в кластере с общим хранилищем. Задача звучит просто, но по дороге нас ждали lvmlockd, sanlock и несколько неочевидных решений.
Начнем с проблемы, ради которой все затевалось. Возьмем условный пример. У виртуальной машины диск на 500 ГБ, а внутри лежит 200 ГБ данных. QCOW2 хранит только записанное, поэтому формат честно занимает 200 ГБ. Но лежит он на thick LV, а такой том забирает из группы томов весь заявленный размер сразу. Остальные 300 ГБ простаивают, и никто другой ими воспользоваться не может.
Помножьте на парк виртуальных машин в облаке. Свободное место в группе томов (VG) заканчивается задолго до того, как заканчиваются данные. Хранилище выглядит забитым под завязку, а больше половины этого места занимает пустота: у машины из нашего примера заполнено всего 40% диска. Новую ВМ уже не создать, потому что в VG нет места, и остается идти за бюджетом на новые полки. Знакомая ситуация? У LVM есть штатное решение против расточительности, thin provisioning, но в кластере из нескольких гипервизоров с общим хранилищем оно не работает.
Мы же пошли другим путем: оставили классический LVM, но научили тома расти вместе с данными. Как это устроено в хранилище BREST_LVM и какую цену пришлось заплатить за эту доработку, читайте ниже.
В этой статье:
как LVM используют в виртуализации и чем RAW отличается от QCOW2;
почему thin LVM нам не подошел;
как устроен thick LV в BREST_LVM, который растет вместе с данными;
какие две проблемы пришлось решить на пути к цели;
что получилось в итоге.
Но сначала немного теории. Итак, что мы имеем…
Два способа подружить LVM с виртуализацией
В виртуализации LVM исторически используют двумя способами.
LV как файловая система. На томе создается файловая система, а на ней лежат файлы образов дисков ВМ (raw или qcow2). Для кластера выбирают кластерную файловую систему.
LV как блочное устройство напрямую. Каждый диск ВМ представлен отдельным LV, без промежуточной файловой системы, и гипервизор работает с ним как с сырым блочным устройством.
Второй подход ценят за предсказуемость и производительность, так как у хоста нет накладных расходов файловой системы плюс LV можно расширять онлайн (частые операции расширения тома, lvextend). Этот классический паттерн реализован в хранилище типа LVM_LVM.
RAW против QCOW2
RAW и QCOW2 — два основных формата хранения дисков ВМ в экосистеме QEMU/KVM.
RAW дает побайтовое отображение диска ВМ на файл или блочное устройство: смещение X на виртуальном диске соответствует смещению X на устройстве. Собственных метаданных, снапшотов и сжатия у формата нет, только линейный массив данных.
QCOW2 (QEMU Copy-On-Write v2) устроен сложнее. Внутри него таблицы трансляции адресов (L1/L2), таблица счетчиков ссылок (refcount table), поддержка backing-файлов, внутренних снапшотов, сжатия и шифрования. По природе QCOW2 sparse-формат: физически занята только та часть, в которую реально писали.
RAW | QCOW2 | |
Трансляция адресов | Слоя трансляции нет: операция ввода-вывода гостя превращается в операцию на устройстве почти напрямую | Каждое обращение к данным гостя проходит через таблицы L1/L2, то есть дополнительные чтения метаданных |
CPU и память хоста | Потребление меньше: не нужно кэшировать и обходить L2-таблицы | Потребление больше |
Первая запись в невыделенный кластер | Write amplification нет | Allocate-on-write: выделить кластер, обновить L2-таблицу и refcount table, и только потом записать данные. Одна логическая запись гостя превращается в несколько физических |
Снапшоты, сжатие, thin provisioning | Встроенных нет. Экономию места приходится обеспечивать другим слоем, например thin LVM | Есть внутренние снапшоты, сжатие и sparse-хранение |
Получается примерно так. RAW выигрывает там, где важны производительность и предсказуемость. QCOW2 платит за гибкость дополнительным слоем абстракции.
Thick и thin: как место достается тому
Помимо формата данных есть еще способ выделения места в томе.
Thick LV получает пространство в VG целиком в момент создания, независимо от того, сколько данных в него реально записано. Thin LV выделяется из thin-пула и физически занимает ровно столько блоков, сколько было записано, разрастаясь по мере необходимости.
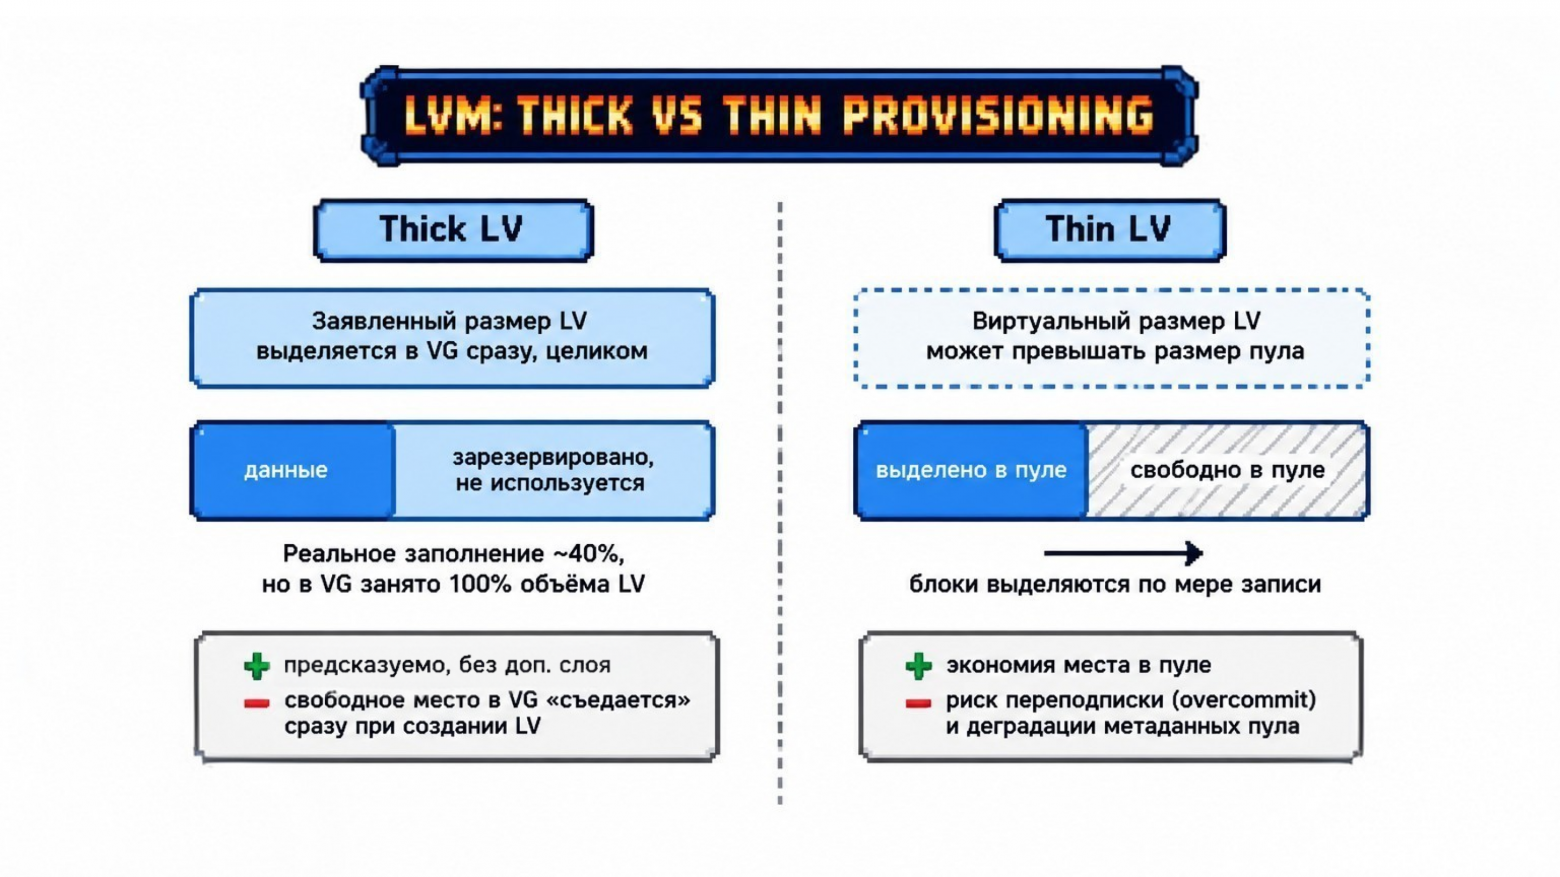
Теперь сложим два факта. Sparse QCOW2 лежит на thick LV, и экономия, которую дает формат, до уровня LVM не доезжает: том занимает в VG весь заявленный размер. Формат бережет место, а том его отбирает. Мы нашли способ, при котором место экономят и формат, и том.
Почему мы не выбрали thin LVM для кластера
Казалось бы, thin LVM решает вопрос: не нужно же вручную подгонять размер тома под реальные данные QCOW2.
Проблема в том, как thin-пул управляет пространством. Метаданные пула (адресация выделенных блоков, счетчики ссылок между снапшотами) поддерживают активацию только на одном узле одновременно. Thin-пул нельзя активировать сразу на двух узлах кластера, даже под управлением lvmlockd. С обычными thick LV все иначе: лок-менеджер допускает для них согласованную эксклюзивную или разделяемую активацию на разных узлах. Thin-пул в кластерной конфигурации жестко привязан к одному узлу-владельцу.
На практике для миграции ВМ на другой узел пришлось бы деактивировать пул на исходном узле и активировать на целевом. Мигрирует одна машина, а владение переходит ко всему пулу сразу. Такая схема создает единую точку отказа (узел, который держит пул) и делает невозможной штатную live-миграцию в привычном виде.
Почему мы остались на thick LVM
Да, мы выбрали классический thick LVM, но от статического выделения отказались. Вместо LV на весь виртуальный размер диска ВМ том создается по размеру данных, которые реально занимает QCOW2, и расширяется по мере их роста. В нашем примере том под диск на 500 ГБ стартует с 200 ГБ и растет вслед за данными.
Схема совмещает предсказуемость классического LVM (совместимость с кластерной активацией через lvmlockd, без ограничений LVM Thin) с экономией места, которая свойственна sparse-формату QCOW2.
Цена вопроса: нужен собственный механизм, который следит за заполненностью и вовремя расширяет том. Записи гостя нельзя дать упереться в границу LV.
Решение потребовало закрыть две проблемы. Ниже делимся секретами реализации)
Проблема 1: не дать QCOW2 дойти до пределов
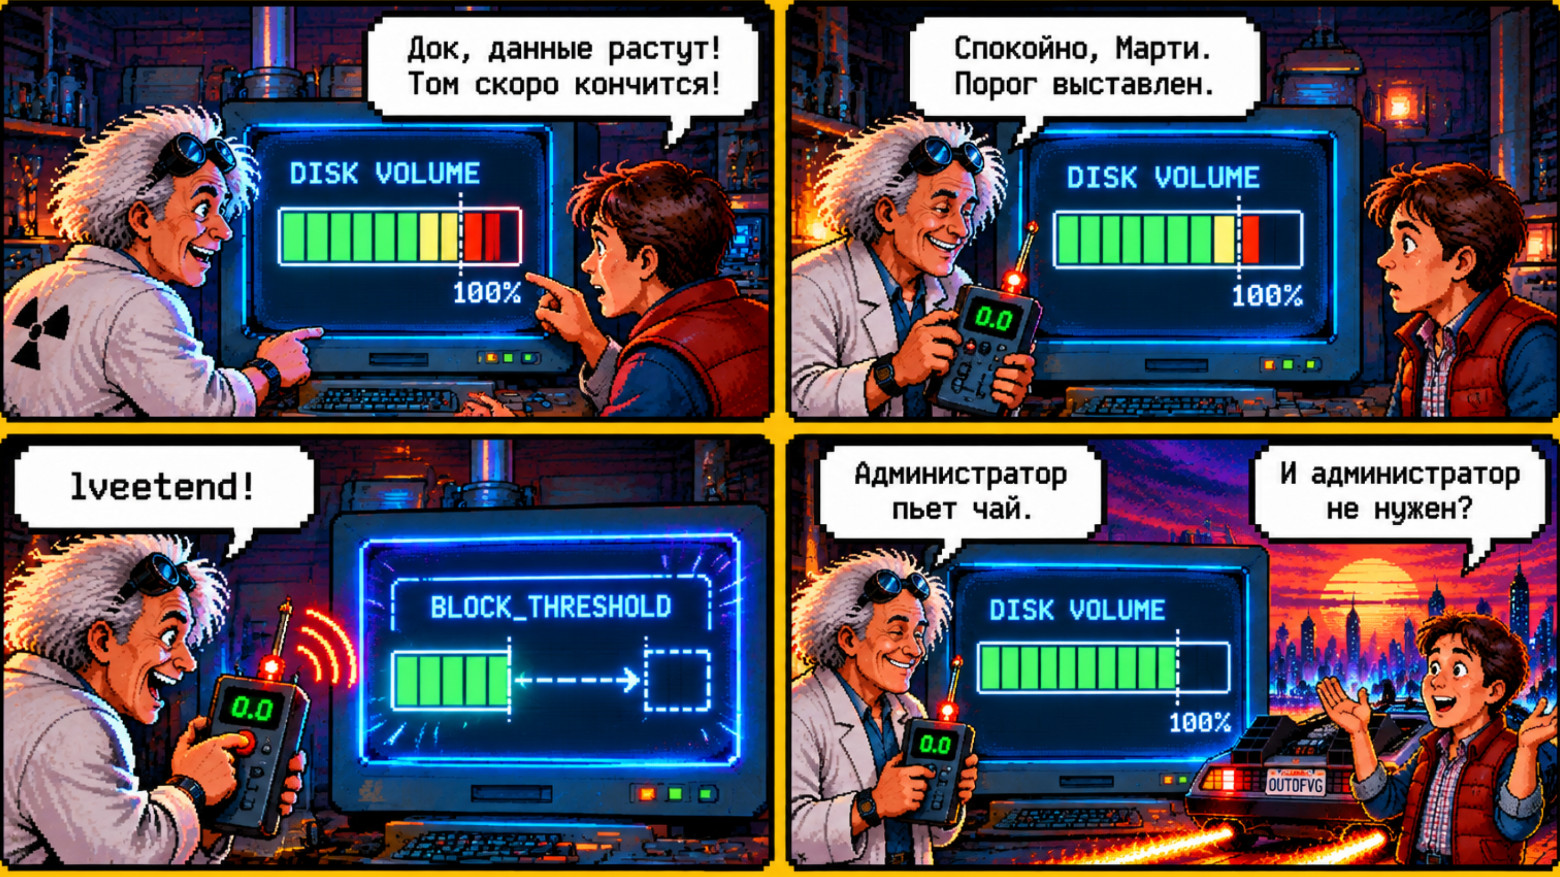
LV по размеру меньше номинального диска ВМ, поэтому нужна гарантия, что QCOW2 никогда не упрется в границу тома, пока ВМ работает. Для этого мы используем механизм domblkthreshold в libvirt. На блочное устройство ВМ выставляется порог заполнения (virDomainSetBlockThreshold). Когда QEMU фиксирует, что аллокация внутри QCOW2 приближается к порогу, libvirt генерирует событие VIR_DOMAIN_EVENT_ID_BLOCK_THRESHOLD.
Дальше libvirtd сам обрабатывает событие и выполняет lvextend для нужного LV, а затем заново выставляет порог с учетом нового размера тома.
Получается цикл:
Гость пишет данные, QCOW2 занимает все больше места внутри тома.
Аллокация приближается к порогу, QEMU это фиксирует.
libvirt генерирует событие BLOCK_THRESHOLD.
libvirtd обрабатывает событие и расширяет соответствующий LV.
Порог выставляется заново с учетом нового размера тома.
Цикл работает автоматически, без участия администратора и без риска достичь лимита на границе тома в момент пиковой записи.
Проблема 2: метаданные LVM между узлами кластера
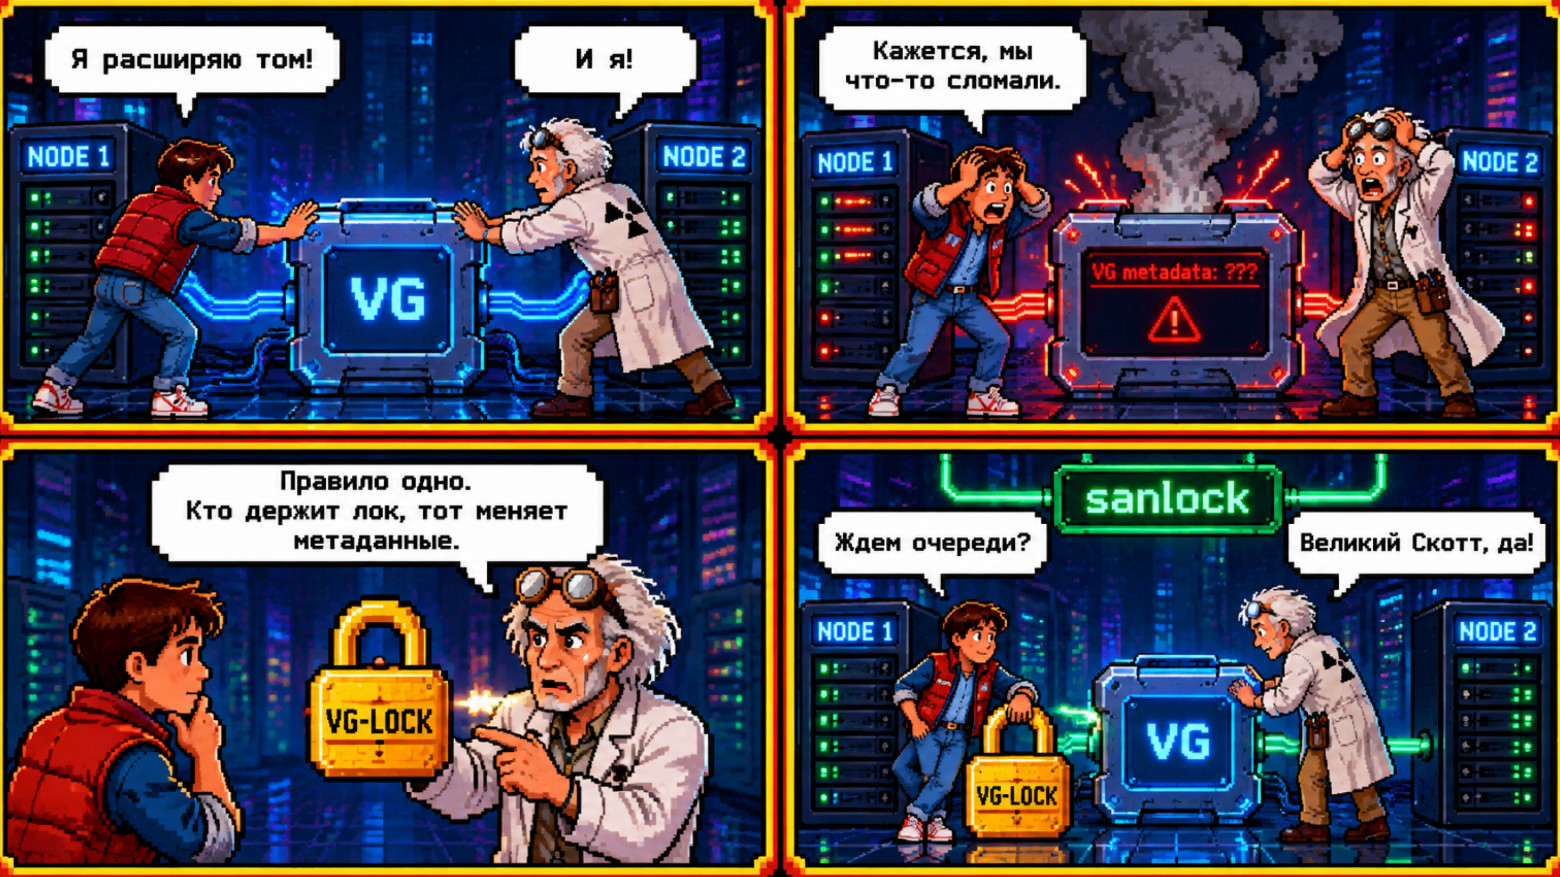
Частые операции расширения тома (lvextend) выполняются то с одного, то с другого узла, в зависимости от того, где сейчас запущена ВМ. То есть метаданные VG меняются часто. Если два узла попробуют изменить их одновременно без координации, то получится рассинхронизация. В худшем случае метаданные VG окажутся повреждены, а данные на всех томах группы потеряны. Эту проблему мы решили связкой lvmlockd и sanlock.
Как у нас работают lvmlockd и sanlock
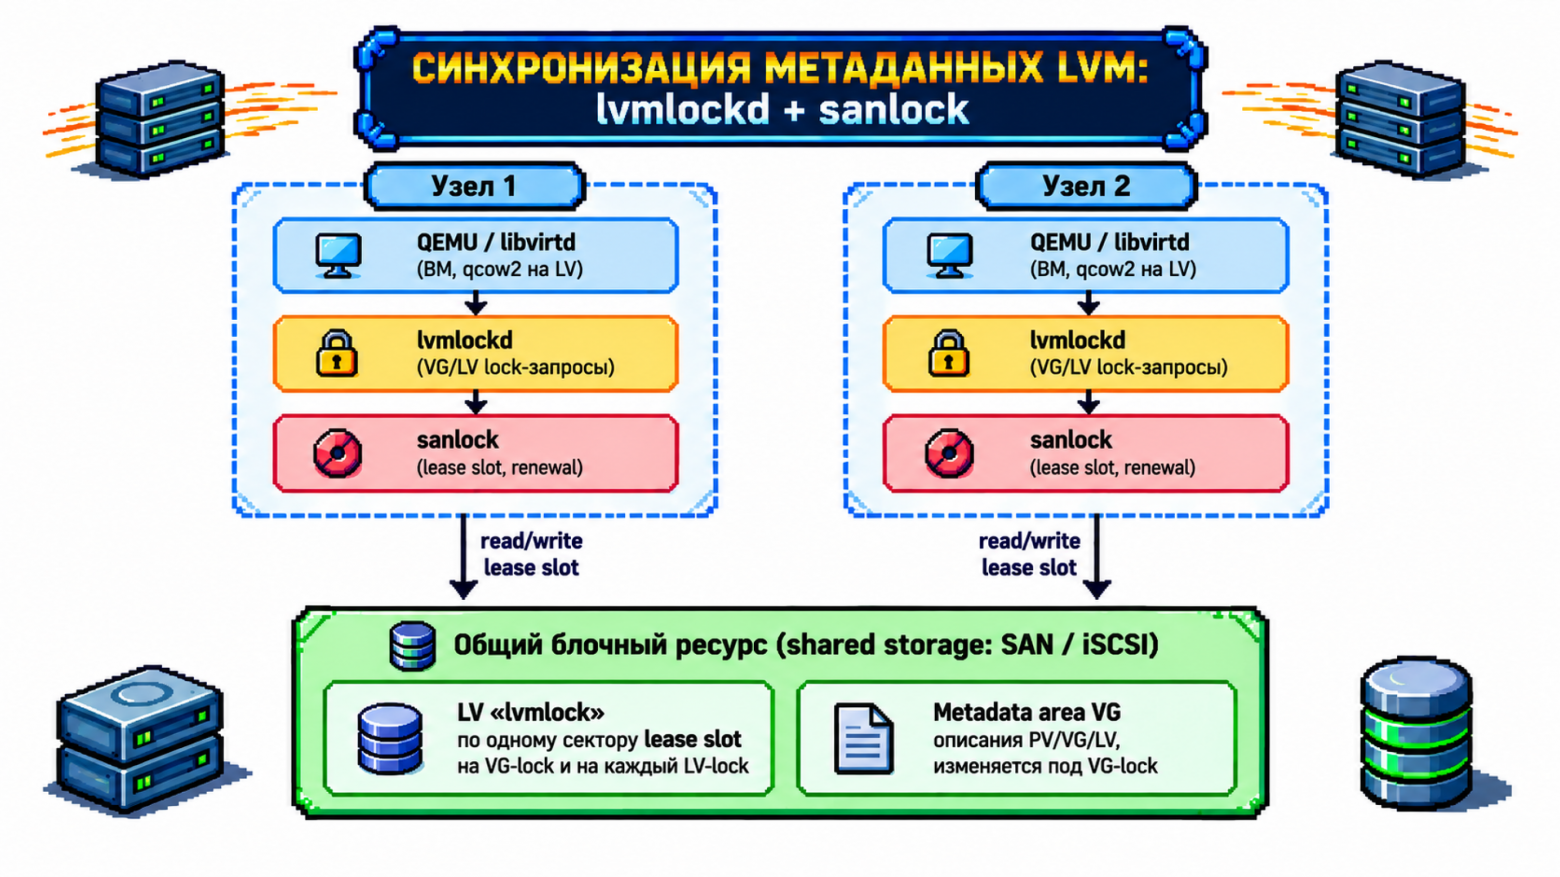
lvmlockd выступает посредником между командами LVM и внешним менеджером блокировок. Он транслирует запросы LVM (например, «нужно изменить метаданные VG» или «нужно активировать LV эксклюзивно») в запросы к бэкенду блокировок — у нас в этой роли sanlock.
Sanlock координирует узлы через само хранилище, без использования сетевого протокола. В группе томов (VG) под управлением lvmlockd создается служебный логический том lvmlock. Каждому ресурсу блокировки (VG-lock, а также LV-lock для каждого отдельного тома) в нем отведен отдельный сектор аренды (lease slot). Узел, которому нужна блокировка, записывает и периодически обновляет (renewal) свой уникальный идентификатор (Host ID) в этом секторе, а остальные узлы видят актуальное состояние блокировок прямо на диске. Такая схема работает поверх обычного общего блочного хранилища (shared block storage) и не требует развертывания отдельного сетевого кворум-протокола (например, Corosync) между узлами виртуализации — необходим только прямой доступ к общему дисковому ресурсу.
Когда узел выполняет операцию, меняющую метаданные VG (lvcreate, lvextend, lvremove), lvmlockd сначала берет ресурс блокировки (VG-lock) через sanlock. Пока лок удержан, ни один другой узел не может параллельно менять метаданные той же VG. После освобождения остальные при следующем обращении к VG видят уже актуальную версию. Именно это защищает от гонок при lvextend, которые вызывает авторасширение томов под QCOW2.
Почему мы отключили self-fencing
В классической конфигурации sanlock рассчитан на сторожевой таймер (watchdog). Узел теряет возможность вовремя продлевать аренду (lease), например из-за потери связи с общим хранилищем, и watchdog запускает его самоперезагрузку. Так система защищается от «зависшего» узла, который продолжает считать, что держит блокировку, и может повредить данные.
В нашей реализации самофенсинг sanlock намеренно отключен. В ПК СВ «Брест» уже есть собственный механизм, который закрывает тот же класс проблем. Два независимых механизма сразу создали бы риск гонок и лишних перезагрузок узлов без дополнительной пользы.
Побочный эффект
Связка lvmlockd и sanlock решила задачу синхронизации метаданных VG, но принесла новую обязанность — управлять блокировками на уровне отдельных LV. Каждый том нужно активировать в подходящем режиме.
Эксклюзивно на узле, где запущена ВМ и идет запись.
Деактивировать, когда ВМ выключается.
Переключать блокировки при миграции.
Автоматизацию этого процесса мы возложили на libvirtd. При старте ВМ он сам блокирует (активирует в нужном режиме) все тома, которые нужны. При остановке или миграции libvirtd снимает блокировку и освобождает том для активации на другом узле. Администратору не нужно вручную вызывать lvchange, потому что активация и деактивация LV стали частью штатного жизненного цикла ВМ и идут синхронно с ее запуском и остановкой.
В итоге получился компромисс между экономией места, которую дает thin provisioning, и предсказуемостью, надежностью и кластерной совместимостью классического LVM. Ограничения LVM Thin в многоузловой конфигурации нас больше не касаются.
Получилось очень даже
Решение уже давно работает в продуктивной среде. Авторасширение стабильно успевает за ростом данных внутри QCOW2, и связка lvmlockd и sanlock не приводит к рассинхронизации метаданных VG между узлами кластера.
Хранилище стало основным вариантом при работе с аппаратными СХД. В облачных системах хранилище BREST_LVM хорошо подходит для сценариев с автомасштабированием, например для узлов кластеров Kubernetes: диск новой ВМ создается малым и растет только по мере записи данных, а при удалении ВМ место сразу возвращается в VG. Экономию здесь дает та же схема растущего thick LV, о которой мы рассказали выше.
По соотношению производительности и экономии места BREST_LVM — наш приоритетный выбор при планировании облачной инфраструктуры. Разработчикам оно позволяет создавать моментальные снимки (снапшоты) как дисков, так и ВМ целиком, включая состояние памяти. Это упрощает тестирование и дает возможность при проблемах откатиться к предыдущему состоянию.
Вообще BREST_LVM рекомендуется как основное хранилище для всех типов ВМ. В то же время для ВМ с высоким требованием к пропускной способности, например серверы БД, лучше ограничить количество снимков.
В свежей версии на базе преимуществ, дающих нам формат QCOW2, мы уже смогли реализовать репликацию ВМ между кластерами, что позволит вам не потерять важные виртуальные машины при выходе из строя кластера. Сделали API для интеграции с внешними системами резервного копирования с поддержкой инкрементальных копий.
В ближайших планах мы расширим мониторинг узлов через СХД, а также появится возможность «тёплой» миграции ВМ через хранилище при сетевой изоляции узла.
Как вам?