Обновить
64K+

Виртуализация *

Виртуализируем машины, ресурсы, приложения

61,58
Рейтинг
Сначала показывать
Порог рейтинга
Уровень сложности

Как я перестал ждать свободный гипервизор и написал четыре симулятора API
Уровень сложностиСредний
Время на прочтение19 мин
Охват и читатели5.7K

Иногда самое сложное в разработке инфраструктурного сервиса - добраться до проверки собственного кода. Меняешь несколько строк, а дальше выясняется, что тестовый кластер занят, в хранилище заканчивается место, а подходящий шаблон кто-то удалил во время уборки. И вот ты уже разбираешься с проблемами в тестовой лабе, хотя собирался всего лишь проверить изменение одного параметра виртуальной машины. Задача на двадцать минут получает все шансы стать огромной проблемой на голову автора инициативой которая принесет больше боли... Лучше так - главным приключением рабочего дня.

Я столкнулся с этим, когда занимался проектами, которые собирают сведения об инфраструктуре и управляют ею через API. Сначала хотел сделать небольшой инструмент для собственных тестов, чтобы реже зависеть от лабораторного Proxmox. В результате появились четыре проекта: симуляторы API Proxmox VE, OpenStack, VMware и oVirt.

Читать далее

Новости

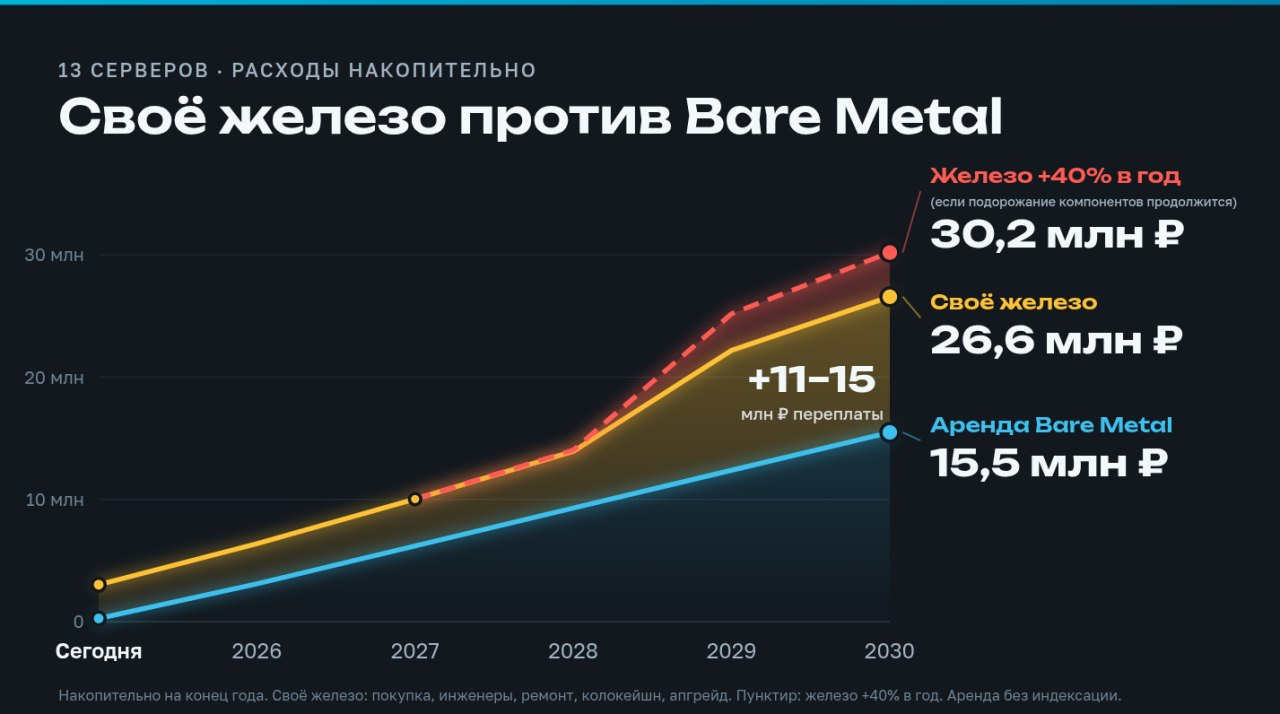
Милорд, серверное железо пожрал ИИ. Арендуем Bare Metal

Уровень сложностиСредний
Время на прочтение19 мин
Охват и читатели8.8K

Почему спор «арендовать или владеть» снова открыт, при чём здесь HBM и на что способен младший выделенный сервер, если посадить его собирать ядро Linux в CI/CD?

Читать далее

Хотел поручить AI целый проект. Уперся в изоляцию, память и восстановление после сбоев

Уровень сложностиСредний
Время на прочтение8 мин
Охват и читатели6.2K

Что пришлось проверить, прежде чем доверять системе самостоятельную работу над программным проектом.

Хотел построить систему, способную самостоятельно вести программный проект от идеи до работающего продукта с помощью AI‑агентов. Но первые инженерные эксперименты показали, что генерация кода далеко не самая сложная часть задачи.

В статье рассказываю о разработке Yggdrasil: почему ограничения файловой системы не гарантируют защиту данных, какие проблемы остаются после изоляции в VM, почему лимиты памяти не обеспечивают жестких гарантий для хоста и как восстанавливать выполнение после сбоев без риска повторить уже совершенные действия.

Разбираю реальные результаты испытаний, включая проваленные проверки, принятые архитектурные решения и ограничения, которые пока не удалось устранить. Проект еще находится на стадии исследований, поэтому речь не о готовом решении, а о проблемах, с которыми приходится сталкиваться при попытке построить действительно автономную AI‑разработку.

Читать далее

Как рабочее место оторвалось от «железа»: история VDI через призму технологий, компаний и людей. Часть 2

Время на прочтение16 мин
Охват и читатели6.1K

Во второй части история подходит непосредственно к VDI. Первая часть закончилась на терминальных серверах середины 1990-х: приложения вернулись на сервер, но каждый пользователь по-прежнему делил одну операционную систему с остальными. Разберемся, почему терминальных серверов оказалось недостаточно, как VMware научила x86 делать то, для чего эта архитектура вообще не проектировалась. Также рассмотрим, как из экспериментов заказчиков вырос отдельный класс виртуальных рабочих мест и почему его судьбу в итоге определили не только гипервизоры, но и протоколы удаленного доступа, BYOD, облака и пандемия.

Читать далее

Вы восстановили взломанный Proxmox из бэкапа. А атакующий уже снова внутри

Время на прочтение18 мин
Охват и читатели6.5K

Почти детектив: как в августе‑сентябре 2026 года массово взламывали гипервизоры Proxmox VE, прятали майнеры даже от root‑а, исправляли уязвимости на захваченных серверах и возвращались после восстановления инфраструктуры.

7 сентября 2026 года хостинг‑провайдер Netfront завершил восстановление кластера из 22 гипервизоров Proxmox VE. За предыдущую неделю злоумышленники получили административный доступ к серверам, внедрили руткиты, установили майнеры и проникли внутрь клиентских виртуальных машин. Администраторы восстанавливали системы из резервных копий, меняли пароли и SSH‑ключи, проверяли целостность файлов. После нескольких суток работы инфраструктуру наконец вернули клиентам.

За время расследования выяснилось, что на серверах побывали атакующие с как минимум тридцати трёх разных внешних IP‑адресов. Одни атакующие последовательно обходили узлы кластера, другие выполняли тысячи команд, третьи устанавливали средства скрытого доступа. На части гипервизоров системные утилиты перестали нормально работать: top аварийно завершался, команды зависали, а load average достигал 160 при отсутствии соответствующей вычислительной нагрузки.

В общем, администраторы Netfront не спали почти неделю, восстанавливая всё и вся. Однако вечером 7 сентября, вскоре после объявления о восстановлении инфраструктуры, злоумышленники снова вошли в кластер. В 20:31 началась новая подозрительная активность, а в 22:22 неизвестный пользователь запросил расписание резервного копирования и сразу после этого — список виртуальных машин, для которых резервное копирование не настроено. Позднее выяснилось, что атакующие заранее создали десятки API‑токенов и дополнительные учётные записи. Эти механизмы доступа сохранились в общей конфигурации кластера и пережили восстановление всех 22 серверов.

Такие дела, собачка!

Сломанный Ctrl+C — сначала гасла VM, а потом не прерывался sleep: Java, KVM и Linux

Уровень сложностиСложный
Время на прочтение12 мин
Охват и читатели9.2K

Обычный Ctrl+C оказался для моей Java VM неожиданной проблемой: сначала он завершал саму виртуальную машину, а после исправления перестал останавливать команды внутри Linux. Чтобы разобраться, пришлось пройти весь путь от host terminal через UART и KVM до гостевого TTY и Unix-сигналов. В статье разберём не только причину, но и метод диагностики, который пригодится далеко за пределами виртуализации.

Разбираемся, куда пропал Ctrl+C

TPM‑WMI 1803 — обновление Platform Key Secure Boot на ВМ VMware

Уровень сложностиСредний
Время на прочтение4 мин
Охват и читатели8.9K

Разбор и пошаговая инструкция по устранению регулярных ошибок Microsoft‑Windows‑TPM‑WMI (ID 1803 и 1801) в журнале System на виртуальных машинах Windows Server под управлением VMware ESXi версии 7.x и 8.x (до ESXi 8.0 U3j). В статье рассматривается причина сбоя — переход Microsoft на новые сертификаты Secure Boot 2023 и несовместимость встроенного Platform Key (PK) в NVRAM виртуальных машин — а также приводится подробный гайд по безопасной ручной замене PK (на основе Broadcom KB 423919) и его проверке через PowerShell.

Читать далее

Когда VPS уже недостаточно: зачем нужен выделенный сервер

Уровень сложностиСредний
Время на прочтение5 мин
Охват и читатели12K

VPS подходит для множества задач: на нём можно разместить сайт, запустить приложение, настроить тестовую среду или базу данных. Но со временем ресурсов виртуального сервера может перестать хватать. Например, если проекту нужны более быстрые диски, стабильная работа под высокой нагрузкой или возможность самостоятельно настраивать оборудование, стоит присмотреться к выделенному серверу Bare Metal. В отличие от VPS, он предоставляет в распоряжение клиента целую физическую машину, ресурсы которой не делятся с другими арендаторами.

Читать далее

Фабрика EVPN-VXLAN, которая выглядит исправной и не передаёт ни одного пакета

Уровень сложностиСредний
Время на прочтение10 мин
Охват и читатели7.9K

Собрал дома фабрику EVPN-VXLAN на бесплатных образах Junos в containerlab — под Windows, в WSL2, на AMD. Фабрика поднялась: обе сессии BGP в Establ, маршруты EVPN разошлись, туннель построен, MAC соседнего хоста в таблице. И при этом между хостами не проходит ни одного пакета. Разбор по трём захватам и разгадка в одну строку конфига, которой нет ни в одном туториале. Вторая половина — про то, как мерить отказы честно: почему ping с секундным разрешением не годится, и что показал поток в тысячу пакетов в секунду, когда я погасил линк.

Читать далее

Чем различаются способы установки приложений на сервер

Уровень сложностиПростой
Время на прочтение17 мин
Охват и читатели9K

Спор про то, чем ставить софт на сервер, обычно заканчивается ничем, потому что у каждого свои привычки. Мы разложили двенадцать способов по полкам, пять прогнали на одинаковых серверах с секундомером и выяснили, что больше половины разницы во времени уходит не на установку приложения, а на установку самого инструмента.

Читать далее

Linux из Java без JNI: от FFM и /dev/kvm до интерактивной консоли

Уровень сложностиСложный
Время на прочтение9 мин
Охват и читатели8.8K

Да, направление здесь немного непривычное: обычно Java запускают в Linux, а здесь я решил попробовать запустить Linux из Java.

Обычно Java и KVM находятся довольно далеко друг от друга: с одной стороны JVM и управляемая память, с другой /dev/kvm, ioctl, регистры vCPU и физическая память guest ОС. В этой статье разберём, как связать эти два мира через Foreign Function & Memory API без JNI. На примере panama-kvm пройдём путь от первого вызова KVM API до загрузки Linux, настройки памяти, обработки VM exits и интерактивной консоли внутри гостевой системы.

Запустить VM из Java

Пережить обрыв связи и потерю пакетов: как мы выбирали транспорт для протокола Pulsar

Время на прочтение5 мин
Охват и читатели6.1K

Привет. Я Александр Донин, я технический менеджер платформы VDI и терминального доступа Termit.  В прошлой статье мы рассказывали, почему делаем собственный протокол удаленного доступа Pulsar с нуля, а не форкаем Open Source. Это не значит, что мы вообще против Open Source — используем его, когда это экономит время и не создает проблем: например, в Termit мы используем PostgreSQL для хранения данных и NGINX как веб-сервер, да и начинал Termit с RDP и X2Go. Транспорт в Pulsar — это еще один пример, когда компонент Open Source дал нам как раз то, что требовалось, и вошел в протокол в виде модуля.

Именно на уровне транспорта решается, помешает ли передача тяжелого файла мыши и клавиатуре, сколько потерь пакетов протокол выдержит, переживет ли сессия обрыв связи. Расскажем, почему остановились на QUIC, а не на легаси-протоколах, и с чем пришлось разбираться при реализации.

Читать далее

Свой Kubernetes‑кластер в рюкзаке: частное облако на ARM64

Уровень сложностиСредний
Время на прочтение9 мин
Охват и читатели6.7K

Хотел домашний Kubernetes, который уносится в рюкзаке. Получился кластер из четырёх RK3588 на Talos и Cozystack: control‑plane, NVMe, виртуалки и отдельный BMC на OpenWrt.

Читать далее

Ближайшие события

Миграция с VMware: девять осей обвязки vSphere и что с ними будет на открытом стеке

Время на прочтение23 мин
Охват и читатели7.4K

Tesco переносит с VMware около 40 тысяч серверных нагрузок, от которых зависят магазинные серверы и системы данных, включая кассы в торговых залах. По данным The Register, ритейлер начал выбирать замену после отказа Broadcom продлевать поддержку его инсталляций. Миграция идёт в предельно возможном темпе — в опубликованных материалах его описали как at exceptional pace. Уже в ходе проекта выяснилось, что Veeam и Zerto, на которых построены резервное копирование и защита данных, не работают с выбранной платформой. Часть функций пришлось дорабатывать или закупать заново. Computer Weekly

При переходе с vSphere виртуальные машины обычно переносятся средствами конвертации без серьёзных сюрпризов. Сложнее сохранить всё, что за полтора десятка лет выросло вокруг платформы: резервное копирование, микросегментацию, аварийное восстановление, интеграции и регламенты ИБ. Совместимость бэкап-системы с целевой платформой можно проверить по документации за рабочий день, но в миграционном проекте таких проверок набирается около десятка, и каждая требует примерно столько же времени. Состав этой обвязки нужно определить до переноса, иначе несовместимости обнаружатся уже во время миграции.

Обвязку можно разложить по девяти функциональным осям: часть возможностей заработает сразу после переноса, часть команде придётся собирать самостоятельно, а часть устроена иначе и потребует новых регламентов. В статье разберём эти группы, порядок проверок и различия между версиями платформ от сообщества; доработки вендоров поверх открытой базы рассмотрим отдельно. Это вторая статья цикла: в первой обсуждались класс решения, модель поддержки и совокупная стоимость владения. Материал рассчитан на инженеров эксплуатации и архитекторов виртуализации, которые выбирают целевую платформу или уже ведут миграцию; специалистам по ИБ будут полезны разделы о доступе к коду и регуляторных требованиях. Таблица девяти осей и чек-лист пригодятся также при переходе с Hyper-V и Nutanix: они относятся к слою оркестрации и не зависят от исходной платформы.

Читать далее

От bare metal до managed Kubernetes: разбираем архитектуру Cozystack. Расшифровка митапа в Дубае

Уровень сложностиПростой
Время на прочтение31 мин
Охват и читатели11K

Как устроен Cozystack и managed Kubernetes на собственном железе

Во время поездки в ОАЭ я случайно попал в дубайское IT-комьюнити в Telegram. Там мы внезапно скоординировались и собрали незапланированный митап. 3 октября встретились в небольшой переговорке в Дубае — получилось душевно, и мы успели обсудить много интересных тем: от Talos и хранилища до сетей и устройства managed Kubernetes.

На митапе я рассказывал о Cozystack — открытой платформе для предоставления managed-сервисов на собственном железе. Начали с обзорной презентации, но довольно быстро перешли к вопросам: почему выбрали именно такой storage, зачем нам одновременно Kube-OVN и Cilium, как устроен Kubernetes внутри Kubernetes и где проходит граница между облачной платформой и обычной виртуализацией.

Ниже — отредактированная техническая расшифровка доклада и обсуждения. Я разберу, как связаны Talos, Flux, LINSTOR, Kube-OVN, Cilium, KubeVirt, Kamaji и Cluster API; как пользовательский ресурс превращается в работающий сервис; и почему для managed Kubernetes важно отдельно обслуживать control plane, вычислительные узлы и хранилище.

Читать далее

Работают ли запреты внутри песочницы ИИ-агента?

Уровень сложностиСредний
Время на прочтение9 мин
Охват и читатели7.4K

ИИ-агент работает в песочнице, но отдельным инструментам нужны разные права. Анализатору можно читать исходники, а менять их нельзя. Как проверить, что этот запрет действует?

В экспериментах с Linux и gVisor встретились три ситуации. Механизм ограничения отсутствует, для его настройки не хватает прав или настройка проходит успешно без ожидаемого эффекта. Даже загруженная и подключённая программа фильтрации не всегда что-то фильтрует. Показываю результаты, ошибки собственных проверок и подход, который помогает проверить ограничения до запуска инструмента агента.

Читать далее

От ручных настроек к автоматизации, или как мы адаптировали Basis Dynamix под наши задачи

Уровень сложностиСредний
Время на прочтение10 мин
Охват и читатели6.5K

Вроде бы довольно очевидная мысль — у ручной настройки есть предел масштабирования. Пока кластеров немного, команда может держать локальные различия под контролем. Но со временем инфраструктура растёт, команды меняются, решения накапливаются в документации, сценариях и памяти отдельных сотрудников. Площадки, одинаковые на старте, постепенно начинают жить по разным правилам, что со временем перестаёт быть особенностью эксплуатации и превращается в самостоятельный источник рисков. Хуже того, эти процессы зачастую проходят незаметно для команды, занятой рутинными делами — просто в один прекрасный день приходит осознание, что предел достигнут и надо было еще вчера что-то менять.
История, которую я хочу рассказать, началась несколько лет назад, когда перед нами была поставлена задача развернуть на наших площадках отечественную платформу виртуализации Basis Dynamix Enterprise. Закончилась же эта история внедрением качественно нового подхода к эксплуатации. Но обо всем по порядку.

Читать далее

Как мы разворачиваем ClickHouse-кластер через Arenadata: практический гайд для DevOps

Уровень сложностиСредний
Время на прочтение16 мин
Охват и читатели5.4K

Привет, Хабр! Меня зовут Никита Ивкин, я — ведущий DevOps-инженер РТЛабс, работаю с инфраструктурой Госуслуг. Сегодня я покажу один из наших реальных сценариев: как мы разворачиваем ClickHouse через Arenadata, почему выбрали именно такую топологию и какие нюансы появляются между кнопкой Install и действительно рабочим кластером. Мы разберём причины выбора такой схемы, увидим, где ADCM действительно упрощает эксплуатацию, какие мелочи всплывают вокруг SSH и Ansible и почему после успешного Install хост всё ещё может выглядеть «жёлтым». В конце — проверки со стороны самого ClickHouse и несколько вещей, которыми мы дополнили кластер уже после раскатки.

Читать далее

Выделенный сервер: как выбрать конфигурацию и не переплатить

Уровень сложностиПростой
Время на прочтение8 мин
Охват и читатели11K

Если вы хотите запустить гипервизор или высоконагруженную СУБД, ресурсов VPS может быть недостаточно. В такой ситуации на помощь приходит выделенный физический сервер. Но сколько ядер процессора и оперативной памяти понадобится именно вашему проекту? Хватит ли канала на 1 Гбит/с или нужно больше? Можно взять конфигурацию с запасом, но переплачивать за ресурсы, которые большую часть времени будут простаивать, тоже не хочется.

В этой статье разберём основные параметры выделенного сервера и расскажем, как подобрать конфигурацию под конкретную задачу.

Читать далее

Как AVM переживает обновления и рост инфраструктуры

Уровень сложностиСредний
Время на прочтение6 мин
Охват и читатели6.5K

Мы продолжаем рассказывать, как создавали AVM собственную платформу управления виртуальными машинами Aéza. В этой части разберём, как обновляем систему без остановки клиентских VM, выполняем живую миграцию, переживаем сбои и масштабируем инфраструктуру а также расскажем, с какими проблемами столкнулись по пути.

Читать далее
1
23 ...