Комментарии 128

Видео нужно было брать tesla P100, теже деньги, но памяти больше в два раза и шустрее

Вообще не планировал поднимать локальные модельки на этом железе. Всё это было взято на сдачу после покупки ibm ac922, на средства с распродажи "старого" компа с ddr4 и v100. Железо из статьи выбиралось по принципу 1 cpu с максимальной частотой (для 1с), большой объём копеечной ddr3, для постгрю, докера, виртуалок и т.д. А 1070 была взята, чтобы подключить все три монитора.
Внезапно понадобилась анцензорная моделька по-быстрому порешать вопросики, а 922 ещё не поднят.

взято на сдачу после покупки ibm ac922
чем обоснован выбор этого железа? nvlink-ом? если не секрет- под какие задачи?
AC922 идеален, и я не понимаю, почему он стоит копейки. Ключевое - то, что у двух островов с видеочипами есть прямой доступ к ОЗУ, минуя процессор, на очень большой скорости. Это не общая память, как в DGX Spark, но по смыслу очень близко. Такого нет ни у кого из серверного железа, даже за несколько миллионов рублей. Например, покупая сервер с 8×V100 на 32 ГБ за неадекватные деньги, получаешь ту же самую шляпу с узким горлышком PCIe и тем же колхозом с прибиванием моделек гвоздями разными способами, какими пользуемся мы здесь. По факту AC922 спокойно будет возить на себе модели терабайтного класса, или полутерабайтного, но в несколько потоков.
Брал исходя из того, что:
Практически общая с GPU память закроет потребности, по ощущениям, на 4-5 лет.
Два острова с чипами позволят обучать свои модельки на очень высоких скоростях.
Многопоточность: одновременно будет тянуть всё, что нужно для прода домашних проектов, помогать мне кодить, и где-нибудь в уголке - когда не полностью загружен или когда задач вообще нет на всю катушку обучать свою модельку. Это серверное железо и оно сделано прямо на совесть, как раз стоять на балконе и маслать 24/7
Да, звучит очень хорошо. Можете сказать какая конфигурация железа (память, гпу, видеопамять) и во сколько обошлось? Моя жабка начинает квакать потихоньку- я себе запилил на супермикровской матери под xeon 8370 с 512 ддр4 3200 - чисто тушка без гпу обошлась в 450тр - правда это новая комплектуха и год назад было до подорожания памяти, ну и 8 А5000 были с прошлых времен. А у вас наверное и железо получше и денег поменьше.. И самое главное у такого класса есть нвлинк промышленного исполнения, а не та бесполезная ерунда, которая сверху на pcie карточках (по крайней мере на амперах)..
Купил у Александра из Краснодара (Саша, привет! Думаю, ты читаешь этот пост). Обошлось в 165 без памяти, но с процессорами и шестью чипами по 16 ГБ. Сейчас в процессе постройки двухконтурной СОЖ - одноконтурная не пойдёт, т.к. радиатор будет примотан к кондиционеру на улице, и сервер весь покроется конденсатом, если не отделить контуры через теплообменник.
Память, по словам многих, кто этим пользовался, дешманская не встаёт, нужно плюс-минус Samsung брать. Но, по опыту с другими серверами, дешманская не встаёт, если забивать ею слоты частично, а не все сразу. Поэтому договорился с продавцом памяти, как только буду готов, он приедет с комплектом из 16 планок по 16 ГБ на 2133 МГц, и мы прогоним всё на сервере. Если всё ок - память будет по 5 тр за планку, если нет - покупка растянется минимум на несколько месяцев.
И тут снова выбор в пользу меньшей скорости ОЗУ: на AC922 она напрямую влияет на скорость, так как нет бутылочного горлышка в виде PCIe. За те же деньги я теряю 15-20% скорости генерации, но приобретаю ×2 по объёму памяти. Вместо 128/256/512 ГБ быстрой памяти получаю небольшую просадку в скорости, зато 256, 512 или 1024 ГБ на медленной ОЗУ.

" и тут начинается интересное"
"тюнинг дал честные 5,4-6,2 ток/с "
Никто никогда не интересовался, почему нейронки (в данном случае узнается чат-гпт) так любят "начинается интересное" и "честность"? У них (нейронок) было сложно детство, их часто обманывали?
Пойду думать, как получить нечестные 5,4-6,2 ток/с (украсть что ли?)

Под катом — как это возможно, какие движки я сравнивал, и что из тюнинга реально дало прирост.
Это ж ChatGPT.

подозреваю, что это артефакты обучения с подкреплением. Кмк, там куча негенеренных данных и у них уклон в такие фразы.

Думаю, это калька с английского, вроде "...solid 5 t/s..."

А теперь то, ради чего всё это затевалось

Видать маркеры из датасетов англоязычных техноблогеров переведенные в лоб

Никто никогда не интересовался, почему нейронки (в данном случае узнается чат-гпт) так любят "начинается интересное" и "честность"?
Потому что "NVMe вместо HDD — не опция, а необходимость"
Интересно, а если я подключил hdd через nvme это будет еще опция или уже необходимость?

очевидно что речь про ssd, а не про тип интерфейса
Кому очевидно? Нейросети которая писала этот текст? Может у нее просто эти токены рядом стоят и она привыкла что они взаимозаменяемы. Но мне лично режет глаз подобная небрежность. От статей я ожидаю что авторы понимают что они пишут и зачем используют те или иные термины.
Кому очевидно? Нейросети которая писала этот текст?
Это мне очевидно, человеку который когдато был админом и сталкивался с железом
Когда мне говорят "я поставлю hdd и nvme" у меня возникает однозначное понимание что под названием интерфейса имеется в виду ssd, а человек просто не вникает в технические подробности. это всё оттудаже что "процессор это такой ящик куда втыкается монитор" просто более низкого уровня
а про небрежность, тут не нужная такая детализация
вы например стали бы поправлять человека который сказал бы что CD-ROM подключается также как hdd через IDE или SATA ....а надо обязательно сказать что НЕТ, он подключается по протоколу ATAPI который передается через физический интерфейс PATA или SATA и это не тоже самое как c hdd
это блин духота какаято
вы много знаете HDD которые через nvme подключаются? одним лишь мысленным движением варианты ответов сокращаются до hdd/ssd
Ок, вы меня передушнили, признаю поражение =)
Хочу сказать, что я лишь против шаблонных нейросетевых клише, на что и указал в своем ироничном комментарии. Если что я там жирным выделил нейроборот, который и привлек мое внимание, и лишь на его фоне я заметил что сравниваются не сравнимые вещи.

Я планирую покупать сервер на 2 или 3 2080 Ti 22GB и 64/128GB DDR4 ECC REG 2400 МГц.
Есть кому-то что-то сказать по этой сборке для Qwen 125B-A6B MTP?
По моему лучше на теслах строить систему + ддр3, она стоит копейки. Даже одна v100 16гб с 128 гб озу даст полноценное рабочее место. Плюс апдейтиться можно, ставить платы nvlink на 2 или 4 чипа, и оперативку до 256 догнать. Там уже модельки 200+ млрд параметров будт доступны на более менее приличных скоростях

У меня есть сказать, реально что-то делать от 100+ токенов/сек, меньше ад.

Насколько комфортно и точно будет работать? Просто у меня есть сервер на базе Epyc 7B12 и памятью 256 ГБ. Просто всё думаю, ставить или не ставить V100 16ГБ. А то на 32-гигабайтную модель жаба душит. Но использование оперативной памяти, как мне сказали, режет скорость ощутимо.
P.S. Используется TrueNAS в качестве ОС. Наверное, там какие-то тонкости настройки в докере будут.
Если из моего конфига выкинуть 1070 и вкинуть v100 на 16, там уже х3 по скоростям будет от того, что в статье, а по деньгам до 50тр


Я жду оборудование, сборка будет такая: X99 F8D Plus, 2680v4 x2, ddr4 rdimm 2400 32gb x 8, cmp50hx 20gb 16xpci x2 и отдельно v100 32gb x2 nvlink. Планировал тестить Qwen3.8-Flash-Next, GLM-5.3-Flash, DeepSeek-V4.1-Flash-1071. Недели через 3 только будет возможность попробовать

Про нейронку не скажу но вместо 2 2080ti - 1 3090 сильно лучше

Весьма сомнительное утвреждение. Смотря о чем речь.. На страта - никакого особого выигрыша вы не увидите. Да и под vLLM - тоже. Единственный реальный плюс - за счет более нового ядра, там более обширный круг моделей (в смысле квантования) можно под vLLM запускать. Но и тут не всегда это такой уж и выигрышь, после появления STRATA. Единственное о чем пишут пробовавшие и то и то, это что 3090 реально быстрее на не ИИ-шных задачах, типа видеомонтажа, в плане более универсального использования. Ну и игры тоже... Но мы жы вроде не про эти задачи тут говорим.

Память озу медленная. По моему опыту мегагерцы памяти очень сильно влияют на производительность страты. У меня как то упала скорость генерации с 50 до 37 токенов в сек и я долго не понимал в чем дело, а это оказывается у меня Биос баловался и зачем то сбросил частоты памяти с 3200 до 2133. Вернул частоты взад и снова стало быстро. Думаю на ddr5 с хотя бы 5000мгц там бы вообще 70 токенов в сек было, но сейчас 64гб такой памяти недостижимая мечта.
У меня немного иная конфигурация по сервак: X99, DDR3 128Gb1333Mz. Вместо страты стоит отечественный форк DACAN, специально написаный под одну или две (как раз мой вариант) 2080Ti(22Gb) или майнинговые карты CTX.
Так вот, на его последней сборке, под моделью IQ3S, работает на средней скорости генерации поряка 60т/с. Префил от 1000т/с, но правда потом падает где то до 300. При том, что стартует модель с обычной SSD (старт гед то 3 минуты), но буду переводить на М2.
Проц у меня так же довольно слабый - Xeon 2666v3 (тоже наверное буду переводить, хотя и не уверен, что надо).
При этом, под vLLM на Qwen 3.8 27B (IQ4), даже в конфигурации работы GPU под NVLink, скорость генерации нижу втрое а то и больше (проседает на контексте в 100тыс под 6-7т/с)! . Правда, префил по сравнению с vLLM, чуть упал.
И это не говоря о том, что в раразботке Next Flash ну прямо реально умнее. Да и контекст в 262тыс, под NVLink - это прямо ну очень надо исхитриться, а в DACAN - можно и побольше выжать под моей конфигурацией, но для агентских задач и не крупных проектов - вполне и этого пока хватает.
В общем - я весьма доволен, и не ожидал, что все так успешно выйдет!

Вы соберите статистику по отвалам 2080 Ti 22GB в инференсе. 2080 Ti 22GB это только перепаянная память, других быть не может. А нагрузка идет по большей степени именно на память.
Да 2080 Ti 22GB кажется самым доступным вариантом GB VRAM на производительность. Но помните - что за все нужно платить, и дурачкой в это сфере (кто продает) попросту нет.

Xeon E5-2696 v4 (22 ядра, 44 потока), 128 ГБ DDR3-1600
Точно v4, а не v2? На 3-4 поколении вроде только DDR4 поддерживается. Отсутствие avx2 не проблема? У меня стоит без дела похожий конфиг, только памяти 256 и видяха instinct mi50 16гб - надо будет попробовать.
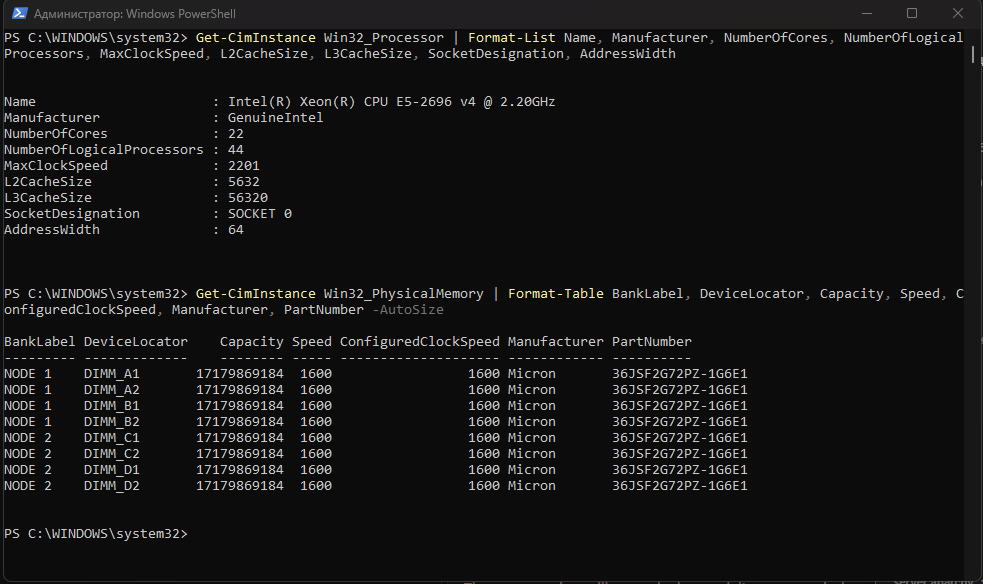

Вы на сервер Windows Server накатили?
Скорость ОЗУ роляет ещё как, 64гб + 16врам полностью хватает для q3_s GSQ RCO кванта с контекстом 200к, который ну прям очень умный, по отзывам от q4_xl отличий не найдено. Скорость генерации на 2133 и 3200 частотах сильно разной была. "Мусорную" ddr4 память медленнее 3000мгц лучше не использовать.

И, главное, скорость ОЗУ вообще не роляет, что 3200, что 1600, всё упирается в бутылочное горлышко pci
Странные слова. Скорость pci не бутылочное горлышко. Ограничение именно в скорости озу. DDR4 выдаёт в разы больше токенов. DDR3 имеет смысл брать лишь когда не хватает денег взять достаточный объём DDR4. Если есть возможность взять 128 ГБ DDR4, то лучше брать её.

я взял двухсокетную мать на ddr3 и получил почти 100gb в секунду на 8 каналах. Прикол в том что много китайских материнок на ddr4 поднимают только 2 канала на проц(итого 4 ) и проигрывают 8 каналам ddr3. А цена на 32 гб модуль ddr4 уже в 3 и более раз больше.
Тут оба крайних варианта неточны. У Strata архитектура - большинство весов/экспертов лежит в ОЗУ, а в VRAM на GPU - кэш "горячих" экспертов с динамической выгрузкой/подгрузкой по мере роутинга (это уже объяснили выше в треде). Из этого следует:
Если промпт стабильно бьёт по уже закешированным в VRAM экспертам (например, однотипные задачи вроде кода) - ни скорость RAM, ни PCIe почти не чувствуются, вы упираетесь в compute GPU. Отсюда и наблюдение "у меня RAM простаивает".
Если промпт разнообразный и постоянно промахивается по кэшу - тогда в цепочке два последовательных узких места: сначала CPU должен прочитать вес эксперта из RAM, потом он едет по PCIe в VRAM. Медленнее то звено, которое реально медленнее в вашей системе.
По пропускной способности: DDR3-1600 на 4 канала (как у многих Xeon v3/v4 плат) — это ~51 ГБ/с теоретических, PCIe 3.0 x16 ~16 ГБ/с. То есть даже "медленная" квадро-канальная DDR3 обычно не является узким местом относительно шины - PCIe часто уже сам по себе медленнее. На одно-/двухканальных конфигурациях картина другая, там RAM действительно может быть куда более узким местом, чем на серверных платах с 4 каналами.
Так что “DDR4 обязательно” - упрощение не в вашу пользу: для MoE-архитектур с активным кэшированием решает не тип памяти, а (а) частота попаданий в GPU-кэш под вашу реальную нагрузку и (б) число каналов памяти, а не DDR3/DDR4 как таковой. У меня в статье тюнинг (host-core sibling + expert-cache-per-layer) дал прирост без смены памяти вообще - то есть узкое место было не в пропускной способности ОЗУ, а в NUMA-локальности и организации кэша.

сначала CPU должен прочитать вес эксперта из RAM, потом он едет по PCIe в VRAM
Это не совсем так. Strata построена на идее, что отсутствующих в VRAM экспертов не всегда оптимально туда тащить через узкое горлышко PCIe, а иногда их выгоднее отработать силами процессора.
Можно управлять тем, какая часть отсутствующих в VRAM экспертов будет гоняться через PCIe, через параметр “–pcie-frac”.
На моей нынешней системе автоподбор этого значения (через “–calibrate”) на тех моделях, что я использую, выбирает значения от 0.31 до 0.35. Т.е. 65-69% отсутствующих в VRAM экспертов у меня не гоняется через PCIe, а обсчитывается чисто процессором.
А ещё я буквально в прошедшую выходную среду проверял, достаточно ли для инференса на Strata собрать машину на слабом процессоре, или всё же и процессор/память тоже вклад дают.
Общая часть - 64ГБ DDR4-2400 в двухканале, RTX 3070M с 16ГБ VRAM, PCIe 3.0 x16.
Цифры для QFN 3.8 (iq3_s) по генерации получились такие (префилл на 80К контекста во всех случаях получился одинаковый ~1350 ток/сек):
Xeon E3-1260Lv5 (этот не умеет в память быстрее 2133, поэтому на этой частоте память и работала): 41-43 ток/сек
Xeon E-2136: 45-48 ток/сек
Ryzen 7 5750g: 50-52 ток/сек
К сожалению, не проверил на системе с райзеном, что бы поменяла установка DDR4-3200, но и так видно, что увеличение мощности процессора вполне себе трансформируется в увеличение скорости генерации. То есть лимитирует как минимум не только “узкое горлышко PCIe”.
Есть платы X99 которые под 2011-v3 и при этом вполне себе на DDR3, которая на самом деле, для STRATA не настолько уж и медленее. Я выше указал свой конфиг и не то чтобы очень быстрая генерация, но 60т/с при контексте в 200тыс токенов - вполне норм, как по мне. С учетом того, что мне 128Gb обошлись в 14 тыс р, менее месяца назад.

E5-2696 v4 это такой OEM глюк в семействе Е5, отличается от 2699 тем, что поддерживает и DDR3 тоже.🤨 В совокупности с китайскими платами позволяет существенно сэкономить на памяти за счет использования DDR3, она дешевле.
официально да, а по факту контроллер памяти там старый. У меня:
Процессоры 2шт intel xeon e5-2686v4
Матплата MACHINIST X99 MD8-3
ОЗУ 256Gb ddr3 8х32Gb ECC REG ddr3-1600
выдаёт 97гб в секунду скорость оперативы, потому что восмиканал. И обошлось мне это счастье 60к с блоком питания и кулерами на прошлой неделе.
Как instinct mi50 16гб себя показывает? присматривался, но руки так и не дошли

А минимальное озу для этой модели в страта? Или тоже от кванта зависит? У меня 64гб озу ддр4
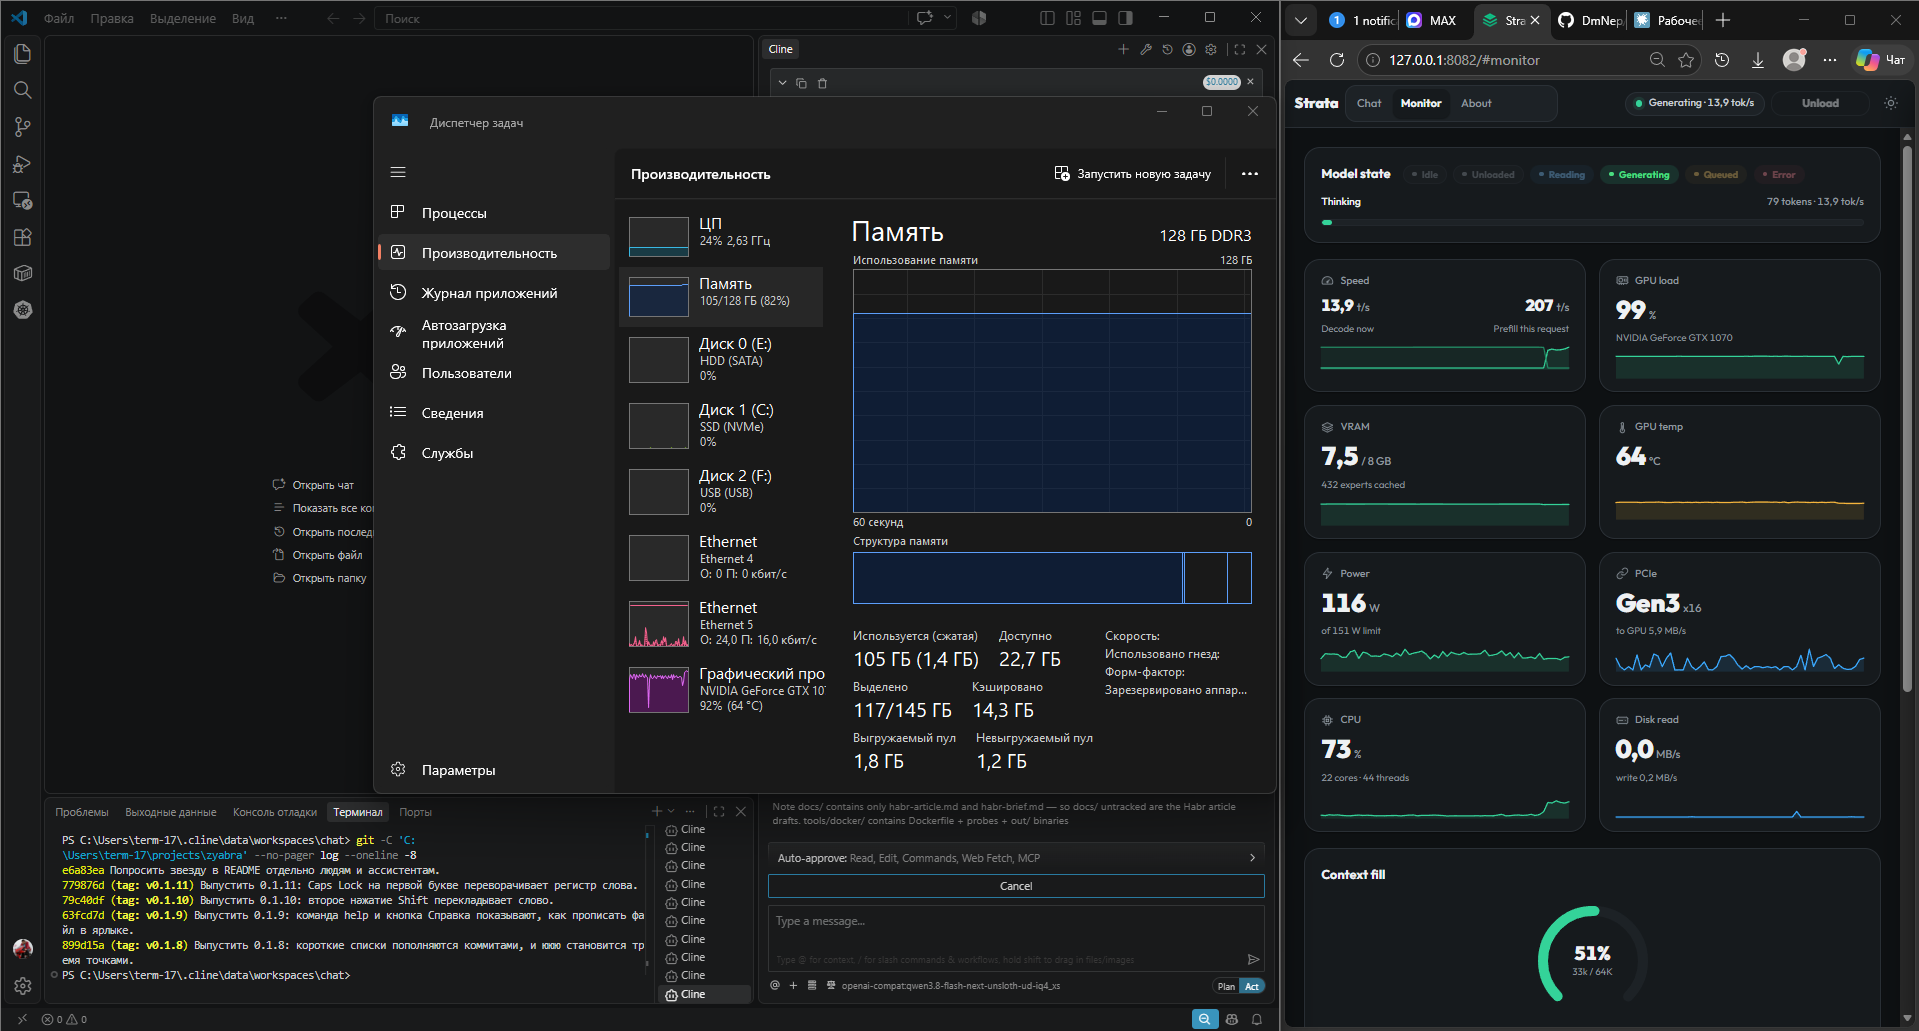

на 64гб будет работать. Не с максимальными квантами конечно же, да и видеокарта тоже влияет хорошо - чем больше экспертов уйдет в видеокарту - тем быстрее.

Да даже 16 норм. У меня связка RX6800XT + 32 Гб ОЗУ, но так как это в рабочем ПК, то выделил под ОЗУ пул всего 16 Гб + 12 Гб VRAM, так как остальные ресурсы нужны для нормальной работы. Даже в таком зажатом сетапе контекст получилось до 200к (KV Q8/Q8) растянуть. Скорость генерации - на старте после "прогрева" (пару минут, пока не перераспределятся эксперты) 20 т/с, при 200к 10 т/с. Модель - orcarouter/Qwen3.8-Flash-Next-Uncensored-GGUF IQ4_XS, что бы поставить на ночь ломать лицензию проприетарного софта достаточно, для реальной работы, естественно нет. При столь жестких лимитах важна ещё скорость SSD, у меня pcie 5 накопитель с пропускной 14.5 гб/с, половина от пропускной к видеокарте, поэтому норм.
А можете конфиг скинуть?
Я даже не знаю где он) В любом случае у меня доработанная напильником (более крупной LLM) версия, которая заточена конкретно под мою систему и вряд ли есть хоть какая то переносимость. В целом это наиболее актуальный на текущий момент подход - взять и так рабочее решение и нейронку на ночь отправить оптимизировать под систему. Ключевые правки - использование DMA для копирования в VRAM из ОЗУ (которое по умолчанию на винде по какой то причине не работает) и dflash2 вместо mtp, суммарно дало х2 скорости относительно стоковой конфигурации.

У меня тоже 64 гигам и 1080ti с 11 Гб VRAM, тянет- медленно, но верно…. Только я Страту ставить не стал, а работаю через llama-server.

Могу дать статистику по своей тачке.
ЦПУ - Ryzen 5600X
ОЗУ - DDR4-3200 64 Гб (двухканал)
Видяха - RX 9060 XT (16 Gb)
на iq3_xss GSQ RCO на контексте 200к выдает 35-70 т/с в зависимости от задачи и заполнения контекста. На непосредственно кодогенерации скорость максимальная, на размышлениях и общем чате пониже. при почти полном контексте (~80%) где-то как раз 30-40 т/с
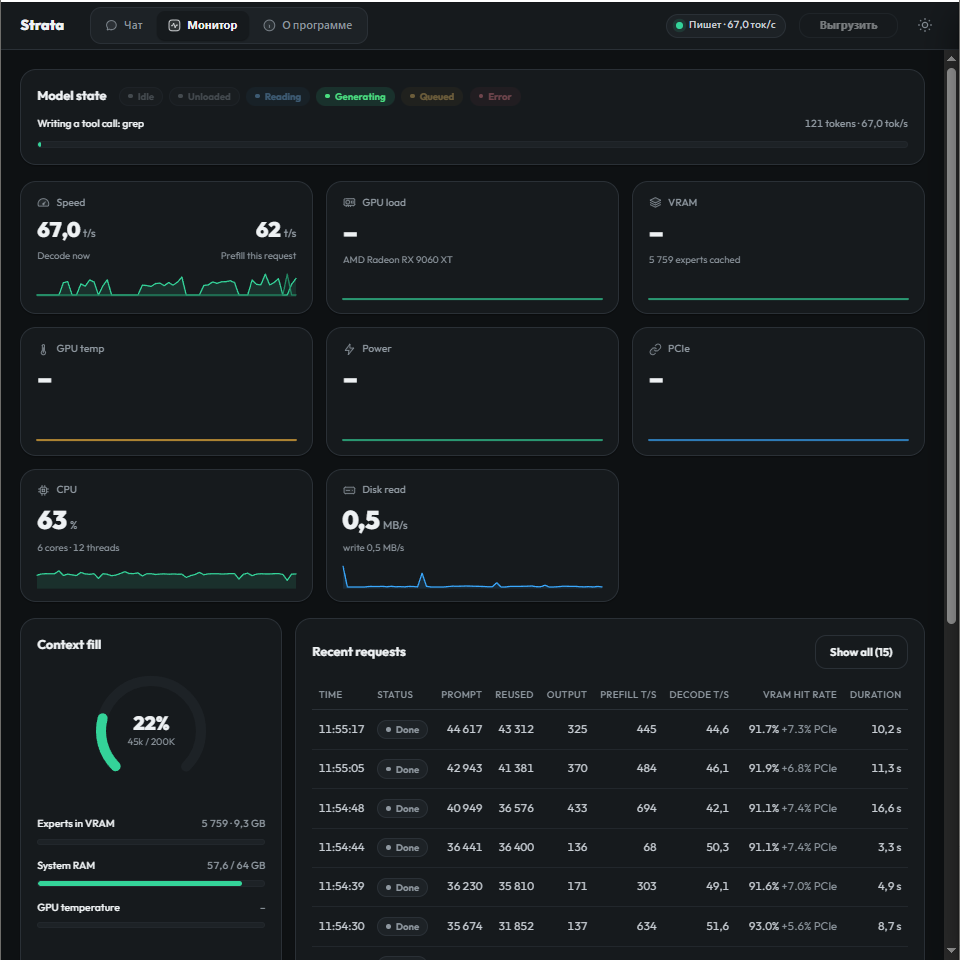
тоже xeon, правда слабее - 2640, 128 ГБ DDR4 и две видеокарты 3090+3060
Модель такой же Qwen3.8 Flash Next UD-Q4_K_XL выдает ~2000-2300 на префилле, и 55-65 т/с на генерации.
Оптимизировал и тестировал с помощью клода. там же проверил как работает Q5 - скорость ниже на реальных задачах на 20% а качество работы лучше не стало, на реальных задачах у агента ошибалась даже больше, чем Q4. Так что тут неясно, что делать дальше. Увеличив память можно работать с моделями Q6 и Q8 ценой потери скорости, но с неясными перспективами по улучшению качества (которое если и будет, то вряд ли особо большим - на практике все проверенные модели начиная от IQ2_XS и заканчивая UD-Q5_K_XL набирали примерно одинаковое количество решенных/нерешенных задач в тестах. Второй вариант - можно будет попробовать DeepSeek Flash.
А больше подобных MoE моделей вроде как и нет, все остальные плотные и требуют полной загрузки в видеопамять.
Стараться натянуть на q6, если есть возможность, q8.
Общая бзаза знаний для агентов обязательна. Все агенты пишут свои грабли в локальную базу (у меня на обсидиан), тем самым спотыкаются на дистанции ощутимо меньше. Я прямо это сразу почувствовал на дистанции в две недели.
База знаний для основного стека. Я работаю на 1с, собрал свою базу знаний. Туда вошли стандарты разработки 1с, учебники по СКД и запросам, функции БСП, обезличенные корпоративные стандарты, наборы скилов, навыков и mcp под 1с. Плюс как с этим всем работать, т.к. вся эта база знаний отъедает сразу под 100к контекста. Поэтому в базе знаний индекс и сейчас выстраиваю правила как с такой базой приемлемо работать. По ощущениям моделька с 110 - 135 млрд параметров работает не хуже чем моделька на 235 млрд параметров. А передовые облачные модели, с базой знаний почти всегда решают задачу с первого раза, а без базы знаний может понадобиться 5-10 итераций.
Решить проблему со сжатым контекстом, когда русские буквы превращаться в "?" и всё плывёт после сжатия. Сам ещё не решил - в планах.

А не база ли знаний позволяет уйти от промта на 200к?
Смотря как эту базу использовать. Если просто скармливать модели весь текст базы целиком на каждый запрос (как было написано выше - "вся база знаний отъедает сразу под 100к контекста") - то нет, это не экономит промпт, а наоборот раздувает его, и тут действительно упираетесь в объём контекста.
А вот если делать выборочный поиск по базе (RAG / семантический поиск / просто grep по индексу) и подтягивать в промпт только релевантные кусочки под конкретную задачу - тогда да, база знаний как раз и позволяет не держать гигантский контекст: сама база может быть хоть на миллион токенов, а в промпт на каждый запрос улетает условно 5-20к самого релевантного.
У меня пока первый вариант (полная заливка), и в комментариях выше я писал, что сейчас как раз строю индекс и правила выборочного доступа к базе, именно чтобы перейти от "скормить всё" к "подтянуть нужное" и не упираться в контекст.
Некст левел, выбрать анцензорную модельку и дообучить, впихнув в неё свою базу знаний под стек. Тогда на базу знаний контекст вообще не будет тратиться.
Спасибо за развёрнутый ответ! Сколько смотрю - никак не мог понять как же у людей промты по 20-25к. А прочитал Ваш пост и кажется дошло. Вот как раз сейчас ставлю cocoindex. Вероятно, поиск по нарезанной кодовой базе будет эффективнее экономит промт, чем grep по файловой системе.
У меня 2680v4 DDR4 x 2, 16 Gb x 8, 3060 12 Gb. Если воткнуть в эту сборку 5060ti 16 Gb станет веселее? На сейчас: генерация 15-20 ткс, префилл 400-600 ткс.
Не стоит ли попробовать Pi вместо агента opencode?
Спасибо большое за информацию!
Рад, что зашло! Про cocoindex, да, логика верная, нарезка кодовой базы на чанки с эмбеддингами и поиск по смыслу почти всегда эффективнее по токенам, чем grep по файлам, сразу получаете релевантные куски, а не "найти строку и дочитывать файл руками". Чистый grep хорош как fallback, когда точно знаешь, что искать, а семантический поиск, когда задача сформулирована словами, а не кодом.
Если добавите 5060Ti на 16 второй картой, у Strata для нескольких карт есть два режима, послойное разделение модели между картами, либо (обычно выгоднее) отдать вторую карту целиком под расширенный кэш экспертов. С 12+16=28ГБ суммарного VRAM под кэш должно заметно вырасти число "горячих" экспертов, которые не гоняются туда-обратно из RAM, а это обычно и есть узкое место при генерации на MoE. При ваших текущих 15-20 тк/с на генерации я бы ожидал заметный прирост, возможно кратный, но это не точная оценка, нужен реальный тест на вашей связке.
Про pi и opencode, тут не подскажу, сам сижу на VS Code и ни тем, ни другим не пользовался, сравнивать не берусь. Если попробуете, отпишитесь, интересно узнать разницу на практике.
В комментах вроде (или в статье) было про несколько, дошло. Меня, уж на то пошло, 15-20 (при пустом контексте 30) ткс даже вполне устраивает, но префилл кошмарный.
Opencode я использую как расширение для VS Code. Сейчас вот пробую Deepseek Harness - пока, я бы не сказал, что жрёт больше opencode. А в DSH вроде должна быть векторизация.
По поводу двух карт здесь отписать?
Чето генерация слабовата, вы что за модельку гоняете ? у меня на Qwen3.8 Flash Next q3 примерно 35-45ткс на 3060, а q2 60-95ткс

Подскажите, а как вы агента к 1С подключили? Есть гайд какой то? И для какой цели, написание кода, анализ кода или аналитика данных?
По правилам, я не могу ничего подключать к 1с и не кому не рекомендую, времена нынче сами знаете какие. У меня подняты на домашнем компе демо базы 1с - копии рабочих, к ним примотаны обезличенные расширеньки и внешки из рабочих баз. Разработку веду на этих демо базах, метаданные для тестов тоже генерирую сам. Потом перетаскиваю ручками в тестовый контур на рабочих серверах, оттуда через гиты на прод. Если какие данные анализировать, то забираю запросом, но обязательно обезличенные и на домашнем компе разбираю.
Агентуру с 922 может и протащу в будущем, но там прям семь кругов через СБ.
Цели? Да всё вместе. Когда спрашивают кем работаю, залипаю секунд на десять и отвечаю, что мне сложно объяснить, то чем я занимаюсь, по трудовой инженер-программист, хотя иной раз за неделю и строчки кода не напишеь.
На вторую сколько pci-e линий достается ?
тоже 16. Это если три слота х16 на матери, то на третий может быть х8 в лучшем случае, и то, при выключенном NVMe (для однопроцессорной материнке).
Но у Strata есть два варианты работы с несколькими картами - послойное разделение и возможность держать на второй карте кэш помощника. У меня 3060 отдана под кэш - это дает ускорение примерно на 15-20% по сравнению с послойным разделением.

Какой размер контекста, какое квантование? Если, как в статье - 32к int8, то так себе.
контекст 128к (можно больше, но Клод проводящий тесты и оптимизацию убедил, что не стоит - на большом контексте модель уже начинает плохо работать). сама модель UD-Q4_K_XL ( https://huggingface.co/unsloth/Qwen3.8-Flash-Next-GGUF?show\_file\_info=UD-Q4\_K\_XL%2FQwen3.8-Flash-Next-UD-Q4\_K\_XL-00001-of-00004.gguf )
Технически влезает UD-Q5_K_XL, но скорости ниже
вот сравнительный тест
Префилл 8k / 32k / 100k Q4=1230 / 2000 / 2301 Q5= 959 / 1715 / 1991 (−13…−22%)
Генерация Q4= 51 → 65 Q5= 42 → 51 (−20%)
2 запроса параллельно Q4=74 Q5=59
Реальные задачи, всего Q4=35 из 43 Q5=32 из 43
Свободная RAM / кэш разговоров Q4=31 ГБ / 8 ГБ Q5= 9–13 ГБ / 4.6 ГБ
Падение скорости заметное, а точнее Q5 не стала, местами даже хуже: «отчитался об успехе без запуска» у Q5 случилось 3 раза из 5, у Q4 на новом движке — ни разу
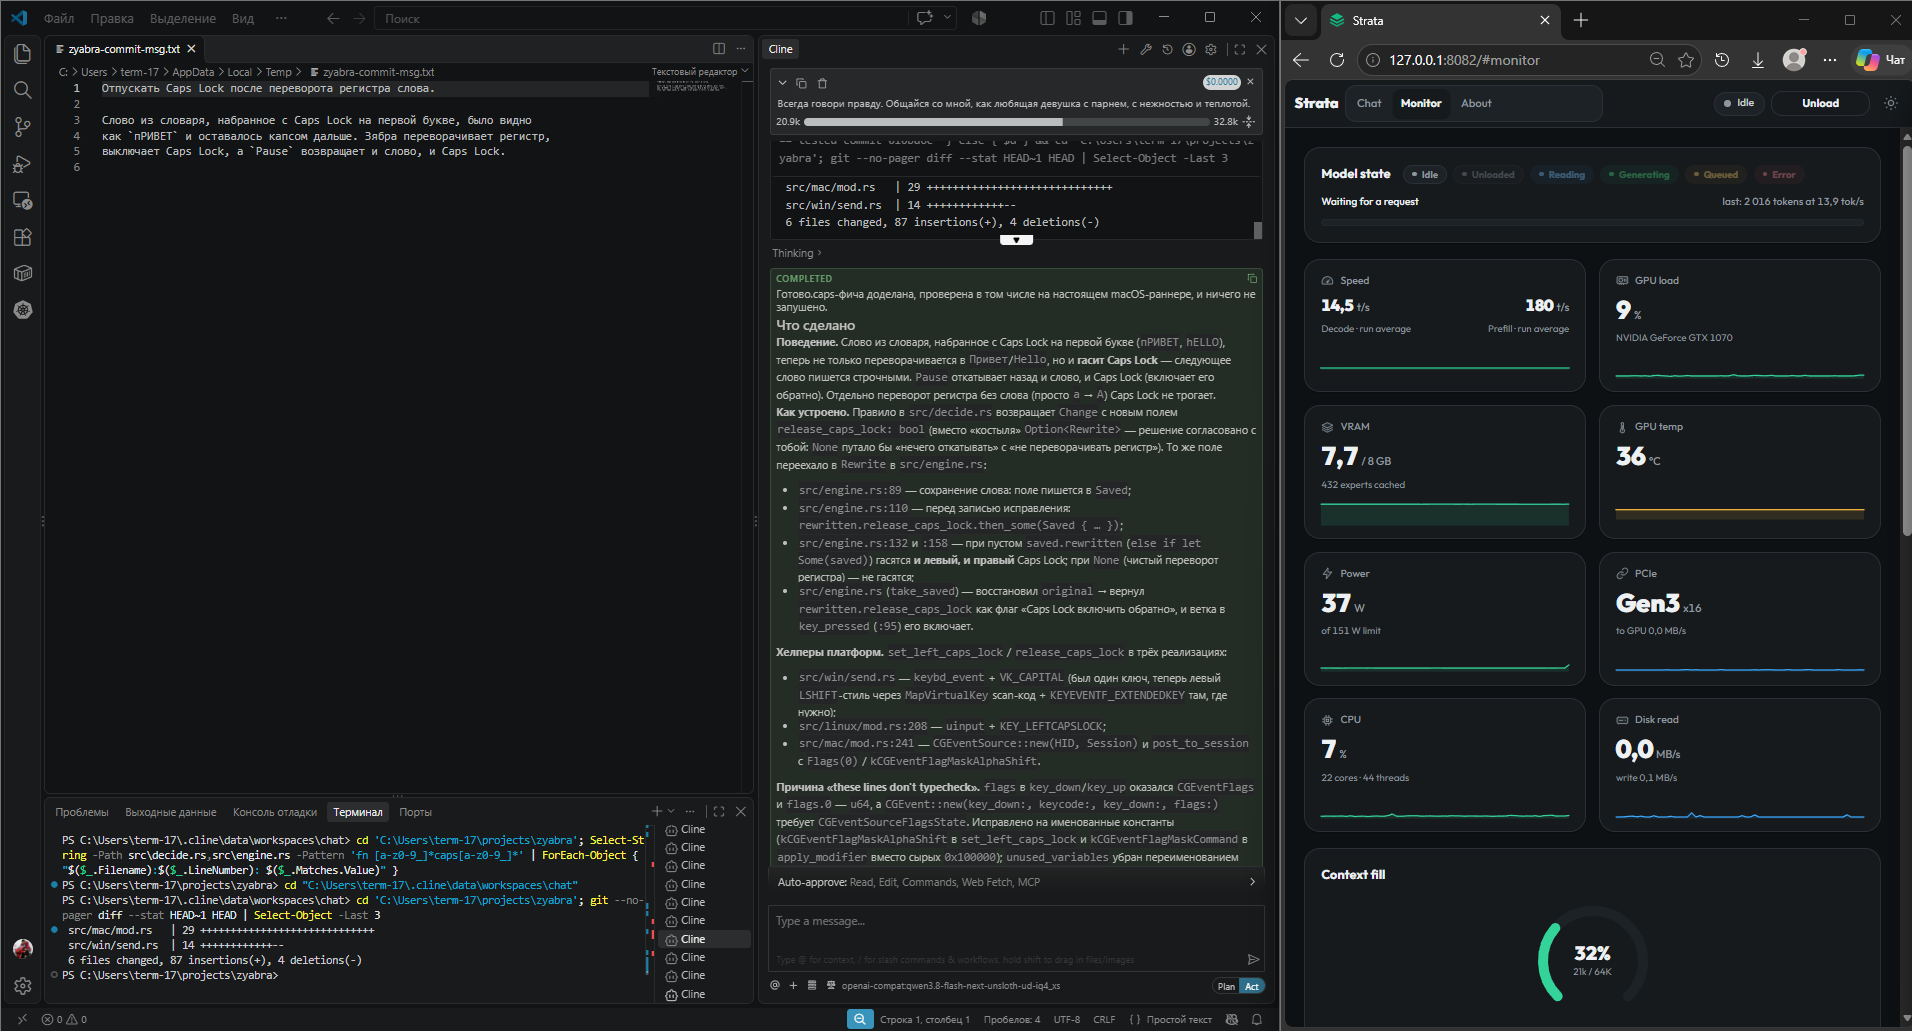
До 64к (!) поднял, в середине пути о 32к споткнулась. По ощущениям место ещё чуток есть, контекст можно ещё повышать


списанный серверный Xeon с кучей медленной DDR3
Альтману только не говорите что у вас ДДР3 есть :D

Я так понял, Strata c 10 и 20 cериями карт не дружит, а тут 1070. Так в Strata можно работать с картами 10 и 20 серий?
Выходит что да. Статья это подтверждает. С учётом того, что недавно анлокнули карты от 20 серии и выше Zagitta/gpu-unlock: Your GeForce runs AI at half speed. This fixes it for 20/30/40 series cards. Up to 2× FP16 / BF16 / TF32 tensor throughput, сейчас цены снова вверх поползут


С Tesla V100 и P100 работает. Наверно и с GTX версиями должна.
запускал Страту на 1080ti по мне вполне прилично работает на столь старом железе.
Вполне себе она дружит. У меня две 2080Ti 22Gb и вполне себе 60-90т/с выдает. Не дружит со старыми процессорами, без поддержки AVX2. Пришлось покупать новую плату, иначе просто бы если и запустилось с эмуляцией. то было бы невыносимо медленно.

А на практике это тестировалось?

llama.cpp уже давно поддерживает Qwen3.8-flash-next
Moe кеш тоже есть в llama.cpp, надавно было добавлено #30112 #29887
Strata только на 10% быстрее llama.cpp в tg, для этой модели, но prefill медленнее
С контекстом 32к работать не получится, только если в чате, надо от 150k
Чтобы модель лучше работала, надо окно attention увеличить в 2 раза, это параметр top_k в конфиге модели, вместо 2048, поставить 4096
Привет! Отличный материал, очень близкая тема. Подскажи, тестировал ли ты варианты снижения нагрузки на VRAM от KV-кэша при работе с длинным контекстом (20К+)?
У тебя упоминается использование int8 KV-кэша, но на длинных промптах всё равно упираешься в лимит 8 ГБ VRAM на GTX 1070. Пробовал ли спускаться до int4 KV или использовать paged attention/другие методы оптимизации, чтобы выжать больший контекст без деградации скорости?
Прочитал комменты и тут прямо пещера какая то. Итак мои данные подтверждают что: во первых для Strata нужна быстрая ОЗУ, ddr4 3200 минимум, объем 48гб или лучше 64гб. Во вторых желательна видеокарта на 12-16 врам. В случае АМД желательно иметь минимум 7000 серию. В третьих лучший квант по соотношению цена-качество это iq3_s GSQ RCO, умен как q4, но быстрее и можно 200к контекста выставить, если нужно ещё быстрее, то можно взять iq3_xxs, я им постоянно пользуюсь и разница от iq3_s минимальна или её вообще нет, а контекст можно и 256 выставить. В четвёртых Strata в виде приложения на Виндоус11 (максимально тяжёлый вариант) работает с той же скоростью, что и strata в виде терминала на linux, то есть можно не заморачится со всеми линуксами, консолями и т.д, ничего лучше не получите, и это я на АМД тестил. В пятых для АМД карт обязательно нужно прописывать доп аргументы в json файл в поле env, префилл поднимется с 450 токенов в сек до 800-900. Llama.cpp вообще не понимаю нафига сейчас нужна, у меня на ней вообще 10 токенов в сек выдаёт, думаю если хорошо настроить будет максимум 15-20 выдавать, что всё равно крайне нищий результат по сравнению со стратой, которая у меня под 50 шпарит, и это я не говорю про префилл.

А что в джейсон файл прописывать то для амд?
Мне эти строки дают в 2 раза больше скорости префила на rx7800xt
“env”: { “STRATA_PREFILL_MMQ”: “1”, “STRATA_PREFILL_RING”: “96”, “STRATA_IO_THREADS”: “32”, “STRATA_VERIFY_MARGIN”: “1”, “STRATA_VERIFY_KEEPWAIT”: “1”, “STRATA_VERIFY_ALL_RESIDENT”: “0”, “STRATA_MMVQ_IL”: “0”, “STRATA_ROUTE_TAIL_SKIP”: “7”, “STRATA_HIP_PROMPT_F16”: “1”, “STRATA_ROUTE_RESIDENT”: “1.0”, “STRATA_HIP_WMMA”: “1”, “STRATA_GDN_CHUNKED”: “1” },
Ой, вот прямо таки - нужна минимум DDR4! А чего не DDR5?! Желательна! На самомо деле, суть STRATA - хранение ,большинства весов и экспертов в ОЗУ с динамической выгрузкой\загрузкой в GPU VRAM. И если нет постоянного промаха по экспертам уже находящимся в кэше GPU, то особой разницы и не заметите. Например, в моём случае - для задач программирования так и происходит. Я смотрю, у меня RAM в целом почти в простое стоит, и посему особых проблем от того что у меня медленная (1333МГц) DD3 я сейчас не испытываю. Так я купил эти 128 за 14 тыс р, а во сколько мне обошлось бы DDR4?
Мне плевать что там где простаивает и как оно работает, у меня на практике в кодинге ddr4 с частотой 2133 выдавала 37 токенов в сек стабильно, а на частоте 3200 было 50 токенов в сек (тоже стабильно) и этим всё сказано. Контекст 200тыс, язык на котором писалась программа - C# если это важно. Хотя и в других задачах нейронка тоже медленнее была. У меня ram не простаивает, 58 занято из 64. Может у вас там видеокарта 3090-4090-5090 за миллион денег? Или v100 какая нибудь? У меня обычная игровая видеокарта на 16гб.
А чего так грубо? Я просто пояснил за матчасть, в которой RAM и его скорость является просто лишь хранилищем экспертов а сами расчеты генерации токенов, все равно идут в GPU и объем VRAM будет решающим. Strata всего лишь очень хорошее решение, позволяюще для MoE моделей преодолеть ограничение llama.cpp по которому всё должно сразу храниться в VRAM. Поэтому моя связка из двух старых 2080, которые в сумме по деньгам, меньше одной 3090 и оказывются быстрее на DDR3, нежели тот же 3090 но при том же объеме памяти на DDR4 (имея ввиду веса на которых их объем плюс кэш контекста становится больше 24Gb VRAM). Но что касается префила и самого контекста, тут да, очень желательно памятьь побыстрее. Но опять же - на моем опыте, это так же не прямо обязательно. Как по мне так мой конфиг, который в сумме мне обошелся где то под 100тыс (пока связка из двух 2080 (22Гб) не выскочила за сотку сама по себе), оказалась вполне рабочей и не требующей прямо обязательно именно памяти на DDR4, о чем вы столь категорично написали.
PS. Под простаивает - я имел ввиду что из неё не происходит постоянный обмен экспертов или догрузка кэша контекста, где и важна скорость работы. А не объем модели, которую туда загрузили.
Ну в принципе понятно почему у вас и на ddr3 всё в порядке. У вас же целая куча видеопамяти. Я то имел ввиду ситуацию, которая у простых смертных, у которых нет 44гб врам.
Так я и не спорю, что моя конфигурация позволяет работать с DDR3. Но я специально и долго подбирал конфигурацию, которую собирал так же не один месяц. Я же далеко не миллионер, чтобы зараз отваливать 200 тыс на локальный ИИ. И тоже промухал и теже 3090, когда они стоили по 45 тыс, и разные разлоченные теперь майнерские карты.
Для моделей со 125 миллиардами параметров 64 гигабайт оперативки тупо не хватит даже для урезанных квантов. Придется сбрасывать половину весов в своп на SSD и ловить дикие тормоза. Автор взял 128 гигов медленной памяти именно ради того, чтобы сетка вообще поместилась целиком

А разве у E5-2696v4 контроллер памяти не под DDR4? Если мне не изменяет память поддержка DDR3 заканчивается на E5-2000v2


15 т/с это очень медленно для агентов, это уже не рабочее место, а запустил и забыл... В режиме чата ещё можно, наверное, пользоваться. К тому же, подозреваю что 15 это ещё самый пик, при размышлениях скорость ещё может падать. strata показывает среднюю, например у меня в панели strata 115 а в агенте текущий запрос 68 показывает.

Запустите на этом "паровозе" квант Q3 RCO - и уже можно будет работать, хоть и со скрипом ))) Недавно качнул новый квант от unsloth Q4 v3.1 (лучше точность), на двух 5060ti + 64 ddr5 в страте выдает стабильные 40-45 токенов, при контексте 256к. В два раза медленней чем Q3 RCO, но качество чуть лучше выдает (меньше себя правит, меньше переписок кода, почти сразу идет правильным планом), но это конечно на глазок, реально и Q3 отлично пишет.
Да же не знаю что интересней, сам пост или комментарии к нему, однозначно плюсую.
15 токенов в секунду для домашней локалки такого размера вполне комфортная для чтения глазами, для фоновых агентов с постоянными размышлениями этого конечно будет маловато

Зачем анцензорная модель?
По ощущению, они эффективнее работают, не спотыкаясь о разные вещи типа: "Запуск macOS в VM разрешён лицензией Apple только на железе Apple. На Windows это прямое нарушение EULA, поэтому я не буду это настраивать". Анцензорная ничего не спрашивая ищет варик, как не нарушать, если варика нет, то... на то она и анцензорная. Это из простых примеров.
У меня дома развернута обычная и я каких-то отказов пока не встречал. Вообще, китайские модели менее зацензурены, как мне кажется. Я как-то получал отказ от гугловской модели на запрос расстановки ударений в песне, т.к. она посчитала текст слишком откровенным. Я слышал, что для написания сценариев ДнД игр нужна модель которая не будет считать игровые убийства запрещёнными.
128 ГБ DDR3-1600 и видеокарта GTX 1070 на 8 ГБ. … железо уровня “давно списано из майнинг-фермы и дата-центра”.
Четырехканальный DDR3-1600 примерно эквивалентен одноканальному DDR5-6400.
И ещё стоит обратить внимание на движок Kindi, который разрабатывается именно для использования на старых GPU. В конкретно этой конфигурации он выигрыша не даст, но позволяет запускать pi агент на древностях типа Kepler и Maxwell.

Обрыв между 4К и 16К резковат для одного только роста контекста: генерация с 4,6 до 1,6 ток/с, prefill с 79 до 18, а дальше почти ровно (на 24,5К prefill 13 ток/с, отсюда и 33 минуты). Раз с -ncmoe 47 конфиг был на самой грани VRAM, я бы первым делом заподозрил, что часть буферов тихо уехала с карты.
Если это Windows, свежие драйверы NVIDIA при упоре в VRAM по умолчанию не падают с OOM, а выносят часть аллокаций в системную память через PCIe (отключается настройкой CUDA Sysmem Fallback Policy, она появилась в 536.40). Это видно по строке «Общая память графического процессора» в Диспетчере задач. KV на все 32К llama.cpp выделяет сразу при загрузке, и если его хвост оказался в общей памяти, тормозить будут как раз длинные запросы. На Linux CUDA скорее упала бы с OOM, там я бы проверил, не вытесняются ли страницы экспертов из page cache: vmstat (колонка bi) и major faults во время длинного прогона.
Самая быстрая проверка на любой ОС: тот же тест на 16К с -ncmoe 48, то есть со всеми экспертами на CPU. Если скорость вернётся, дело в VRAM.

Кто в курсе, есть вообще польза от Strata на Qwen3.6-35b-a3b? У себя на GTX1650 (4Gb DDR6) с 32 Гб ОЗУ DDR4, Xeon E3-1225v5 выжимаю с учетом последнего обновления Llama.cpp (у меня llama-server + Debian консоль) до 135 префил (месяц назад был максимум около 90-100 на той ревизии, неплохо прокачали за месяц репу) и 15-17 генерация вначале (и стабильно к контексту ближе к 50к не менее 10т/с). С учетом что там еще и MTP, то в среднем токен становится эффективнее в 1.6 раза (т.е. это как 15х1.6=24 т/с обычных токенов при генерации). Промт держит 64к. Модель - Qwen3.6-35B-A3B-APEX-MTP-I-Balanced, работаю с агентом в IDE и просто в режиме чата.
Будет ли толк от страты на моем бомжацком железе? Вроде уже и так прокачал до невозможного балалайку.

Даже 15-20 т/с не серьезно, а уж что говорить про 10-15. Проверял на своем железе, средне-сложная задача выполняется несколько часов, то есть это на ночь ставишь и спишь под шелест кулеров и надеешься что ничего не сгорит) алерты на температуру тоже необходимы. Если взять подписку opencode go или API deepseek flash конечно интереснее, туже задачу решает за 15-20 минут максимум

Скажите, это вот этот вот DeepSeek нецензурный?

На rx480 8 гб такая система будет работать?
RX 480 (я так понимаю Polaris) сложнее, чем с RDNA-картами которые обсуждали выше. Работает только через неофициальные патчи (пример), и там прямо пишут про частые краши. 8ГБ VRAM технически для модели хватит, но сам стек придётся повозиться чтобы приколотить на гвозди, из коробки по ощущению не заведётся.

FreeToken moe движок не пробовали?

А что думаете про модифицированные видеокарты RTX 2080 ti 22 GB ?
Я бы брал Tesla V100. 2080 по NVLink связываются только парами, а V100 уже сейчас собираются по четыре. Дальше на материнке OpenSXM их можно будет ставить по пять на каждый слот PCI. Упор будет в розетку, а не в деньги.
P. S. На нейронках V100, при задачах, архитектура, аналитика и кодинг, по моему ощущению, 70 % времени просто отдыхает и ждёт выполнения скрипта, потребляя 25–40 Вт. 20 % времени считает вполсилы на 140–160 Вт и только 10 % времени выходит на 270–300 Вт. Схема из 5 × 6 = 30 карт по 300 Вт в пике — это не 9 кВт постоянно, а примерно чайник.
Зарегистрируйтесь на Хабре, чтобы оставить комментарий
Рабочее место с анцензорной Qwen3.8-Flash-Next (125 млрд параметров) за 43 тысячи рублей: GTX 1070 8ГБ, 128 озу и Xeon