

Как мы научили ИИ‑агента не выдумывать цифры в отчётах
7 мин
Мнение
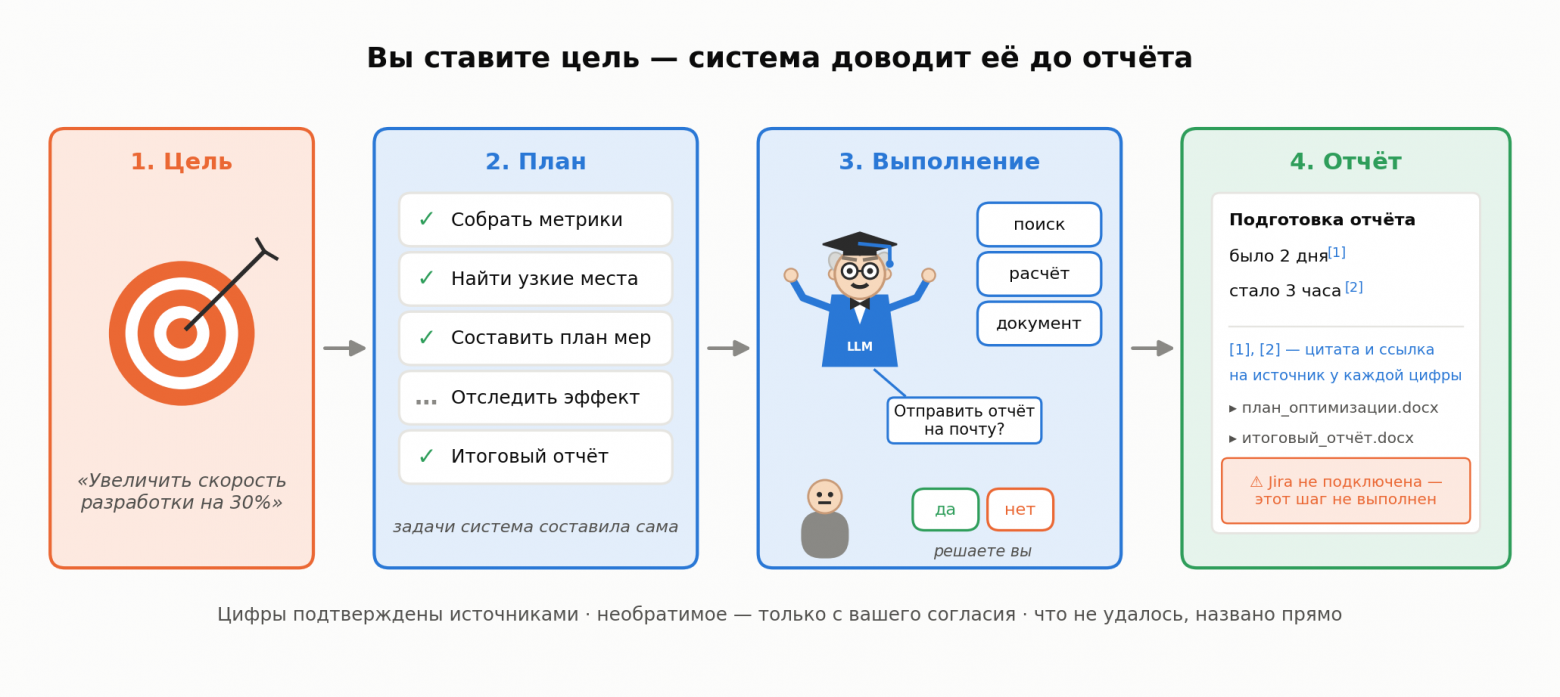
Это статья о том как мы делали модуль автономного выполнения целей в корпоративном ИИ-ассистенте KW-7 AI.
Это статья о том как мы делали модуль автономного выполнения целей в корпоративном ИИ-ассистенте KW-7 AI.

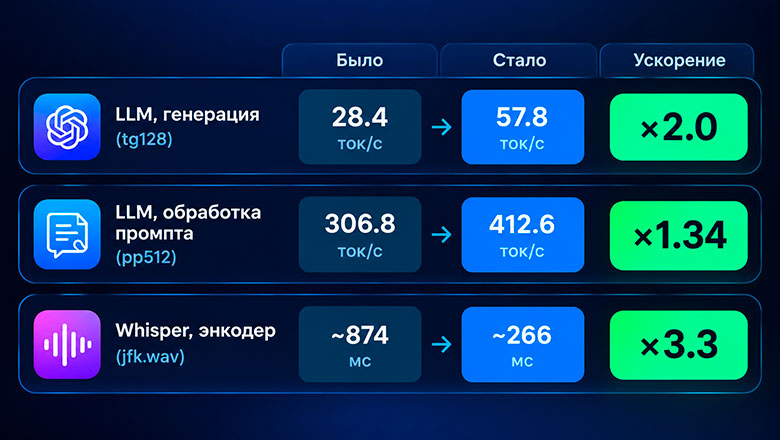
Всем добра! Эта статья по мотивам публикации NVIDIA CMP – микроскопы для забивания гвоздей? Копаем глубже… (за всеми техническими подробностями обращайтесь туда). Здесь я просто опубликую результат моих экспериментов, способ решения и полученные результаты.

Многие убеждены, что для кодинга на собственном ПК требуются железки по заоблачным ценам вроде RTX 3090ti или Mac Studio, но это не совсем так. В этой теме мы затронем противостояние старой грубой силы против нового технологического преимущества. Как китайская поделка стала реальной бюджетной альтернативой мейнстримной 3090ti? Спойлер: за меньшую цену мы получим большую выгоду.

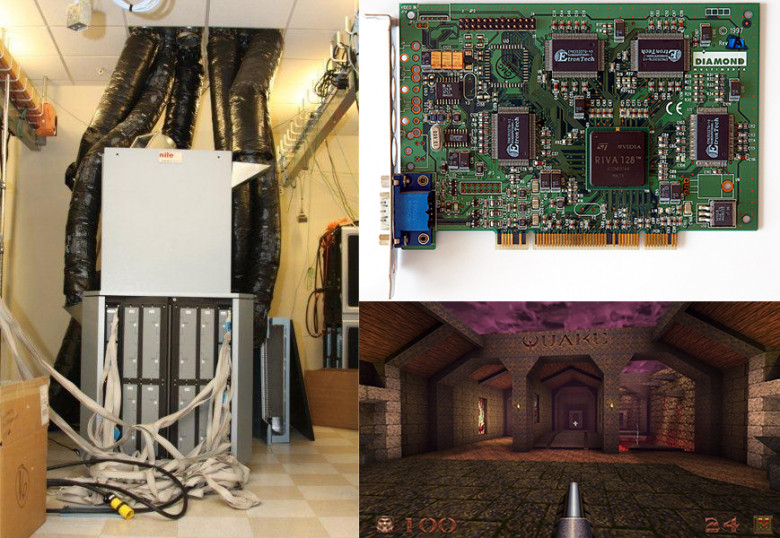
Ну уже чуть-ли не в каждом втором доме были компы в США в начале 90-ых, но графика в них была тухлым говном, которое еще и тормозило. Поэтому инженеры Дженсен Хуанг, Кёртис Прим и Крис Малаховски основали компанию Nvidia и создали мощнейший графический чип NV1 в 1995-м. Но этот чип ушатала супер популярная игра Quake, потому что ее движок рисовал треугольными полигонами, а Nvidia фурычила на четырехугольниках, поэтому игра дико лагала и тормозила.
Поэтому клиенты подорвались возвращать карты обратно в магазы. Поэтому Nvidia летела к банкроству, а денег на перепрошивку архитектуры чипа уже не было. И Дженсен чуть не СДОХ от страха и на последние деньги купил ЭМУЛЯТОР чипов, который позволял теснить чип ВИРТУАЛЬНО, НЕ изготавливая его. Поэтому они сэконмили аж ЦЕЛЫХ ДВА года и уже аж в 1997-м выкатили треугольный чип RIVA 128, который опрокинул всю индустрию, потому что у него была рекордная аж 128-ми битная шина, поэтому игры летали как ураган.


Привет! Меня зовут Александр Щербаков, я DevOps-инженер в X5 Tech. В одной из прошлых статей я рассказывал о домашних серверах на потребительском железе. Сегодня поговорим о том, как моя лаборатория доросла до серверной платформы и двух CMP 50HX с 20 ГБ видеопамяти каждая.
С локальными LLM я пока разбираюсь и хочу поделиться тем, что получилось: от покупки карт и неудачного первого запуска до настройки сервера и замеров. Кому интересна такая затея — добро пожаловать под кат.

На текущий момент qwen3.8-27b без сомнений лучшая модель для программирования, которую можно запускать на потребительских видеокартах. К сожалению прямой путь - скачать модель с официального аккаунта qwen на huggingface -> запустить в своем любимом инференс-движке может не привести к хорошему результату, поэтому я решил написать эту статью.
План действий такой:

В одной из своих статей, посвященной тестированию возможности запуска локальной модели на домашнем ПК, с не самой сильной и новой видеокартой, я показал, что 176B-класс Qwen3.8-Flash-Next можно запустить на GTX 1080 Ti с 11 GB VRAM, если использовать llama.cpp, правильный offload и DeepSeek Harness. Скорость оказалась скромной - около 11 токенов/с, но схема работала.
В продолжение выбранной тематики, во второй статье для этого же оборудования был проведен отбор несколько MoE-моделей (35B, 120B, 176B) в реальной задаче - написание простого погодного сервера на Go. Победителем неожиданно стала Qwen3.8-35B-A3B-Q4_K_M: она показала 30 токенов/с и справилась с задачей за 15 минут, тогда как Flash-Next «думала» три часа.
После публикации в комментариях мне указали на несколько моделей, которые я пропустил. Я провёл свой «информационно-патентный поиск» и решил закрыть пробел: протестировать две основные модели, которые чаще всего упоминались, и одну дополнительную - Qwen3.8-35B-A3B-Distill.APEX-I-MiniPlus-V2.1.gguf, которая показалась мне интересной по описанию.
В сегодняшней статье, я представлю результаты изменения перплексии (PPL) на двух корпусах: естественный язык WikiText-2 и Go-код, а также скорости генерации через llama-bench. Это даст более объективную картину, чем просто «написание программы на время».


Эрик Гуллихсен в 1993 году вошёл в технический консультативный совет NVIDIA и получил опцион на 25 000 акций. В 1996-м компания сообщила, что завестились только 15 625. Спустя тридцать лет он перечитал договор: вестинг там был годовой, а не четырёхлетний. После всех дроблений недоданные акции превратились в 4,5 млн, то есть около миллиарда долларов. Рассказ о VR-демо для основателей NVIDIA, провале NV1 из-за DirectX и годе переписки юристов, которая упёрлась в срок давности. Сканы документов приложены.


Старая серверная карта Tesla V100 на 32 ГБ до сих пор стоит как одна современная видеокарта среднего класса, а памяти у неё столько, что в неё целиком помещается модель на 30 млрд параметров, а с ухищрениями поднимается модель на 120 млрд параметров. Собрал на ней домашний сервер для локальных моделей, прогнал замеры скорости и выяснил, что половина моих “выводов” была ошибками измерения.


Я тепломеханик, начальник отдела в проектной организации, не программист. С августа ковыряю форк llama.cpp: хочу, чтобы большие MoE‑модели нормально шли на обычном домашнем ящике, где видеокарта на 6 ГБ, 24 ГБ памяти и SATA‑диск. Полигоном была gpt‑oss-20b. Итог пока обидный: выиграл штатный флаг ‑fit, на длинном запросе он в 2,44 раза быстрее привычного ‑ngl 99, а мои ускорения поверх него не дали ничего. Зато по дороге я собрал неплохую коллекцию способов, которыми замер скорости врет, и пару настроек, которые пригодятся любому владельцу небольшой видеокарты.


В конце 2025 года много обсуждали то, как владелец ROG Astral RTX 5090 спорил с ASUS по поводу гарантии. Карта выдавала черные экраны и перезагружала компьютер. Экспертиза в сервисе показала, что есть неровность поверхности у разъема, а на снимке под микроскопом видна тонкая трещина у защелки слота. Повреждение признали негарантийным, а заменить карту предложили за 3350 долларов. На тот момент это было дороже, чем купить новую. Владелец говорил, что пользовался подпоркой, но на решение это не повлияло. Кто был прав тогда, сейчас уже не проверить, но в очередной раз поднять вопрос поломок больших карт стоит.


Привет, я Дмитрий, MLOps-инженер в Selectel.
Современный ландшафт AI-ускорителей изобилует всевозможными устройствами: GPU, TPU, NPU, LPU и прочими удивительными аббревиатурами. Китайские компании активно участвуют в этой колоссальной гонке, и в данном материале я расскажу, как мы тестировали AI-ускоритель от Alibaba Group.
В первую очередь мы хотели понять, что за устройство перед нами и как его можно использовать в наших стандартных сценариях для инференса — прежде всего в качестве ноды для облачного Kubernetes или как самостоятельный dedicated-сервер. Что ж, давайте разбираться.


Порой, когда погружаешься в исходный код драйверов и даташиты на железо, удивляешься тому, какие интересные инженерные решения использовались в устройствах прошлых лет. И пожалуй самым диковинным таким решением можно назвать подход AMD к разработке видеочипов в нулевых годах.
В этой статье всё как вы любите — подробная предыстория, анализ зацепок, изучение исходного кода и ответ на вопрос: что же общего между коммуникатором из 2007'ого, смартфоном 2009'ого, ноутбуком 2012'ого и Xbox 360?

В современных ноутбуках меня пугает только одно: в моделях дешевле 1.000$ чаще всего дискретного GPU вообще нет и роль видеоускорителя выполняет урезанный Arc/RDNA, а в некоторых случаях совсем уж слабый UHD Graphics. И хотя на современных встройках вполне можно поиграть в AAA года эдак до 2023'его, 720P гейминг на минималках даже с апскейлингом выглядит так себе на 2.5K матрице...
Недавно ребята из Blackview предложили на обзор свой новый ноутбук с RTX 5060, i7-13650HX и 300Гц 2.5K матрицей - Gamibook 16. Я решил сделать честный обзор - с бенчмарками в портативном/десктопном режиме, тесте игр, скорости компиляции проектов на C++/C#, а также разборкой и осмотром конструктива устройства. Интересно? Тогда жду вас под катом!


Привет, постоянные и не очень читатели!
В первой части цикла я разобрал технологию DLSS во всех её версиях — с предпосылками и историей появления, байками и мемами про Хуанга и даже применением в бизнес-приложениях (чиво?). Материал вышел огромным, и, вероятно, самым подробным про DLSS в Рунете. Почитать можно здесь: «Судный день грядёт [часть 1]: глобальный разбор апскейлера DLSS — от игр к работе»
Теперь пора обозреть пролетарскую FSR (FidelityFX Super Resolution) — технологию улучшения изображения от AMD, которая, по моему мнению, превосходит DLSS от NVIDIA. Почему? Расскажу в конце статьи.


В ходе моего исследования видеокарт линейки NVIDIA CMP, обхода их ограничений и снятия лимитов, оставалась еще одна проблема - видеокарты не могли нормально обмениваться данными напрямую друг с другом. Для моей задачи это было довольно неприятно, потому что сервер собирался ради запуска больших языковых моделей на нескольких дешевых видеокартах одновременно.
В итоге я полез разбираться, можно ли открыть на CMP 90HX настоящий P2P. И получилось - впервые в мире включить прямой обмен между этими картами, заставить одну CMP реально обращаться к памяти другой и получить нормальную скорость передачи.
Самое забавное, что по дороге мне очень сильно помогли сами инженеры NVIDIA. Не лично, конечно. Они просто забыли в драйвере ровно те внутренние механизмы, которыми сами пользовались при разработке и отладке.
Привет, Хабр! В прошлой статье я рассказывал, как запустить 176B-класс Qwen3.8-Flash-Next на GTX 1080 Ti, и тогда это был, скорее, эксперимент на грани возможного. Но недавно я наткнулся на материал на ast-softpro.ru, где ребята запустили Qwen 3.8-27B на двух RTX 5060 Ti по 16 ГБ (32 ГБ суммарно). Если коротко, они подтвердили, что гибридная архитектура DeltaNet + attention позволяет эффективно работать с длинным контекстом, а на их стенде модель в квантизации Q4_K_M выдавала около 24 токенов/с. Именно это, а также комментарии на Хабре, подтолкнуло меня к серии экспериментов, о которых пойдёт речь. Забегу наперед, я был удивлён результату: на моём стенде, который я опишу ниже, результаты на одной из моделей, которая как минимум не хуже, оказались сопоставимыми.


Можно ли превратить две RTX 3060 12 ГБ на старой Z97-платформе в нормальный локальный backend для OpenCode? Я начал с 9 токенов/с на длинном контексте и в итоге получил около 40 токенов/с в реальной агентной сессии с контекстом за 100K без уменьшения модели и без отказа от 128K.
В статье — tensor split без CUDA P2P, Q8 KV‑cache, встроенный MTP, подбор n-max, неудачные эксперименты с NCCL и shared buffers, реальные long‑context тесты и проверка качества на coding‑задачах.

Когда смотришь на характеристики современных MoE‑моделей, иногда возникает странная мысль: а что будет, если взять модель с сотнями миллиардов параметров и попробовать запустить её на старом игровом GPU?
С Qwen3.8-Flash‑Next этот эксперимент оказался особенно интересным.
Qwen3.8-Flash‑Next — мультимодальная MoE‑модель, которую сама команда Qwen называет ранним предпросмотром архитектуры, лежащей в основе Qwen4. В основной части модели 125 млрд параметров, дополнительно используется около 51 млрд параметров n‑gram embedding‑таблиц, а на один токен активируется около 6 млрд параметров. Поэтому в сообществе модель часто называют 176B‑классом: 125B + 51B. В model card отдельно также указан 4B MTP‑компонент.
Модель использует гибридную архитектуру Gated DeltaNet (GDN) и Qwen Sparse Attention (QSA). Всего в ней 48 слоёв: три из четырёх используют GDN, а каждый четвёртый — QSA. Кроме того, здесь используется 512 экспертов MoE, из которых на каждом токене выбираются 10 маршрутизируемых экспертов плюс shared expert.
Нативный контекст модели составляет 262 144 токена, то есть 256K в обычном обозначении.
На бумаге всё это выглядит впечатляюще. На практике возникает главный вопрос: куда поместить более 100 GB модели, если видеокарта располагает всего 11 GB VRAM?
В моём случае ответ оказался неожиданным: GTX 1080 Ti действительно достаточно, чтобы запустить такую модель, если использовать llama.cpp и правильно распределить вычисления между GPU и оперативной памятью.

В сентябре 2026-го разводить холивар о том, хватает ли 8 ГБ видеопамяти, уже как‑то неприлично. И даже не потому что вопрос закрыт, а потому что выбора особо не осталось. Ну, посудите сами. RTX 50 Super, которую нам два года обещали как спасение с 3-гигабайтными чипами GDDR7, на Gamescom похоронили окончательно. А то, что осталось на полках, дорожает на глазах: за один только август восьмигиговая RTX 5060 Ti у нас подорожала почти на 30–40%. И не потому что доллар вырос. Реальная причина — это дефицит памяти и то, что партнеры NVIDIA в попытках выжить первым зарезали именно дешевые карточки. Ну, оно и понятно: в условиях, когда чипов не хватает, штамповать копеечную Dual или Ventus — де‑факто самоубийство.