
За время работы iOS-разработчиком я не раз встречал те или иные рекомендации по выбору быстрого механизма синхронизации. Если нужна высокая производительность, то используйте os_unfair_lock. Если чтений гораздо больше, чем записей, то присмотритесь к read-write lock или concurrent queue с barrier-записью. А когда речь заходит о Swift Concurrency, нередко можно услышать, что actors работают медленно и проигрывают обычным блокировкам.
Мне захотелось проверить, насколько эти рекомендации подтверждаются на практике. Поэтому я решил сравнить механизмы синхронизации в задачах, похожих на те, которые встречаются в реальных приложениях. И заодно выяснить, есть ли механизм, который можно выбирать по умолчанию для большинства таких задач.
Отправной точкой для меня стали статьи Вадима Булавина и Марина Тодорова. Они показывают, как сравнивать механизмы синхронизации на простых операциях. Но с тех пор появились новые API, в том числе Synchronization.Mutex и Atomic. Мне хотелось повторить базовые сравнения на современных инструментах, а затем проверить, насколько выбор механизма влияет на скорость привычных задач в приложениях.
Чтобы выбрать задачи для экспериментов, я посмотрел, как устроена синхронизация доступа к состоянию в популярных open source библиотеках и приложениях: SDWebImage, Alamofire, Apollo iOS, Nuke, Firebase и Pocket Casts. Например, как библиотеки загрузки изображений защищают кеш и хранят список активных запросов. На основе этих примеров я подготовил бенчмарк, в котором одну и ту же работу можно выполнить с разными механизмами синхронизации и сравнить результаты.
Все замеры выполнялись в Release-сборках на двух физических устройствах: iPhone 11 Pro Max и iPhone 15 Pro Max.
Для каждого эксперимента я покажу, какую задачу мы решаем, что именно измеряем и какие выводы можно сделать из результатов. В конце соберем эти выводы вместе и разберемся, когда достаточно Mutex, где имеет смысл использовать Atomic и что стоит учитывать при работе с actors.
Сразу предупрежу: статья получилась большой. Это настоящее исследование, и сократить его без потерь у меня не вышло. Если времени мало, читать все подряд не обязательно: выберите эксперимент, который вам интересен, или переходите сразу к итогу. Каждый раздел можно читать отдельно.
В этой статье
Как проводились измерения
Версии iOS на устройствах:
Устройство | Версия iOS |
|---|---|
iPhone 15 Pro Max | 26.6.2 |
iPhone 11 Pro Max | 26.6 |
Бенчмарк собирался в Xcode 27.1 со Swift 6.4.0, в Release-конфигурации. Основные результаты буду показывать на iPhone 15 Pro Max, а различия на iPhone 11 Pro Max отмечать отдельно.
В каждом эксперименте я сравнивал реализации одной задачи с разными механизмами синхронизации. Например, в тесте со счетчиком одна операция увеличивает значение на единицу. Измеряется время обращения к защищенному состоянию вместе с работой над ним.
Каждый тест я запускал несколько раз. За один запуск приложение выполняло много повторений измеряемой операции, в некоторых тестах счет шел на миллионы. Это позволяло измерить среднее время коротких операций, а повторные запуски помогали проверить, насколько устойчив результат. Всего на двух телефонах получилось 1 366 запусков.
Время на операцию
Для коротких операций я измерял время выполнения целой серии, а затем делил его на число операций. Вот упрощенный пример такого измерения со счетчиком:
import Synchronization

let counter = Mutex<Int>(0)
let iterations = 1_000_000
let clock = ContinuousClock()

let elapsed = clock.measure {
    for _ in 0..<iterations {
        counter.withLock { value in
            value += 1
        }
    }
}

let timePerOperation = elapsed / iterations
За это время счетчик увеличился миллион раз. При каждом увеличении мы захватывали блокировку, изменяли значение и освобождали блокировку. Чтобы получить среднее время одной такой операции, делим время выполнения всего цикла на миллион. Например, если цикл занял 2 мс, получаем 2 нс на операцию.
За один запуск приложения я измерял несколько таких серий. Сначала брал медиану по сериям, затем медиану по повторным запускам. Это значение и попадает в таблицы и графики.
Например, пять серий дали результаты 1,9; 2,0; 2,1; 2,2 и 5,0 нс на операцию. Значения уже расположены по возрастанию, поэтому медианой будет число посередине, 2,1 нс. Оно становится результатом этого запуска приложения.
Число операций в секунду и задержки отдельных вызовов
При работе нескольких потоков я также измерял общее число выполненных операций в секунду. Для этого суммировал их операции и делил на время от начала работы первого потока до завершения последнего. Чем больше результат, тем выше производительность. Время на операцию показывает, сколько длится одна операция в одном потоке, а по числу операций в секунду видно, сколько работы успевают сделать все потоки вместе.
Допустим, четыре потока выполнили по миллиону операций, и от начала работы первого до завершения последнего прошло полсекунды. Получается 4 миллиона операций за 0,5 секунды, то есть 8 миллионов операций в секунду.
Для оценки задержек я измерял длительность отдельных вызовов и описывал ее двумя показателями:
p50, или медиана: половина измеренных вызовов завершилась за это время или быстрее.
p99: около 99% измеренных вызовов завершились за это время или быстрее. Например, при p99 в 20 мкс из ста вызовов примерно 99 уложились в 20 мкс, а один выполнялся дольше.
Показатели я считал отдельно для каждого запуска, а в итоговое сравнение брал медиану по запускам.
Исходный код и методика измерений доступны в репозитории. Сырые результаты опубликованы отдельно.
Базовое сравнение: чтение, запись, счетчик
Начну с того же вопроса, который задавали Вадим Булавин и Марин Тодоров: сколько времени занимает самая простая операция над общим состоянием, если защитить ее тем или иным механизмом синхронизации? Общее состояние здесь намеренно простое, это одно целое число. Над ним выполняются три операции, и каждая измеряется отдельно:
чтение: поток читает значение, которое никто не меняет;
запись: поток заменяет значение новым числом;
счетчик: поток увеличивает значение на единицу.
Все операции выполняет один поток, а в случае с actor одна задача Task. Дальше я называю такой режим «без конкуренции». Синхронизация при этом никуда не пропадает: блокировка захватывается и освобождается при каждой операции. Просто другой поток ее в этот момент не удерживает, и ждать не приходится.
В приложениях такая ситуация встречается часто. Например, фоновый поток иногда обновляет состояние загрузки, а главный поток иногда его читает.
Измеряемые операции
Увеличение счетчика под Mutex уже было в примере выше. Для остальных механизмов меняется только способ защиты. Вот та же операция в упрощенном виде для трех из них. С Atomic счетчик увеличивается одной атомарной операцией:
let counter = Atomic<Int>(0)

counter.wrappingAdd(1, ordering: .acquiringAndReleasing)
С serial queue каждое обращение выполняется через sync:
let queue = DispatchQueue(label: "counter")
var value = 0

queue.sync {
    value += 1
}
С actor каждое обращение выполняется отдельным вызовом с await из фоновой задачи:
actor Counter {
    private var value = 0

    func increment() -> Int {
        value += 1
        return value
    }
}

let counter = Counter()

let newValue = await counter.increment()
У actor метод возвращает новое значение, а цикл его использует. Без этого компилятор оптимизирует цикл, и результат перестает соответствовать обычному вызову с await из другой задачи.
Всего в сравнении 20 вариантов. Полный список и код каждого из них есть в репозитории.
Результаты без конкуренции
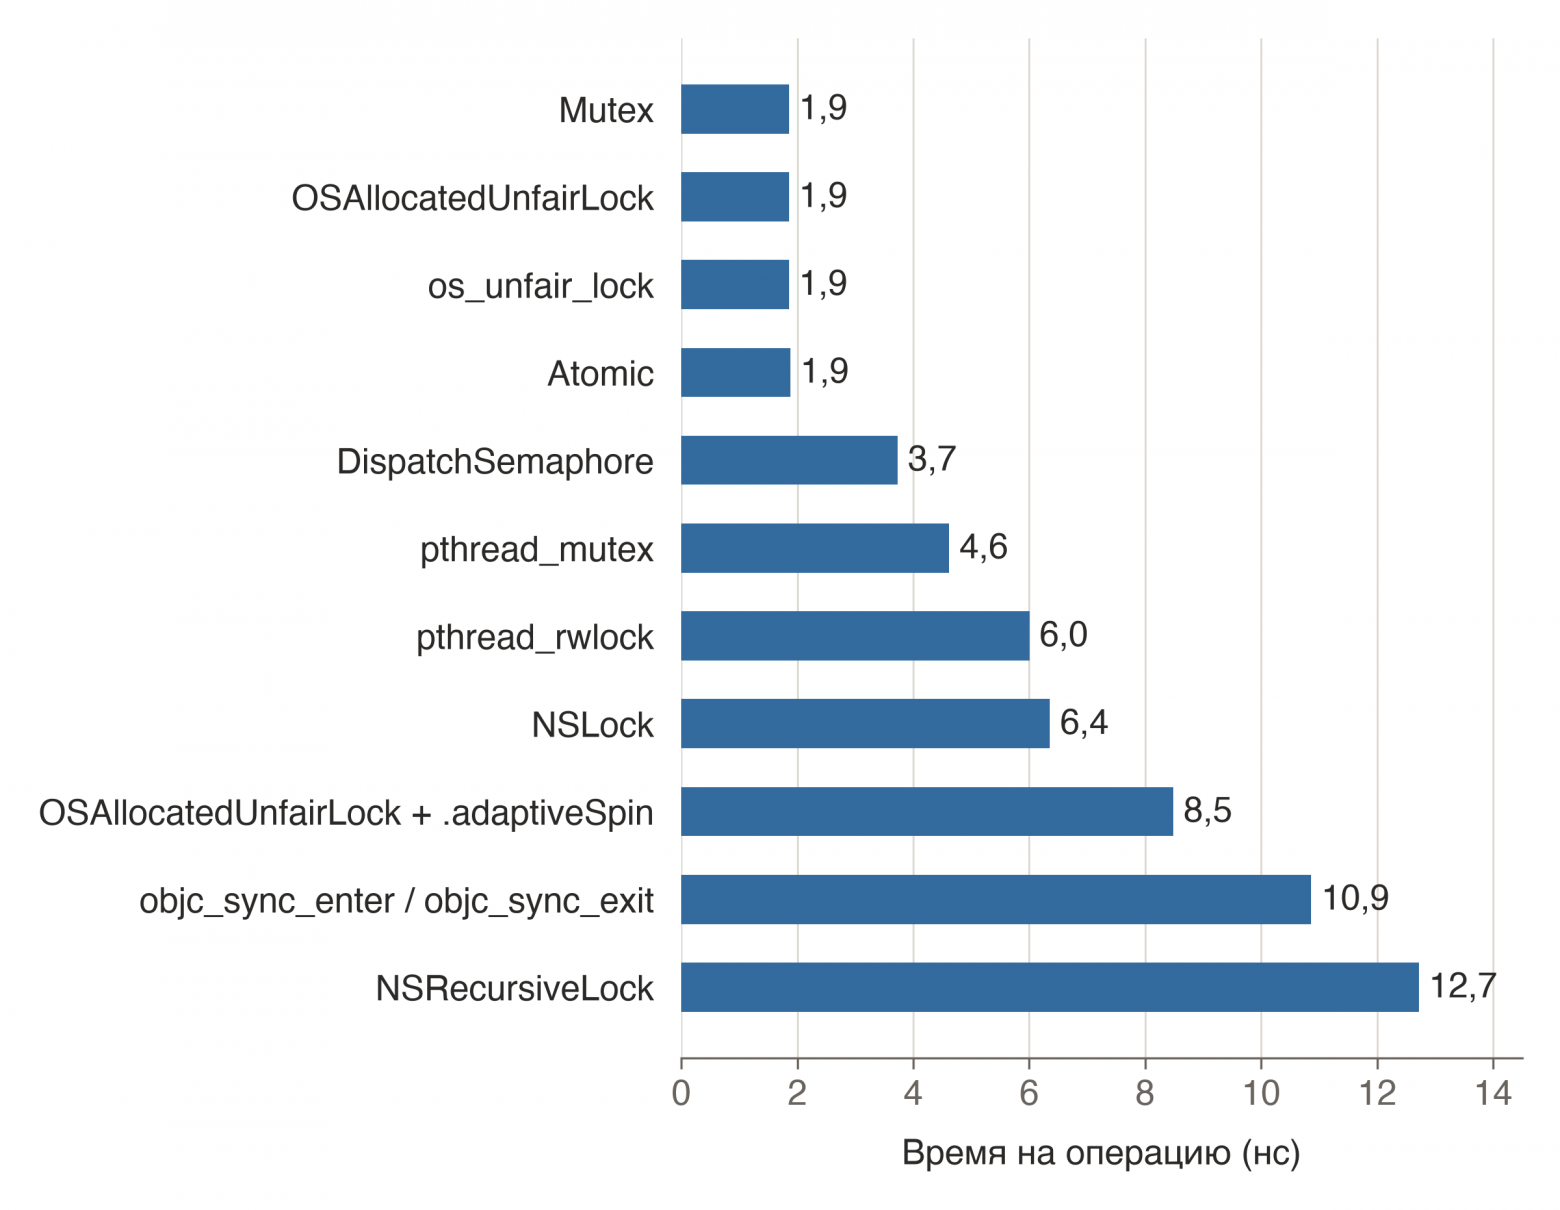
Сначала блокировки и Atomic. На графике показано время увеличения счетчика на единицу: чем короче столбец, тем быстрее.
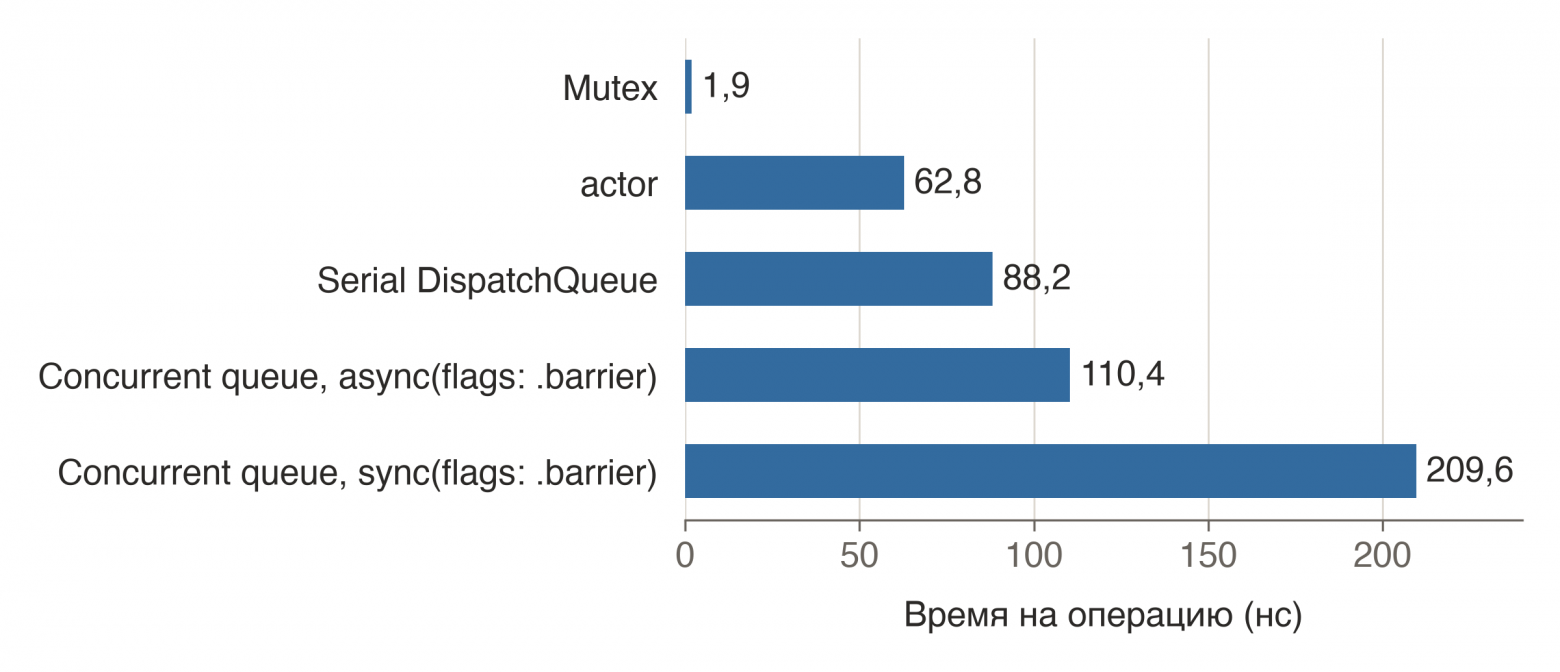
Actor и очереди на этот график не помещаются: их время больше в десятки раз. Поэтому они показаны отдельно, рядом с Mutex.
Task, iPhone 15 Pro Max, iOS 26.6.2, Release-сборка. Медиана по 20 запускам.Те же данные в таблице, вместе с чтением и записью:
Механизм | Чтение, нс | Запись, нс | Счетчик, нс | Счетчик относительно |
|---|---|---|---|---|
| 1,85 | 1,85 | 1,86 | 1,0× |
| 1,86 | 1,86 | 1,86 | 1,0× |
| 1,86 | 1,86 | 1,85 | 1,0× |
| 4,59 | 4,60 | 4,62 | 2,5× |
| 6,36 | 6,36 | 6,36 | 3,4× |
| 8,48 | 8,22 | 8,49 | 4,6× |
| 0,27 | 0,27 | 1,88 | 1,0× |
actor | 62,64 | 62,03 | 62,77 | 34× |
Serial | 199,42 | 107,47 | 88,23 | 48× |
Все 20 вариантов
Механизм | Чтение, нс | Запись, нс | Счетчик, нс |
|---|---|---|---|
| 1,85 | 1,85 | 1,86 |
| 1,86 | 1,86 | 1,86 |
| 1,86 | 1,86 | 1,85 |
| 3,72 | 3,72 | 3,74 |
| 4,59 | 4,60 | 4,62 |
| 6,14 | 6,07 | 6,00 |
| 6,36 | 6,36 | 6,36 |
| 8,48 | 8,22 | 8,49 |
| 10,88 | 10,87 | 10,87 |
| 12,72 | 12,72 | 12,72 |
| 0,265 | 0,265 | 1,88 |
| 0,265 | 0,265 | 1,88 |
| 0,795 | 0,795 | 1,86 |
| 0,795 | 0,795 | 1,88 |
actor | 62,64 | 62,03 | 62,77 |
| 5 770 | 5 769 | 5 731 |
Serial | 199,42 | 107,47 | 88,23 |
Concurrent queue, запись через | 204,76 | 210,56 | 209,61 |
Concurrent queue, запись через | 204,94 | 115,66 | 110,42 |
Без синхронизации | 0,265 | 0,265 | 0,83 |
Строка «Без синхронизации» показывает, сколько занимает сам цикл с обращением к памяти. Она измерялась только на одном потоке и не защищает состояние. Для записи через async(flags: .barrier) в измеренное время входит ожидание, пока очередь выполнит все отправленные операции. К @MainActor я вернусь в разделе про actors.
Mutex, OSAllocatedUnfairLock и os_unfair_lock показали одинаковый результат. У всех трех около 1,86 нс на операцию, различия начинаются в третьем знаке после запятой. Это ожидаемо: на платформах Apple Mutex и OSAllocatedUnfairLock построены на том же os_unfair_lock. Получается, что ради скорости не нужно использовать os_unfair_lock с ручными вызовами lock() и unlock(). Mutex работает так же быстро.
pthread_mutex и NSLock медленнее, но счет идет на наносекунды. У pthread_mutex 4,6 нс на операцию, у NSLock 6,4 нс. Это в 2,5 и в 3,4 раза больше, чем у Mutex. При этом в абсолютных числах NSLock добавляет около 4,5 нс на операцию. Если приложение захватывает блокировку 10 000 раз в секунду, вся разница составит 45 мкс за эту секунду. Поэтому из отношения 3,4× не следует, что после замены NSLock на Mutex приложение станет работать быстрее.
Atomic быстрее всех на чтении и записи, а на счетчике равен Mutex. Чтение и запись занимают 0,27 нс, это в семь раз быстрее Mutex. Увеличение счетчика занимает 1,88 нс, столько же, сколько под блокировкой. Увеличение выполняется одной атомарной операцией, и она обходится дороже отдельного чтения или записи.
Actor и очереди дороже в десятки раз. Обращение к actor занимает около 63 нс для любой из трех операций. Это в 34 раза дольше, чем увеличение счетчика под Mutex. У serial queue от 88 до 199 нс в зависимости от операции. Операция здесь крошечная, поэтому эти числа показывают в основном цену самого обращения к actor или очереди.
У Марина Тодорова actor оказался медленнее serial queue, у меня наоборот. Главная причина, на мой взгляд, в том, откуда вызывается actor. В его тесте задача Task создается в обработчике кнопки SwiftUI и наследует изоляцию MainActor. Поэтому при каждом обращении выполнение переходит с главного потока на actor и возвращается обратно. В моем тесте к actor обращается фоновая задача, без участия главного потока. Сколько стоит обращение к actor с MainActor, я покажу в разделе про actors.
Есть и результат, который я объяснить не могу. Чтение через serial queue заняло 199 нс, а увеличение счетчика 88 нс, хотя оба выполняются через queue.sync.
Два потока на одном счетчике
Теперь два потока одновременно увеличивают один и тот же счетчик. Здесь я сравниваю число операций в секунду для всех потоков вместе.
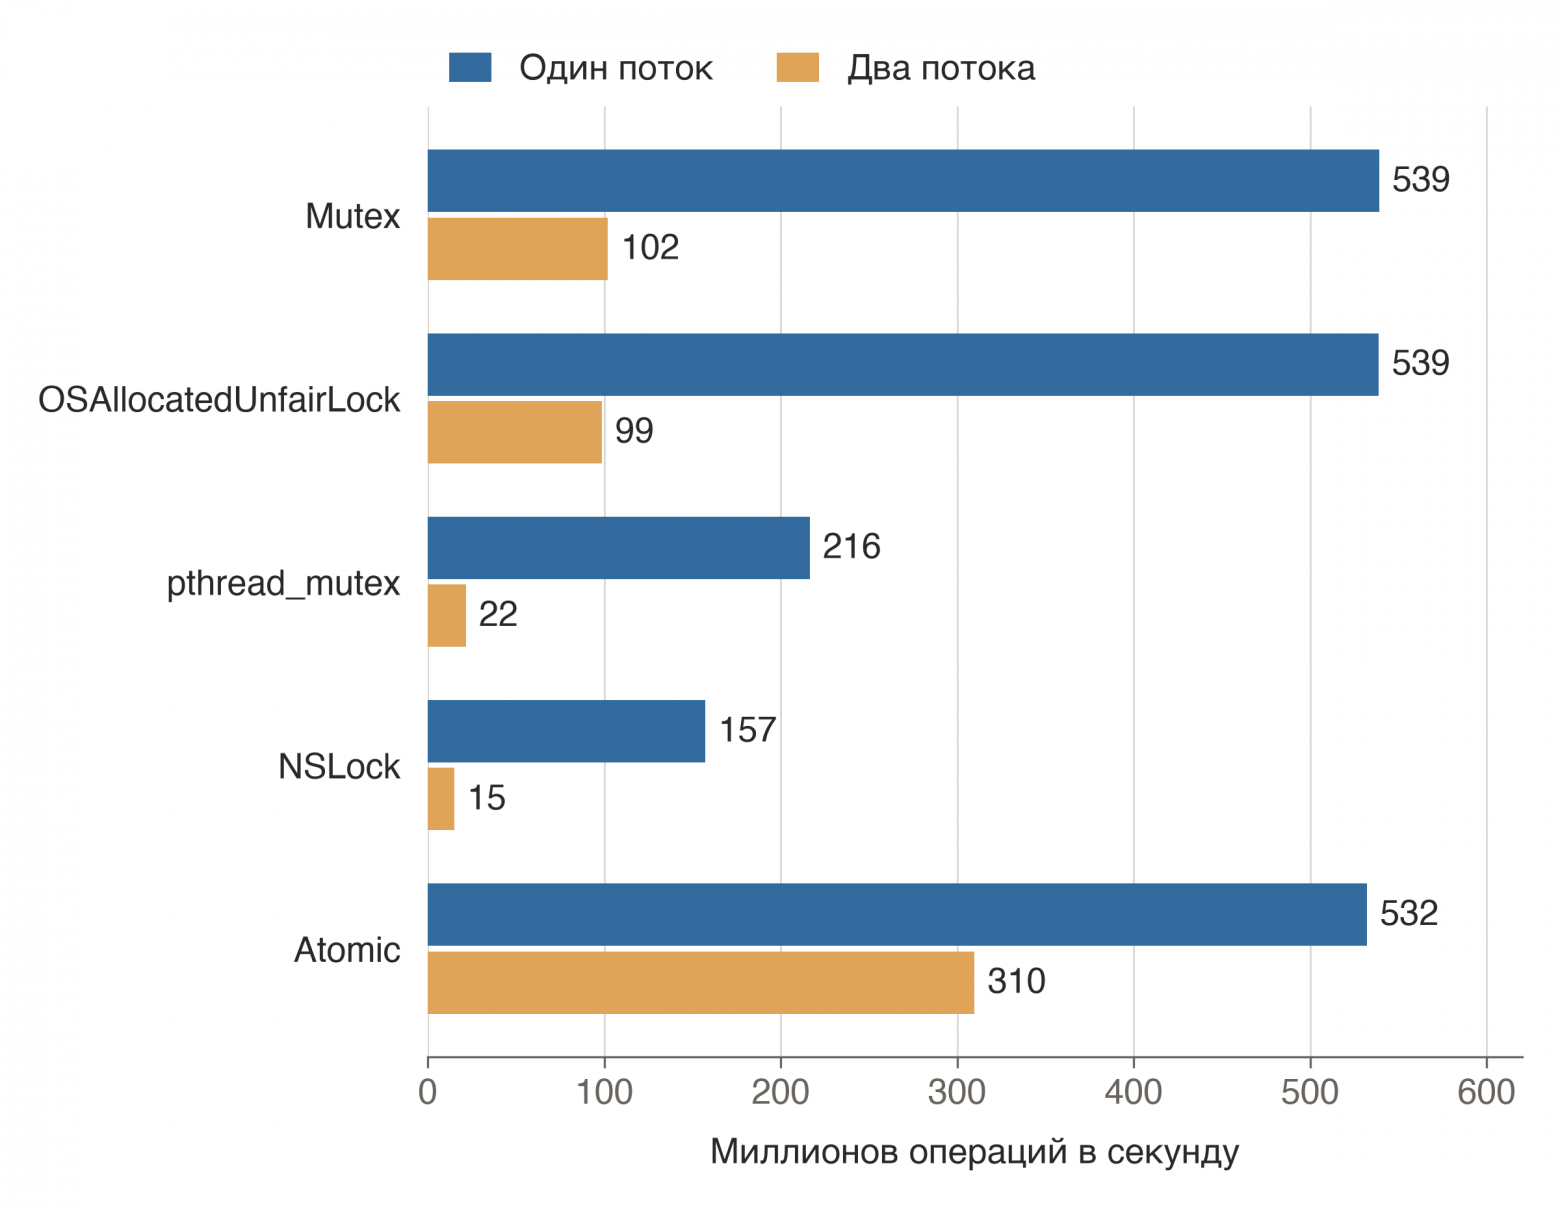
Механизм | Один поток, млн операций/с | Два потока, млн операций/с |
|---|---|---|
| 539 | 102 |
| 539 | 99 |
| 216 | 22 |
| 157 | 15 |
| 532 | 310 |
Производительность падает у всех механизмов: у Mutex примерно в пять раз, у Atomic в 1,7 раза. При двух потоках Atomic выполняет втрое больше операций в секунду, чем Mutex, хотя на одном потоке они были равны.
В бенчмарке есть также варианты с шестью и двенадцатью потоками, они описаны в репозитории.
iPhone 11 Pro Max
На старом телефоне общая картина та же. Mutex, OSAllocatedUnfairLock и os_unfair_lock снова не отличаются друг от друга и занимают около 9,5 нс. Actor занимает около 65 нс, serial queue на счетчике 199 нс.
Отличий три:
NSLockиpthread_mutexпочти не отстают отMutex: 10,6 и 10,3 нс против 9,5 нс.Для
Atomicпорядок доступа к памяти здесь важен. Увеличение счетчика с acquiring/releasing занимает 8,3 нс, а с relaxed 2,3 нс.При двух потоках порядок механизмов меняется на обратный.
NSLockиpthread_mutexвыполняют 52 и 55 млн операций в секунду, аMutex21 млн. На iPhone 15 Pro Max было наоборот: 102 млн уMutexпротив 15 и 22 млн.
Вывод
Для короткой синхронной операции над общим состоянием можно начинать с Mutex. Он так же быстр, как os_unfair_lock, и не требует ручных вызовов lock() и unlock().
Atomic стоит рассмотреть, когда достаточно одной атомарной операции: чтение, замена значения, увеличение счетчика. В таком случае он не медленнее Mutex без конкуренции и заметно быстрее, когда за счетчик конкурируют два потока.
Обращаться к actor или к очереди ради каждой крошечной операции дорого: такое обращение занимает в десятки раз больше времени, чем захват блокировки.
Но в приложениях под блокировкой обычно лежит не одно число. В следующем разделе несколько потоков работают с общим словарем.
Синхронизация доступа к словарю
Теперь под блокировкой лежит словарь, в котором по идентификатору хранится объект запроса. Когда появляется новый запрос, его нужно добавить в словарь, а после завершения удалить. Иногда нужно отменить все оставшиеся запросы сразу.
Такая задача встречается в библиотеках для работы с сетью и изображениями. При подготовке эксперимента я опирался на runningOperations в SDWebImage и RequestTaskMap в Alamofire. Здесь я проверяю собственную реализацию похожей задачи, настоящие сетевые запросы в бенчмарке не выполняются.
В тесте со словарем одновременно работают несколько потоков. Каждый поток по очереди удаляет старый запрос и добавляет новый, а между обращениями выполняет небольшую работу вне блокировки. Один из потоков после каждых 1024 своих обращений отменяет все запросы и очищает словарь.
Я проверял два режима:
с паузами: после каждого обращения поток засыпает на 50 мкс;
без пауз: потоки обращаются к словарю непрерывно.
В каждом режиме работают четыре или восемь потоков. Восьми потокам уже не хватает шести ядер телефона.
Показателей здесь два. Время вызова показывает, сколько длится один add или remove вместе с ожиданием блокировки, для него я привожу p50 и p99. Число операций в секунду считается по всем потокам вместе и включает работу вне блокировки и паузы.
Измеряемые операции
Вот как словарь защищен с помощью Mutex:
final class MutexRegistry {
    private let downloads = Mutex<[Int: Download]>([:])

    func add(_ download: Download, id: Int) {
        downloads.withLock { downloads in
            downloads[id] = download
        }
    }

    func remove(id: Int) -> Download? {
        downloads.withLock { downloads in
            downloads.removeValue(forKey: id)
        }
    }

    func cancelAll() -> Int {
        downloads.withLock { downloads in
            let count = downloads.count
            for download in downloads.values {
                download.cancel()
            }
            downloads.removeAll(keepingCapacity: true)
            return count
        }
    }
}
В сравнении десять механизмов: блокировки из прошлого раздела и serial queue. Один вариант стоит пояснить отдельно. OSAllocatedUnfairLock можно захватывать с флагом .adaptiveSpin, он доступен с iOS 18:
downloads.withLock(flags: .adaptiveSpin) { downloads in
    downloads[id] = download
}
С этим флагом поток, которому блокировка не досталась, не засыпает сразу. Сначала он короткое время ждет в активном цикле, пока владелец блокировки выполняется на другом ядре. В прошлом разделе этот вариант был в 4,6 раза медленнее обычного. Здесь результат другой.
Код всех вариантов есть в репозитории.
С паузами между обращениями
Когда потоки делают паузы, выбор механизма почти не влияет на общую производительность. При четырех потоках все десять вариантов выполняют от 57,3 до 57,8 тысячи операций в секунду, разница между ними меньше 1%. При восьми потоках картина та же: от 110,1 до 110,8 тысячи.
Время отдельного вызова при этом различается. У Mutex p99 при четырех потоках равен 0,125 мкс, у serial queue 3,75 мкс, то есть в 30 раз больше. Но потоки почти все время заняты паузами и работой вне блокировки, поэтому на общий результат эта разница не влияет.
Без пауз
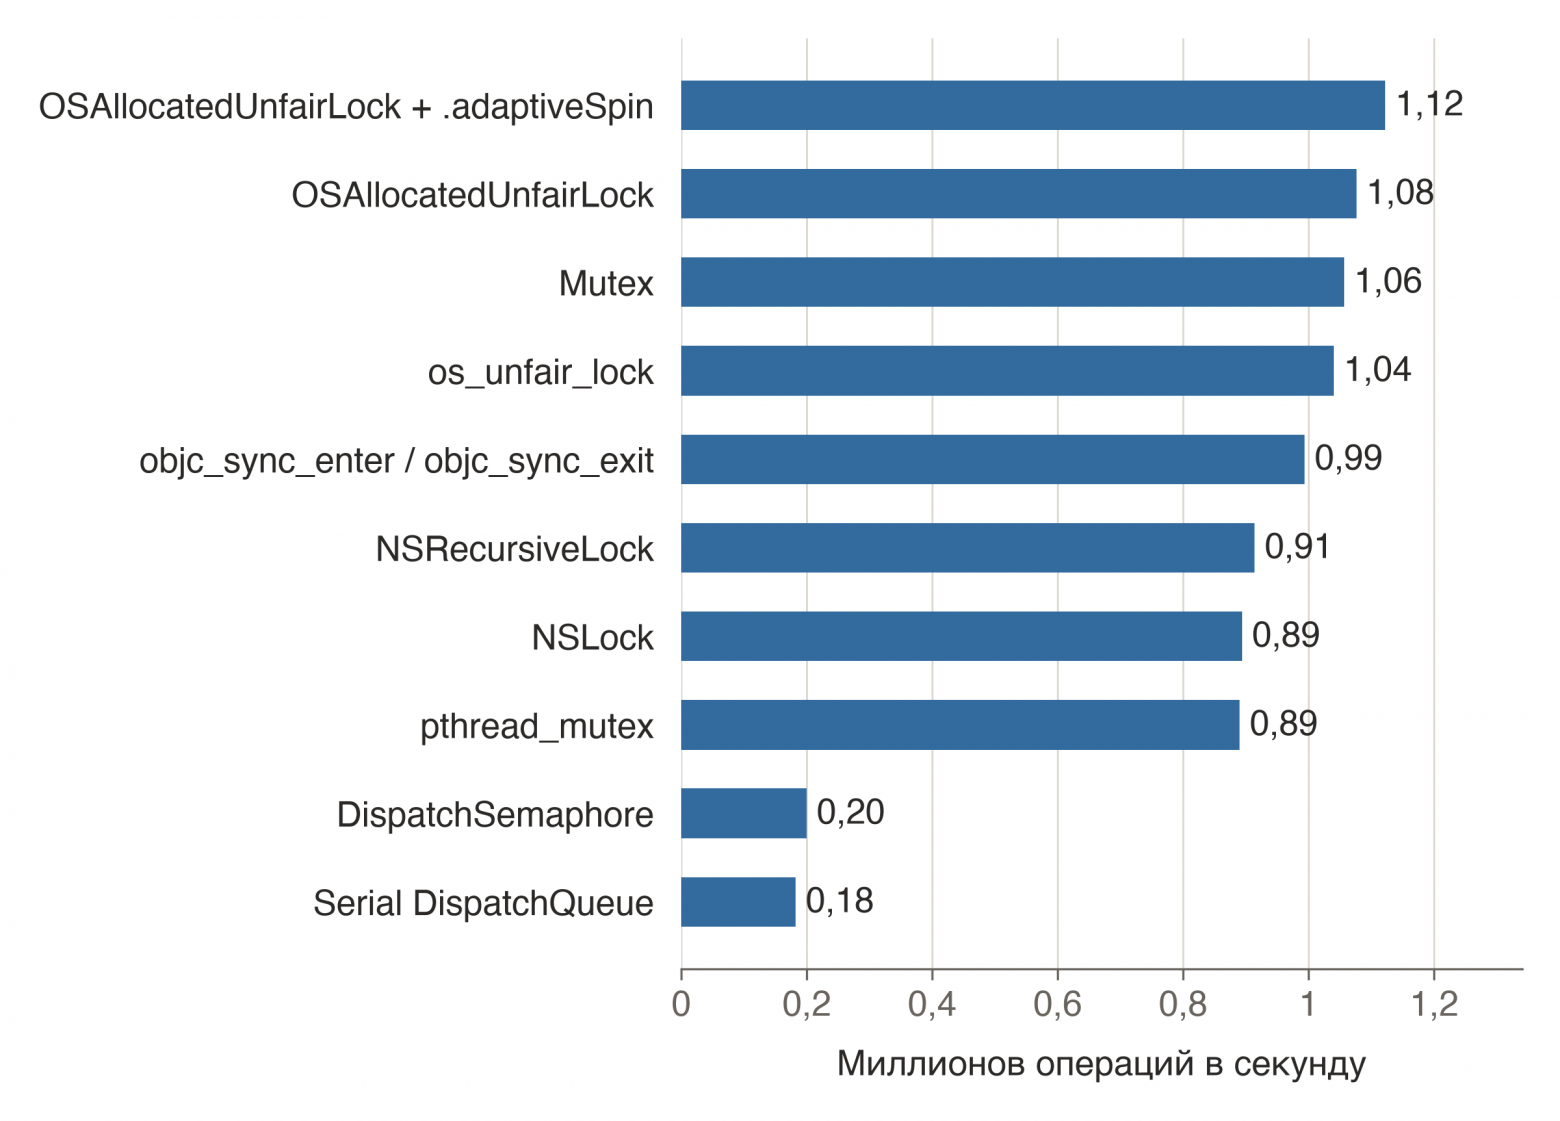
Без пауз потоки постоянно конкурируют за блокировку, и разница между механизмами становится заметной. Дальше результаты для восьми потоков. Сначала число операций в секунду: чем длиннее столбец, тем быстрее.
Число операций в секунду не показывает, как часто отдельный вызов надолго застревает в ожидании. Это видно по p99 времени вызова, и здесь уже чем короче столбец, тем лучше.
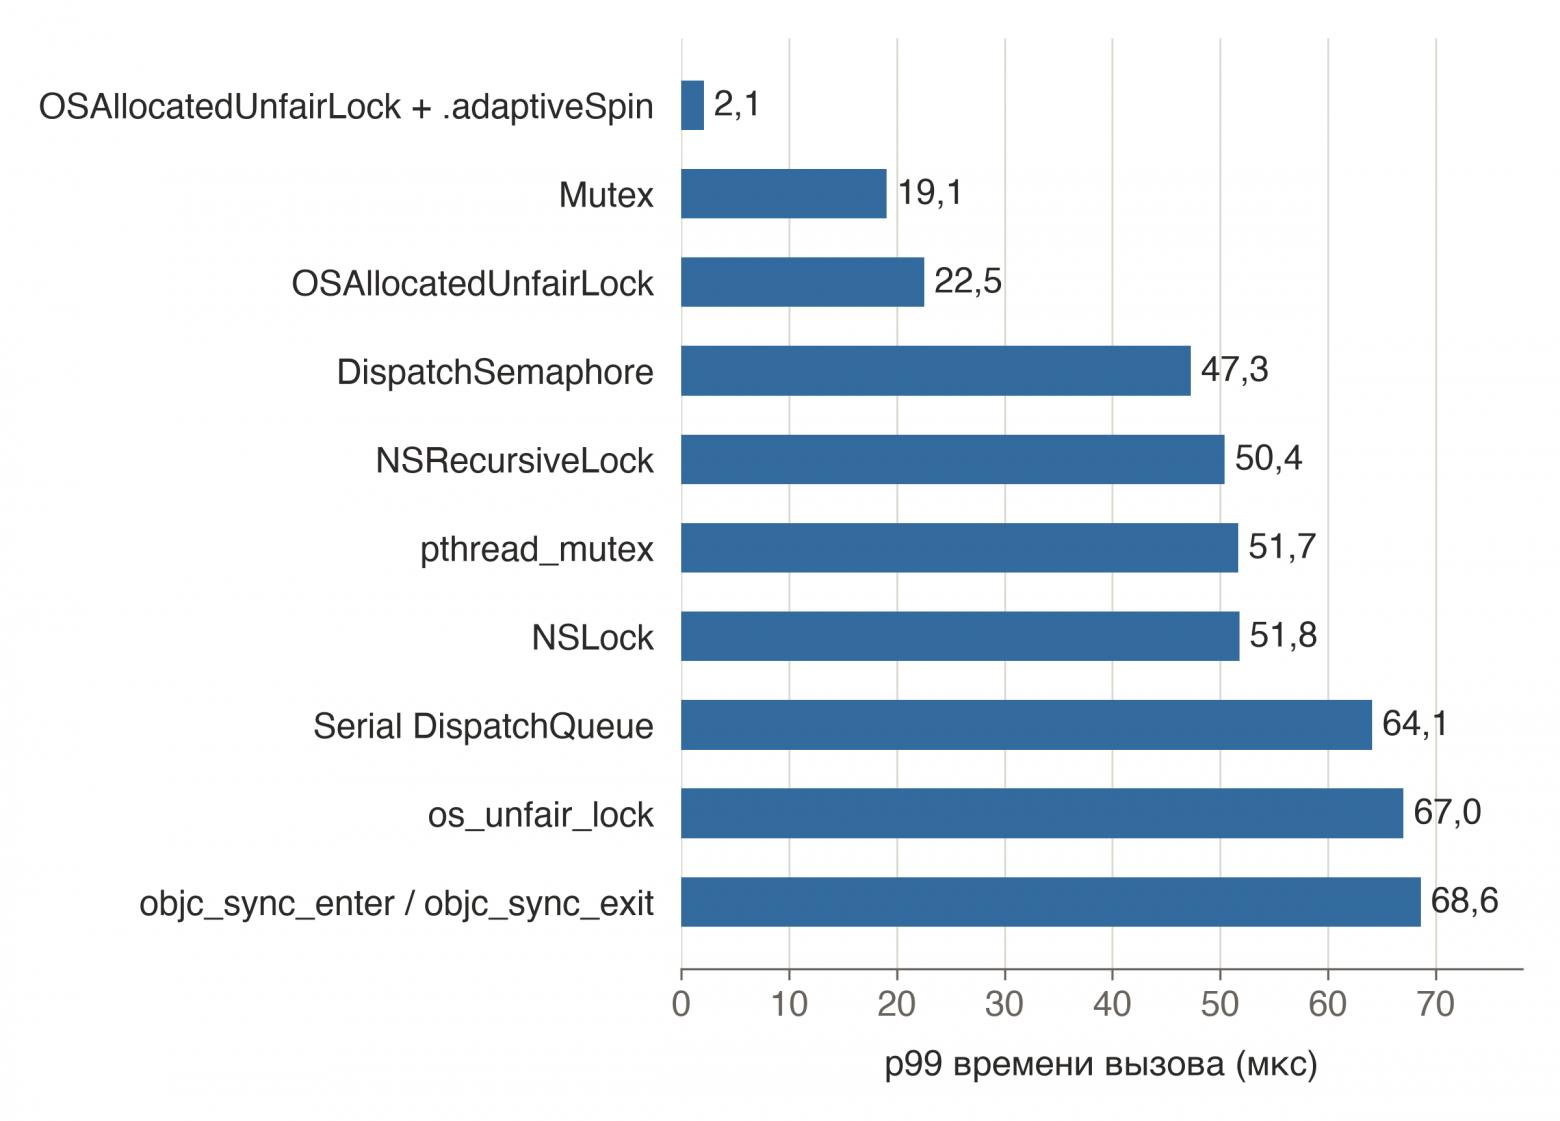
Те же данные в таблице, вместе с медианой времени вызова:
Механизм | p50 вызова, мкс | p99 вызова, мкс | Млн операций/с |
|---|---|---|---|
| 0,42 | 2,08 | 1,12 |
| 0,29 | 22,54 | 1,08 |
| 0,29 | 19,06 | 1,06 |
| 0,38 | 67,02 | 1,04 |
| 0,50 | 68,61 | 0,99 |
| 0,33 | 50,43 | 0,91 |
| 0,33 | 51,79 | 0,89 |
| 0,38 | 51,69 | 0,89 |
| 38,46 | 47,27 | 0,20 |
Serial | 40,06 | 64,10 | 0,18 |
Serial queue и DispatchSemaphore отстают в пять-шесть раз. Они выполняют 0,18 и 0,20 млн операций в секунду против 1,06 млн у Mutex. Обычный вызов через очередь длится 40 мкс, а под Mutex 0,29 мкс.
NSLock и pthread_mutex уступают Mutex примерно на 15%. У обоих 0,89 млн операций в секунду, а p99 равен 52 мкс против 19 мкс у Mutex.
os_unfair_lock снова не дал выигрыша. Операций в секунду у него почти столько же, сколько у Mutex, а p99 в три с половиной раза больше: 67 против 19 мкс.
Флаг .adaptiveSpin сокращает редкие долгие вызовы. По сравнению с Mutex p99 упал с 19 до 2 мкс. Число операций в секунду выросло примерно на 6%. При этом обычный вызов стал дольше: p50 вырос с 0,29 до 0,42 мкс. При четырех потоках результат похожий: p99 снизился с 6 до 1,6 мкс.
Общая отмена при восьми потоках обычно занимает 25 мкс с Mutex, 14 мкс с .adaptiveSpin и 42 мкс с serial queue.
iPhone 11 Pro Max
На старом телефоне картина та же. С паузами все механизмы выполняют от 55,5 до 56,5 тысячи операций в секунду при четырех потоках. Без пауз при восьми потоках serial queue отстает от Mutex в пять раз: 0,14 против 0,74 млн операций в секунду. Флаг .adaptiveSpin снижает p99 с 48 до 2,9 мкс и добавляет около 5% к числу операций.
Вывод
Mutex остается хорошим выбором и для словаря. Среди обычных блокировок он был в числе лучших и по числу операций в секунду, и по p99.
Если между обращениями к словарю потоки заняты другой работой, механизм синхронизации почти не влияет на общий результат.
Если обращения идут непрерывно, serial queue и DispatchSemaphore заметно проигрывают блокировкам. А флаг .adaptiveSpin, который проиграл на простом счетчике, здесь сократил редкие долгие вызовы в девять раз. Его стоит проверить, когда важно время самых медленных вызовов.
В следующем разделе состояние снова простое: один флаг, который часто читают и редко меняют.
Сколько стоит прочитать feature flag
Представим feature flag, от которого зависит, какую ветку кода выполнить. Приложение часто проверяет его значение, а обновляется оно гораздо реже. Если чтение и запись происходят в разных потоках, доступ к флагу нужно синхронизировать.
Похожие флаги есть почти в любом приложении. Из интересного: в Pocket Casts раньше каждый такой флаг создавал собственную serial queue и вызывал sync при каждом чтении, потом очередь заменили блокировкой. В SDWebImage флаг isCancelled защищен через @synchronized.
В тесте фоновый поток непрерывно читает флаг, а главный поток переключает его примерно раз в 10 мс. Я сравниваю время одного чтения.
Измеряемые операции
Чтение флага под Mutex:
let isFeatureEnabled = Mutex<Bool>(false)

let enabled = isFeatureEnabled.withLock { value in
    value
}
То же чтение через Atomic:
let isFeatureEnabled = Atomic<Bool>(false)

let enabled = isFeatureEnabled.load(ordering: .acquiring)
В сравнении 17 вариантов, их код есть в репозитории.
Результаты
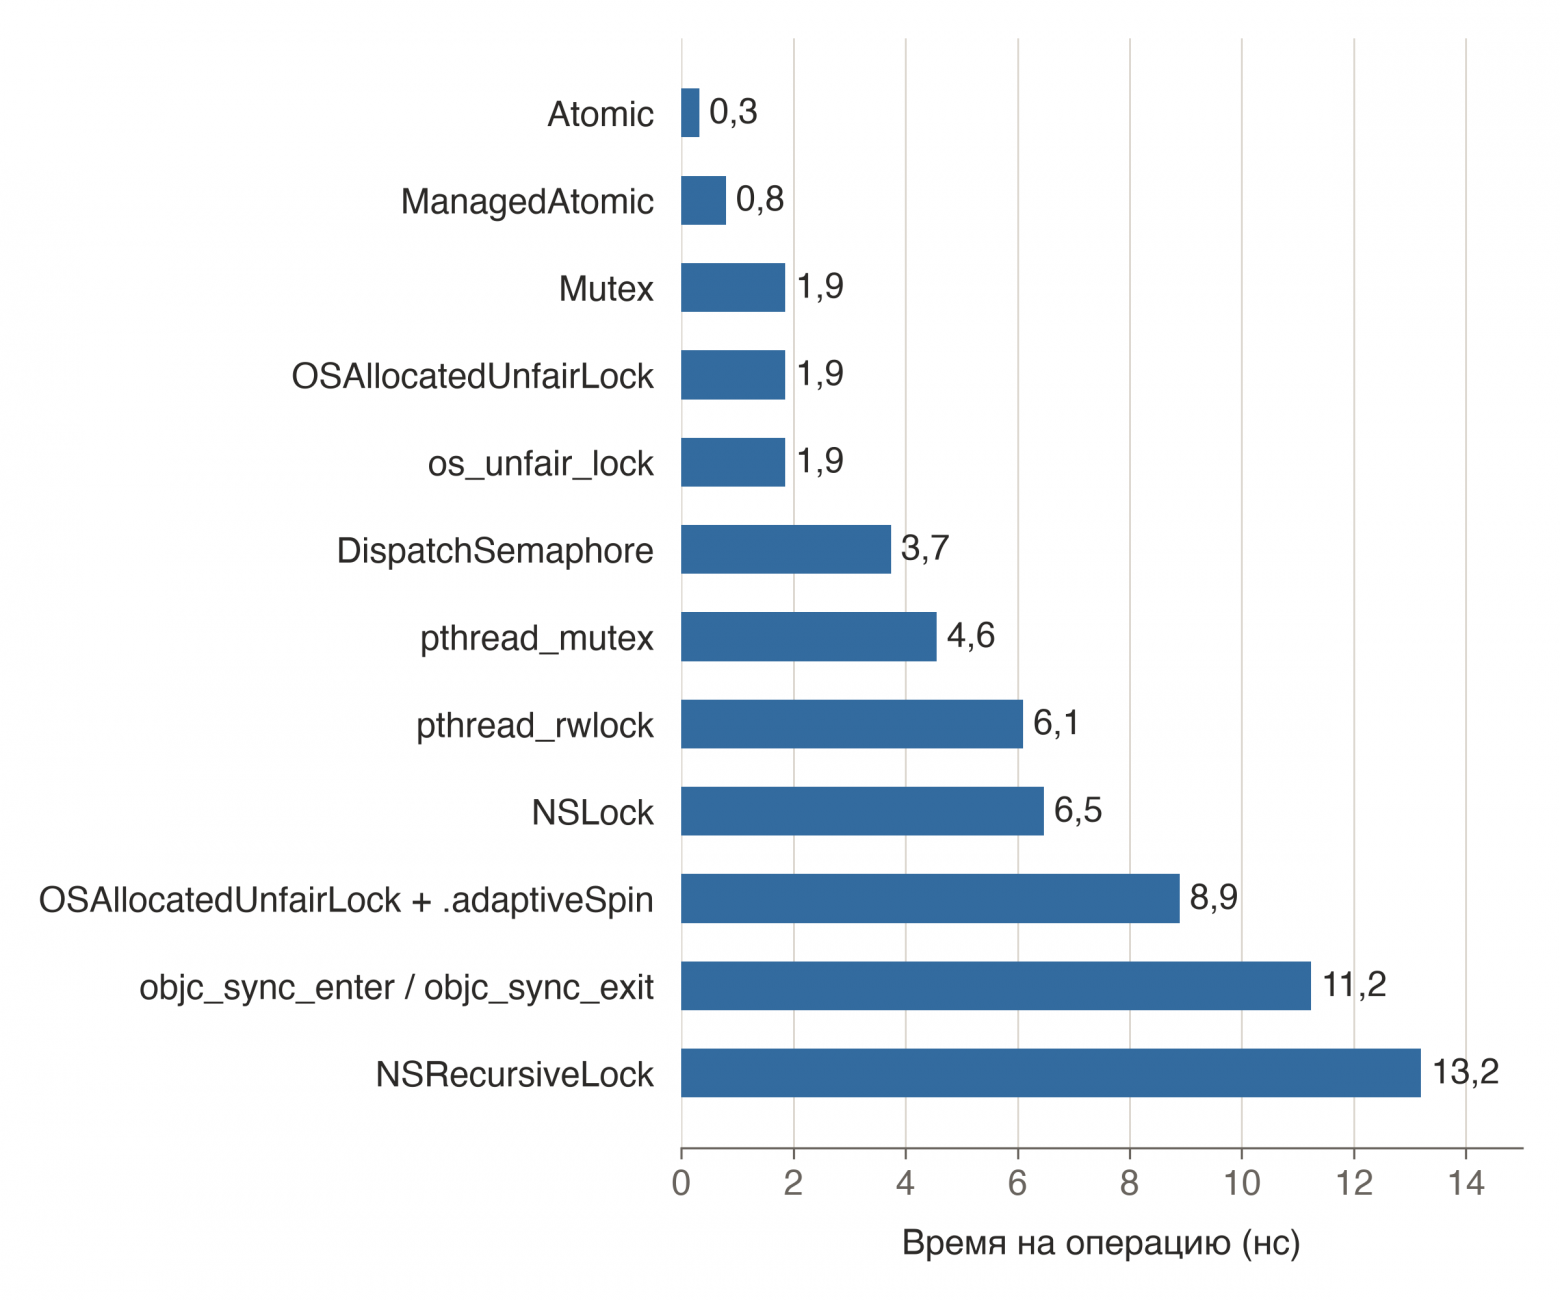
Сначала Atomic и блокировки. На графике показано время одного чтения: чем короче столбец, тем быстрее.
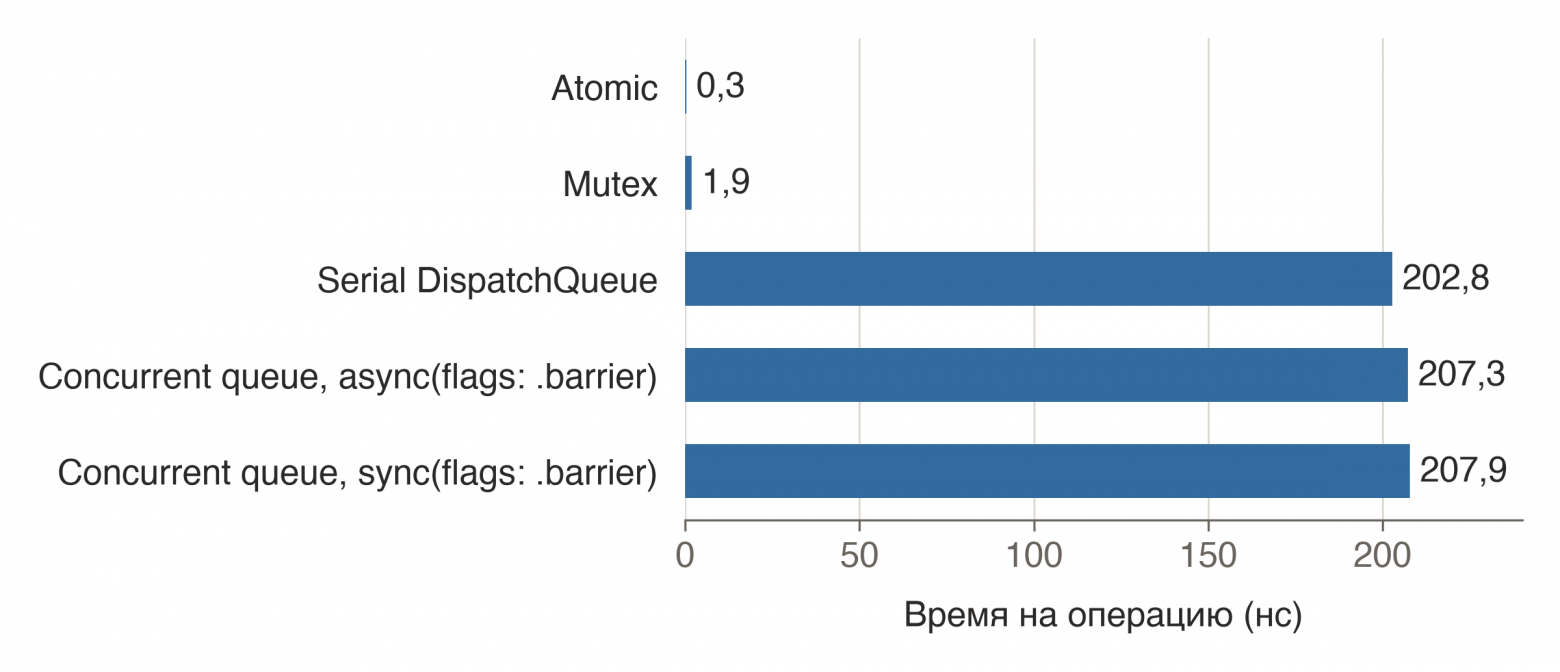
Очереди снова показаны отдельно, рядом с Atomic и Mutex.
Те же данные в таблице:
Механизм | Чтение, нс | Относительно |
|---|---|---|
| 0,32 | 0,2× |
| 0,80 | 0,4× |
| 1,86 | 1,0× |
| 1,86 | 1,0× |
| 1,86 | 1,0× |
| 3,74 | 2,0× |
| 4,56 | 2,5× |
| 6,10 | 3,3× |
| 6,47 | 3,5× |
| 8,89 | 4,8× |
| 11,24 | 6,0× |
| 13,20 | 7,1× |
Serial | 202,78 | 109× |
Concurrent queue, запись через | 207,31 | 111× |
Concurrent queue, запись через | 207,85 | 112× |
Atomic читает флаг быстрее всех. Одно чтение занимает 0,32 нс, это почти в шесть раз быстрее Mutex. В первом эксперименте значение во время чтения никто не менял. Здесь его меняет другой поток, и преимущество Atomic сохранилось. ManagedAtomic из пакета swift-atomics, который работает и до iOS 18, тоже быстрее блокировок: 0,80 нс.
Mutex, OSAllocatedUnfairLock и os_unfair_lock равны. У всех трех 1,86 нс на чтение, у NSLock 6,5 нс.
pthread_rwlock не дал выигрыша. Чтение с ним занимает 6,1 нс, в три раза дольше, чем под Mutex. Читающий поток здесь один, и выполнять чтения параллельно некому.
Чтение через очередь в сто раз дольше, чем под Mutex. С serial queue оно занимает 203 нс, с concurrent queue около 207 нс.
Чтобы оценить масштаб, эти числа можно умножить на частоту чтений. Если читать флаг 10 000 раз в секунду, на все чтения за эту секунду уйдет 3 мкс с Atomic, 19 мкс с Mutex и 2 мс с serial queue.
iPhone 11 Pro Max
На старом телефоне картина та же: Atomic 0,61 нс, Mutex 9,1 нс, serial queue 407 нс. Для Atomic на этом телефоне важен порядок доступа к памяти. Чтение с relaxed занимает 0,46 нс, на четверть меньше, чем с acquiring. На iPhone 15 Pro Max оба варианта дали одинаковый результат.
Вывод
Если флаг часто читают, быстрее всего это делать через Atomic.
Mutex при этом остается хорошим выбором: разница с Atomic составляет 1,5 нс на чтение.
Создавать очередь ради чтения флага дорого. Чтение через нее в сто раз дольше, чем под Mutex, и именно от такой схемы отказались в Pocket Casts.
Дальше читающих потоков становится несколько.
Много чтений, мало записей: нужен ли read-write lock?
Когда данные в основном читают, обычная блокировка кажется лишним ограничением: пока один поток читает, остальные ждут, хотя ничего не меняется. Отсюда и привычное решение: read-write lock или concurrent queue с barrier. С ними читать могут сразу несколько потоков, а запись выполняется одна.
Так делают и в известных библиотеках. В Apollo iOS 1.x кеш читают через concurrent queue, а записывают через async(flags: .barrier). В swift-log настройки LoggingSystem читают под pthread_rwlock.
В разделе про feature flag читающий поток был один, и читать параллельно было некому. Теперь потоков шесть. Они работают с массивом из 10 000 записей: 98% операций читают данные, 2% меняют. Проверим, хватит ли такого соотношения, чтобы read-write lock обогнал Mutex.
Измеряемые операции
Я проверял два варианта. В первом каждая операция читает или меняет одну запись. Во втором она работает сразу с группой из двадцати записей. Так чтение длится дольше, и потоки чаще читают одновременно. Если read-write lock и может где-то обогнать Mutex, то здесь.
Показателей два: число операций в секунду по всем потокам вместе и p99 времени записи.
Чтение группы под Mutex:
let records = Mutex<[Record]>(initialRecords)

let result = records.withLock { records in
    records.readGroup(group, size: groupSize)
}
Запись выглядит так же, только вместо readGroup вызывается writeGroup.
С pthread_rwlock чтение и запись захватывают блокировку по-разному:
// Чтение: одновременно могут читать несколько потоков
pthread_rwlock_rdlock(lock)
let result = records.readGroup(group, size: groupSize)
pthread_rwlock_unlock(lock)

// Запись: поток работает с данными один
pthread_rwlock_wrlock(lock)
records.writeGroup(group, size: groupSize)
pthread_rwlock_unlock(lock)
С concurrent queue чтение идет через sync, а запись через sync с флагом .barrier:
let queue = DispatchQueue(label: "store", attributes: .concurrent)

let result = queue.sync {
    records.readGroup(group, size: groupSize)
}

queue.sync(flags: .barrier) {
    records.writeGroup(group, size: groupSize)
}
Есть и второй вариант с очередью, где запись отправляется через async(flags: .barrier). В нем запись считается выполненной, когда блок отработал, а не когда вызов вернулся.
В сравнении 13 вариантов, их код есть в репозитории.
Результаты
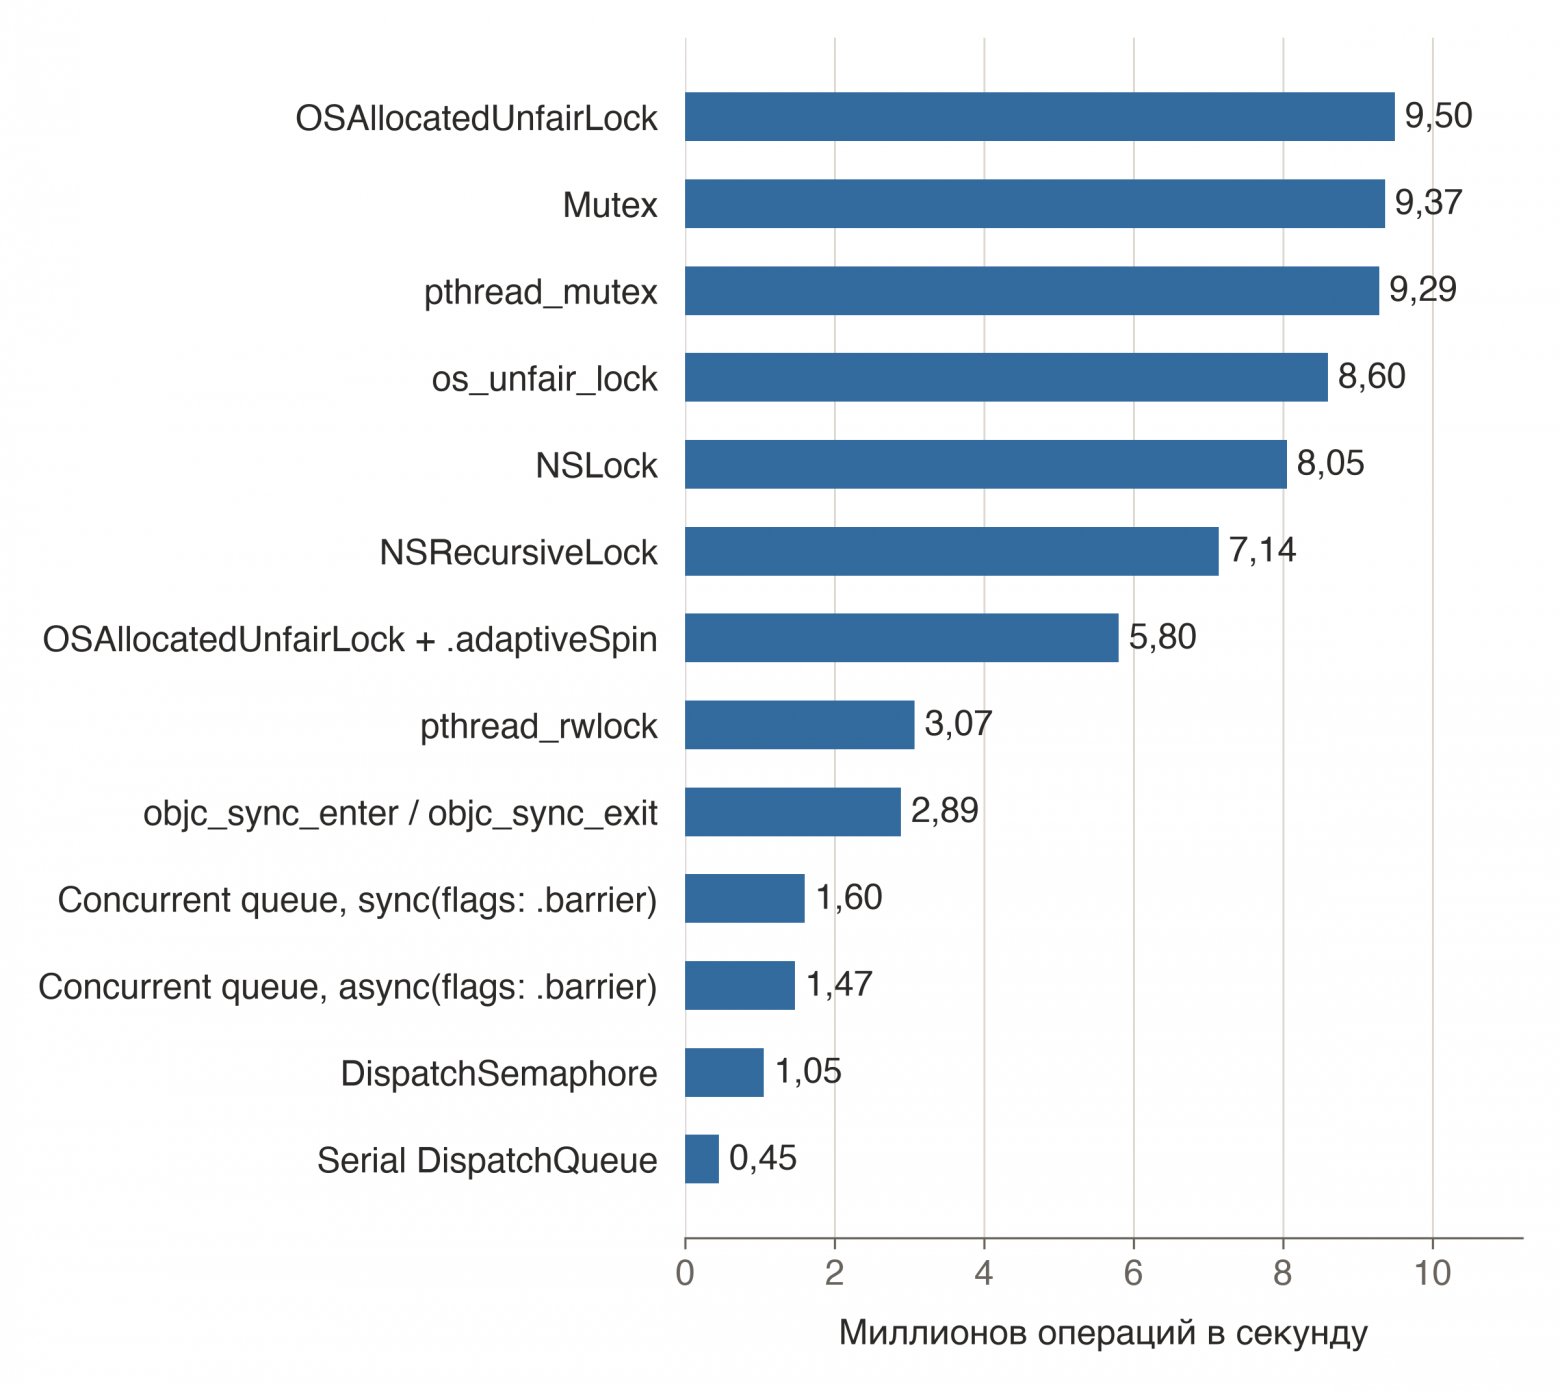
Сначала число операций в секунду для групп из двадцати записей: чем длиннее столбец, тем быстрее.
Записей всего 2%, но им тоже нужно получить доступ к данным. Сколько они ждут, показывает p99 времени записи. Оно отсчитывается от вызова до момента, когда данные изменены. Здесь чем короче столбец, тем лучше.
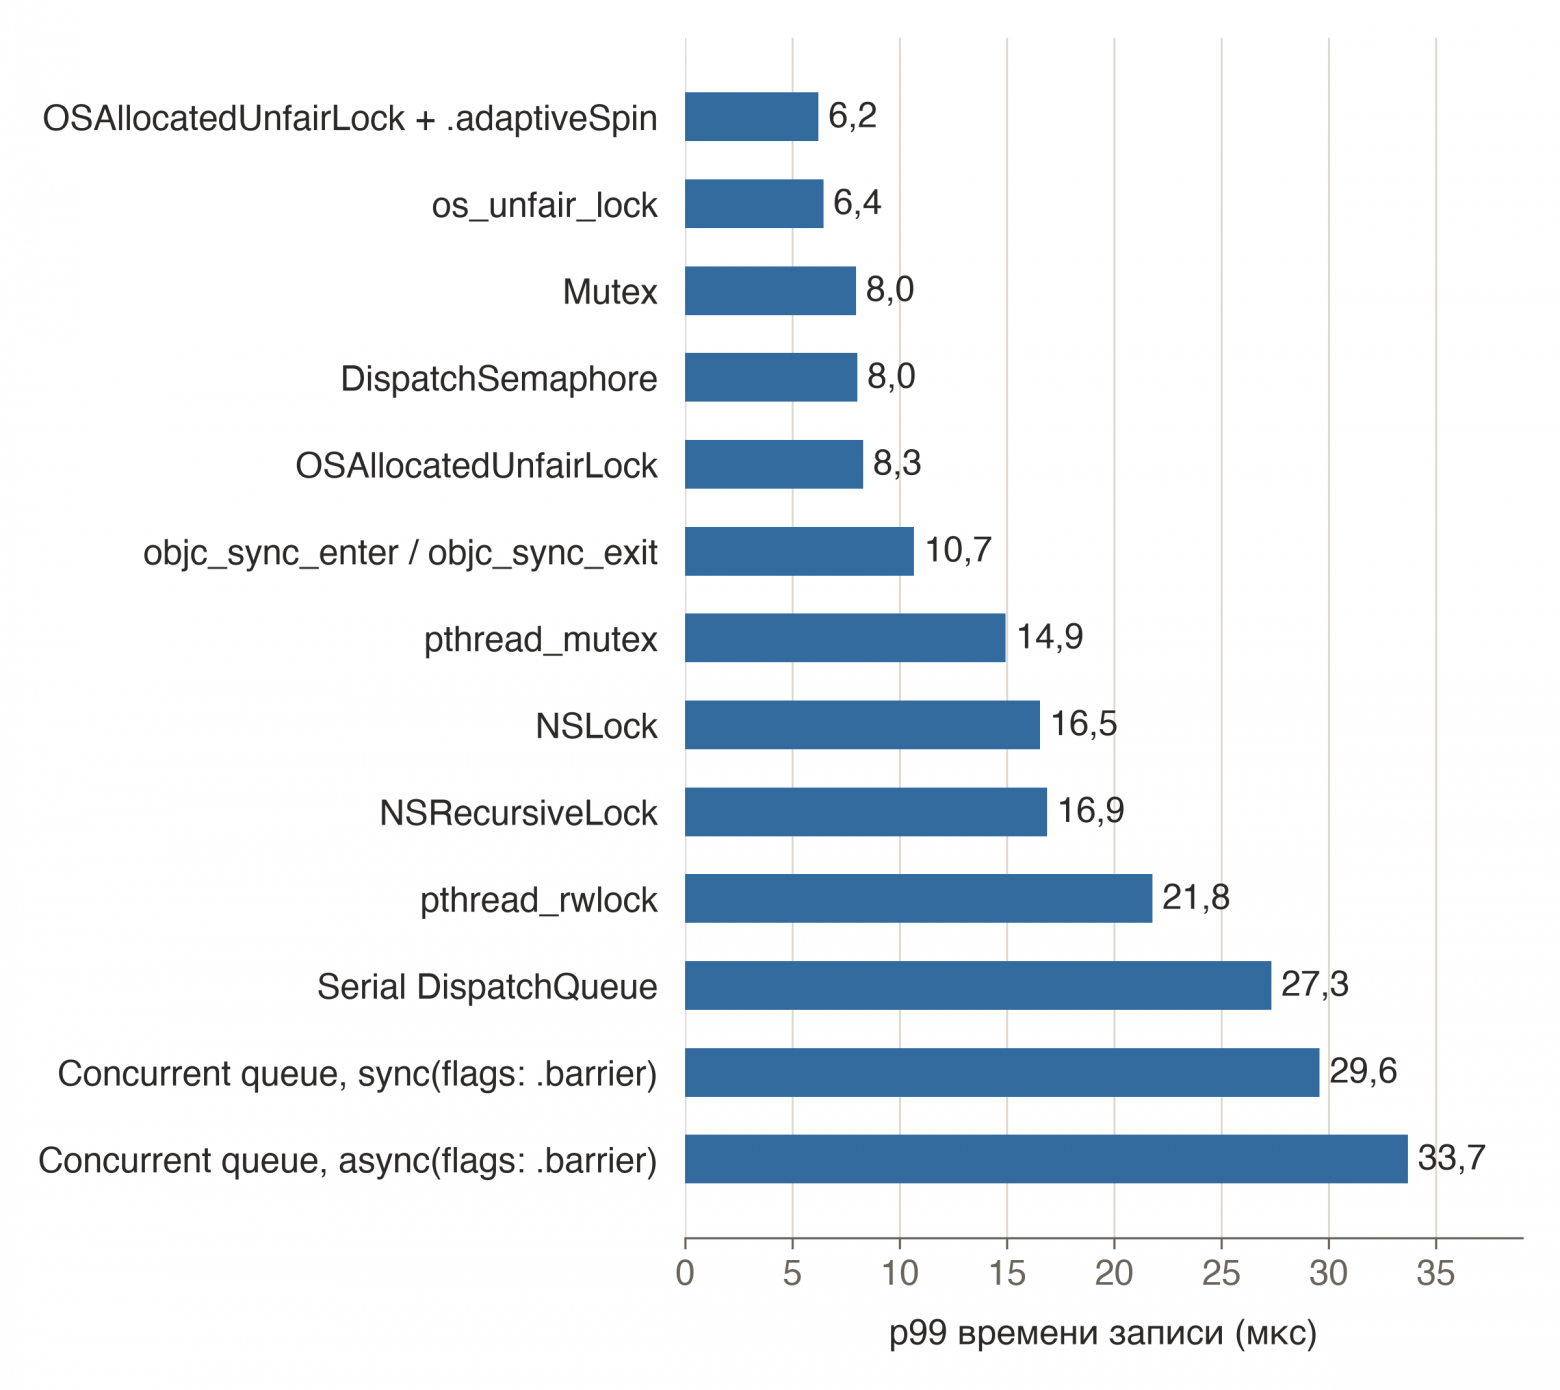
В таблице те же данные и число операций в секунду для одной записи:
Механизм | Одна запись, млн операций/с | Двадцать записей, млн операций/с | Двадцать записей, p99 записи, мкс |
|---|---|---|---|
| 34,67 | 9,50 | 8,29 |
| 34,81 | 9,37 | 7,96 |
| 35,10 | 9,29 | 14,94 |
| 33,35 | 8,60 | 6,44 |
| 22,48 | 8,05 | 16,52 |
| 14,62 | 7,14 | 16,85 |
| 10,40 | 5,80 | 6,21 |
| 3,88 | 3,07 | 21,77 |
| 3,12 | 2,89 | 10,67 |
Concurrent queue, запись через | 1,69 | 1,60 | 29,56 |
Concurrent queue, запись через | 2,09 | 1,47 | 33,69 |
| 1,10 | 1,05 | 8,02 |
Serial | 0,46 | 0,45 | 27,31 |
pthread_rwlock медленнее обычных блокировок. С группами из двадцати записей он выполняет 3,07 млн операций в секунду, в три раза меньше, чем Mutex с его 9,37 млн. С одной записью разрыв девятикратный: 3,88 против 34,81 млн. Читают 98% операций, но возможность читать параллельно не окупилась.
Скорее всего, дело в длине операций. pthread_rwlock сам по себе дороже: в разделе про флаг чтение под ним занимало 6,1 нс против 1,86 нс под Mutex. Чтение двадцати записей из памяти слишком короткое: выигрыш от параллельного чтения меньше этой разницы.
Concurrent queue с barrier еще медленнее. С группами из двадцати записей это 1,60 млн операций в секунду с sync(flags: .barrier) и 1,47 млн с async(flags: .barrier), примерно в шесть раз меньше, чем у Mutex. Замена sync на async устойчивого выигрыша не дает: с одной записью async быстрее (2,09 против 1,69 млн), с двадцатью медленнее.
Mutex, OSAllocatedUnfairLock и pthread_mutex идут вровень. С двадцатью записями у них от 9,29 до 9,50 млн операций в секунду, с одной от 34,67 до 35,10 млн. NSLock отстает: 8,05 и 22,48 млн.
Запись дольше всего ждет в очередях и под pthread_rwlock. У Mutex p99 записи равен 8,0 мкс, у pthread_rwlock 21,8 мкс, у concurrent queue 29,6 мкс с sync и 33,7 мкс с async. pthread_mutex по числу операций не уступает Mutex, но p99 записи у него почти вдвое больше: 14,9 мкс.
Флаг .adaptiveSpin здесь себя не оправдал. В разделе про словарь он сократил p99 в девять раз. Здесь p99 записи снизился с 8,3 до 6,2 мкс, зато число операций в секунду упало с 9,50 до 5,80 млн.
iPhone 11 Pro Max
На старом телефоне Mutex тоже быстрее pthread_rwlock и очередей, но разрыв меньше. С двадцатью записями pthread_rwlock выполняет 3,45 млн операций в секунду против 4,26 млн у Mutex, то есть отстает на 19%, а не в три раза. Concurrent queue с barrier здесь медленнее Mutex в три с лишним раза. С одной записью pthread_rwlock отстает почти в четыре раза: 3,99 против 15,59 млн.
Вывод
Большая доля чтений сама по себе не повод брать read-write lock или concurrent queue с barrier. На коротких операциях в памяти Mutex оказался быстрее обоих.
Операции в тесте короткие. Если чтение под блокировкой долгое, параллельное чтение может дать выигрыш, и это стоит измерить на своем коде.
Дальше перейдем к асинхронному коду и сравним actors с блокировками.
Действительно ли actors медленные?
«Акторы медленные, возьми блокировку». Первый эксперимент этот совет вроде бы подтверждает: обращение к actor там в 34 раза дороже захвата Mutex. Но я проверял только один способ обращения: одна фоновая задача вызывала actor в цикле.
В приложении к actor обращаются по-разному. С главного потока, из десятков задач сразу, по одной операции за await или по сотне.
И кода с actors становится больше: на них переходят целые библиотеки. В Nuke 13 внутреннюю serial queue заменили на global actor ImagePipelineActor. В Apollo iOS 2.0 кеш защищает асинхронный read-write lock, который сам написан как actor.
Начну с вопроса, который остался с первого эксперимента. У Марина Тодорова actor оказался медленнее serial queue, у меня наоборот. Я предположил, что дело в MainActor: в его тесте actor вызывался с главного потока. Теперь это можно проверить.
Измеряемые операции
Сам счетчик я оставил тем же, что в первом эксперименте. Меняется только то, как к нему обращаются.
actor CounterActor {
    private var value = 0

    func increment() {
        value &+= 1
    }
}
Обращаться к нему можно из фоновой задачи:
Task.detached {
    for _ in 0..<count {
        await counter.increment()
    }
}
Или с MainActor. Цикл тот же, но после каждого await выполнение возвращается на главный поток:
@MainActor
func incrementFromMainActor() async {
    for _ in 0..<count {
        await counter.increment()
    }
}
Для сравнения тот же счетчик под Mutex. Блокировка и в асинхронном коде захватывается синхронно, без await:
let value = Mutex(0)

value.withLock { $0 &+= 1 }
Код всех вариантов есть в репозитории.
Откуда обращаемся к actor
На графике время на одно увеличение счетчика для разных способов обращения: чем короче столбец, тем быстрее.
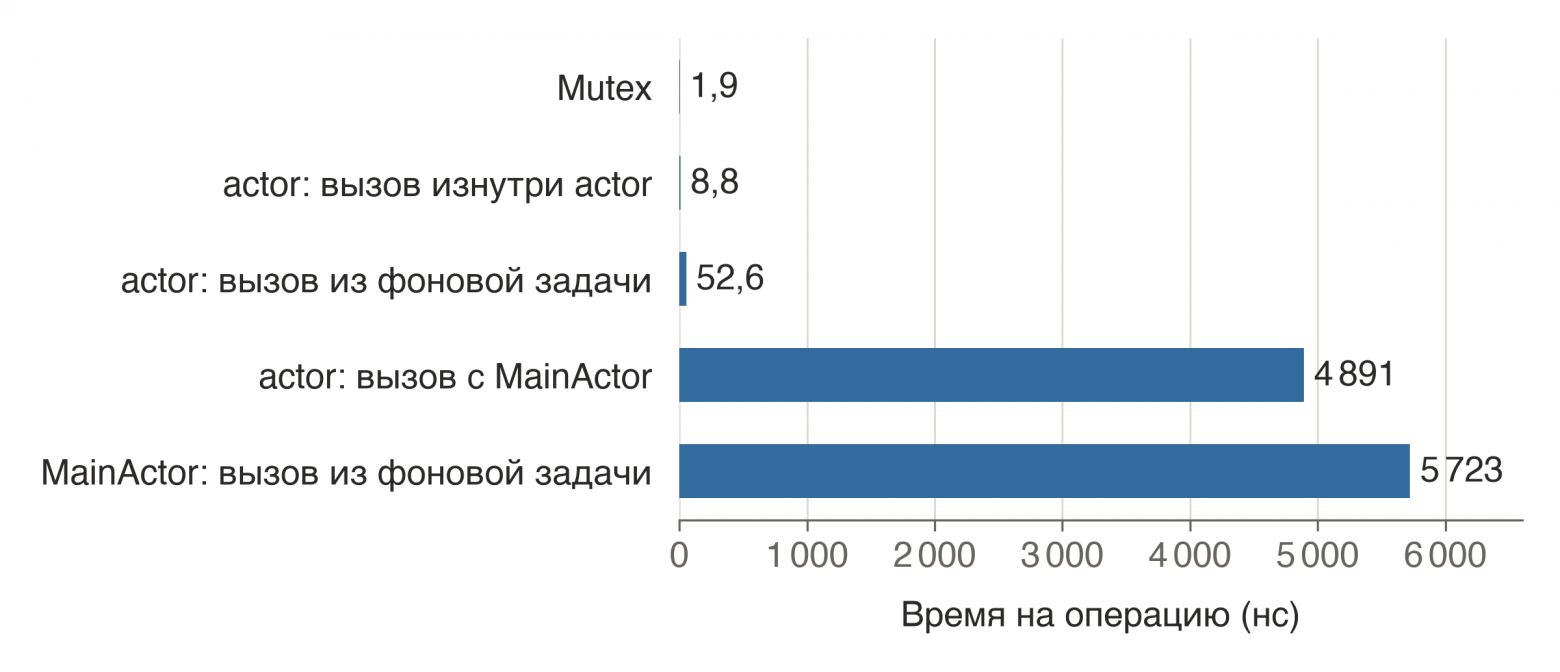
Те же данные в таблице:
Как выполняется увеличение счетчика | Время на операцию |
|---|---|
| 1,86 нс |
Actor, код уже выполняется на нем | 8,77 нс |
Actor, вызов из фоновой задачи | 52,61 нс |
Actor, вызов с | 4,89 мкс |
| 5,72 мкс |
Предположение подтвердилось: с главного потока обращение в 93 раза дороже. Фоновая задача тратит на одно обращение к actor 52,6 нс. Код на MainActor тратит 4,89 мкс, то есть 4891 нс. Счетчик и actor те же, изменилось только место вызова. В другую сторону результат похожий: когда фоновая задача обновляет состояние на MainActor, одно обращение занимает 5,72 мкс.
Этого хватает, чтобы объяснить результат Тодорова. У serial queue в первом эксперименте операция занимала от 88 до 199 нс. Обращение к actor из фоновой задачи быстрее, а с MainActor медленнее в десятки раз.
Чтобы оценить масштаб: сто обращений с MainActor к actor подряд займут около 0,5 мс. Кадр при 120 Гц длится 8,3 мс.
Дело в actor или в главном потоке?
На этот вопрос отвечает тест, в котором actor нет вообще. С MainActor вызывается обычная короткая async-функция, и я проверяю, в каком потоке выполняется ее тело и сколько занимает вызов:
nonisolated func work() async { … }

@concurrent
func concurrentWork() async { … }
Первую функцию я собирал с двумя наборами настроек проекта, поэтому вариантов три:
Вариант | Где выполнилась функция | Время на вызов |
|---|---|---|
| На главном потоке | 8,82 нс |
| Вне главного потока | 5,58 мкс |
| Вне главного потока | 5,60 мкс |
iPhone 15 Pro Max, iOS 26.6.2, Release-сборка. Медиана по 12 запускам.
Дорог не actor, а переключение потоков. Функция с @concurrent выполнялась вне главного потока, и каждый вызов занимал 5,60 мкс. Это даже чуть больше, чем обращение к actor с MainActor (4,89 мкс), хотя никакого actor здесь нет. Получается, около 5 мкс занимает само переключение с главного потока на фоновый и обратно.
А nonisolated async функция с настройками нового проекта остается на главном потоке. nonisolated async функция, вызванная с MainActor, во всех вызовах осталась на главном потоке, и вызов занял 8,8 нс. В режиме Swift 6 без Approachable Concurrency та же функция выполнялась вне главного потока: 5,58 мкс на вызов. Правила описаны в SE-0461.
Быстрый вызов в первой строке не значит, что так лучше: тяжелая работа в этом варианте тоже останется на главном потоке.
С главным потоком разобрались. Но и без него обращение к actor стоит 52,6 нс, в 28 раз больше, чем захват Mutex. И это одна задача, которой никто не мешает. А что будет, если задач много?
50 задач на одном счетчике
К одному счетчику одновременно обращаются 50 задач Task, каждая делает 1000 вызовов. Здесь я измеряю время каждого вызова отдельно и смотрю на p99.
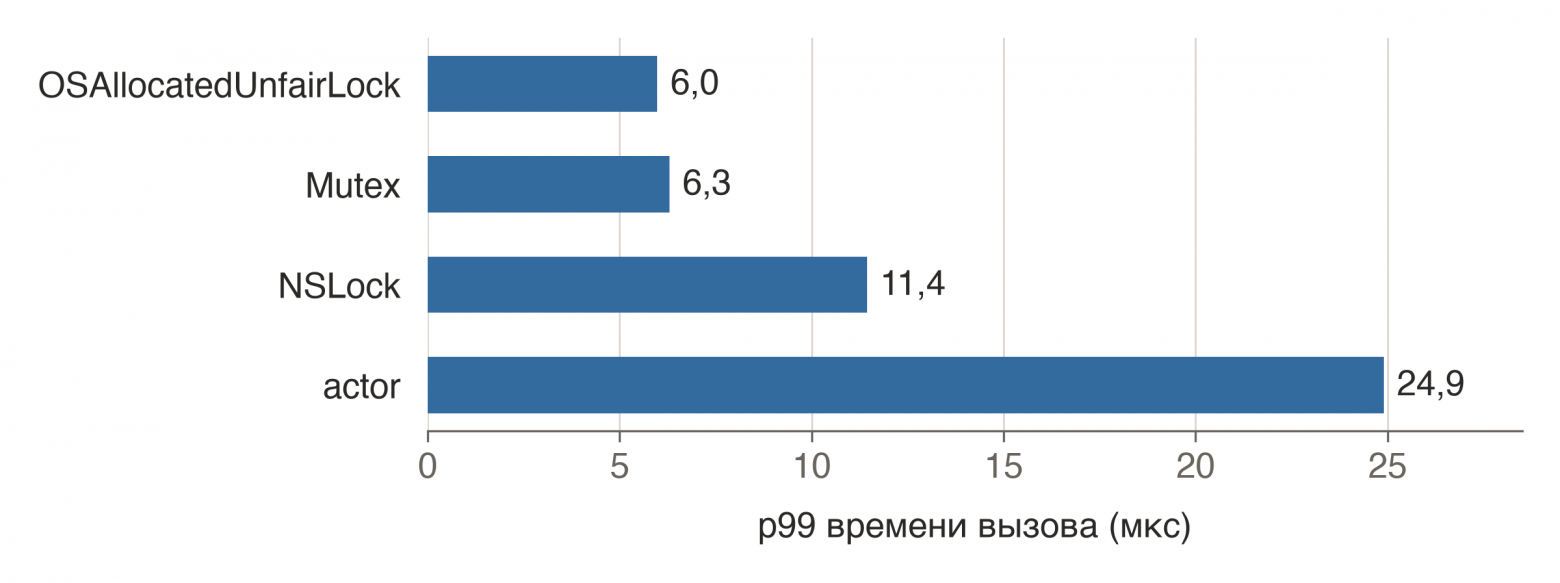
Task, по 1000 вызовов в каждой. iPhone 15 Pro Max, iOS 26.6.2, Release-сборка. Медиана по 20 запускам.Под нагрузкой разрыв остается. У Mutex и OSAllocatedUnfairLock p99 около 6 мкс, у NSLock 11,4 мкс, у actor 24,9 мкс. Отличается и обычный вызов: у actor медиана 19 мкс, у блокировок меньше 0,1 мкс. При каждом await задача уступает место другим и ждет своей очереди. Под блокировкой она чаще всего получает доступ к счетчику сразу.
Во всех этих тестах отдельное обращение к actor дороже захвата блокировки. Но платим мы за обращение, а не за работу внутри него. Отсюда последняя проверка: что будет, если обращаться реже, а за один раз делать больше?
Сто обновлений за один await
Состояние здесь это массив из 128 счетчиков. В первом варианте на каждое обновление приходится отдельный await, во втором один вызов выполняет сразу сто обновлений:
actor CounterGroupActor {
    private var counters = [Int](repeating: 0, count: 128)

    func incrementOne(at index: Int) {
        counters[index % 128] &+= 1
    }

    func incrementGroup(startingAt start: Int) {
        for index in start..<(start + 100) {
            counters[index % 128] &+= 1
        }
    }
}
Снаружи это выглядит так. В первом варианте сто вызовов:
for index in 0..<100 {
    await counters.incrementOne(at: index)
}
Во втором один:
await counters.incrementGroup(startingAt: 0)
Работа при этом та же: сто отдельных увеличений в массиве, а не одно прибавление числа 100.
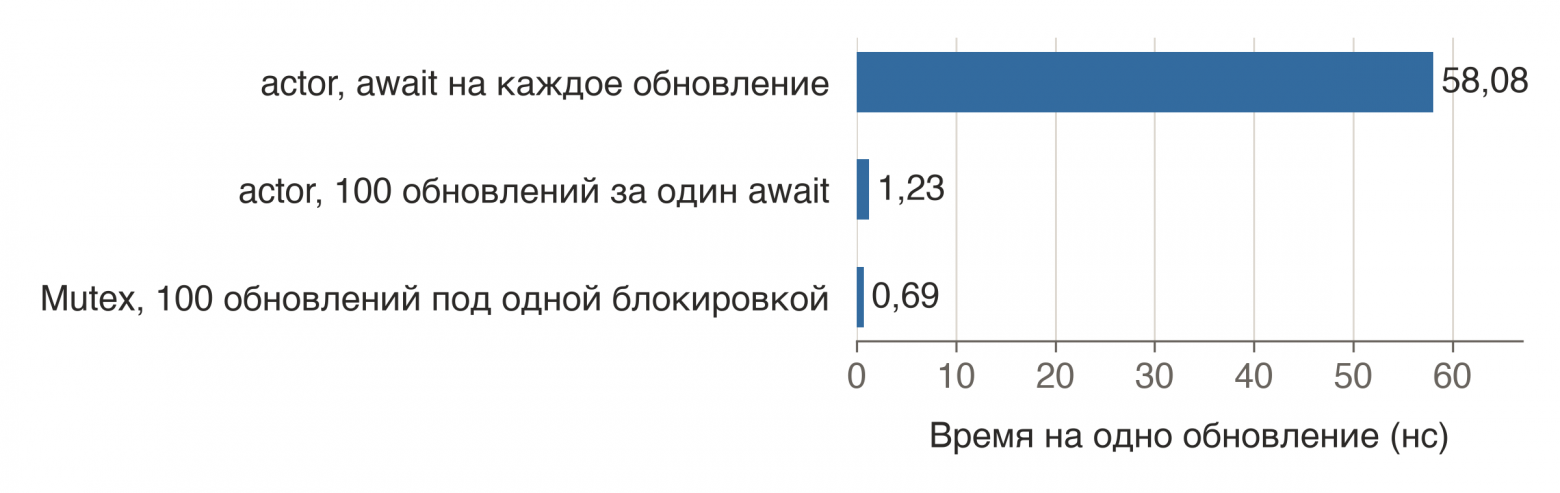
Группировка ускорила actor в 47 раз. С отдельным await одно обновление занимает 58,1 нс, в группе из ста 1,23 нс. Mutex с такой же группировкой все еще быстрее: 0,69 нс. Но разница между ними теперь полнаносекунды на обновление, а без группировки была около 50 нс.
Группировать можно не всегда: пока actor выполняет сто обновлений, остальные обращения к нему ждут.
iPhone 11 Pro Max
На старом телефоне картина та же. Обращение к actor из фоновой задачи занимает 64,6 нс, с MainActor 6,0 мкс. Группировка ускоряет actor в 49 раз: с 80,2 до 1,63 нс на обновление. При 50 задачах p99 у actor 35,4 мкс против 9,4 мкс у Mutex. Отличие одно: у NSLock p99 здесь 33,5 мкс, почти как у actor.
Вывод
Actor не медленный сам по себе. Сколько стоит обращение к нему, зависит от того, откуда оно идет и сколько работы выполняется за одно обращение.
Дороже всего переключение между главным потоком и фоновым: около 5 мкс туда и обратно, с actor или без него. Если оно происходит в цикле, искать стоит в первую очередь его.
Если состояние уже живет в actor, связанные операции лучше передавать ему одним вызовом. В тесте это ускорило actor в 47 раз.
Для короткой синхронной операции Mutex остается самым дешевым вариантом, и в асинхронном коде тоже. Одно другому не мешает: в том же Nuke 13 задачами управляет actor, а мелкое состояние, которое нужно читать синхронно, по-прежнему защищено блокировкой.
В следующем разделе главный поток читает кеш изображений во время скролла.
Кеш изображений при скролле
«Не блокируй главный поток». Это правило знает каждый iOS-разработчик. И все же кеш изображений читают именно с главного потока: cellForItemAt достает картинку из памяти, пока фоновые потоки кладут туда новые. Получается, во время скролла главный поток сам захватывает блокировку, а иногда и ждет, пока ее освободит фоновый.
Так работает, например, Nuke: LazyImageView проверяет кеш прямо на главном потоке, до запуска загрузки, а сам кеш защищен os_unfair_lock. В SDWebImage часть кеша в памяти тоже лежит под os_unfair_lock.
Я хотел понять две вещи. Сколько занимает такое чтение с разными механизмами синхронизации? И видно ли это при скролле?
Измеряемые операции
В тесте работает настоящий UICollectionView: сетка в четыре столбца, которую CADisplayLink скроллит с постоянной скоростью. Когда UIKit запрашивает ячейку, изображение для нее берется из кеша:
func collectionView(_ collectionView: UICollectionView,
                    cellForItemAt indexPath: IndexPath) -> UICollectionViewCell {
    let cell = collectionView.dequeueReusableCell(
        withReuseIdentifier: "image", for: indexPath) as! ImageCell
    cell.imageView.image = cache.image(for: key(at: indexPath))?.image
    return cell
}
Кеш это словарь, в котором по строке с URL лежит готовое изображение. Вот вариант под Mutex:
final class MutexImageCache {
    private let images = Mutex<[String: CachedImage]>([:])

    func image(for key: String) -> CachedImage? {
        images.withLock { $0[key] }
    }

    func store(_ entry: CachedImage, for key: String) {
        images.withLock { $0[key] = entry }
    }
}
Пока идет скролл, четыре фоновых потока заменяют изображения в кеше. Перед каждой записью поток выполняет вычисления вне блокировки, как будто декодирует картинку, а после записи засыпает на 700 мс. Кеш заполнен заранее, поэтому каждое чтение находит изображение.
Показателей два. Время чтения это длительность вызова cache.image(for:), остальная работа ячейки в него не входит. А чтобы поймать hitches, то есть моменты, когда главный поток не успевает к очередному кадру, я измерял интервалы между вызовами CADisplayLink. На экране 120 Гц вызов приходит каждые 8,3 мс. Если главный поток занят дольше, следующий вызов опаздывает, и интервал растет.
В сравнении 14 вариантов, их код есть в репозитории.
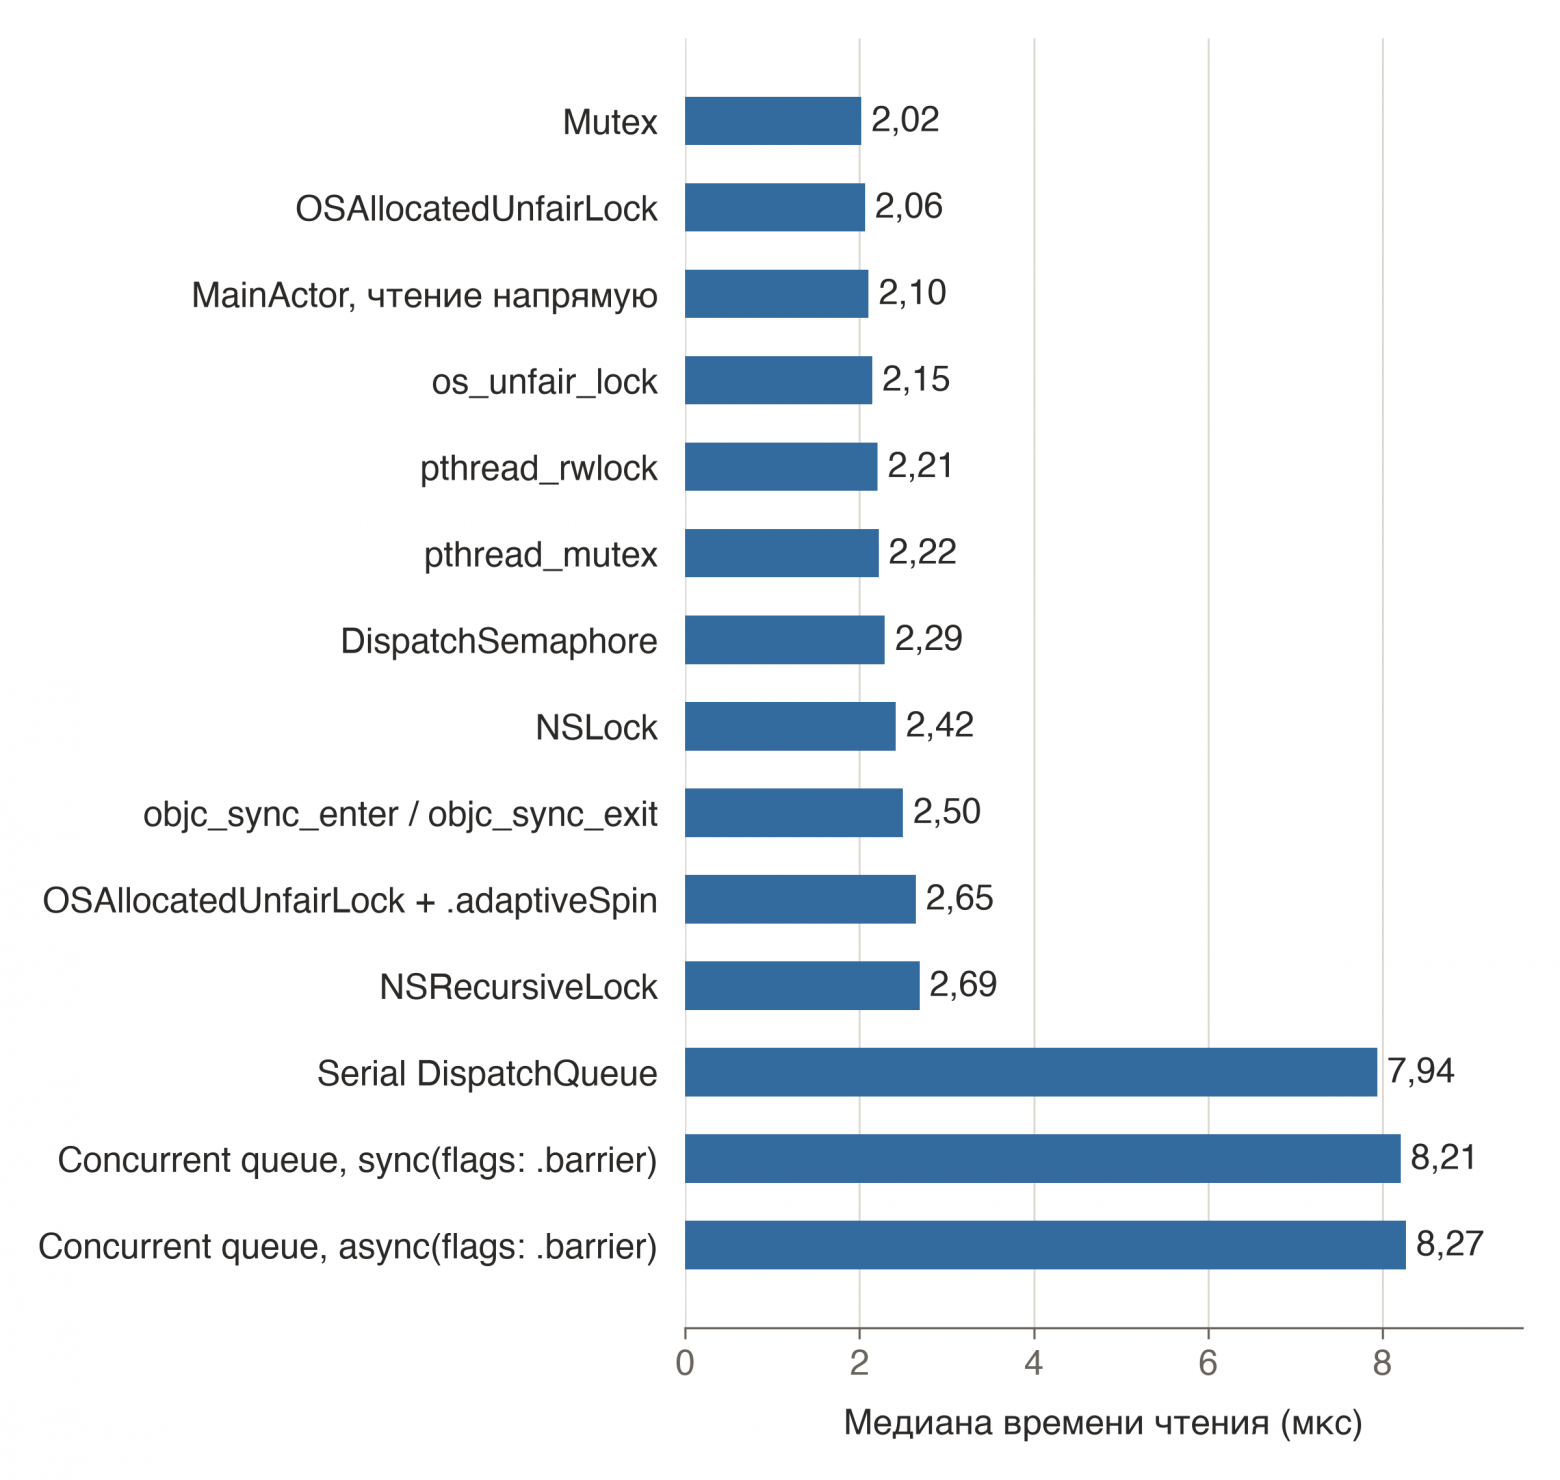
Сколько занимает чтение
На графике медиана времени чтения: чем короче столбец, тем быстрее.
Те же данные в таблице, вместе с p99:
Механизм | p50 чтения, мкс | p99 чтения, мкс |
|---|---|---|
| 2,02 | 8,16 |
| 2,06 | 8,56 |
| 2,10 | 8,29 |
| 2,15 | 8,62 |
| 2,21 | 8,48 |
| 2,22 | 8,41 |
| 2,29 | 9,21 |
| 2,42 | 10,02 |
| 2,50 | 9,00 |
| 2,65 | 9,96 |
| 2,69 | 9,93 |
Serial | 7,94 | 19,25 |
Concurrent queue, запись через | 8,21 | 20,21 |
Concurrent queue, запись через | 8,27 | 19,89 |
Через очередь чтение в четыре раза дольше. Под Mutex оно занимает 2,0 мкс, через serial queue 7,9 мкс, через concurrent queue около 8,2 мкс. У остальных блокировок от 2,1 до 2,7 мкс.
pthread_rwlock и .adaptiveSpin здесь не помогли. Чтение с ними занимает 2,21 и 2,65 мкс против 2,02 мкс у Mutex. Фоновые потоки пишут редко, и главный поток почти никогда не ждет блокировку.
Итак, очередь добавляет к каждому чтению около 6 мкс. Заметно ли это при скролле?
Видно ли это при скролле?
Нет, не видно. У всех 14 вариантов интервалы между вызовами CADisplayLink одинаковые, и ни один не растянулся даже до полутора кадров.
Это ожидаемо. Hitches обычно появляются, когда главный поток занят тяжелой работой: сложный UI, верстка, декодирование картинок. Чтение из кеша к такой работе не относится. Оно занимает микросекунды, а кадр при 120 Гц длится 8,3 мс. Поэтому от выбора блокировки плавность скролла здесь не зависит.
А если кеш привязать к MainActor
Читает кеш только главный поток. Значит, блокировка для чтения не обязательна: кеш можно привязать к MainActor.
@MainActor
final class MainActorImageCache {
    private var images: [String: CachedImage] = [:]

    func image(for key: String) -> CachedImage? {
        images[key]
    }

    func store(_ entry: CachedImage, for key: String) {
        images[key] = entry
    }
}
В прошлом разделе обращение к MainActor из фоновой задачи занимало 5,7 мкс. Но здесь читает сам главный поток, и переключаться ему не нужно. Чтение занимает 2,10 мкс, почти столько же, сколько под Mutex. Переключение потоков достается фоновым задачам, которые пишут через await cache.store(…), а записей всего около шести в секунду.
Из этого сравнения видно еще одно. Чтение без всякой блокировки занимает те же 2 мкс, что и под Mutex. Значит, на саму блокировку из этих 2 мкс почти ничего не уходит.
iPhone 11 Pro Max
На старом телефоне экран обновляется с частотой 60 Гц. Чтение под Mutex занимает 3,1 мкс, через serial queue 13,7 мкс, в четыре с лишним раза дольше. Интервалов дольше полутора кадров тоже нет.
Вывод
Короткое чтение под блокировкой не нарушает правило «не блокируй главный поток». Под Mutex оно занимает около 2 мкс, а кадр длится 8,3 мс.
Очередь в четыре раза медленнее, но и этой разницы при скролле не видно. Менять очередь на Mutex ради плавности здесь незачем: hitches появляются из-за тяжелой работы на главном потоке, а не из-за выбора блокировки.
Если кеш уже привязан к MainActor, переносить его под блокировку ради скорости чтения тоже незачем.
Все это верно, пока блокировку держат недолго. В следующем разделе ее удерживает фоновый поток с низким приоритетом, а главный поток ждет.
Инверсия приоритетов: главный поток ждет фоновый
Тяжелую фоновую работу обычно запускают с низким приоритетом, чтобы она не мешала интерфейсу. Но представим, что такой поток захватил блокировку, которая нужна главному. Теперь главный поток ждет, пока фоновый закончит. А фоновому не дают процессорного времени, потому что в приложении есть работа с приоритетом выше. Получается наоборот: самый важный поток ждет самого неважного. Это и называют инверсией приоритетов.
Некоторые механизмы синхронизации должны решать эту проблему: пока важный поток ждет, система временно передает его приоритет потоку, который держит блокировку. В этом разделе я проверяю, сколько в такой ситуации ждет главный поток и какие механизмы действительно сокращают это ожидание.
Измеряемые операции
Одна попытка выглядит так:
Фоновый поток с приоритетом
backgroundзахватывает блокировку и начинает работу под ней. Без нагрузки на процессор эта работа занимает около 5 мс.Шесть потоков с приоритетом
userInitiatedзанимают все ядра на 300 мс.Через 1 мс главный поток пытается прочитать состояние под той же блокировкой.
Я измеряю, сколько главный поток ждал. Вот как это выглядит с Mutex:
let state = Mutex(0)

// Фоновый поток, приоритет background
state.withLock { value in
    doWork()    // около 5 мс без нагрузки
    value = trial
}

// Главный поток, через 1 мс
let value = state.withLock { $0 }
В каждом запуске по 100 таких попыток на механизм. В сравнении 14 вариантов, их код есть в репозитории.
Сколько ждет главный поток
На графике медиана ожидания: чем короче столбец, тем лучше.
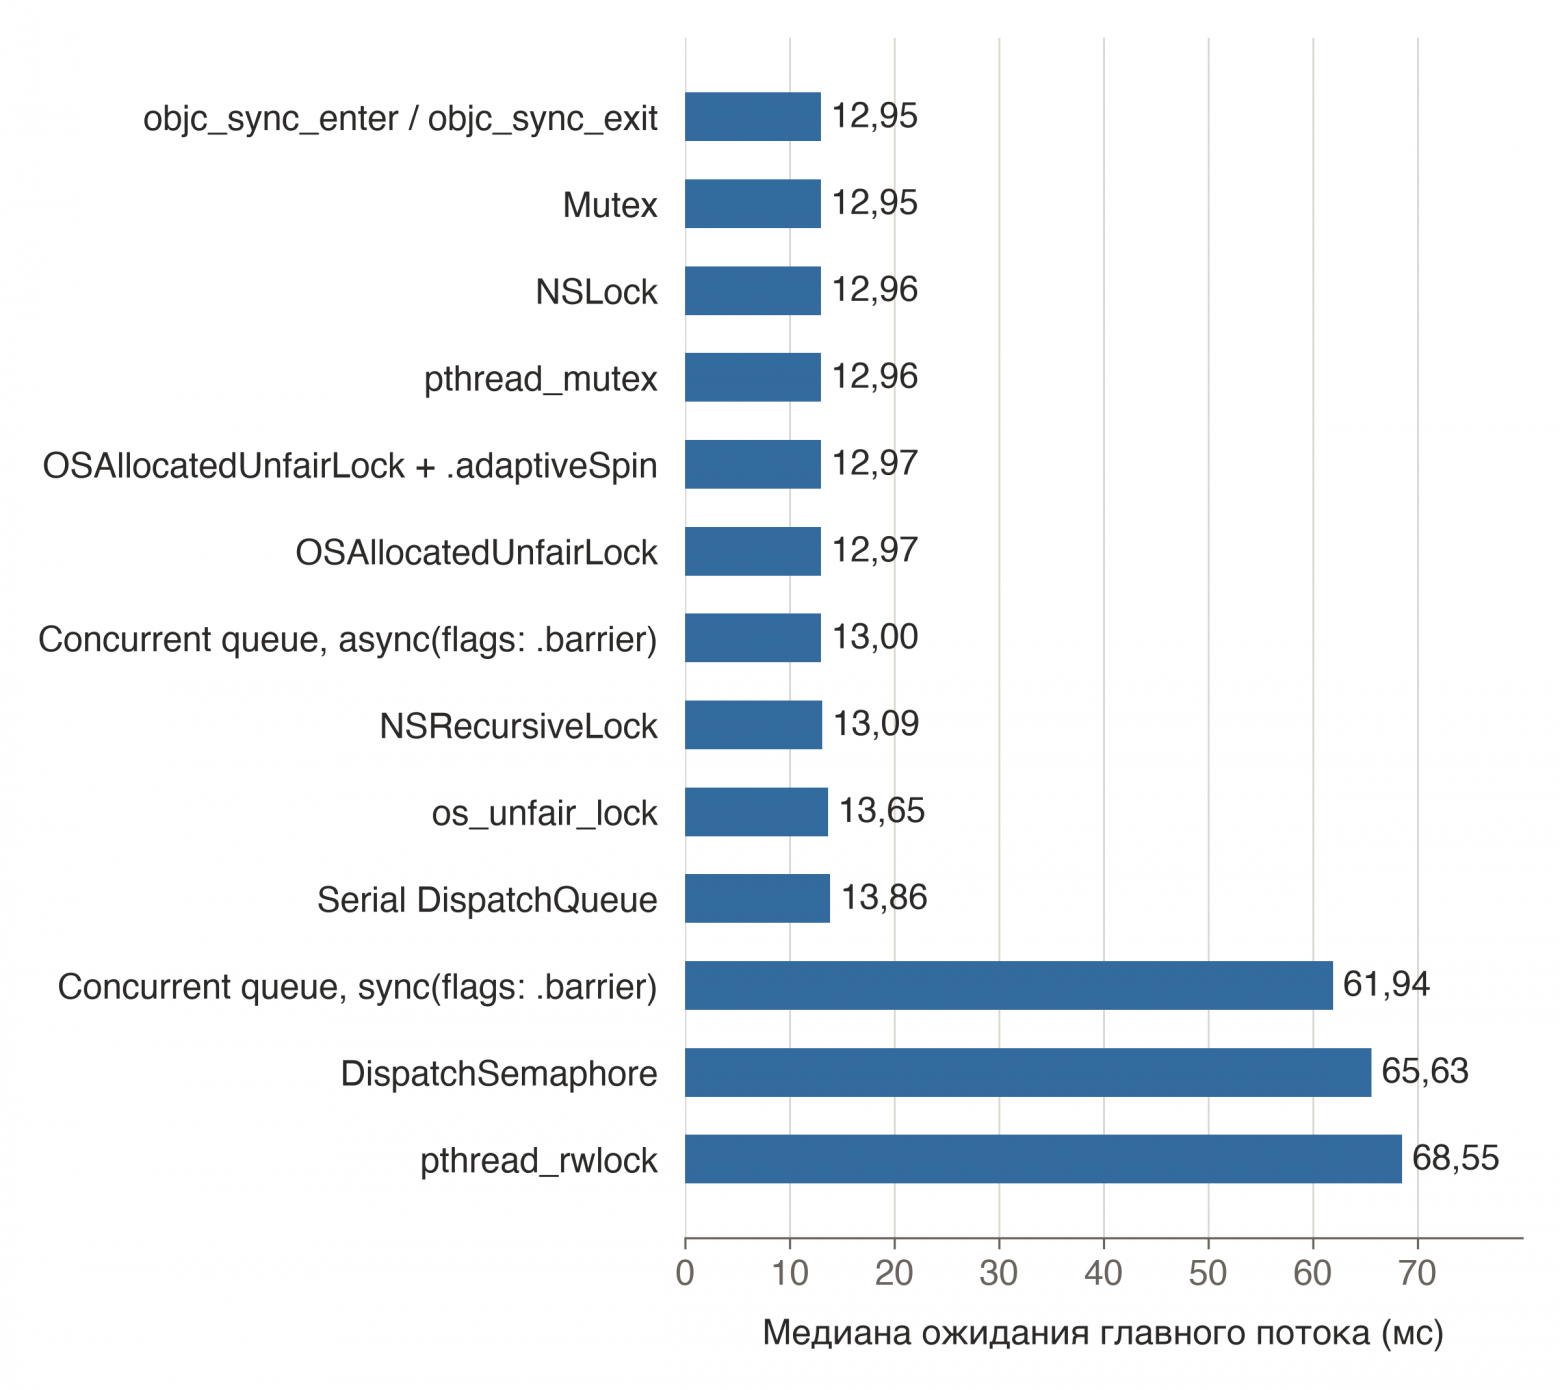
background, шесть потоков нагрузки с приоритетом userInitiated. iPhone 15 Pro Max, iOS 26.6.2, Release-сборка. Медиана по трем запускам.Те же данные в таблице:
Механизм | Медиана ожидания, мс |
|---|---|
| 12,95 |
| 12,95 |
| 12,96 |
| 12,96 |
| 12,97 |
| 12,97 |
Concurrent queue, запись через | 13,00 |
| 13,09 |
| 13,65 |
Serial | 13,86 |
Concurrent queue, запись через | 61,94 |
| 65,63 |
| 68,55 |
У десяти механизмов из тринадцати ожидание одинаковое, около 13 мс. У Mutex 12,95 мс, у NSLock 12,96 мс, у serial queue 13,86 мс.
Три механизма заставляют ждать примерно в пять раз дольше. С concurrent queue и записью через sync(flags: .barrier) главный поток ждет 61,9 мс, с DispatchSemaphore 65,6 мс, с pthread_rwlock 68,6 мс.
С приоритетом utility у фонового потока результат тот же: около 13 мс у большинства и от 55 до 60 мс у той же тройки.
Почему именно эти три
Ответ есть у Apple. В докладе Modernizing Grand Central Dispatch Usage с WWDC 2017 примитивы синхронизации делятся на три группы:
С одним известным владельцем, как serial queue и
os_unfair_lock. Система знает, какой поток держит блокировку, и может передать ему приоритет того, кто ждет.Без владельца, как
DispatchSemaphore. Система не знает, какой поток вызоветsignal, и передавать приоритет некому.С несколькими владельцами, как concurrent queue и read-write lock. Одного владельца нет, и приоритет система не передает.
Медленная тройка в точности совпадает со второй и третьей группой. С этим объяснением результаты сходятся: в быстрой группе фоновый поток на время получает приоритет главного и заканчивает работу, а в медленной остается со своим и ждет свободного ядра.
Одно исключение я объяснить не могу. Вариант с async(flags: .barrier) оказался в быстрой группе, хотя очередь там та же concurrent queue.
13 мс это тоже много
Даже в быстрой группе главный поток ждал 13 мс, хотя работы под блокировкой всего на 5 мс, но под нагрузкой она идет дольше. При 120 Гц 13 мс это полтора кадра, то есть hitch. И выбором блокировки его не убрать.
iPhone 11 Pro Max
На старом телефоне те же три механизма медленнее остальных, но разница меньше: у них около 21,5 мс, у остальных от 12 до 14,5 мс.
Вывод
Если блокировку может ждать главный поток, стоит выбирать механизм, который справляется с инверсией приоритетов: Mutex, OSAllocatedUnfairLock, NSLock или serial queue. С семафором, pthread_rwlock и concurrent queue с sync(flags: .barrier) главный поток ждал в пять раз дольше.
Но и с Mutex главный поток ждал 13 мс, а это уже hitch. Значит, менять нужно не блокировку, а то, что под ней происходит. Вычисления стоит выполнять до захвата, а под блокировкой оставлять только короткое обновление состояния.
Остался последний вопрос: сколько стоит сам объект блокировки, по времени создания и по памяти.
Стоимость создания объектов и расход памяти
Блокировку обычно хранят прямо в объекте: это одно поле рядом с состоянием, которое она защищает. Пока таких объектов несколько, об этом поле никто не думает. Но бывает, что таких объектов тысячи: записи кеша, запросы, элементы списка. Тогда у каждого своя блокировка, своя очередь или свой actor, и каждую нужно создать, хранить в памяти и потом уничтожить.
В этом разделе я проверяю, сколько времени занимает создание и уничтожение такого объекта и сколько памяти добавляет к нему механизм синхронизации.
Измеряемые операции
Объект в тесте простой: одно целое число и механизм, который его защищает. Вот вариант с Mutex и вариант с собственной очередью:
final class MutexObject {
    private let value = Mutex<Int>(0)
}

final class SerialQueueObject {
    private var value = 0
    private let queue = DispatchQueue(label: "creation.serial")
}
Я создаю 100 000 таких объектов подряд, а потом уничтожаю их. Время делю на число объектов. Память считаю по счетчикам аллокатора: насколько выросло число занятых байт после создания, в пересчете на один объект. Затем вычитаю из него результат для объекта без синхронизации. К объектам в этом тесте никто не обращается, они только создаются и уничтожаются.
В сравнении 15 вариантов, их код есть в репозитории.
Сколько времени занимает создание
На графике время создания одного объекта: чем короче столбец, тем быстрее.
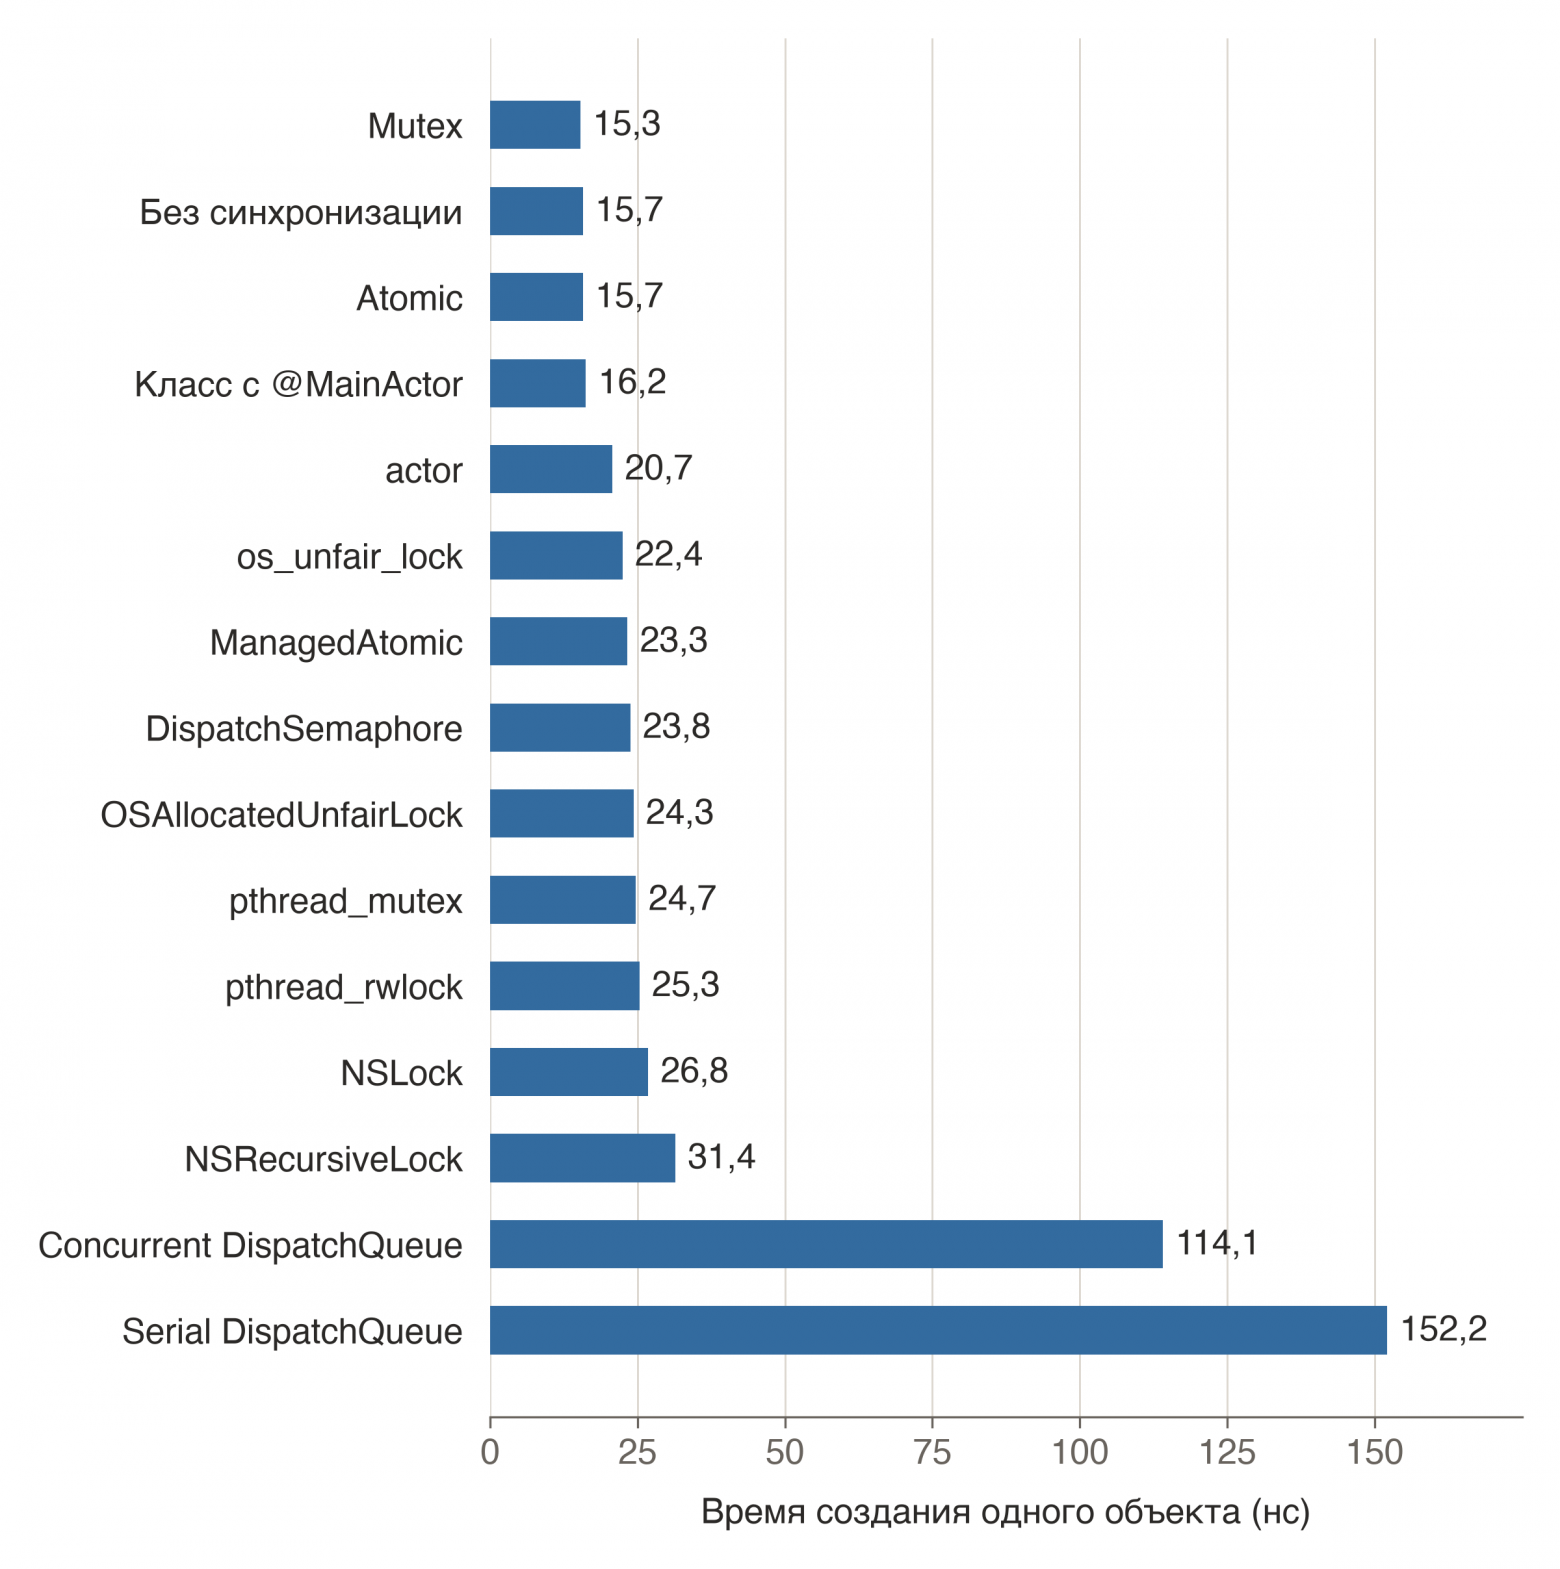
Объект с Mutex создается так же быстро, как объект без синхронизации. У них 15,3 и 15,7 нс. То же у Atomic и у класса с @MainActor.
Остальные блокировки добавляют от 7 до 16 нс. У OSAllocatedUnfairLock 24,3 нс, у NSLock 26,8 нс, у NSRecursiveLock 31,4 нс.
Объект с собственной очередью создается в семь-десять раз дольше. С serial queue это 152 нс, с concurrent queue 114 нс. На 100 000 объектов получается 15 мс против 1,5 мс с Mutex.
Откуда такая разница, видно по памяти.
Сколько памяти добавляет механизм
Здесь столбец показывает, на сколько байт объект с механизмом синхронизации больше такого же объекта без него.
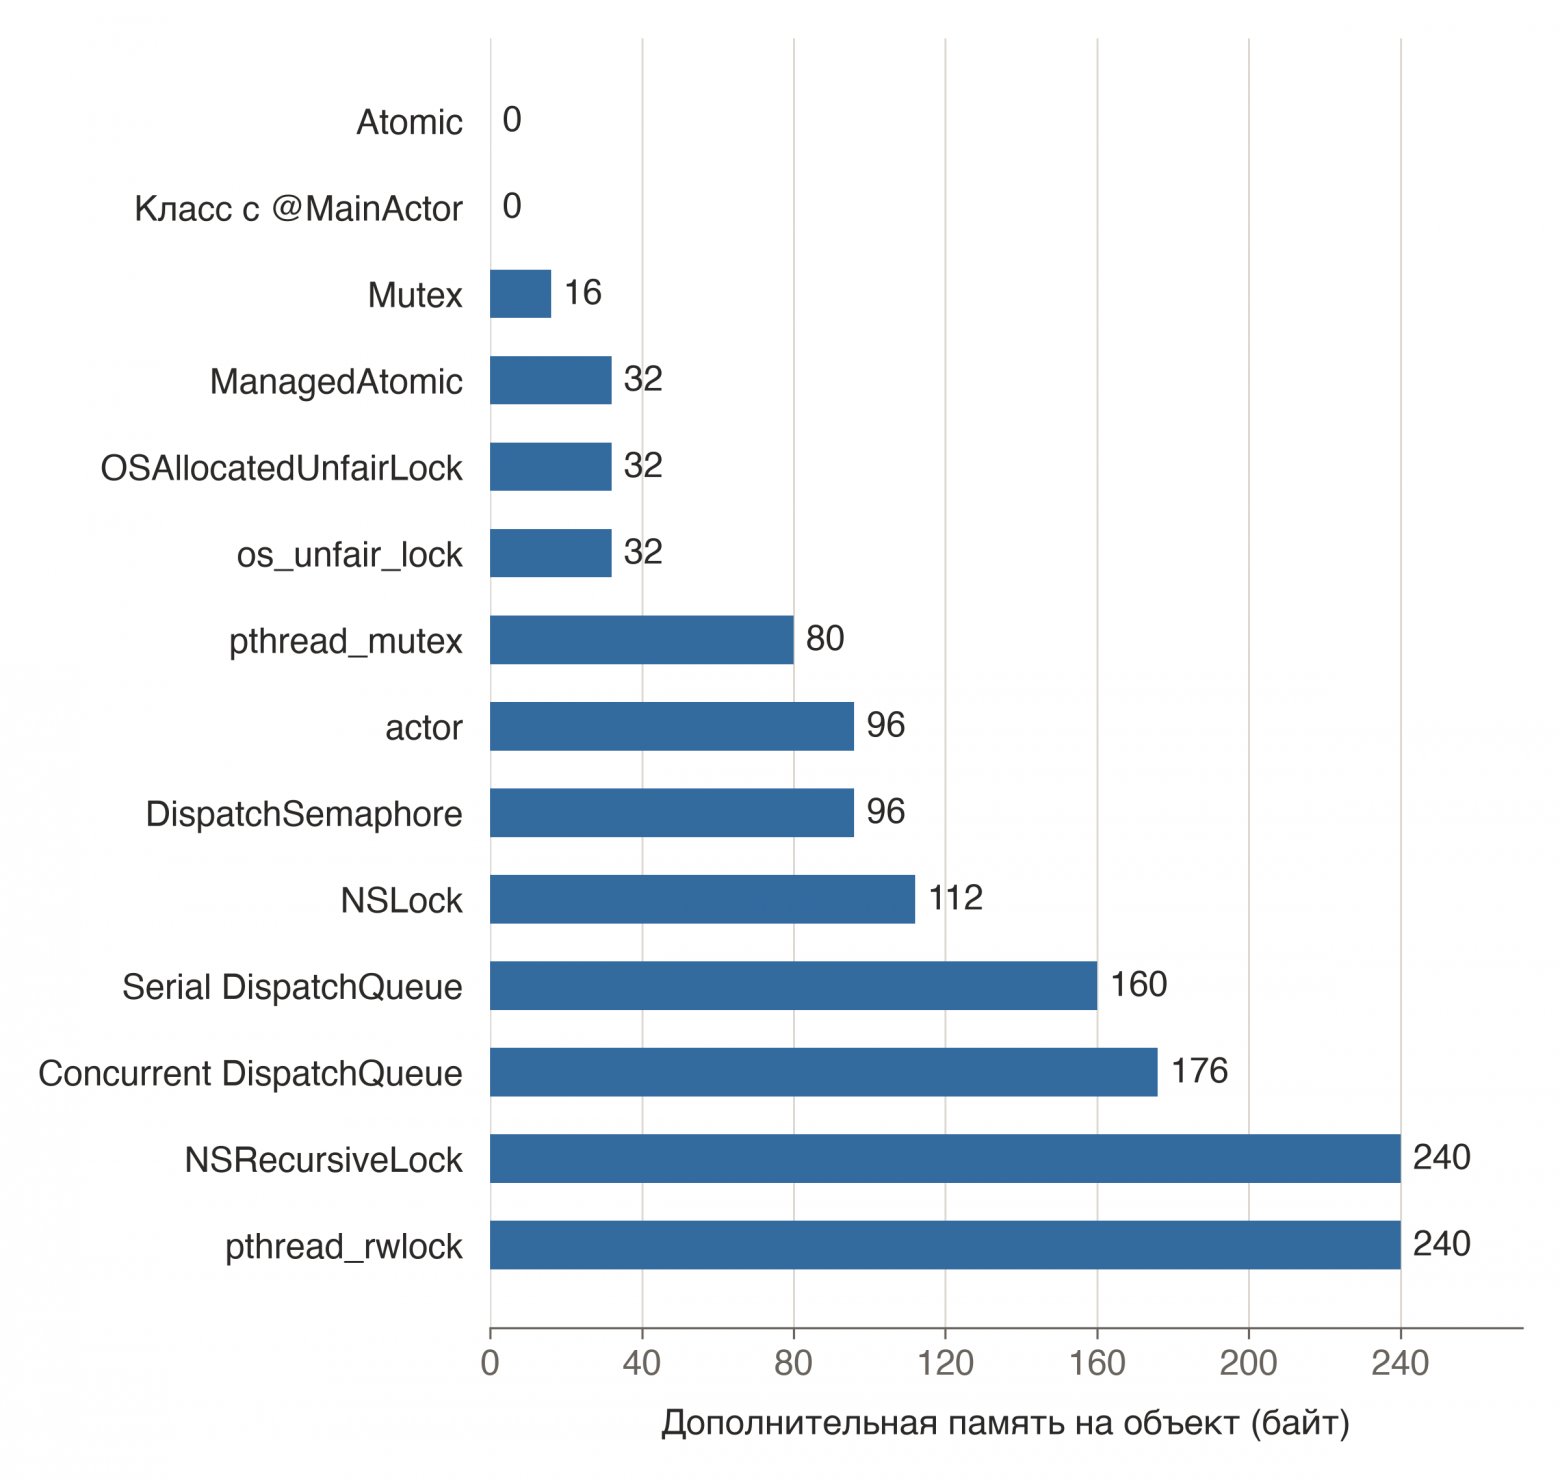
Те же данные в таблице, вместе с временем уничтожения:
Объект содержит | Создание, нс | Уничтожение, нс | Дополнительная память, байт |
|---|---|---|---|
Без синхронизации | 15,7 | 17,5 | 0 |
| 15,7 | 17,0 | 0 |
Класс с | 16,2 | 17,4 | 0 |
| 15,3 | 16,6 | 16 |
| 22,4 | 24,6 | 32 |
| 23,3 | 39,8 | 32 |
| 24,3 | 35,6 | 32 |
| 24,7 | 28,0 | 80 |
Actor | 20,7 | 22,3 | 96 |
| 23,8 | 65,9 | 96 |
| 26,8 | 36,2 | 112 |
Serial | 152,2 | 81,0 | 160 |
Concurrent | 114,1 | 83,5 | 176 |
| 25,3 | 28,7 | 240 |
| 31,4 | 34,9 | 240 |
Mutex добавляет к объекту 16 байт. Он хранится прямо внутри объекта, и отдельно выделять память для него не нужно. Поэтому и создается такой объект так же быстро, как объект без блокировки.
Для остальных блокировок память выделяется отдельно. На каждый объект приходится уже два выделения вместо одного. OSAllocatedUnfairLock добавляет 32 байта, NSLock 112, NSRecursiveLock и pthread_rwlock по 240. По скорости обращения Mutex и OSAllocatedUnfairLock в первом эксперименте были равны, а по стоимости создания нет.
Очередь требует трех выделений памяти на объект и добавляет 160 байт. Это как раз случай Pocket Casts из раздела про feature flag: там каждый флаг создавал собственную очередь.
На 100 000 объектов это 1,6 МБ с Mutex, 11 МБ с NSLock, 16 МБ с serial queue и 24 МБ с NSRecursiveLock.
iPhone 11 Pro Max
На старом телефоне память та же. Время примерно вдвое больше, но соотношения те же: объект с Mutex создается за 31,1 нс, без синхронизации за 30,5 нс, с serial queue за 318 нс.
Вывод
Если блокировка нужна в каждом объекте, а объектов много, стоит брать Mutex. Объект с ним создается так же быстро, как без синхронизации, и занимает на 16 байт больше.
Создавать собственную очередь на каждый объект не стоит: такой объект создается в семь-десять раз дольше и занимает минимум на 160 байт больше.
Для одного значения подойдет Atomic: он не добавляет к объекту ничего.
Это был последний эксперимент. Осталось собрать выводы вместе.
Итог
В начале статьи я задавался вопросом, есть ли механизм синхронизации, который можно выбирать по умолчанию. Есть, и это Mutex. Во всех восьми экспериментах на iPhone 15 Pro Max он оказался в числе лучших.
Обгоняли его только в отдельных условиях: Atomic на одном значении, флаг .adaptiveSpin на редких долгих вызовах. Read-write lock и очереди не были быстрее Mutex ни в одном эксперименте.
При этом сам выбор механизма меняет немного. Захват свободной блокировки у разных механизмов отличается на наносекунды, у очередей на сотни наносекунд. Заметные задержки, микросекунды и миллисекунды, появлялись в трех случаях: когда потоки непрерывно конкурировали за блокировку, когда выполнение в цикле переключалось между главным потоком и фоновым и когда блокировку надолго захватывал фоновый поток.
Блокировка часто оказывается лишь небольшой частью оптимизации. У каждого приложения и у каждой задачи свои условия, и основное ускорение может найтись совсем в другом месте. Пример есть в моей статье «От 798 до 16 нс: как оптимизация debounce привела меня в Swift Runtime».
Mutex по умолчанию
В таблице результаты пяти экспериментов для механизмов, которые участвовали почти в каждом из них.
Механизм | Счетчик, нс | Словарь, млн операций/с | Словарь, p99 вызова, мкс | 98% чтений, млн операций/с | Ожидание главного потока, мс | Дополнительная память, байт |
|---|---|---|---|---|---|---|
| 1,86 | 1,06 | 19,1 | 9,37 | 12,95 | 16 |
| 1,86 | 1,08 | 22,5 | 9,50 | 12,97 | 32 |
| 1,85 | 1,04 | 67,0 | 8,60 | 13,65 | 32 |
| 4,62 | 0,89 | 51,7 | 9,29 | 12,96 | 80 |
| 6,36 | 0,89 | 51,8 | 8,05 | 12,96 | 112 |
| 6,00 | нет в тесте | нет в тесте | 3,07 | 68,55 | 240 |
| 3,74 | 0,20 | 47,3 | 1,05 | 65,63 | 96 |
Serial | 88,23 | 0,18 | 64,1 | 0,45 | 13,86 | 160 |
iPhone 15 Pro Max. Счетчик: один поток. Словарь: восемь потоков без пауз. 98% чтений: шесть потоков, группы из двадцати записей. Ожидание главного потока: блокировку держит поток с приоритетом background.
Mutex, OSAllocatedUnfairLock и os_unfair_lock это одна и та же блокировка. На платформах Apple Mutex хранит внутри себя os_unfair_lock и вызывает его функции напрямую. OSAllocatedUnfairLock это тот же os_unfair_lock, для которого память выделена отдельно. Поэтому время захвата у всех трех одинаковое, а отличаются они тем, где хранится блокировка и как ее захватывают.
Mutex доступен с iOS 18. Если приложение поддерживает более ранние версии, подойдет OSAllocatedUnfairLock: он есть с iOS 16.
Менять работающий NSLock на Mutex ради скорости обычно не имеет смысла. Без конкуренции NSLock добавляет около 4,5 нс на захват, а при инверсии приоритетов главный поток ждал с ним столько же, сколько с Mutex. Разница появляется в двух случаях. Когда потоки обращаются к блокировке непрерывно: в словаре NSLock выполнил на 15% меньше операций, а p99 вызова вырос с 19 до 52 мкс. И когда блокировок много: NSLock добавляет к объекту 112 байт, Mutex 16.
Очередь, которая защищает состояние через queue.sync, почти в каждом эксперименте была среди самых медленных. Увеличение счетчика через нее в 48 раз дольше, чем под Mutex, чтение флага в сто раз дольше. В словаре при восьми потоках serial queue выполнила почти в шесть раз меньше операций, при 98% чтений в двадцать раз меньше. Объект с собственной очередью создается в десять раз дольше и занимает на 160 байт больше.
Заменять такую очередь блокировкой стоит прежде всего там, где обращения идут непрерывно или где очередь создается в каждом объекте. Если обращения редкие, замена ничего заметного не даст.
Atomic для одного значения
Если достаточно одной атомарной операции, Atomic быстрее блокировки. Это чтение флага, замена значения, увеличение счетчика. Чтение флага занимает 0,32 нс против 1,86 нс под Mutex. На счетчике при одном потоке Atomic равен Mutex, а при двух выполняет втрое больше операций в секунду: 310 против 102 млн. С точки зрения использования памяти к объекту он не добавляет ни одного байта.
Если флаг уже защищен Mutex, менять его на Atomic ради скорости обычно не имеет смысла. Разница составляет 1,5 нс на чтение: при 10 000 чтений в секунду это 3 мкс с Atomic и 19 мкс с Mutex. Замена оправдана, когда флаг читают намного чаще или когда за значение постоянно конкурируют несколько потоков.
До iOS 18 вместо Atomic можно взять ManagedAtomic из пакета swift-atomics. Чтение с ним занимает 0,80 нс, а к объекту он добавляет 32 байта.
Подтвердились ли привычные советы?
«Если нужна высокая производительность, используйте os_unfair_lock». Совет по сути верный, только следовать ему теперь проще через Mutex. Внутри Mutex тот же os_unfair_lock: захват занимает те же 1,86 нс, но ручные вызовы lock() и unlock() не нужны. Больше операций в секунду, чем Mutex, os_unfair_lock не выполнил ни в словаре, ни при 98% чтений. Причины использовать его в новом коде напрямую я не нашел.
«Если чтений гораздо больше, чем записей, присмотритесь к read-write lock или concurrent queue с barrier». На коротких операциях в памяти совет не подтвердился. При 98% чтений и шести потоках pthread_rwlock выполнил втрое меньше операций в секунду, чем Mutex, а concurrent queue примерно вшестеро меньше. Запись с ними тоже ждала дольше: p99 записи 21,8 и 29,6 мкс против 8,0 мкс.
Скорее всего, дело в длине операции. Захват pthread_rwlock сам по себе дороже: чтение флага под ним занимает 6,1 нс против 1,86 нс под Mutex. На коротком чтении из памяти выигрыш от параллельного чтения меньше этой разницы.
У этих механизмов нашлись еще два недостатка, уже не связанные с долей чтений. При инверсии приоритетов главный поток ждал pthread_rwlock 68,6 мс, concurrent queue с записью через sync(flags: .barrier) 61,9 мс, а Mutex 13 мс. И pthread_rwlock добавляет к объекту 240 байт, в пятнадцать раз больше, чем Mutex.
Поэтому и при большой доле чтений начинать стоит с Mutex. Read-write lock имеет смысл проверить, если чтение под блокировкой долгое. В моих тестах таких операций не было, и выигрыш нужно измерять на своем коде.
«Акторы медленные, возьми блокировку». Совет подтвердился наполовину. Обращение к actor из фоновой задачи занимает 52,6 нс, в 28 раз больше, чем захват Mutex.
Но платим мы за обращение, а не за работу внутри actor. Сто обновлений за один await обходятся в 1,23 нс каждое вместо 58,1 нс. Это в 47 раз меньше и уже близко к Mutex с его 0,69 нс.
Дороже всего в этих тестах оказался не actor, а переключение между главным потоком и фоновым. Оно занимает около 5 мкс туда и обратно, с actor или без него. Это в 93 раза больше, чем обращение к actor из фоновой задачи. А когда код уже выполняется на нужном actor, переключаться не нужно совсем.
Отсюда рекомендации:
Не заменять actor блокировкой только потому, что одно обращение к нему дороже. Сначала стоит посмотреть, откуда идут обращения и сколько работы приходится на каждое.
Не переключаться между главным потоком и фоновым в цикле.
Связанные операции передавать actor одним вызовом.
Мелкое состояние, которое нужно читать синхронно, и в асинхронном коде защищать
Mutex.
«Не блокируй главный поток». Правило верное, если понимать его как ограничение на время, которое блокировку удерживают. Когда главный поток читал кеш под Mutex, чтение занимало около 2 мкс. Когда под тем же Mutex фоновый поток выполнял вычисления, главный поток ждал 13 мс, а это уже hitch.
Поэтому вычисления стоит выполнять до захвата, а под блокировкой оставлять короткое обновление состояния. И там, где блокировку может ждать главный поток, не стоит использовать DispatchSemaphore, pthread_rwlock и concurrent queue с sync(flags: .barrier): с ними он ждал в пять раз дольше.
С чего начать
В большинстве случаев достаточно взять Mutex и больше о выборе блокировки не думать. Время полезнее потратить на то, что выполняется под блокировкой и как часто к ней обращаются.
Задача | С чего начать |
|---|---|
Короткая синхронная операция над общим состоянием |
|
Одно значение: флаг или счетчик |
|
Чтений намного больше, чем записей |
|
Состояние уже в actor или на | Оставить как есть. Группировать обращения и не переключаться между главным потоком и фоновым в цикле |
Блокировку может ждать главный поток |
|
Блокировка в каждом из тысяч объектов |
|
Потоки непрерывно конкурируют за блокировку, и важен p99 | Проверить |
В коде уже есть | Ради скорости не менять |
Бенчмарк и сырые результаты всех запусков открыты. Эксперименты можно запустить на своем устройстве и сравнить числа с моими.
Спасибо, что дочитали! Если у вас получатся другие результаты или останутся вопросы, пишите в комментариях.

