
Все началось с простой идеи: я хотел настроить локального ИИ‑агента на своем стареньком ноутбуке (MSI с GTX 1050 Ti), чтобы он сам крутил ветки, правил файлы и отправлял Pull Request на GitHub. Но маленькие локальные модели (Qwen 2.5 Coder 7B и DeepSeek R1 7B) постоянно путали синтаксис Windows, срывались на обычный чат и наотрез отказывались автономно нажимать кнопку «Запустить терминал».
Поняв, что доверять ИИ‑агентам 7B сложные многошаговые скрипты рановато, я решил взять управление в свои руки. До этого дня я никогда не писал скрипты на PowerShell (.ps1), но все‑таки, чутка почитав, удалось разобраться и состряпать скрипт. А пока скрипт рождался, закралась в голову мысль проверить: что будет, если бахнуть по GitHub непрерывным потоком из 1000 PR?
Результат эксперимента
1035 Pull Request
1035 успешных merge
Merge Failures: 0
0 ошибок CI
~3.5 часа работы
1 неудаленная ветка
Ниже история о том, как я собрал свой первый автоматический конвейер, с какими граблями столкнулся и как GitHub переваривал этот хаос в течение пары часов.
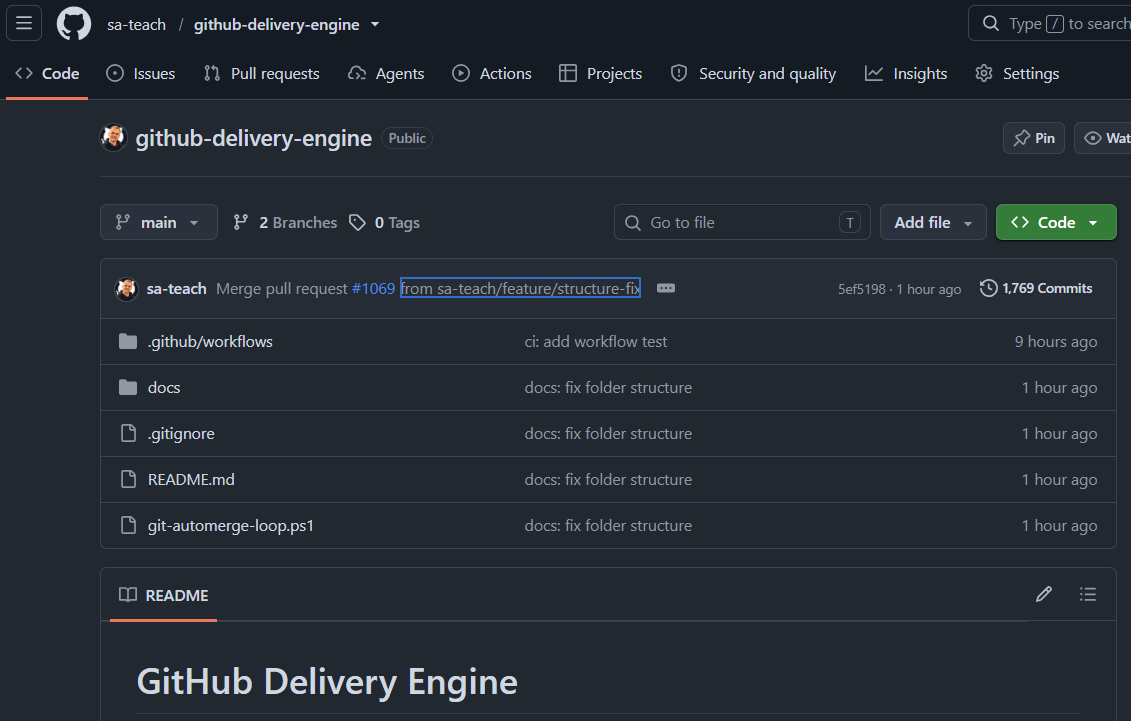
Репозиторий, на котором проводился эксперимент
Препятствие 1: интерактивный тупик GitHub CLI
Сначала скрипт создавал ветку, добавлял строчку в README.md, делал коммит и вызывал стандартный gh pr create --automerge. Логика была проста: GitHub сам поставит PR в очередь автомержа, а скрипт пойдет дальше.
Моя ошибка: в публичных репозиториях утилита gh по умолчанию интерактивна. Она замирала в фоне, пытаясь спросить терминал, куда слать PR, в основной репо или в форк. Скрипт не мог ответить, падал по таймауту, а локальные ветки стирали друг друга.
Ветки созданы
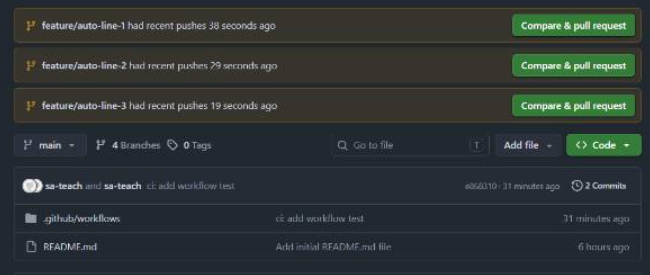
gh pr create по‑прежнему не создала ни одного PR. «Compare & pull request» есть, ветки залиты, а вкладка Pull requests вверху так и осталась пустойРешение: отключение интерактивности через жесткое указание целевых веток: gh pr create --head $branchName --base main.
Препятствие 2: война с облачными тестами
Первые PR
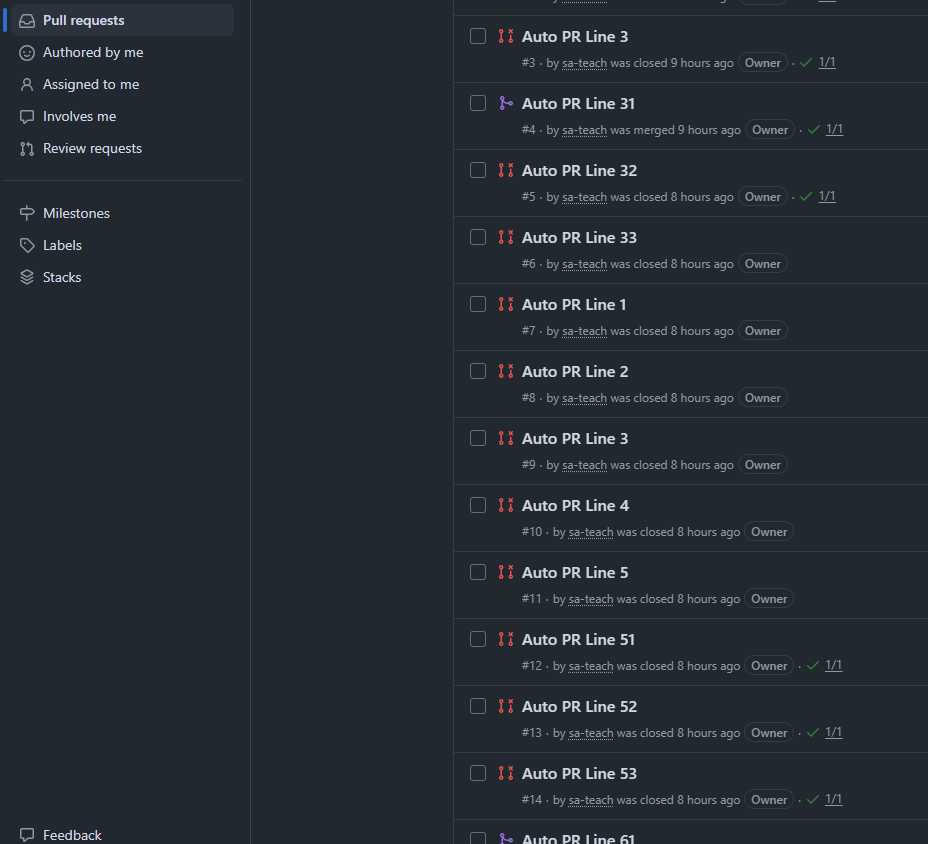
Чтобы автомерж на GitHub вообще стал активным, я настроил простенький GitHub Actions (CI‑тест на проверку содержимого README) и поставил защиту ветки main.
Вот тут‑то и началась вакханалия. Локальный скрипт штамповал ветки за секунды, переключался обратно на main, делал git pull и шел на новый круг. А GitHub Actions в облаке запускал виртуальную машину для теста около 20–30 секунд. Скрипт делал git pull, стягивал из облака старый, еще не проверенный тестами main, стирал локально предыдущую строчку и пушил кашу. GitHub сходил с ума от гонки версий, блокировал автомерж и выдавал грустную серую плашку: «Base branch was updated. Обновите ветку вручную». 10 веток вставали в глухой затор.
Конвейерный success!
Решение оказалось элегантным. Зачем прыгать назад на отстающий облачный main? Можно же строить ветки пайплайном локально! Каждая следующая ветка создавалась на базе предыдущей локальной ветки, унося с собой весь накопленный текст.
main
└── branch-1
└── branch-2
└── branch-3
└──...
└── branch‑N
И еще, как оказалось, для такой схемы категорически нельзя использовать --squash (он ломает линейную историю коммитов в облаке), поэтому я оставил только обычный --merge. Каждая новая ветка создавалась как продолжение предыдущей локальной ветки, что сохраняло совместимость изменений и исключало конфликты при последующем merge.
Великий запуск на 1000+ PR
Я выставил счётчик foreach($i in 86..1120),добавил паузу в 3 секунды, хотя вообще и не знаю, банит ли GitHub за такие DDoS‑ы, и нажал Enter.
Терминал
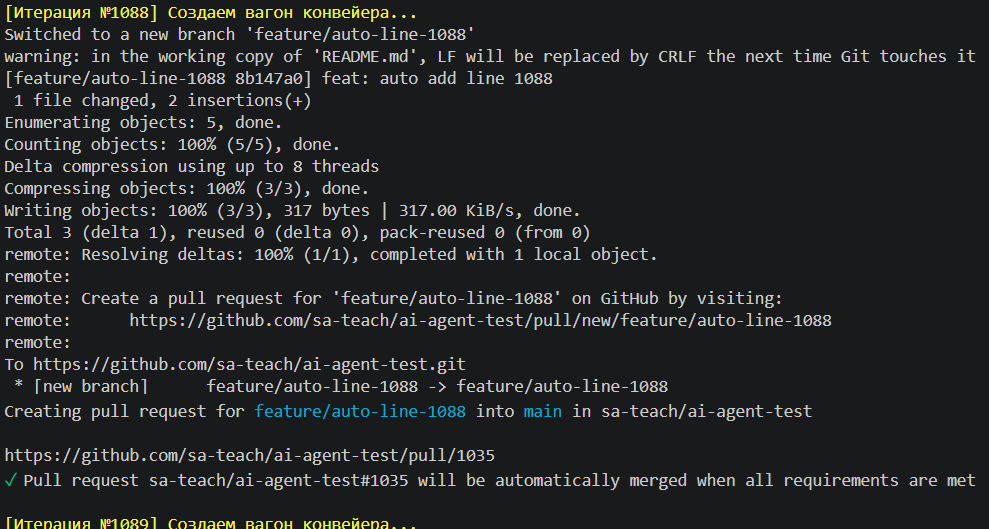
Локальный скрипт на ноутбуке и очередь тестов растянулись на 3+ часа. Облачные сервера Microsoft поочередно запускали контейнеры, проверяли файлы и автоматически схлопывали PR.
Actions
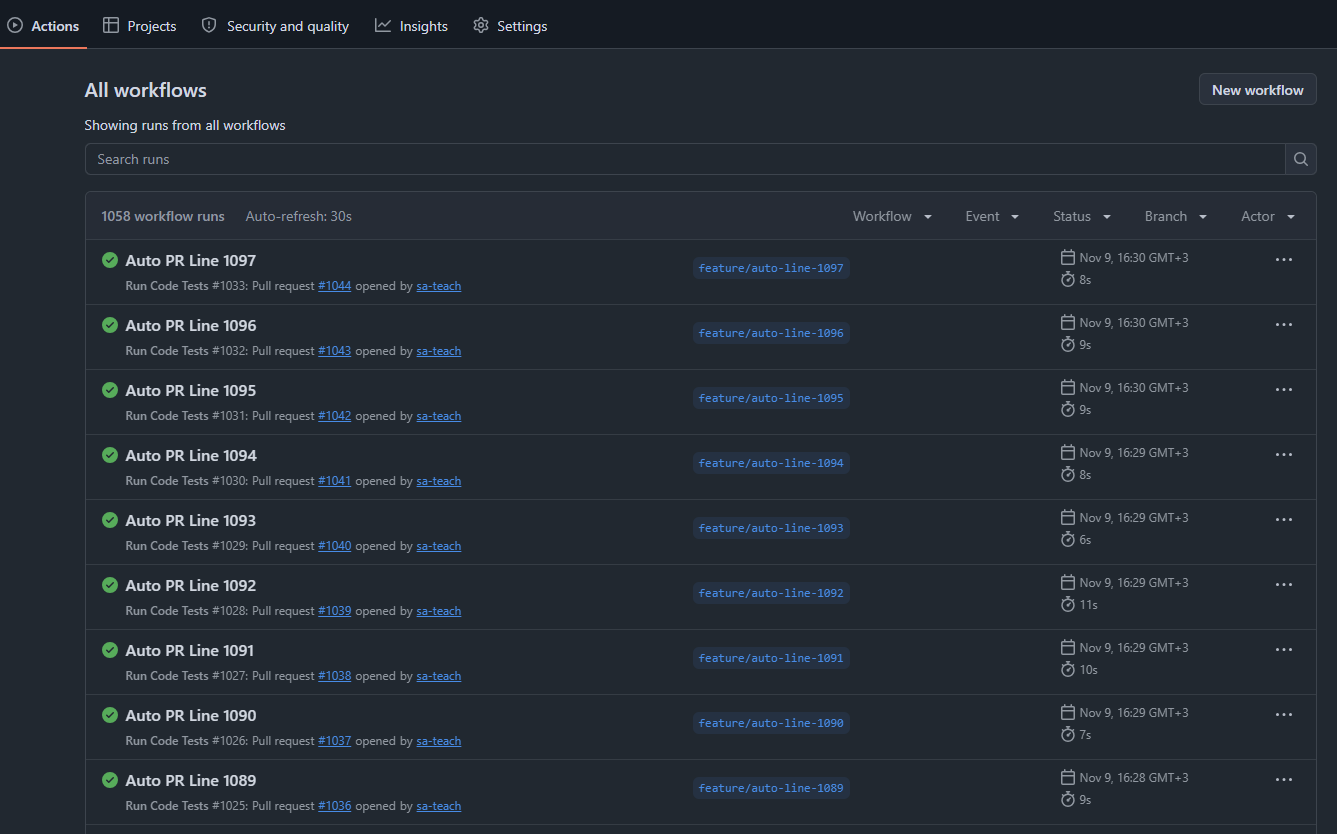
Итог стресс‑теста:
100% Success! Все 1000+ PR были успешно проверены и автоматически влиты в
main.Файл на GitHub вырос в ровный список из тысячи без пропусков.
Единственная ветка, не удалившаяся автоматически после merge, была
feature/auto-line-169. Точную причину установить не удалось. Возможные объяснения: временный сбой API, ошибка удаления ветки или сбой в цепочке автомержа.Одна ветка не удалилась автоматически
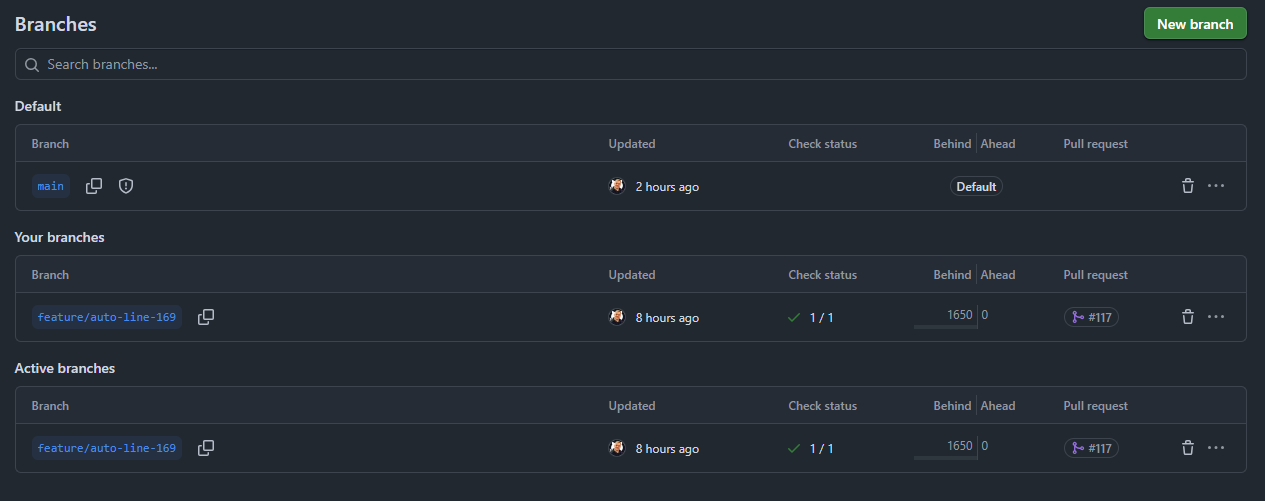
Единственный обнаруженный артефакт после обработки 1035 PR
Вывод
В рамках данного эксперимента GitHub без видимых проблем обработал более 1000 последовательных PR с обязательным CI и авто merge.
А самым неожиданным для меня результатом оказалось вовсе не прохождение 1035 PR подряд. Во время эксперимента стало понятно, что получившийся скрипт уже напоминает универсальный слой доставки изменений в GitHub: вместо строки в README он может принимать файлы, патчи или результаты работы ИИ‑агента, а дальше самостоятельно создавать ветки, коммиты, PR и включать авто merg. Поэтому эксперимент на этом не заканчивается. Следующий шаг — превратить этот конвеер в полноценный GitHub Delivery Engine и проверить, насколько далеко мне удастся зайти в такой автоматизации разработки.
