Обновить
32K+

Git *

Система управления версиями файлов

2,64
Рейтинг
Сначала показывать
Порог рейтинга
Уровень сложности

origin master или origin/master: как Git хранит ветки в обычном словаре «ключ — значение»

Время на прочтение5 мин
Охват и читатели6.8K

Почему в git fetch origin master пробел, а в git switch -c my-feature origin/master слеш? Алексей Кладов (matklad) много лет пользовался Git, представляя его контентно-адресуемой базой коммитов, и только недавно разглядел рядом с ней обычное изменяемое хранилище «ключ — значение» — ссылки в .git/refs. Разворачиваем сокращения fetch до полной формы refs/heads/master:refs/remotes/origin/master, разбираемся, зачем Git держит у себя копию чужих веток и почему git switch -c refs/heads/x создаёт refs/heads/refs/heads/x.

Читать далее

Новости

lsw: одна команда, чтобы увидеть все свои git worktree

Уровень сложностиПростой
Время на прочтение5 мин
Охват и читатели5.2K

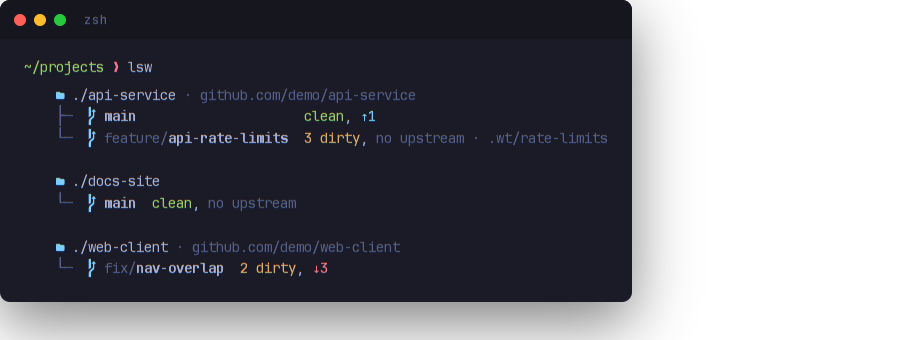
Если вы работаете в стиле «одна задача — свой worktree», у вас наверняка скопилась папка, где рядом лежат полдюжины чекаутов одного проекта. Я в какой-то момент устал бегать по ним с git status и написал lsw — это «ls» для worktree. Одна команда показывает все репозитории и worktree вокруг: ветку каждого, есть ли незакоммиченные правки, насколько ветка ушла от origin. Read-only, без зависимостей, один бинарник.

Читать далее

ИИ-ревью, или как я себя чуть не уволил

Уровень сложностиСредний
Время на прочтение16 мин
Охват и читатели6.5K

AI-ревьюер для GitLab, который проверяет не отдельный merge request, а всю задачу сразу, во всех сервисах, которые она задела. И почему для этого понадобился агент, а не анализ diff через API.

Читать далее

В вайбкодинге агент почти не читает документацию без ссылки: 57 файлов из 88 он не открыл ни разу

Уровень сложностиПростой
Время на прочтение5 мин
Охват и читатели9.5K

В вайбкодинге документацию первым читает агент, и открывает он почти только то, на что ему сослались. По журналам Claude Code одного моего проекта файлы без входящей ссылки агент открывал в среднем 1,2 раза, а 57 из 88 таких не открыл ни разу.

Раньше документацию писали в конце цикла, и читал её человек. В вайбкодинге код пишет агент, и получает он только то, что ему подали. Я посчитал по журналам за пять недель, какие markdown-файлы агент открывал. Точкой входа ниже называю то, чем агента запускают на задачу: файлы слеш-команд в .claude/commands и описания субагентов в .claude/agents. Документы, названные в точке входа, агент открывал в среднем 12,3 раза.

Читать далее

Централизованные хранилища скиллов (Skill registries)

Уровень сложностиСредний
Время на прочтение17 мин
Охват и читатели7K

Компании всё активнее пользуются AI‑агентами: Claude Code, Cursor, Codex, Copilot. Вместе с агентами появляются и «скиллы» — инструкции, которые учат агента работать по правилам конкретной компании. Через пару месяцев оказывается, что эти скиллы лежат в Google Docs, Notion, личных папках и десятке git‑репозиториев. У кого‑то версия свежая, у кого‑то устаревшая, а проверял ли их кто‑нибудь на безопасность, никто сказать не может.

В статье разберём, что такое централизованное хранилище скиллов, какие задачи оно решает, и сравним четыре подхода к его построению: от «просто git‑репозитория» до готового SaaS. Статья рассчитана не только на разработчиков: все термины объясняются по ходу, а для менеджеров, аналитиков и специалистов по ИБ есть словарик и раздел «как выбрать».

Читать далее

Claude Code сливает ключи в коммиты вдвое чаще среднего: почему хук PreToolUse их пропускает

Уровень сложностиСредний
Время на прочтение4 мин
Охват и читатели5.3K

Агент Claude Code ради одной цифры для статьи запустил платную серию запросов к ИИ-моделям, хотя правило в CLAUDE.md это прямо запрещало: в длинной сессии оно потерялось. Эта ошибка стоила только денег. Ключ в публичном коммите или выкладка без проверки обошлись бы дороже, и такие действия я проверяю хуками — кодом перед каждым вызовом инструмента.

Читать далее

Синхронизация Claude Code, месяц спустя: что ещё сломалось, когда машин стало две по-настоящему

Уровень сложностиСредний
Время на прочтение7 мин
Охват и читатели5.6K

Продолжение статьи о синхронизации Claude Code между машинами через git: пять новых граблей за месяц эксплуатации на двух реальных машинах — от веток в транскрипте сессий до секретов, которые чуть не стёрлись сами.

Читать далее

Заметки в своём GitHub без сервера: как я оживил BatNoter и написал синхронизацию на Git Data API

Уровень сложностиСредний
Время на прочтение8 мин
Охват и читатели6.7K

Мне давно нравится идея хранить заметки обычными Markdown-файлами в своём репозитории на GitHub. Файлы остаются твоими, их можно открыть на github.com или в любом редакторе, а история изменений достаётся даром: это просто коммиты.

Был проект BatNoter, который делал ровно это, но ему нужен был собственный сервер для входа через GitHub. В конце 2022 года сервер перестал отвечать, и приложение умерло.

Я переписал его так, чтобы сервер был не нужен вовсе. Получился Notewing: браузер сам ходит в GitHub API, изменения копятся офлайн и отправляются одним коммитом, а конфликтующие правки не теряются. В статье расскажу, как устроена синхронизация через Git Data API, где были подводные камни и как всё это тестировать, не трогая настоящий GitHub.

Как устроена синхронизация

Как мигрировать GitLab под рабочей нагрузкой из одного в десять Docker‑контейнеров

Уровень сложностиПростой
Время на прочтение29 мин
Охват и читатели9.3K

Привет! Меня зовут Илья, я занимаюсь автоматизацией разработки аппаратного обеспечения в YADRO. Эта статья будет посвящена масштабированию работающего в Docker контейнере под рабочей нагрузкой инстанса Gitlab. По мере роста команды производительности Gitlab, развернутого в одном Docker‑контейнере, становится мало. И масштабирование работающего под рабочей нагрузкой Gitlab, скажем, на десять контейнеров может стать нетривиальной задачей. Далее я на нашем примере расскажу, как это разумно организовать.

Читать далее

AI‑агент не увидел мой код: worktree, состояние задач и границы доступа в VECTA

Уровень сложностиСредний
Время на прочтение11 мин
Охват и читатели8.7K

Файлы проекта лежали на диске, но AI-агент получил пустую рабочую копию. Причина нашлась в Git: исходники ещё не были закоммичены, а worktree создавался из HEAD.

На примере VECTA разбираю, что приходится строить вокруг запуска coding agent: снимки текущих файлов, восстановление событий после обрыва связи, права доступа и проверку результата. Объясню, как управлять задачей с другого устройства, почему worktree не заменяет песочницу и чего нельзя обещать от лимита расходов.

Читать далее

Агентам выкатили патч. А git status в чужой папке до сих пор выполняет чужой код

Уровень сложностиСредний
Время на прочтение4 мин
Охват и читатели6.7K

Тебе присылают папку с репозиторием. Ты её открываешь, и на твоей машине выполняется чужой код. Ты не набрал ни одной команды.

Это GitSpawn: восемь находок в семи кодинг-агентах. Агентам уже выкатили патчи, и это почти ничего не меняет, потому что твой собственный git status в той же папке по-прежнему выполняет чужой код. Проверял руками на git 2.53.0 и Claude Code 2.1.271.

Читать далее

Не переписывая пайплайны: переезд с include на GitLab CI Components

Уровень сложностиСредний
Время на прочтение18 мин
Охват и читатели8.3K

Переезд с include на GitLab CI Components: у модуля появляется объявленный spec: inputs с типами и дефолтами, а опечатка в имени input роняет пайплайн до старта…

Как переезжали

Когда антибот притворяется РКН: ложные заглушки и локальный Web UI в rkn-block-checker 0.6.0

Уровень сложностиПростой
Время на прочтение3 мин
Охват и читатели11K

В прошлой статье я рассказывал о базовой концепции rkn-block-checker - маленькой CLI-утилиты, которая пытается не просто сказать “сайт не открывается”, а раскладывает сбой по слоям сетевого стека: DNS (отравление) -> TCP (блокировка по IP) -> TLS (DPI на SNI) -> HTTP (заглушка провайдера)

В теории схема выглядела стройной и красивой. На тестах всё работало как часы. Но когда инструмент попал на реальные машины пользователей, произошли нюансы.

Ниже разбор интересного бага с WAF, который заставил переписать логику вердиктов, и рассказ о том, как сделать локальный Web UI со стримингом на чистом Python без единой сторонней зависимости.

Читать далее

Ближайшие события

Реестр контейнеров, который живёт внутри ячеек электронной таблицы

Время на прочтение4 мин
Охват и читатели8.8K

Привет, Хабр! Значю, что вам на это плевать и вы не хотите это читать, но я все равно продолжу это писать:) В общем, Sheet-Native Computing Foundation продолжает цвести и пахнуть и у нас даже есть сторонние контрибьюторы. А чего добились вы?

Итак, вот что теперь можно сделать в таблице: запушить в неё настоящий OCI-образ контейнера и вытянуть его обратно. Не ссылку на образ, не метаданные о нём — сами слои, хранящиеся как base64 по ячейкам, с адресацией по sha256, собирающиеся байт-в-байт на выходе. У SheetHub — нашего форжа в стиле GitLab, который работает на Google-таблице — появился реестр контейнеров, и он целиком живёт в ячейках.

Этот пост — про то, как это всё устроено.

Читать далее

Свой git без gitlab‑комбайна: настраиваем gitea, подключаем ci и проверяем полное восстановление

Уровень сложностиПростой
Время на прочтение12 мин
Охват и читатели15K

Как завести свой Git на небольшом VPS и не превратить его обслуживание в отдельный проект? Показываю свой путь с Gitea: настройку пользователей и SSH, перенос репозиториев из GitHub и подключение CI через Gitea Actions. А затем проверяю бэкап делом - восстанавливаю из внешней копии. С командами, ошибками и оговорками по безопасности - для личных проектов и небольших команд.

Читать далее

Вы удалили ключ следующим коммитом. Из репозитория он никуда не делся

Уровень сложностиСредний
Время на прочтение3 мин
Охват и читатели5.8K

Секрет попадает в репозиторий почти всегда одинаково. Разработчик случайно коммитит файл с ключом доступа, замечает это, удаляет файл, делает коммит «убрал лишнее» и выдыхает.

Ключ при этом остаётся на месте: он лежит в объектах истории и достаётся одной командой. У всех, кто успел склонировать, — тоже.

Читать далее

Вы точно знаете, что когда-то попадало в ваш Git? Ищем и удаляем секреты из истории

Уровень сложностиСредний
Время на прочтение7 мин
Охват и читатели6.9K

Случалось ли вам добавлять в Git что-нибудь по ошибке? Если это было что-то вроде функции для дебага, некорректного комментария или случайно скопированного файла, то можно это исправить следующим коммитом. Но сработает ли такое исправление, если вы (или ваш коллега) случайно добавили в репозиторий какой-нибудь секрет? Ключ от стороннего сервиса, логин/пароль от интеграции или даже дамп базы данных или всю папку /private/uploads? На первый взгляд - да, сработает, можно сделать новый коммит и удалить то, что было добавлено по ошибке. Но дело в том, что эти данные все равно останутся в репозитории. По истории коммитов можно вернуться назад во времени (до исправления) и увидеть данные, которых уже нет в последней версии репозитория.

Как же исправить? Читать далее

Работа с файлами Git: от самого простого к сложному

Уровень сложностиСложный
Время на прочтение14 мин
Охват и читатели10K

Всем привет!

Почти каждый, кто работал с Git больше пары недель, хоть раз сталкивался с одной и той же путаницей: почему git add — это не сохранение, зачем нужен какой‑то отдельный индекс, если есть коммит, откуда вообще берутся конфликты при мерже, если мы просто оба поправили один файл. И почему иногда git status показывает файл как изменённый, хотя вы точно ничего не трогали.

Если вы так же знакомы с этими проблемами, а также с другими проблемами при работе с Git — эта статья для вас.

В этой статье cначала покажем, как Git на самом деле хранит файлы и их изменения, что такое индекс и почему он существует отдельно от рабочей директории и коммитов. Далее — как устроены ветки на уровне данных, а не только как указатель текущей линии разработки. После этого разберём, как Git определяет, какие именно строки поменялись, и как из этого механизма следует слияние т.е merge и, самое главное, конфликты при слиянии.

Изучив модель, пройдёмся по основным командам работы с файлами: add, rm, mv, restore, diff, log, stash, работу с .gitignore и с большими файлами.

А в конце мы вам покажем, как это всё применяется на практике.

Читать далее

Одна сессия Claude Code на нескольких машинах: что ломается, если просто синхронизировать папку

Уровень сложностиСредний
Время на прочтение9 мин
Охват и читатели9.3K

Разговор с Claude Code остаётся на той машине, где начат. Разбираю, почему облачная папка эту задачу не решает, и шесть граблей, на которые я наступил, пока делал перенос сессий, памяти и инструментов между Linux, Windows и macOS.

Читать далее

Рефакторинг моего Obsidian: как я перестроил хранилище после предыдущей статьи

Время на прочтение17 мин
Охват и читатели11K

Какое-то время назад я выкладывал статью на Хабр про свое obsidian хранилище.

Я получил хороший фидбэк и некоторые идеи. Также я понял, что довольно большая часть моего obsidian нуждается в оптимизации и структуризации. В итоге нашел свободный выходной, чтобы немного перестроить хранилище. Я все это сделал и тут расскажу, как теперь выглядит мой obsidian.

Кроме простой структуризации и удаления лишнего, я также провел некоторые махинации над кодом dataviewjs своей библиотеки книг и доделал свою домашнюю страницу, добавив интеграцию со своей основной библиотекой и поработав на css составляющей. В общем-то были еще некоторые изменения, но об этом всем будет далее.

Читать далее
1
23 ...