Еще лет пять назад графические ускорители в стойке выглядели как экзотика и весьма специфическое решение для узкого круга задач вроде тяжелого рендеринга или специфических научных расчетов. Теперь же с их помощью успешно решают задачи локального обучения нейросетей, аналитики видео и развертывания мощных виртуальных рабочих мест.
Однако физический GPU спроектирован как монолитное устройство для параллельных вычислений. В отличие от процессора и оперативной памяти, его нельзя просто так «нарезать» на части стандартными программными методами гипервизора. Из-за этого видеокарту сложно использовать эффективно — если отдать ее целиком одной ВМ под небольшую задачу, остальная часть ресурсов может простаивать, а распределить свободные мощности между соседними виртуальными машинами без специальных технологий не получится.
Чтобы решить эту проблему, инженерам приходится выбирать между двумя принципиально разными подходами — GPU Passthrough и vGPU. Ниже мы подробно разберем, как устроены эти технологии, в чем их реальные различия и что выбрать под конкретные сценарии и типы нагрузок.
GPU Passthrough — прямой проброс как мощный, но дорогой путь
Самый очевидный способ отдать графическую мощность в виртуальное окружение — использовать режим прямого проброса — GPU Passthrough. На технологическом уровне гипервизор просто «отключает» физический ускоритель от хостовой системы и через механизмы IOMMU пробрасывает устройство шины PCIe напрямую внутрь конкретной виртуальной машины. Гостевая ОС видит карту точно так же, как если бы она была вставлена в обычный системный блок, и при работе с ней используются стандартные драйверы.
С точки зрения производительности такой подход действительно вне конкуренции. Отсутствие промежуточных абстракций и эмуляции позволяет гостевой системе задействовать всю вычислительную мощность чипа, весь доступный объем VRAM и узкоспециализированные блоки вроде тензорных или RT-ядер. Именно поэтому прямой проброс остается стандартом для действительно тяжелых задач — обучения крупных языковых моделей, финального 3D-рендеринга или выполнения сложных научных вычислений.
Обратная сторона прямого проброса — низкий уровень гибкости и высокая итоговая стоимость. Закрепляя ускоритель за одной ВМ, вы фактически объявляете монополию на этот ресурс. Но есть и альтернативное решение.
vGPU — режем на кусочки
Когда задачи не требуют монопольного доступа к вычислительным блокам, логично не выделять целую видеокарту под одну виртуальную машину, а делить ее мощности. И тут нам поможет другая технология — vGPU. В отличие от прямого проброса этот подход позволяет нарезать один физический ускоритель на несколько виртуальных профилей и распределить их между разными гостевыми системами.
В этом случае на хостовую систему устанавливается специализированный менеджер и драйвер, которые взаимодействуют с аппаратными механизмами самой видеокарты. Видеопамять при этом нарезается между виртуальными машинами строго фиксированными блоками, что исключает ситуацию, когда одна ВМ забирает чужую память. Доступ же к вычислительным ядрам регулируется планировщиком на уровне GPU — планировщик поочередно выделяет кванты времени каждой гостевой системе.
Поэтому гостевая ОС считает, что работает с полноценным (хоть и менее мощным, чем он есть на самом деле) графическим адаптером. Что это дает:
Повышение плотности размещения. На одной физической карте можно запустить 4, 8, 16 или более виртуальных машин — в зависимости от объема VRAM и требований конкретного профиля.
Гибкое профилирование под задачи. Для рабочих мест инженеров в CAD-системах можно выделить профили с увеличенным объемом видеопамяти, а для типовых инференс-микросервисов — более скромные конфигурации.
Выигрыш здесь абсолютно понятен — если проброшенная целиком карта при нерегулярных нагрузках большую часть времени будет просто стоять, то разделенный через vGPU чип работает с высокой суммарной эффективностью. Это сделало vGPU стандартом для инфраструктур VDI и развертывания легких нейросетевых сервисов, где оплачивать отдельный физический чип под каждый инстанс просто нецелесообразно.
Как выбрать технологию под свой сценарий
При выборе между прямым пробросом и виртуализацией логичнее всего исходить из приоритетов. Что именно вам нужно — высокий уровень производительности или утилизация дорогостоящего железа?
Когда брать GPU Passthrough:
Обучение крупных нейросетей (LLM, Generative AI). Требует непрерывной загрузки тензорных ядер и постоянного обмена гигабайтами данных между RAM и VRAM.
Тяжелые расчеты (HPC). Моделирование гидродинамики, прочности или геофизики, как правило, требует длительных непрерывных вычислений. Прямой проброс гарантирует, что задача получит 100% ресурсов чипа без задержек на переключение между виртуальными машинами.
Высоконагруженная видеоаналитика. Если нужна обработка множества параллельных видеопотоков высокой четкости в реальном времени, выбирают GPU Passthrough.
Облачный гейминг. Если необходимо, чтобы каждый игровой инстанс работал на выделенной видеокарте — для плавного геймплея.
Удаленные рабочие места (VDI) с графическим ускорением. Если нужно обеспечить специалистов высокопроизводительными рабочими станциями (актуально для инженеров, архитекторов и дизайнеров). GPU Passthrough обеспечивает им удаленный доступ к ресурсоемким приложениям без необходимости использовать мощные локальные ПК.
Когда оправдан vGPU:
Инфраструктура виртуальных рабочих столов (VDI). Когда нужно производительное виртуальное рабочее место, где не требуются все ресурсы ускорителя, например, массовый корпоративный VDI или организация виртуальных рабочих столов для стандартных инженерных задач. Для подобных сценариев можно нарезать одну производительную карту, получив высокую плотность размещения пользователей и экономию на железе.
Микросервисный инференс со средней нагрузкой. Если сервис используется периодически (например, для распознавания документов или транскрибаций), выделять под него целую видеокарту нерационально. vGPU изолирует виртуальные машины на уровне видеопамяти, что гарантирует стабильную работу инференса и защищает соседние сервисы от падения по ошибке OOM.
Разработка и Data Science. Разработчикам vGPU подойдет для решения задач, где важна масштабируемость и эффективное использование вычислительных ресурсов — машинное обучение, рендеринг, тестирование и разработка ПО, игр и других сценариев.
Продажа ресурсов GPU. Хостинг-провайдерам vGPU позволяет расширить портфель услуг и экономить — они могут предлагать клиентам доступ к GPU-ресурсам без необходимости выделения отдельных видеокарт, что значительно снижает капитальные затраты на инфраструктуру.
Исследования и диагностика. vGPU позволяет развертывать виртуальные лаборатории с доступом к GPU для диагностики и исследований. Пользователи получают мощные графические ресурсы без необходимости оснащать каждое рабочее место отдельной видеокартой.
Параметр | GPU Passthrough | vGPU |
Эффективность утилизации железа | Может быть низкой — карта залочена за одной ВМ, даже если процессор простаивает. | Высокая. Один физический ускоритель параллельно обслуживает десятки ВМ. |
Накладные расходы (Overhead) | Очень низкие. Производительность идентична работе на голом железе. | Несколько процентов в зависимости от профиля, характера нагрузки и плотности ВМ. |
Лицензионная нагрузка | Для GPU Passthrough достаточно стандартных драйверов. | Обязательна лицензия NVIDIA GRID — без нее возможны ограничения в распределении ресурсов GPU. |
Целевые нагрузки | Обучение LLM, масштабный HPC-расчет, 24/7 обработка видеопотоков. | VDI для инженеров, R&D-лаборатории, отладка ML, периодический инференс. |
GPU Passthrough и vGPU в VMmanager
Наша платформа VMmanager поддерживает обе технологии. GPU Passthrough используется для максимальной производительности, а vGPU — для повышения плотности ВМ и эффективного распределения ресурсов.
При работе в режиме прямого проброса платформа сама находит установленные в серверы ускорители и берет на себя изоляцию PCI-устройств через vfio-pci. Администратору не нужно вручную править параметры загрузчика гипервизора или отслеживать адреса на шине. Работа с графическими ускорителями происходит через удобный интерфейс VMmanager. Администратор может назначить графический ускоритель виртуальной машине прямо в панели управления. Доступны конфигурации с одним или несколькими GPU, а также настройка по шаблону.
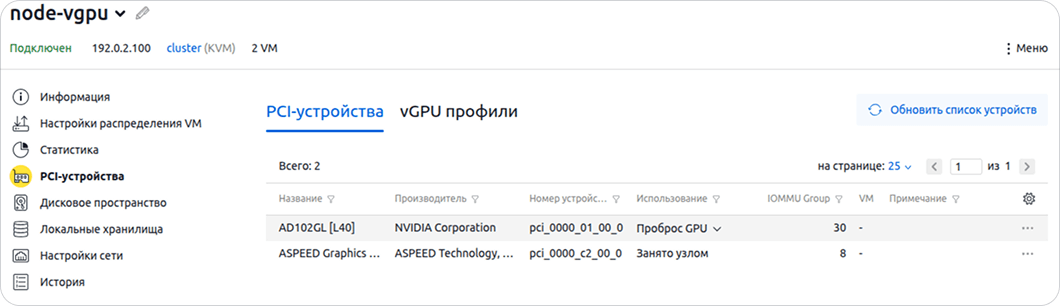
С конфигурированием vGPU процесс выглядит аналогично. После установки необходимых драйверов NVIDIA vGPU Manager и системной утилиты mdevctl на ноды кластера платформа позволяет разметить физические чипы на стандартные профили прямо из панели управления.
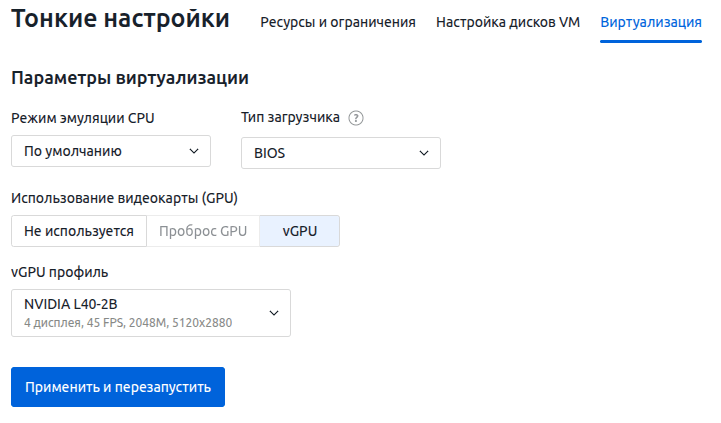
Больше деталей о том, как это работает в VMmanager, — в нашей документации: