При обновлении приложения через Docker Compose старый контейнер останавливается, новый запускается. Между этими событиями может появиться окно, когда приложение недоступно.
Обычно предлагается два решения: добавить healthcheck или перейти на blue-green deployment. И тут мне стало интересно, насколько они действительно помогают, если запросы идут непрерывно.
Для проверки я собрал лабораторию с Caddy, двумя версиями небольшого HTTP-приложения и генератором нагрузки. Сравнил три способа обновления: обычное пересоздание контейнера, пересоздание с healthcheck и --wait, а также blue-green.
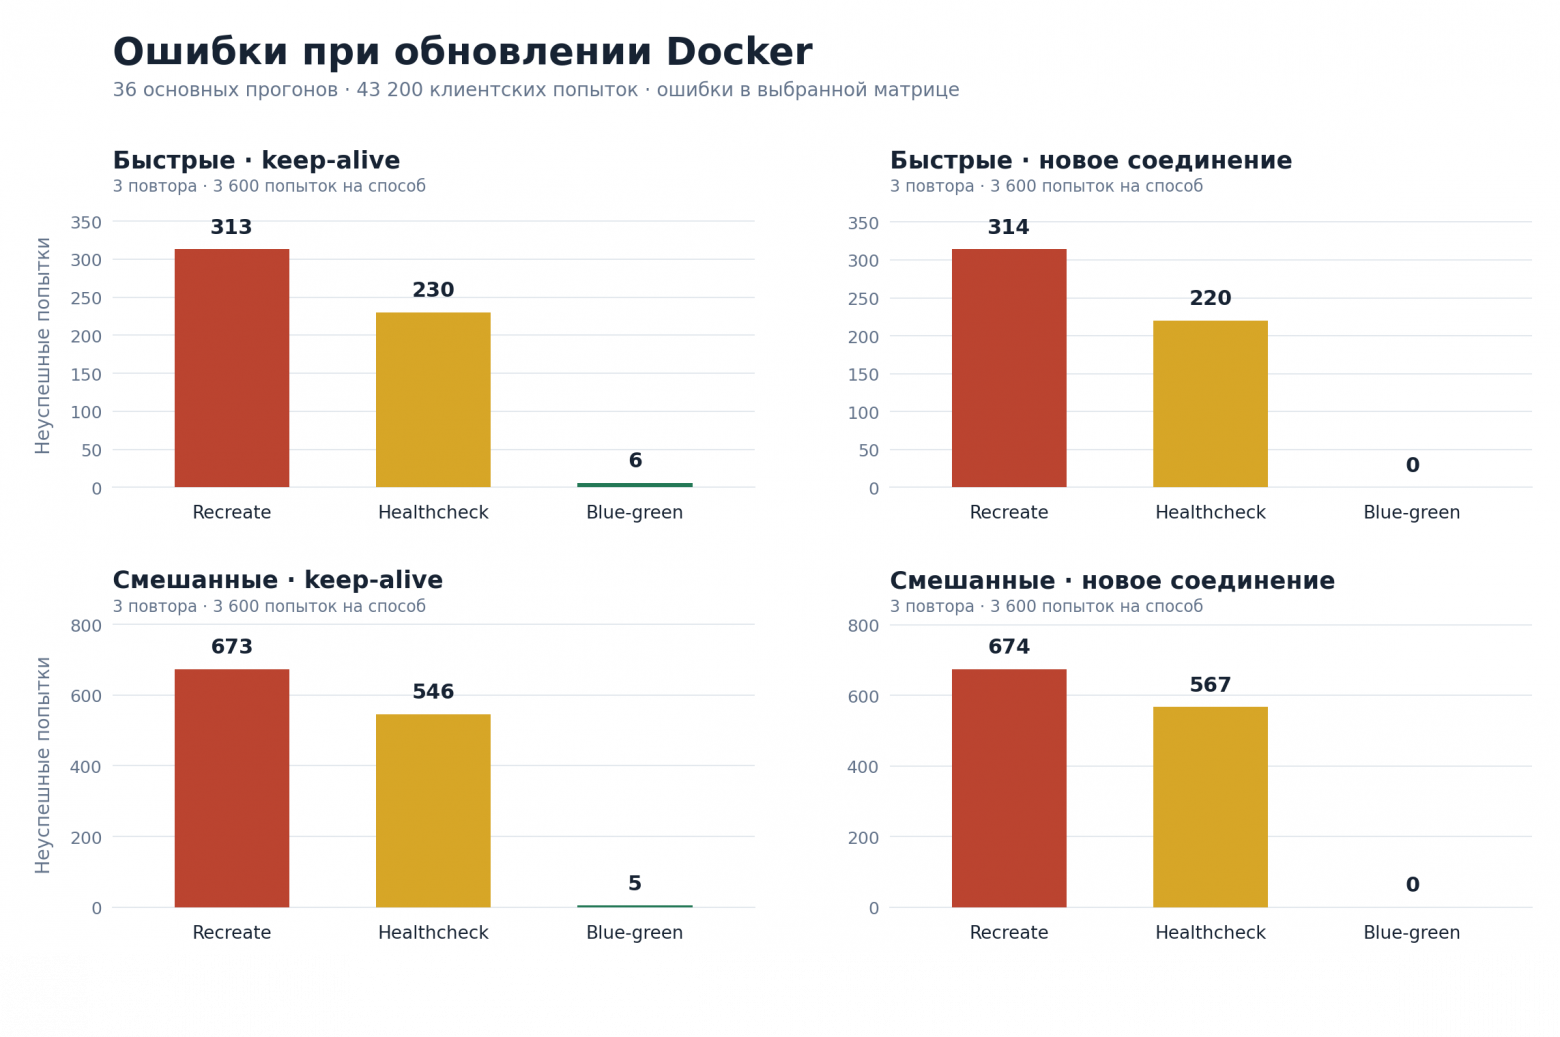
Всего получилось 36 основных прогонов и 43 200 клиентских запросов.
Blue-green показал лучший результат: ни одного HTTP 502 или 503 на 14 400 попыток. Но 11 запросов всё равно завершились транспортной ошибкой.
Что тестировал
Лаборатория состоит из Caddy и HTTP/1.1-приложения на Python. У приложения две версии: v1 и v2, каждая собрана в отдельный Docker-образ.
После запуска приложение три секунды находится в состоянии not_ready: порт уже слушается, но рабочие запросы получают HTTP 503.
При SIGTERM сервер перестаёт принимать новую работу и ожидает завершения ранее принятых запросов до 12 секунд. Docker Compose предоставляет ему 15 секунд на остановку.
В ответах возвращаются версия приложения, путь и request ID. Генератор проверяет не только HTTP-статус, но и полноту тела, согласованность версии в заголовке и JSON, а также идентификатор запроса.
Это важно: если клиент получил заголовок 200 OK, а затем соединение оборвалось, считать такой запрос успешным нельзя.
Все контейнеры работают во внутренней Docker-сети. У каждого прогона отдельный Compose.
Три способа обновления
1. Обычный recreate
Есть один backend app. Его образ меняется с v1 на v2 через docker compose up -d --no-deps.
Caddy продолжает работать, но во время пересоздания контейнера у него нет резервного приложения.
2. Healthcheck + --wait
Схема такая же, только у контейнера есть Docker healthcheck, а обновление выполняется с --wait.
Healthcheck проверяет /health раз в секунду. Compose ожидает перехода контейнера в состояние running или healthy.
При этом Caddy не читает состояние Docker healthcheck. Для него upstream по-прежнему один. Даже если Compose ещё ожидает готовности, запросы через proxy уже могут поступать на новый контейнер.
3. Blue-green
Здесь одновременно существуют два backend.
Пока Caddy отправляет запросы на blue/v1, запускается green/v2. Контроллер проверяет готовность новой версии, меняет upstream в конфигурации Caddy и выполняет caddy reload.
Затем проверяет ответ v2, дожидается завершения активной работы на blue и только после этого останавливает старый контейнер.
Контейнер Caddy не пересоздаётся. Это дополнительно проверялось по его ID, времени запуска и счётчику перезапусков.
Новые запросы переключаются на другую версию, а уже выполняющиеся запросы к старому backend не обязательно обрываются.
Как проводил измерения
Параметр | Значение |
|---|---|
Частота запросов | 20 в секунду |
Продолжительность | 60 секунд |
Попыток за прогон | 1 200 |
Максимум одновременно выполняющихся | 20 |
Начало обновления | Около 20-й секунды |
Повторений каждого сочетания | 3 |
Было два профиля нагрузки:
fast- только быстрые запросы;mixed- 90% быстрых запросов и 10% запросов с трёхсекундной задержкой.
Эти режимы касались участка клиент → Caddy. Соединения между Caddy и приложением могли переиспользоваться во всех тестах.
Получилось 3 способа обновления × 2 профиля × 2 режима соединений × 3 повторения × 1 200 запросов = 43 200 попыток.
Тесты проходили на общем хосте: Ubuntu 24.04., arch64, 3 CPU, 3,81 GiB RAM. Использовались Docker 29.9.2, Compose 5.6.1 и Caddy 2.11.9.
Для backend установлен лимит 0,35 CPU и 128 MiB RAM. Приложение, задержки и нагрузка синтетические - это проверка механики обновления, а не производительности реального сервиса.
Результаты
Способ | Попытки | Корректные 200 | HTTP 502 | HTTP 503 | Транспорт |
|---|---|---|---|---|---|
Recreate | 14 400 | 12 426 | 1 246 | 728 | 0 |
Healthcheck + | 14 400 | 12 837 | 826 | 736 | 1 |
Blue-green | 14 400 | 14 389 | 0 | 0 | 11 |
Неуспешных запросов получилось:
Recreate - 1 974 (13,71%).
Healthcheck +
--wait— 1 563 (10,85%).Blue-green - 11 (0,076%).
Здесь учитываются только полностью полученные корректные HTTP 200. Частично полученный ответ относится к транспортной ошибке.
Почему healthcheck не спас
При обычном пересоздании встречались два характерных случая.
Первый - Caddy пытался соединиться с backend, которого в этот момент уже не было:
dial tcp 172.19.0.2:8080: connect: connection refused
Второй - новый контейнер уже принимал соединения, но ещё не был готов:
{
  "event": "request_rejected",
  "version": "v2",
  "request_id": "load-419",
  "path": "/",
  "reason": "not_ready"
}
Вариант с healthcheck и --wait дал меньше ошибок, но полностью их не устранил.
Причина понятна из архитектуры: --wait влияет на то, когда завершится команда Compose. Он не создаёт резервный backend и не запрещает Caddy отправлять запросы на ещё не готовое приложение.
В своей лаборатории я отдельно проверил healthcheck без --wait и --wait без healthcheck. Но эти контрольные сочетания выполнялись только по одному разу. Поэтому утверждать, что наблюдаемое уменьшение ошибок вызвано исключительно healthcheck, было бы неправильно.
Вывод: в протестированной конфигурации healthcheck и --wait не обеспечили непрерывную доступность единственного backend.
Blue-green: откуда взялись 11 ошибок
При blue-green не было ни одного полностью полученного ответа HTTP 502 или 503.
Режим | Корректных 200 | Транспортные ошибки |
|---|---|---|
Fresh | 7 200 / 7 200 | 0 |
Keep-alive | 7 189 / 7 200 | 11 |
Все 11 ошибок имели одинаковый тип:
RemoteDisconnected:
Remote end closed connection without response
В данных этих запросов также присутствовал признак:
connection_reused: true
То есть клиент пытался отправить очередной запрос через уже существовавшее соединение.
Например, в прогоне 02-blue-green-fast-keepalive-r1 две такие ошибки возникли приблизительно через 0,206 и 0,305 секунды после начала команды caddy reload.
При этом сам контейнер Caddy не перезапускался.
Что происходит с соединениями при reload
В отдельной функциональной проверке воспроизвелась следующая последовательность:
Клиент отправил запрос и получил корректный ответ от
v1.Соединение осталось открытым.
Контроллер выполнил
caddy reload.Следующий запрос через прежнее простаивающее соединение завершился
RemoteDisconnected.Новый запрос через новое соединение получил корректный ответ от
v2.
То есть сохранение процесса Caddy ещё не означает сохранения каждого клиентского соединения.
А что с запросами, которые уже выполнялись?
Отдельно я проверялся шестисекундный /slow.
17:37:36.092 request_start
version=v1
request_id=diagnostic-slow
attempt_id=528

17:37:42.093 request_end
version=v1
request_id=diagnostic-slow
attempt_id=528
delivered=true
Между этими событиями прошёл reload Caddy. Клиент получил полный HTTP 200 от старой версии.
Аналогичная проверка при SIGTERM показала, что уже принятый шестисекундный запрос завершился корректно, несмотря на начавшуюся остановку backend.
Способ | Корректные ответы |
|---|---|
Recreate | 586 / 720 |
Healthcheck + | 609 / 720 |
Blue-green | 719 / 720 |
Единственная неуспешная попытка /slow при blue-green тоже была транспортной ошибкой на переиспользуемом клиентском соединении.
Здесь нужно различать две ситуации: сохранение активного запроса и сохранение простаивающего соединения для следующего запроса.
Одна ошибка, которую легко посчитать неправильно
В серии healthcheck обнаружился ещё один любопытный случай.
Запрос load-403 получил заголовки HTTP 503 от v1, после чего соединение оборвалось:
IncompleteRead: IncompleteRead(0 bytes read, 72 more expected)
То есть сервер объявил длину тела 72 байта, но клиент не получил ни одного.
В логах backend есть request_rejected с причиной draining, а у Caddy — сообщение aborting with incomplete response.
Запрос поступил уже после начала SIGTERM. Вероятно, процесс завершился во время отправки отказа.
Что в итоге
Обычное пересоздание контейнера в этом тесте приводило к заметному количеству ошибок. Добавление healthcheck и --wait улучшило наблюдаемый результат, но не решило проблему отсутствия резервного backend.
Blue-green позволил подготовить новую версию до переключения и сохранить уже выполнявшиеся запросы старой версии.
При этом 11 клиентских попыток завершились транспортными ошибками - несмотря на отсутствие HTTP 502 и 503.
Для меня главный результат эксперимента не столько в преимуществе blue-green, сколько в различии между двумя формулировками:
«Proxy не вернул ни одного 502» и «все клиентские запросы завершились успешно».