

Мы строим учебные лаборатории на настоящих продуктах экосистемы автономной кибербезопасности BI.ZONE. Каждый участник получает собственный изолированный стенд, который собирается с нуля за 5–7 минут, а выполнение заданий проверяет код. Рассказываем, как это устроено, от чего мы отказались и на какие грабли наступили.
Какая задача перед нами стояла
BI.ZONE Education учит специалистов работать с продуктами BI.ZONE. К нынешнему формату обучения мы пришли не сразу и пробовали разные подходы. В итоге выбрали онлайн-формат: участник проходит курс в LMS — системе управления обучением. От обучения мы хотели двух результатов. Во-первых, после курса участник должен уметь выполнить то же действие в рабочей консоли своей компании. Во-вторых, мы должны иметь возможность проверить, что он это умеет.
В онлайн-формате стало понятно, что теории и демонстраций недостаточно: участник видит продукт, но сам в нем не работает. Нужно больше практики. Сначала мы выстраивали практическую часть вручную: выполнение заданий проверяли сами и привлекали к этому SRE-инженеров. Пока участников было немного, это работало. С ростом нагрузки такой подход перестал работать: когда в группе двадцать человек, а продукт состоит из десятков контейнеров, на ручную подготовку и ручную проверку не хватает ни времени, ни людей.
Поэтому задачу мы сформулировали так: построить платформу, которая сама собирает для участника стенд, то есть набор виртуальных машин с настоящим продуктом, и сама проверяет, что участник в нем сделал. Из этой формулировки следуют три решения, которые определяют устройство платформы: отдельный стенд на каждого участника, настоящий продукт вместо симулятора и проверка результата кодом.
Дальше мы покажем на одном задании, почему без этих решений не обойтись. Затем разберем, как устроена платформа, от каких вариантов мы отказались и какая история граблей изменила наше понимание готовности стенда.
Пример: как проверить, что хост действительно изолирован
Допустим, в задании написано: «Изолируйте зараженный хост в EDR». Как убедиться, что участник действительно выполнил это действие на своем стенде?
Он мог нажать похожую кнопку в симуляторе или вообще в другой консоли. Тренер может проверить это на экране, но в группе из двадцати человек это займет слишком много времени. Поэтому нужна автоматическая проверка, которая определит, изменилось ли состояние стенда так, как требуется в задании, или нет.
Как устроена такая проверка и из каких компонентов состоит учебная лаборатория? Это первая статья серии о платформе BI.ZONE Education. В ней мы описываем общее устройство наших курсов: из чего состоит лаба, что происходит между нажатием кнопки и первым заданием, как работают проверки и зачем нужна роль тренера. Отдельные компоненты платформы разберем в следующих статьях. Текст пригодится тем, кто строит учебные стенды, киберполигоны и CI-окружения, а еще руководителям SOC и обучения, которые выбирают между симулятором и реальным продуктом.
Как работает платформа
Платформа выдает участнику учебную лабораторию, или лабу: набор виртуальных машин с настоящими продуктами BI.ZONE, сценарий из заданий и автоматическую проверку. В лабах работают BI.ZONE EDR, BI.ZONE PAM, BI.ZONE Mail Security, BI.ZONE SD-WAN и BI.ZONE ZTNA. Продукт в лабе настоящий, данные в нем подготовлены заранее.
Мы исходили из таких требований:
у каждого участника должен быть собственный стенд, чтобы чужие действия не ломали его задание;
задания должны выполняться в настоящем продукте, чтобы участник мог сразу применять полученный навык в рабочей консоли;
код должен автоматически проверять результат выполнения задания;
тренер должен управлять группой и отслеживать прогресс участников, а не вручную обслуживать стенды.
В таком порядке мы и построили рассказ. Сначала пройдем путь от кнопки запуска до первого задания и посмотрим, как участник получает собственный стенд. Затем разберем сценарий, в котором описаны задания и проверки, а также варианты, от которых мы отказались. После этого покажем, как работает автопроверка и что остается тренеру.
Путь от кнопки до задания
Участник заходит на портал и нажимает кнопку запуска. Дальше запрос проходит по цепочке компонентов.
Портал принимает запрос, проверяет права и создает запись о назначении.
Оркестратор, то есть API платформы, ставит в очередь задания на провижининг. Его воркеры разбирают очередь, повторяют неудавшиеся шаги и следят, чтобы два воркера не работали с одним стендом одновременно.
Облачный слой создает машины из образов и собирает для участника отдельную изолированную сеть.
Сценарный движок выполняет setup: раскладывает по машинам данные и настройки, которые нужны этой лабе.
Участник получает веб-консоль к своим машинам и начинает работать, а портал показывает прогресс по заданиям.
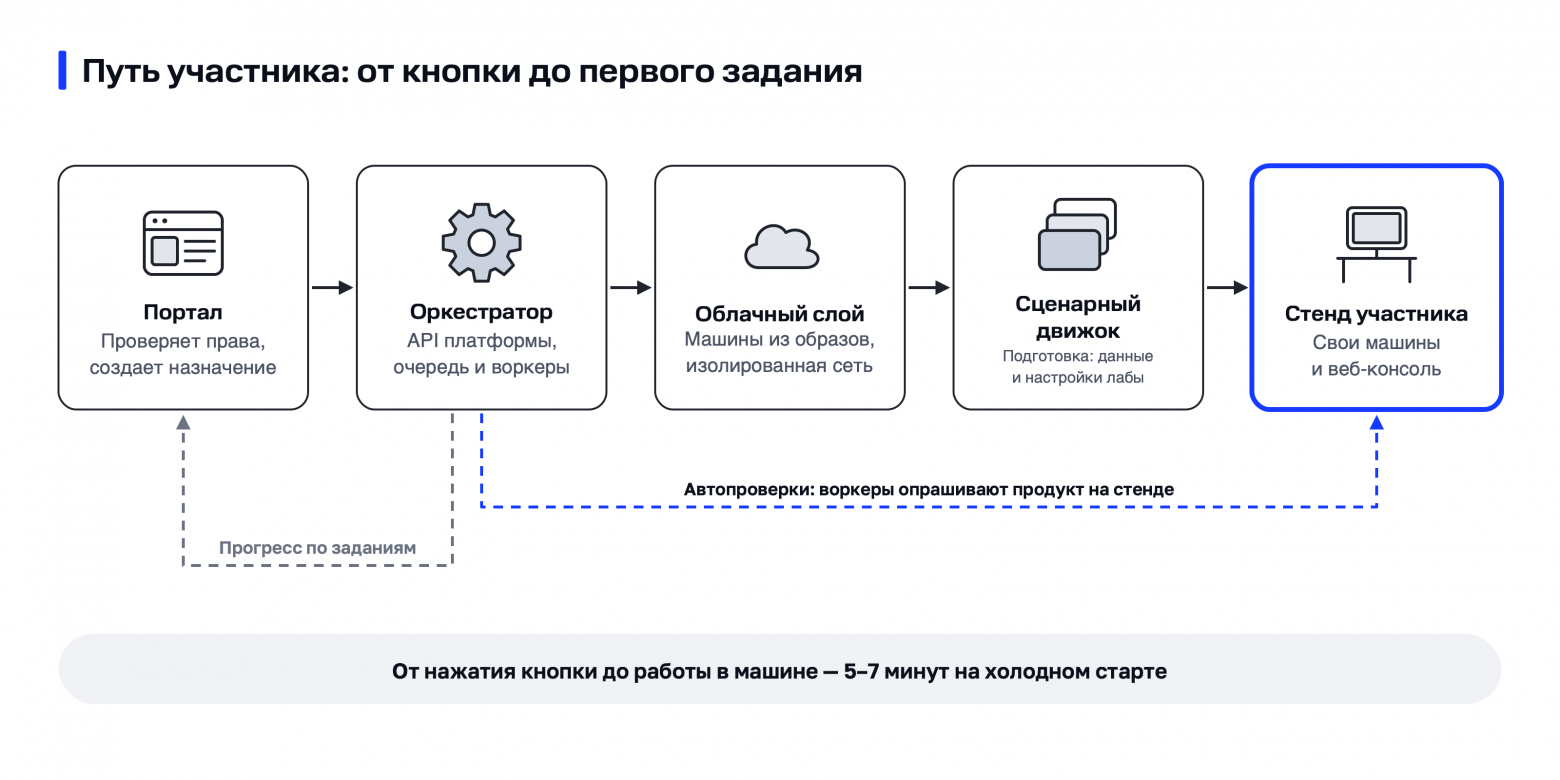
От нажатия кнопки до работы в машине проходит 5–7 минут. Это продуктовый контракт: если лаба стартует дольше, мы ищем фазу провижининга, которая замедлилась. Фазы и образы подробно разберем в пятой статье серии.
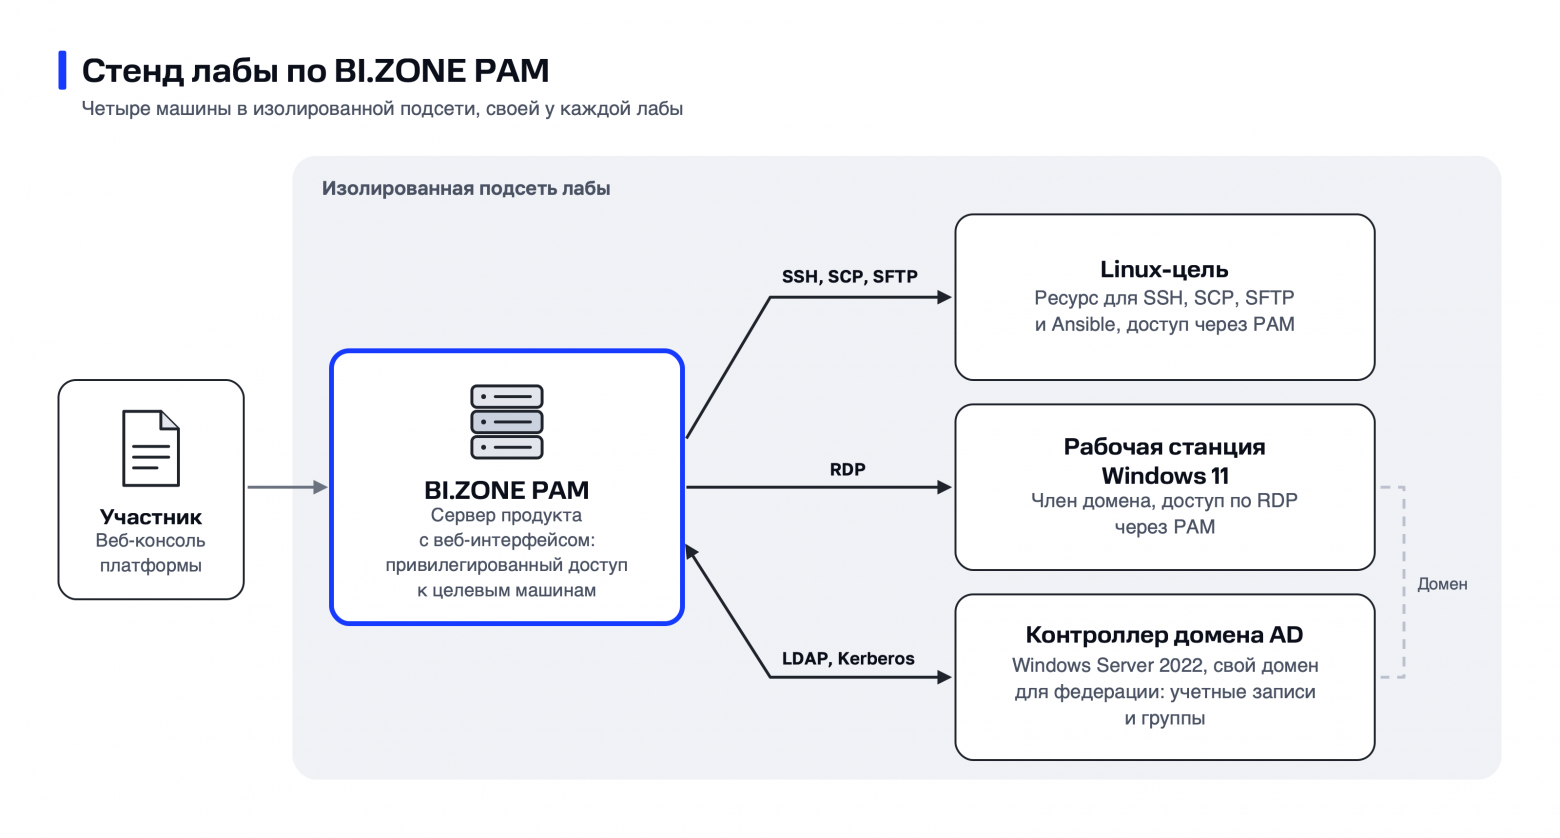
Так выглядит стенд лабы по BI.ZONE PAM. В нем четыре машины: сервер продукта, Linux-цель для SSH и Ansible, рабочая станция Windows 11 и контроллер домена со своим доменом для федерации. Все они работают в изолированной подсети, которая есть у каждой лабы.
Из чего состоит сценарий
Машины и сеть — только основа стенда. Что на них подготовить, какие события запустить и как проверить результат, платформа берет из сценария.
Лаба описывается сценарием в YAML. В нем указано, с какими продуктами он совместим, какие роли хостов нужны, что подготовить на старте, какие события запустить по ходу работы и как проверять результат. Ниже сокращенный и упрощенный пример: минимальный сценарий расследования SSH-перебора на стенде BI.ZONE PAM.
Сценарий лабы (упрощенно)
|
В примере четыре слоя. Setup готовит «здоровый фон», чтобы журнал не был стерильным. Inject через три минуты запускает событие, которое участник должен найти. Проверка типа auto_polling раз в 30 секунд спрашивает у стенда, сработало ли правило. Проверка типа manual оставляет решение тренеру: отчет о расследовании машина оценить не может.
Оговоримся: пример намеренно минимальный. Атака в нем эмулируется записью в журнал, и этого хватает, чтобы показать механику. В боевых лабах события приходят от настоящих продуктов, и проверка читает их оттуда.
Что не сработало
У каждого из трех решений есть более простая и дешевая альтернатива: симулятор вместо продукта, общий стенд вместо отдельного, проверка глазами тренера вместо кода. Есть и способ ускорить старт, который мы использовали, а потом убрали. Ниже четыре таких варианта и причины, по которым мы от них отказались.
Симулятор вместо продукта
С симулятора начинает почти каждый, кто строит обучение по ИБ: нарисованный интерфейс, готовые «алерты», заранее известные ответы. Мы от него отказались по трем причинам:
Участник учит интерфейс, которого нет в реальности: настоящая консоль BI.ZONE EDR меняется от релиза к релизу, а симулятор отстает.
Симулятор приходится поддерживать наравне с продуктом. По сути это вторая разработка, и она всегда догоняет.
В симуляторе нет настоящих побочных эффектов. Изоляцию хоста проверить нечем: машины нет.
Общий стенд на группу
Один большой стенд на всех проще и дешевле, но ломается на первом же задании, которое меняет состояние стенда. Один участник удаляет правило, второй получает «не сработало». Кто-то перезагружает сервер посреди чужого упражнения. В общем стенде не разобрать, кто что сделал: события перемешаны. Отдельный стенд на участника снимает эти проблемы, а заодно и споры о том, кто сломал лабу.
Теплые пулы
Чтобы участник не ждал, можно держать заранее собранные стенды и выдавать готовый. Такой механизм у нас был, но как от целевой модели мы от него отказались. Заготовка стареет вместе с образом и конфигурацией. Лаба из свежих кубиков на холодном старте получает ровно то, что описано в сценарии, а заготовку кто-то собрал неделю назад. Если старт укладывается в 5–7 минут, пул не нужен. Если не укладывается, мы чиним медленную фазу и не прячем ее за пулом. Теперь каждая лаба стартует на холодных машинах.
Ручная проверка тренером
Отчет и ход рассуждений тренер оценивает хорошо. А вот проверить вручную на двадцати стендах, изолирован ли хост, он не может. Поэтому проверки разделены: все, что можно посчитать по состоянию продукта, считает код, а оценка отчета остается человеку.
Как работает автопроверка
Проверку состояния стенда мы передали коду. В примере сценария это проверка типа auto_polling. Теперь покажем, как она устроена.
Проверка смотрит на эффект в реальной системе. Для типа auto_polling платформа периодически опрашивает стенд участника: сработало ли правило, появился ли файл, изменилась ли настройка. Хелперы сгруппированы по семействам продуктов, например подсчет алертов PAM из примера выше.
Тонкое место здесь одно: результат нужно привязать к конкретному участнику и к конкретной попытке, иначе чужие события засчитаются как свои. Если платформа не смогла проверить, она сообщает об ошибке и зачет не ставит.
Если участник может сымитировать эффект, проверка бесполезна. Об этом третья статья серии. В документации для тренеров мы записали принцип: зеленый статус автопроверки сам по себе не доказывает прохождение, тренер сверяет его с инструкцией сценария.
Роль тренера
Стенды собирает платформа, состояние продукта проверяет код. Что при этом остается тренеру?
В нашей модели тренер не администрирует стенды. Он собирает курс и лабу из готовых блоков, назначает их группам, выдает приглашения, смотрит статусы проверок и оценивает ручные задания. Шаблоны стендов и инфраструктуру готовит команда платформы.
Контент тренер правит сам: через конструктор, мастер сборки лабы и MCP-сервер платформы, к которому подключается его ИИ-клиент (эта часть пока в пилоте). Если контенту не хватает какой-то возможности, команда платформы меняет ядро: движок, тип компонента, API. Для этого есть обычный путь через ревью и CI. Это разделение закреплено в правилах: контент живет на платформе, в репозиторий попадает только ядро. Про блоки-кубики и про то, что значит «правка кубика сразу во всех лабах», подробно расскажем в четвертой статье.
Еще платформа останавливает простаивающие стенды: виртуальные машины выключаются, диски остаются, и, когда участник возвращается, стенд поднимается обратно. Ресурсы экономятся, а тренеру ничего делать не нужно.
История граблей: стенд «готов», а продукт еще нет
Все описанное выше заработало не с первого раза. Расскажем об одном случае, после которого мы изменили правило, по которому стенд получает статус «готов».
Простаивающие стенды мы усыпляем и поднимаем, когда участник возвращается. Однажды участники лабы по EDR начали жаловаться: после паузы раздел заданий пустой, грузится минутами или выбрасывает на страницу входа.
Разбор показал следующее. Оркестратор помечал лабу готовой, как только облако показывало виртуальную машину активной, на это уходило около 12 секунд. Тяжелый стек EDR из примерно 18 контейнеров после сна поднимался за 78–91 секунду. Участник попадал на стек, который еще не проснулся. Выброс на страницу входа с платформой связан не был: за время сна истекала сессия самого продукта.
Побочная находка того же разбора: ночное окно усыпляло стенды после 21:00 и не смотрело на последнюю активность участника.
Исправляли в несколько приемов:
Перед статусом «готов» платформа ждет, пока ключевые контейнеры продукта станут здоровыми. Проба опрашивает их состояние здоровья, общий бюджет ожидания — 180 секунд.
Если бюджет исчерпан, лаба все равно становится доступной, а в журнал уходит громкое событие. Стек EDR перезапускается сам, поэтому риск здесь только в задержке. Для PAM мы выбрали обратное: если проверка готовности не прошла, лаба снова засыпает, потому что неготовый продукт выдает участнику ошибки входа.
Прокси веб-консоли теперь читает живой статус лабы. Раньше он читал статус назначения, а тот на всем цикле сна остается «активным». Пока стенд просыпается, участник видит страницу «Стенд просыпается» вместо пустого экрана.
Ночное окно учитывает последнюю активность.
Вывод из этой истории подходит любой платформе со стендами: «машина запущена» и «продукт готов» — разные события, и статус для пользователя нужно привязывать ко второму. Кроме того, для каждого продукта стоит заранее решить, что делать, если ожидание истекло: открыть доступ и записать событие в журнал или закрыть доступ. У нас этот выбор разный для EDR и PAM, и оба решения записаны в манифесте шаблона стенда.
Похожая ловушка возникает при холодном старте: на старых целевых ОС могут быть установлены старые версии интерпретаторов. Скрипт успешно выполняется на нашей машине, но завершается с ошибкой в образе участника. Об этой ловушке и о двух гейтах, которые ее ловят, расскажем в пятой статье серии.
Что будет дальше
В этой статье мы описали платформу в целом и почти не касались деталей. Их разберем в следующих частях серии.
Впереди еще пять статей. Начнем с наиболее интересных:
ИИ-агенты в команде платформы. Как агенты пишут и проверяют код платформы, зачем нужно двойное независимое ревью, как устроен MCP для тренера, что пошло не так и какие ограничители мы ввели.
Автопроверка заданий. Как платформа понимает, что участник сделал задание в реальном продукте, и как мы закрываем обходы.
Кубики. Лабы из повторно используемых блоков и конструктор. Выгода и риски правки одного кубика сразу во всех лабах.
Холодный старт за 5–7 минут. Провижининг стенда, образы виртуальных машин, старые интерпретаторы на целевых ОС, отказ от теплых пулов, очистка.
Живой прогон до релиза. Как мы тестируем лабы за «e2e-участника» до выпуска и почему зеленый CI для лабы ничего не гарантирует.
Что пригодится и за пределами учебных стендов
Эти приемы мы вывели на лабах, но работают они шире: в SOC, во внутреннем обучении, при онбординге новичков и везде, где нужно понять, освоил ли человек работу с продуктом:
Оценивайте итог в системе. Нажатая кнопка в интерфейсе ничего не доказывает, важно, в каком состоянии остался продукт. Такая проверка переживает смену интерфейса: она смотрит в продукт и не зависит от того, как выглядит консоль.
Привязывайте результат к человеку и его попытке. Если в учебной среде работают несколько человек или один проходит задание повторно, без такой привязки чужие или старые события засчитаются как свои.
Не путайте отсутствие ошибки при проверке с подтверждением правильного результата. Это касается автопроверки заданий, опросов и мониторинга. Если проверка не смогла подтвердить выполнение нужного условия, система не должна автоматически засчитывать результат.
Считайте среду готовой, когда в ней можно работать. Новичку в первый день мало запущенной машины, ему нужен работающий продукт. Мы ставим статус «готово» по готовности продукта. Заранее решите, что делать, если ожидание истекло.
Готовьте среду с нуля и держите время старта в бюджете. Заготовленные заранее стенды стареют, а время холодного старта показывает реальное состояние всей цепочки подготовки.
На платформе BI.ZONE Education мы запускаем такие лабы по BI.ZONE EDR, BI.ZONE PAM и BI.ZONE Mail Security, и проверка компетенций (экзамен) тоже проходит в настоящем продукте. В следующей статье серии расскажем, как в нашей команде работают ИИ-агенты, как мы ревьюим их код и какие ограничители пришлось ввести.

