

Привет, Хабр!
Меня зовут Валентин, я DevOps-инженер команды Platform V Kintsugi. Мы развиваем облачный сервис и часто сталкиваемся с задачами эксплуатации распределённых систем, построенных на базе Kubernetes и Istio/Platform V Synapse Service Mesh.
В первой части мы разобрали, как устроен Tap Filter в Envoy, как подключить его в Istio через EnvoyFilter и сохранить перехваченный трафик в файлы.
На тестовом стенде всё выглядело просто, ведь мы заранее знали, какой запрос хотим найти — POST на определённый путь с заголовком x-debug: true. Задали три условия через and_match, отправили запрос и получили нужный tap-файл. Но в реальных задачах сам запрос далеко не всегда известен заранее. Например, сервис начал возвращать ошибки, а нам нужно понять, какие именно обращения стоит перехватить. Можно включить Tap на весь трафик, но тогда вместо нескольких интересующих запросов в каталог начнут попадать все обращения к сервису, включая служебный трафик и health-check.
Получаются две противоположные задачи: условие должно быть достаточно точным, чтобы не собирать лишнее, но при этом достаточно гибким, чтобы описать реальный сценарий поиска.
В этой статье разберём, как строятся такие условия в Tap Filter, посмотрим на предикаты и логические операторы, разберём несколько вариантов комбинирования условий и проверим их на практике.
Но точность фильтра — это не только вопрос удобства. Каждый запрос, попавший под перехват, требует дополнительной обработки, а тело сообщения может буферизоваться и сохраняться в sink. Поэтому отдельно посмотрим на обратную сторону Tap, сколько ресурсов стоит перехват и что происходит, если условие отбора оказывается слишком широким.
Как отбирать трафик в реальных расследованиях
Ранее мы использовали and_match как готовую конструкцию. Но это не самостоятельная сущность, а оператор логического выражения. Есть предикаты и операторы, которые их связывают. Всё вместе образует дерево: в узлах — and_match, or_match, not_match, в листьях — конкретные условия.
Минимальный «кирпичик» — проверка заголовков:
match_config:
  http_request_headers_match:
    headers:
      - name: ":path"
        string_match:
          prefix: "/test-tap"
В API Tap доступны шесть HTTP-предикатов:
http_request_headers_match— проверка заголовков запроса, включая псевдозаголовки HTTP/2 (:method,:path,:authority,:scheme). Отбор по методу и пути делается именно здесь, это самый частый предикат в практике;http_response_headers_match— проверка заголовков ответа, включая:status. Позволяет отбирать трафик по коду ответа, но требует дождаться ответа от приложения;http_request_trailers_match— проверка трейлеров запроса — заголовков, отправленных после тела. В обычном HTTP встречаются редко, а вот в gRPC используются штатно;http_response_trailers_match— то же для ответа. Для gRPC именноgrpc-statusв трейлерах позволяет определить статус самого RPC-вызова. HTTP-ответ при этом может иметь:status: 200. Поэтому при диагностике ошибок gRPC полезно учитыватьhttp_response_trailers_matchи заголовокgrpc-status, а не ориентироваться только на HTTP-код;http_request_generic_body_match— поиск подстроки или последовательности байтов в теле запроса. Позволяет отобрать трафик по содержимому, если не за что зацепиться в заголовках;http_response_generic_body_match— то же для тела ответа.
Первые четыре работают с уже разобранными структурами, поэтому они дешёвые. Два последних требуют чтения тела, что дороже и ограничено размером буфера. Если искомый фрагмент окажется за пределами max_buffered_rx_bytes, совпадения не будет.
Для сравнения строк используется StringMatcher с пятью формами:
exact— точное совпадение всей строки;prefix— строка начинается с указанного значения;suffix— строка заканчивается указанным значением. Реже нужен для заголовков, но полезен, например, для отбора по расширению в пути;contains— подстрока в любом месте – самый мягкий вариант, с ним же самый высокий риск случайных совпадений;safe_regex— полноценное регулярное выражение, когда четырёх предыдущих форм не хватает.
Важно, что в одном string_match можно указать только одну форму. Если нужно проверить и префикс, и суффикс одновременно, используют либо safe_regex, либо два отдельных предиката внутри and_match.
У HttpGenericBodyMatch логика другая. Там string_match — это просто обычная строка для поиска подстроки, а не объект с полями. Разница между ними — частая причина ошибок конфигурации.
Собираем сложные условия
Схема стенда прежняя — клиент (client) и сервер (webapp) в service mesh, между ними трафик через mTLS, перехват на sidecar-прокси Pod webapp, на входящем направлении (SIDECAR_INBOUND).
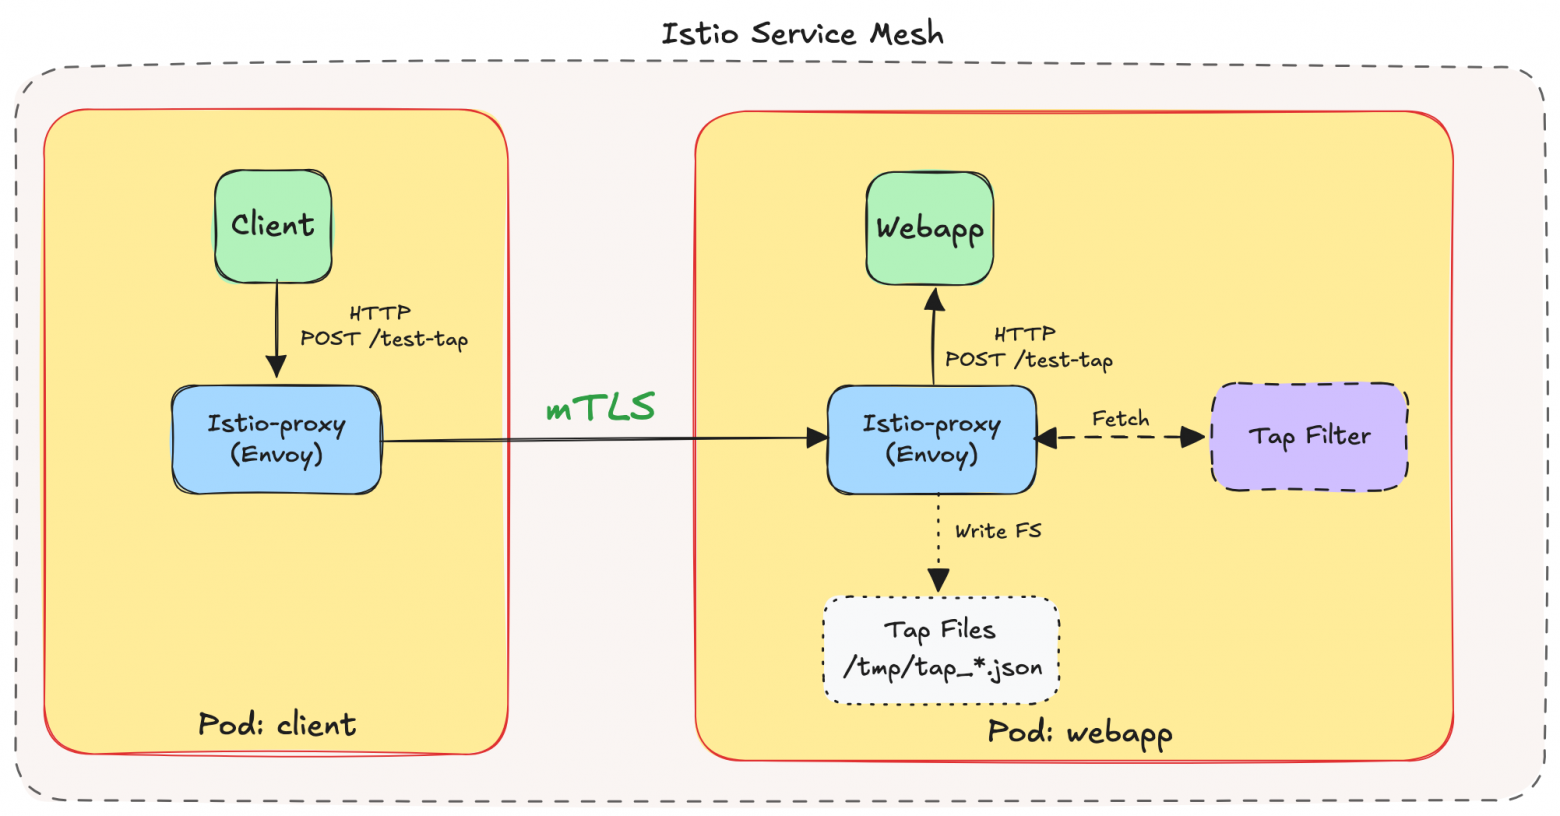
Для перехвата запросов POST /test-tap с заголовком x-debug: true используем конфигурацию EnvoyFilter:
apiVersion: networking.istio.io/v1alpha3
kind: EnvoyFilter
metadata:
  name: tap
spec:
  workloadSelector:
    labels:
      app: webapp
  configPatches:
    - applyTo: HTTP_FILTER
      match:
        context: SIDECAR_INBOUND
        listener:
          filterChain:
            filter:
              name: envoy.filters.network.http_connection_manager
              subFilter:
                name: envoy.filters.http.router
      patch:
        operation: INSERT_BEFORE
        value:
          name: envoy.filters.http.tap
          typed_config:
            "@type": type.googleapis.com/envoy.extensions.filters.http.tap.v3.Tap
            common_config:
              static_config:
                match_config:
                  and_match:
                    rules:
                      - http_request_headers_match:
                          headers:
                            - name: ":method"
                              string_match:
                                exact: "POST"
                      - http_request_headers_match:
                          headers:
                            - name: ":path"
                              string_match:
                                prefix: "/test-tap"
                      - http_request_headers_match:
                          headers:
                            - name: "x-debug"
                              string_match:
                                exact: "true"
                output_config:
                  max_buffered_rx_bytes: 4096
                  max_buffered_tx_bytes: 4096
                  sinks:
                    - format: JSON_BODY_AS_STRING
                      file_per_tap:
                        path_prefix: /tmp/tap_
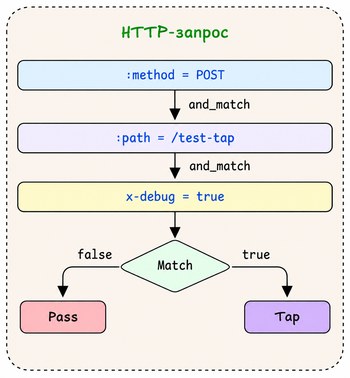
Первый неочевидный момент: внутри одного headers_match несколько заголовков уже соединены «логическим И». Поэтому нашу конфигурацию можно переписать короче:
match_config:
  http_request_headers_match:
    headers:
      - name: ":path"
        string_match:
          prefix: "/test-tap"
      - name: ":method"
        string_match:
          exact: "POST"
      - name: "x-debug"
        string_match:
          exact: "true"
Эта запись эквивалентна and_match из трёх отдельных предикатов.
Проверим:
kubectl exec -ti deploy/client -c client -- \
  curl -i -X POST \
  -H "x-debug: true" \
  -H "Content-Type: application/json" \
  webapp:8080/test-tap \
  -d '{"message": "This message is for testing tap filter"}'

HTTP/1.1 200 OK
server: envoy
content-type: application/octet-stream,application/json
content-length: 45
x-envoy-upstream-service-time: 8
Факт срабатывания выясним через листинг директории, в которой аккумулируются tap-файлы:
kubectl exec -ti deploy/webapp -c istio-proxy -- ls -lh /tmp/

total 4.0K
-rw-r--r--. 1 10002 10001 3.7K Aug 23 14:06 tap_14222390442389397416.json
Запрос попал под условие.
Сокращённая запись удобна, но у неё есть предел. Все заголовки в одном блоке относятся к одному срезу. and_match нужен, когда условия затрагивают разные срезы, например, заголовок запроса и статус ответа.
and_match и or_match — оба оператора принимают список rules, и каждый элемент списка — это снова полноценный предикат. Отсюда и берётся вложенность.
match_config:
  or_match:
    rules:
      - http_request_headers_match:
          headers:
            - name: "x-debug"
              string_match:
                exact: "true"
      - http_response_headers_match:
          headers:
            - name: ":status"
              string_match:
                prefix: "5"
Здесь Tap сработает, если запрос помечен отладочным заголовком или если ответ вернулся с 5xx. Второй вариант на практике самый полезный. Вы заранее не знаете, какой запрос сломается, но точно знаете, что интересуют именно упавшие.
Проверим работу такой конфигурации. Направим запрос GET /test-tap/500 — метод и путь здесь роли не играют, нас интересует только код ответа. Заголовок x-debug намеренно не отправляем, раз используется or_match, истинным должно оказаться лишь одно условие — код ответа 5xx.
kubectl exec -ti deploy/client -c client -- \
  curl -i -X GET \
  -H "Content-Type: application/json" \
  webapp:8080/test-tap/500

HTTP/1.1 500 Internal Server Error
server: envoy
content-type: application/octet-stream
content-length: 36
x-envoy-upstream-service-time: 8
Фильтр сработал:
kubectl exec -ti deploy/webapp -c istio-proxy -- cat /tmp/tap_15831352684644655500.json
{
  "http_buffered_trace": {
    "request": {
      "headers": [
        { "key": ":authority", "value": "webapp:8080" },
        { "key": ":path", "value": "/test-tap/500" },
        { "key": ":method", "value": "GET" },
        { "key": ":scheme", "value": "http" },
        { "key": "user-agent", "value": "curl/7.74.0" },
        { "key": "accept", "value": "*/*" },
        { "key": "content-type", "value": "application/json" },
        { "key": "x-forwarded-proto", "value": "http" },
        { "key": "x-request-id", "value": "92d16540-52db-971f-b40c-24e5ad411944" },
        { "key": "x-envoy-attempt-count", "value": "1" },
        { "key": "x-forwarded-client-cert", "value": "By=spiffe://cluster.local/ns/demo/sa/default;Hash=...;URI=spiffe://cluster.local/ns/demo/sa/default" },
        { "key": "x-b3-traceid", "value": "54a3091563d0e493c6ba599195f14f43" },
        { "key": "x-b3-spanid", "value": "70224cb6fe8dbddd" },
        { "key": "x-b3-sampled", "value": "1" }
      ],
      "trailers": []
    },
    "response": {
      "headers": [
        { "key": ":status", "value": "500" },
        { "key": "server", "value": "istio-envoy" },
        { "key": "content-type", "value": "application/octet-stream" },
        { "key": "content-length", "value": "36" },
        { "key": "x-envoy-upstream-service-time", "value": "0" }
      ],
      "body": {
        "as_string": "{\"message\": \"Internal Server Error\"}",
        "truncated": false
      },
      "trailers": []
    }
  }
}
Примечание. В листингах скрыты служебные поля и внутренняя инфраструктура стенда. Остальная структура ответа сохранена без изменений.
Запрос не содержал x-debug, но попал в Tap — сработало условие по коду ответа.
Обратите внимание на сам листинг. В нём одновременно видны объекты запроса и ответа. Это сущности, по которым мы строим условия отбора. Практическая сила Tap состоит в том, что инструмент не просто показывает, что произошло с запросом, а позволяет отфильтровать трафик по любому срезу — методу, пути, коду ответа или телу, комбинируя их в произвольной логике.
Поскольку rules содержит предикаты, внутрь and_match можно вложить or_match (и наоборот). Как пример, отберём запросы к /test-tap, которые пришли методом GET и при этом либо помечены заголовком x-debug, либо завершились ошибкой.
match_config:
  and_match:
    rules:
      - http_request_headers_match:
          headers:
            - name: ":method"
              string_match:
                exact: "GET"
            - name: ":path"
              string_match:
                prefix: "/test-tap"
      - or_match:
          rules:
            - http_request_headers_match:
                headers:
                  - name: "x-debug"
                    string_match:
                      exact: "true"
            - http_response_headers_match:
                headers:
                  - name: ":status"
                    string_match:
                      prefix: "5"
Формально это (GET И /test-tap) И (x-debug ИЛИ5xx). Заметьте, как первое условие использует сокращение с двумя заголовками в одном блоке, а второе — явный or_match.
Повторим запрос с заголовком x-debug, на этот раз обратимся к ресурсу /test-tap с ожидаемым кодом ответа 200:
kubectl exec -ti deploy/client -c client -- \
  curl -i -X GET \
  -H "x-debug: true" \
  -H "Content-Type: application/json" \
  webapp:8080/test-tap

HTTP/1.1 200 OK
server: envoy
content-type: application/octet-stream,application/json
content-length: 45
x-envoy-upstream-service-time: 4
В результате получаем:
kubectl exec -ti deploy/webapp -c istio-proxy -- cat /tmp/tap_8395364958470957648.json
{
  "http_buffered_trace": {
    "request": {
      "headers": [
        { "key": ":authority", "value": "webapp:8080" },
        { "key": ":path", "value": "/test-tap" },
        { "key": ":method", "value": "GET" },
        { "key": ":scheme", "value": "http" },
        { "key": "user-agent", "value": "curl/7.74.0" },
        { "key": "accept", "value": "*/*" },
        { "key": "x-debug", "value": "true" },
        { "key": "content-type", "value": "application/json" },
        { "key": "x-forwarded-proto", "value": "http" },
        { "key": "x-request-id", "value": "9f9b72ca-dddf-9723-aff8-b638c0a4268f" },
        { "key": "x-envoy-attempt-count", "value": "1" },
        { "key": "x-forwarded-client-cert", "value": "By=spiffe://cluster.local/ns/demo/sa/default;Hash=...;URI=spiffe://cluster.local/ns/demo/sa/default" },
        { "key": "x-b3-traceid", "value": "cb5f7c972f8f37c4e90406c845ecd576" },
        { "key": "x-b3-spanid", "value": "4bb8545d0f762c03" },
        { "key": "x-b3-sampled", "value": "1" }
      ],
      "trailers": []
    },
    "response": {
      "headers": [
        { "key": ":status", "value": "200" },
        { "key": "server", "value": "istio-envoy" },
        { "key": "content-type", "value": "application/octet-stream,application/json" },
        { "key": "content-length", "value": "45" },
        { "key": "x-envoy-upstream-service-time", "value": "0" }
      ],
      "body": {
        "as_string": "{\"status\":\"ok\",\"message\":\"Hello from webapp\"}",
        "truncated": false
      },
      "trailers": []
    }
  }
}
На этот раз ответ успешный, но перехват состоялся — из двух условий вложенного or_match выполнилось первое.
Следующий оператор, который часто забывают — not_match, он полезен для исключений, например, перехватывать всё, кроме health-проб:
match_config:
  not_match:
    http_request_headers_match:
      headers:
        - name: ":path"
          string_match:
            exact: "/healthz"
В отличие от and_match и or_match, оператор not_match принимает один предикат, а не список правил.
Технически вложенность не ограничена, но читаемость YAML падает быстро. Три уровня уже тяжелы для восприятия. Если условие слишком длинное, то нужно разделить его на два разных EnvoyFilter с разными path_prefix.
При проверке важно помнить, что условия срабатывают для каждого проходящего запроса, а не только для тех, что попали в выборку. Сама проверка заголовков обходится дёшево, к вопросу о реальной стоимости перехвата мы перейдём в следующих разделах.
Поиск по телу сообщения
Рассмотрим случай, когда заголовков для фильтрации недостаточно и нужно проверить содержимое самого сообщения. Для этого используем предикаты http_request_generic_body_match и http_response_generic_body_match. В нашем примере они работают в связке и позволяют анализировать тело как запроса, так и ответа:
match_config:
  and_match:
    rules:
      - http_request_headers_match:
          headers:
            - name: ":method"
              string_match:
                exact: "POST"
            - name: ":path"
              string_match:
                prefix: "/test-tap"
      - or_match:
          rules:
            - http_request_headers_match:
                headers:
                  - name: "x-debug"
                    string_match:
                      exact: "true"
            - http_response_headers_match:
                headers:
                  - name: ":status"
                    string_match:
                      prefix: "5"
      - http_request_generic_body_match:
          bytes_limit: 44
          patterns:
            - string_match: tap
      - http_response_generic_body_match:
          bytes_limit: 43
          patterns:
            - string_match: webapp
Под перехват попадёт запрос POST /test-tap с заголовком x-debug: true или кодом ответа 5xx — при условии, что его тело содержит подстроку tap, а тело ответа — webapp.
kubectl exec -ti deploy/client -c client -- \
  curl -i -X POST \
  -H "x-debug: true" \
  -H "Content-Type: application/json" \
  webapp:8080/test-tap \
  -d '{"message": "This message is for testing tap filter"}'

HTTP/1.1 200 OK
server: envoy
content-type: application/octet-stream,application/json
content-length: 45
x-envoy-upstream-service-time: 1
bytes_limit — это отдельная граница, не связанная с max_buffered_rx_bytes. Она определяет, сколько байтов тела Envoy просматривает в поисках совпадения.
Посмотрите на значения этого параметра в нашем примере, они выбраны не случайно. Лимиты выставлены ровно по границе искомых подстрок. Слово tap полностью укладывается в первые 44 байта тела запроса, а webapp — в первые 43 байта тела ответа.
Запрос:
{"message": "This message is for testing tap filter"}
Ответ:
{"status":"ok","message":"Hello from webapp"}
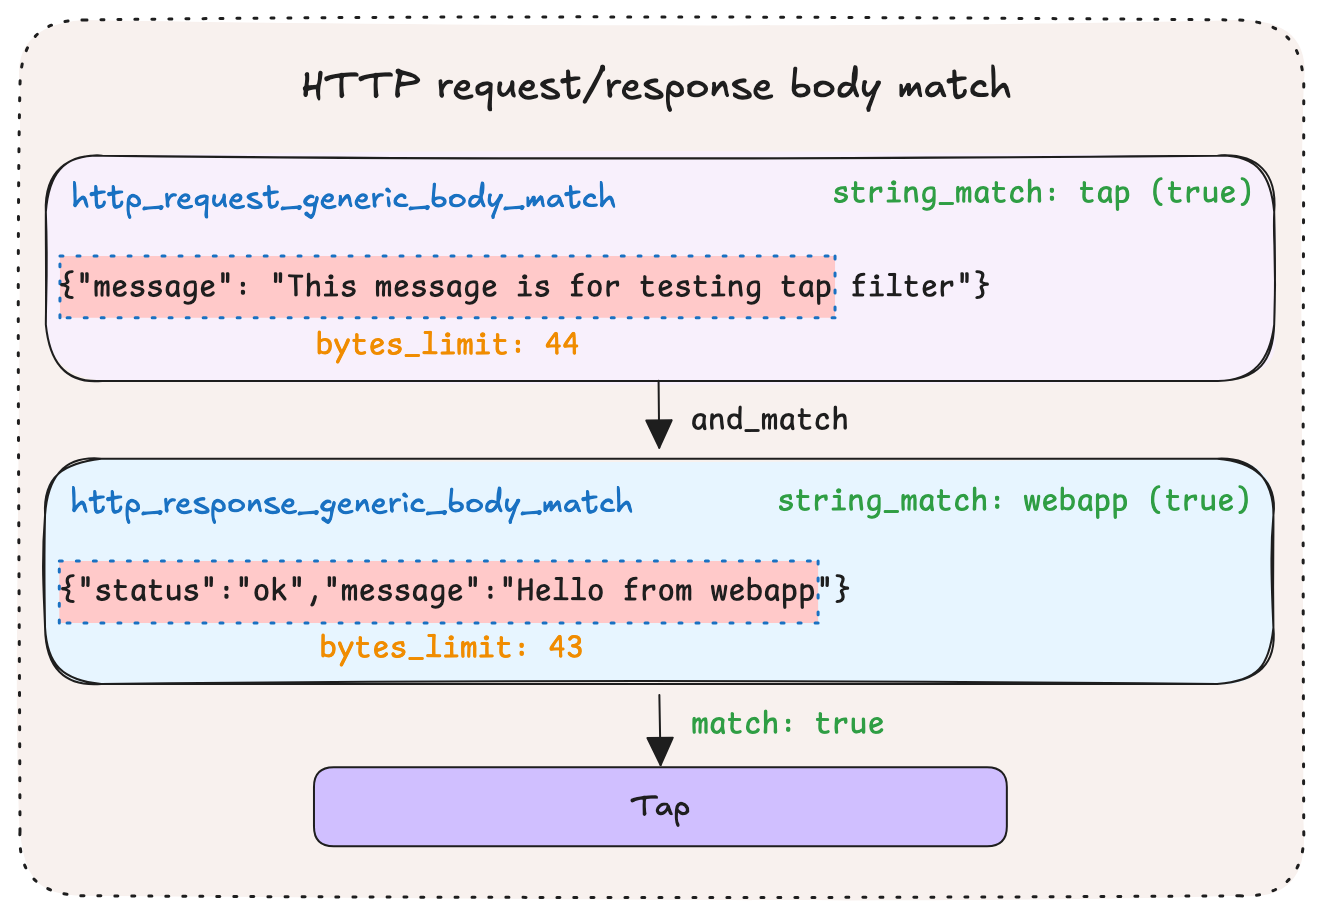
Оба искомых фрагмента присутствуют, и все условия and_match выполняются.
Если искомая строка окажется дальше указанного предела, совпадения не будет — даже если тело целиком поместилось в буфер. Проверим, что произойдёт, если немного уменьшить лимит для запроса:
- http_request_generic_body_match:
    bytes_limit: 40
    patterns:
      - string_match: tap
Отправляем тот же самый запрос:
kubectl exec -ti deploy/client -c client -- \
  curl -i -X POST \
  -H "x-debug: true" \
  -H "Content-Type: application/json" \
  webapp:8080/test-tap \
  -d '{"message": "This message is for testing tap filter"}'

HTTP/1.1 200 OK
server: envoy
content-type: application/octet-stream,application/json
content-length: 45
x-envoy-upstream-service-time: 9
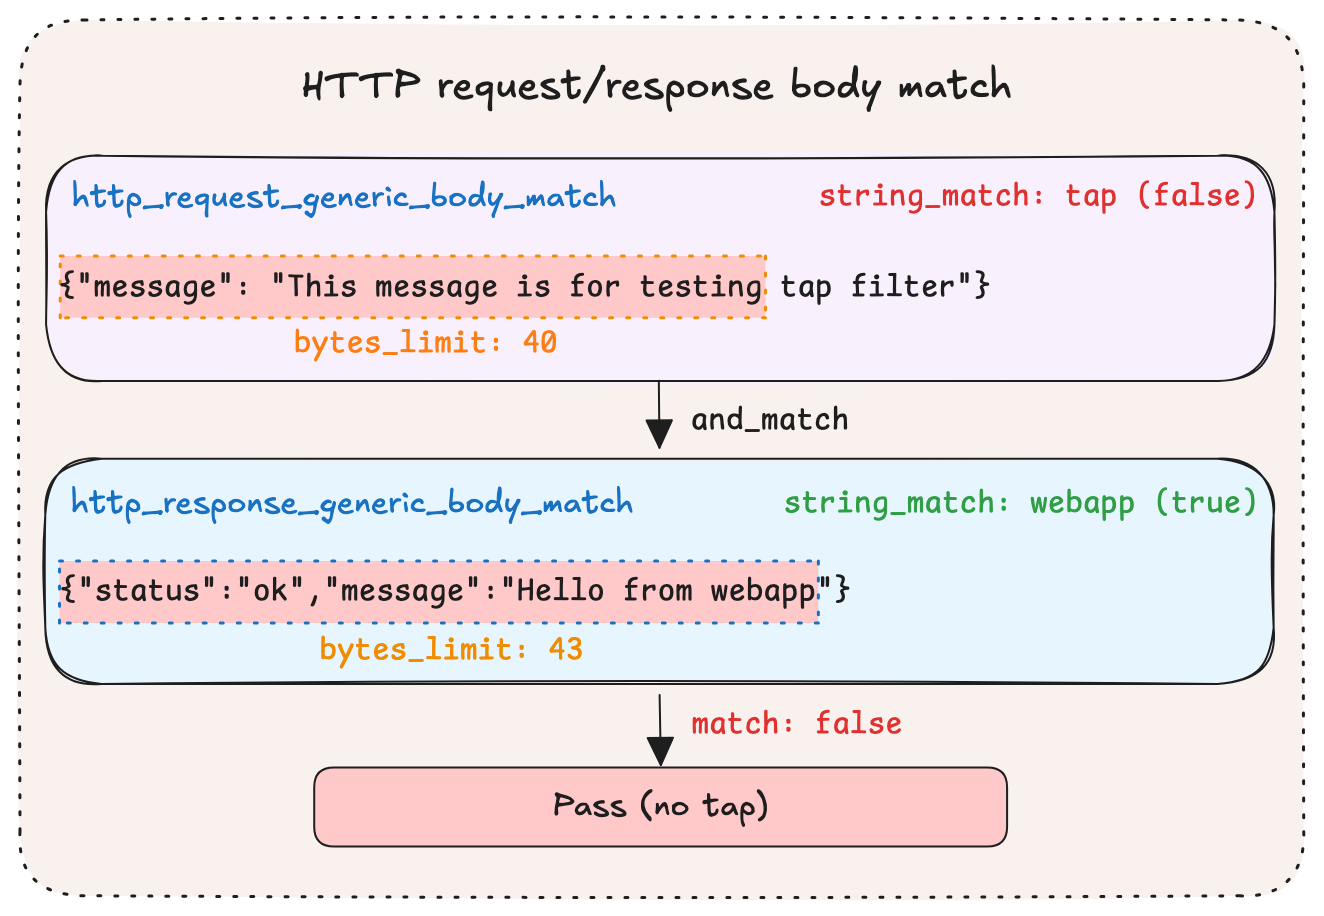
Запрос обработан успешно, но новый tap-файл не создался. При bytes_limit: 40 Envoy проверил только первые 40 байт тела, не нашёл там подстроки tap, поэтому предикат не сработал — а вместе с ним провалился весь блок and_match.
Это главное отличие bytes_limit от max_buffered_rx_bytes. Первый ограничивает область поиска, второй — объём записи. Тело может целиком поместиться в буфер вывода, но остаться непросмотренным, если лимит поиска меньше его размера.
Второй нюанс в том, что поиск идет по сырой подстроке и не учитывает структуру JSON. Значение tap совпадёт и с полем message, и с любым другим местом, где эти три символа встретятся подряд. Для диагностики этого обычно достаточно, но стоит помнить о ложных срабатываниях, особенно при поиске коротких фрагментов.
Цена перехвата трафика
Мы разобрались с условиями, теперь посмотрим на их стоимость. Tap легко превращается из диагностического инструмента в источник нагрузки на прокси, и происходит это незаметно.
Ключевое, что основная цена платится не за проверку условия, а после совпадения. Сравнить пару заголовков дёшево даже во вложенном and_match — Envoy всё равно их уже разобрал. Дорого обходится то, что следует дальше, а именно удержание данных в буфере, формирование события, сериализация и запись файла.
Отсюда контринтуитивный вывод для настройки — сложное узкое условие безопаснее простого широкого. Лишний предикат почти бесплатен, лишняя тысяча совпадений — нет.
Проверим теорию цифрами. Оценим накладные расходы, сняв метрики sidecar-контейнера под нагрузкой Fortio. Для чистоты эксперимента используем одну и ту же команду для обоих прогонов:
kubectl exec -it deploy/fortio -c fortio -- \
  fortio load \
    -c 100 \
    -qps 100 \
    -t 60s \
    -X POST \
    -H "x-debug: true" \
    -H "Content-Type: application/json" \
    -payload '{"message": "This message is for testing tap filter"}' \
    http://webapp:8080/test-tap
Сто одновременных соединений, сто запросов в секунду, минута прогона — около 6000 запросов, каждый из которых удовлетворяет условию отбора и попадает в tap. За базовую линию принимаем потребление sidecar сразу после старта, до подачи нагрузки — она видна в начале каждого графика.
Выключенный Tap
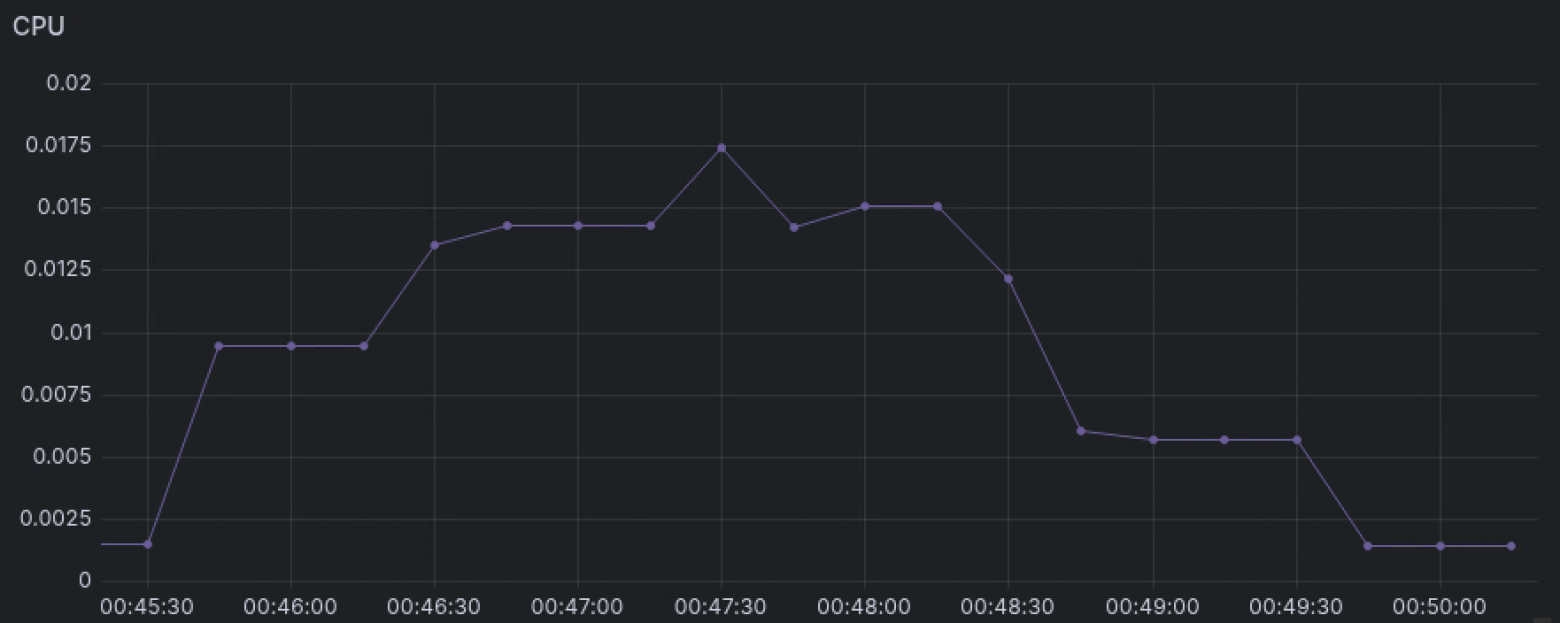
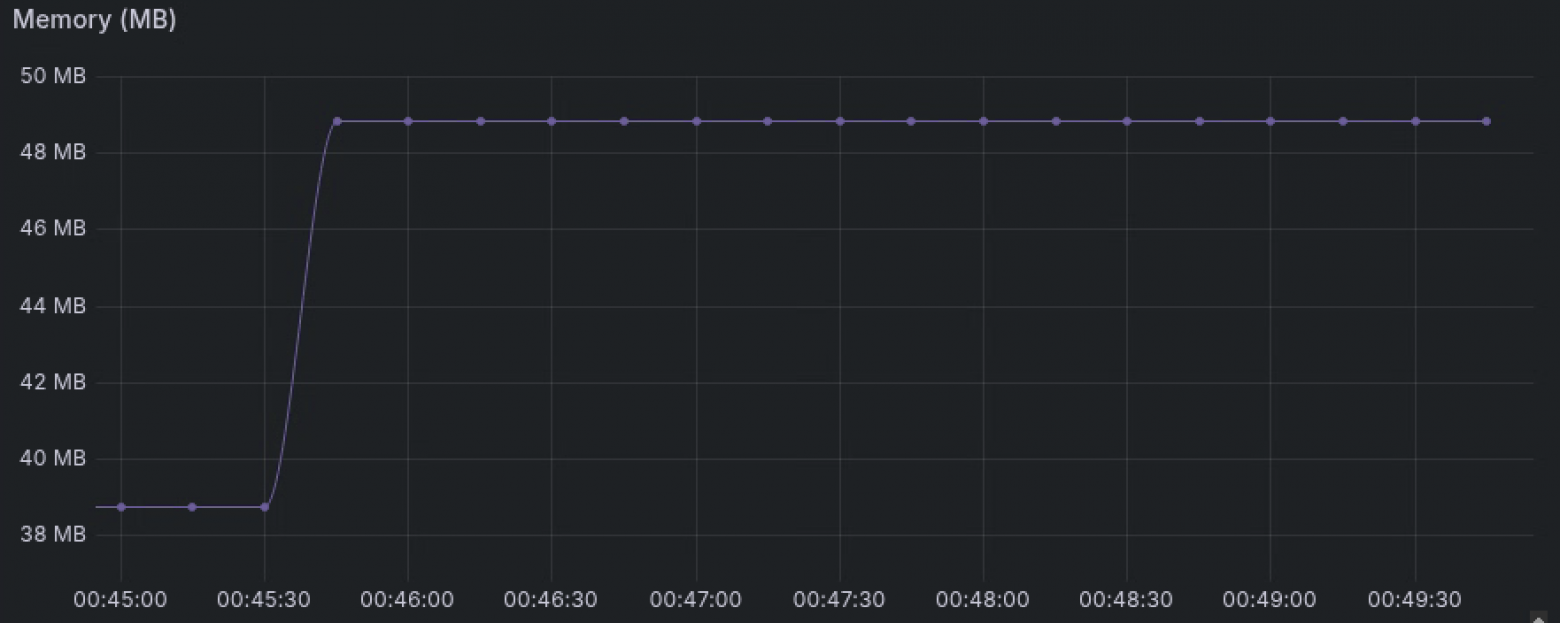
Включенный Tap
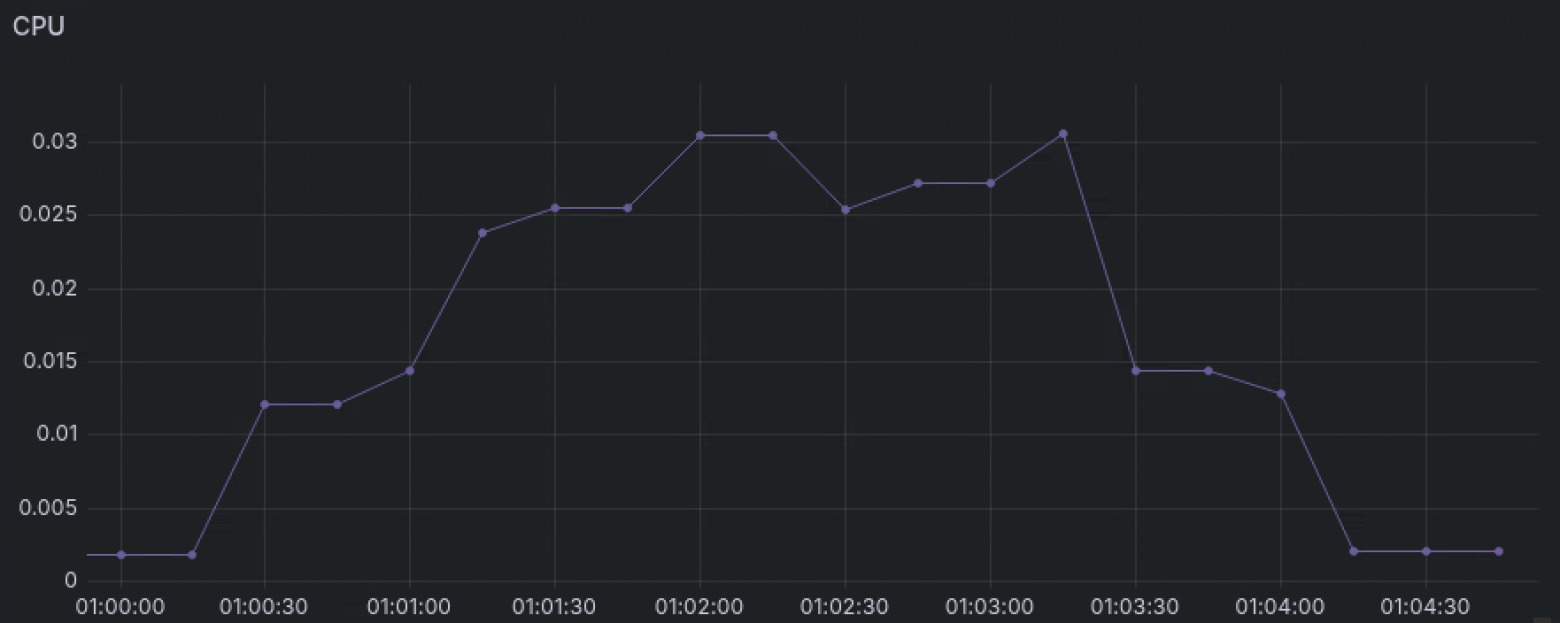
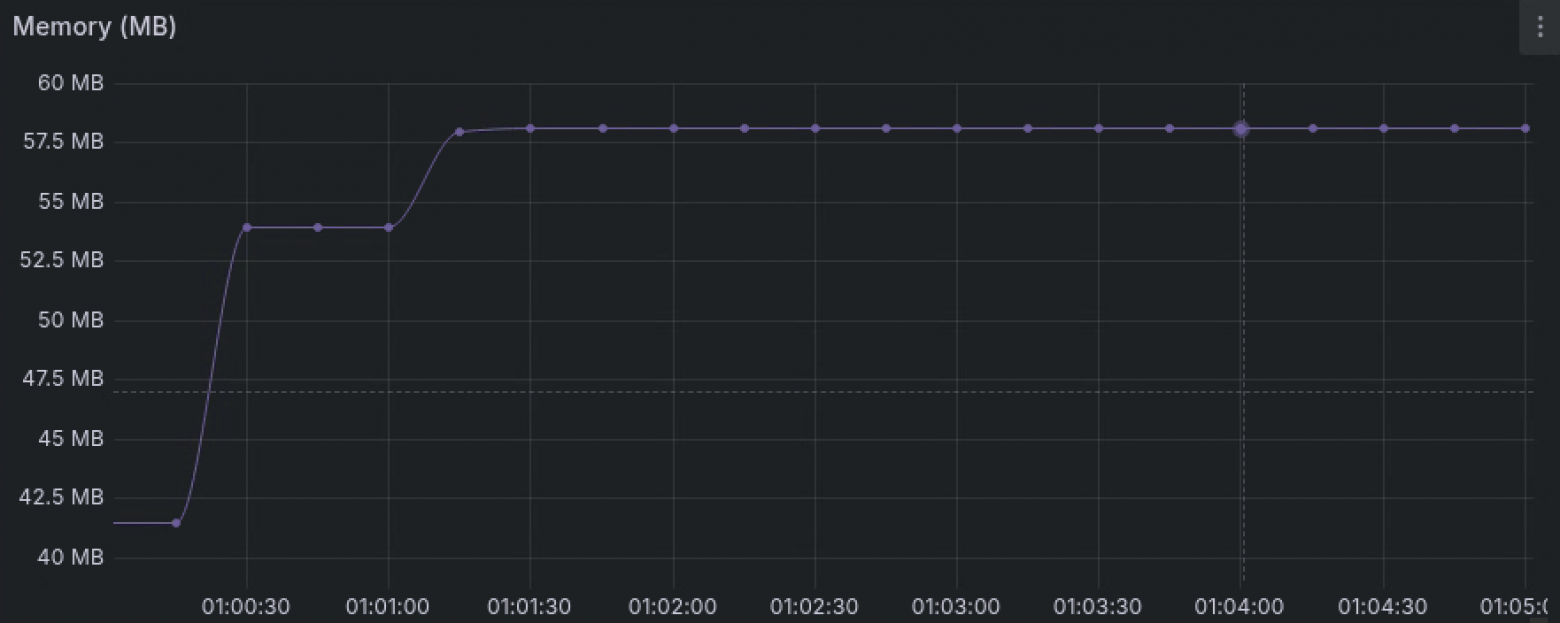
Метрика | Без Tap | С Tap |
CPU без нагрузки | ~0,0015 | ~0,0018 |
CPU под нагрузкой | ~0,0175 | ~0,0306 |
Память без нагрузки | 38,7 МБ | 41,5 МБ |
Память под нагрузкой | 48,8 МБ | 58,0 МБ |
Прирост памяти под нагрузкой | +10,1 МБ | +16,5 МБ |
Сама конфигурация фильтра резервирует около 3 МБ памяти ещё до появления трафика — это разница базовых линий. Под нагрузкой перехват добавляет около 75% к пиковому CPU и 63% к приросту памяти.
Метрики ведут себя по-разному после снятия нагрузки. CPU возвращается к норме за пару интервалов, а память остаётся на плато. Такое поведение связано с особенностями аллокатора, освобождённая память не всегда сразу возвращается операционной системе и может быть повторно использована при следующем всплеске.
Оговорюсь, что это единичный прогон на тестовом стенде. Цифры показывают порядок величины, а не универсальный коэффициент. На реальном сервисе результат будет зависеть от размера тел, доли совпадений и профиля нагрузки.
Эксперимент наглядно показывает цену ширины отбора. Даже узкое условие заставляет Envoy делать дополнительную работу при каждом совпадении. Чем больше запросов попадает под фильтр, тем чаще запускается эта цепочка. Отсюда логичный вопрос: какие конфигурации заставляют Tap выполнять эту работу впустую?
Антипаттерны и безопасные практики
Мы разобрались, как писать условия отбора. Теперь посмотрим на обратную сторону. Когда сам инструмент диагностики становится источником проблем, и как этого избежать.
Широкий отбор
Самый очевидный антипаттерн — начать диагностику с any_match: true. Под перехват попадёт всё подряд, и пользовательские запросы, и health-пробы, и служебный трафик.
Счётчик начинает расти стремительно. Если один tap-файл весит около 3,7 КБ (как в нашем примере), а сервис обрабатывает 1000 RPS:
~3,7 МБ данных в секунду;
~222 МБ за минуту;
~13 ГБ за час.
При использовании emptyDir с типом Memory такой объём очень быстро исчерпает лимиты Pod.
Особенно ощутимо это при использовании emptyDir с medium: Memory для хранения tap-файлов:
emptyDir:
  medium: Memory
В этом случае файлы находятся в памяти и отнимают её у Envoy и приложения. Для короткой разовой диагностики такой вариант удобен, но при широком перехвате он быстро приведёт к нехватке памяти.
Массовым может оказаться не только any_match. Условие по заголовку x-debug: true кажется безопасным, пока этот заголовок проставляется вручную на нескольких запросах. Стоит ему попасть в нагрузочный тест или в клиентскую библиотеку по умолчанию — под перехват начнёт попадать значительная часть трафика. В используемой нами конфигурации основной способ контролировать объём данных — ограничивать само условие отбора.
Перед применением EnvoyFilter полезно заранее оценить несколько простых величин:
сколько Pod совпадёт с
workloadSelector;какой суммарный RPS через них проходит;
какая доля запросов попадёт под условие;
сколько данных накопится за время расследования.
Небольшой конфиг, применённый к сотне нагруженных прокси, может оказаться гораздо опаснее объёмного фильтра на одном тестовом поде.
Игнорирование спецификации Envoy
Отдельная опасность — конфигурация выглядит верной, но на деле работает иначе. Схема Tap Filter жёстко привязана к версии Envoy. То, что работало в одном кластере, может сломаться после обновления. Поля переименовываются, устаревают или меняют вложенность.
Поэтому любую скопированную конфигурацию — из старой статьи или другого окружения — нужно сверять со спецификацией именно вашей версии. Полагаться на то, что раньше работало, нельзя.
Вторая, более коварная проблема — перепутать две разные конструкции string_match. В заголовочных предикатах это объект StringMatcher с вариантами exact, prefix, suffix, contains и safe_regex. В patterns у generic_body_match string_match — обычная строка, которую Envoy ищет в теле сообщения. Поэтому конструкции имеют похожее название, но разную структуру:
# *_headers_match,
patterns:
  - string_match:
      contains: tap

# *_body_match, *_trailers_match
patterns:
  - string_match: tap
Первый вариант применяется без единой ошибки. kubectl apply проходит успешно, Envoy принимает конфигурацию. Но предикат с неверным значением перестаёт фильтровать, а родительский and_match начинает пропускать всё подряд.
Узкое на вид условие превращается в any_match — тот самый первый антипаттерн, только без предупреждения. На тестовом стенде это видно по лишним файлам. На нагруженном сервисе конфиг выглядит рабочим, а разрастание каталога обнаруживается уже постфактум.
И главное правило здесь — после применения EnvoyFilter всегда делать негативную проверку. Отправьте запрос, который не должен попасть под фильтр, и убедитесь, что новых файлов нет.
Если есть сомнения, проверьте, как конфигурация реально доехала до прокси:
kubectl exec deploy/webapp -c istio-proxy -- \
pilot-agent request GET config_dump | grep -A 100 'envoy.filters.http.tap'
Буферы и размер сообщения
Широкий отбор влияет не только на объём записываемых данных. После совпадения Envoy должен удержать тело в буфере, сформировать tap-событие, сериализовать его и отправить в sink. Поэтому размер сообщения и количество одновременных запросов напрямую определяют стоимость перехвата.
Упрощённо дополнительное потребление памяти выглядит так:
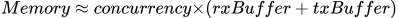
Например, при 50 одновременных запросах и буферах по 64 КБ это около 6 МБ дополнительной буферизации.
На практике всё сложнее. Конкурентность растёт именно тогда, когда сервис начинает тормозить — то есть в разгар того самого инцидента, ради которого вы включили Tap. Отсюда простое правило: захватывайте тело, только если оно нужно для расследования.
Если вопрос звучит как «какой upstream вернул 503 и с какими заголовками?», содержимое ответа вам не поможет. В этом случае держите max_buffered_*_bytes минимальными.
Матчинг по ответу
Отдельного внимания заслуживает ситуация, когда условие зависит от ответа. Если используется http_response_headers_match, фильтр принимает окончательное решение только после получения ответа от приложения.
Это отличается от проверки заголовков запроса. Там нужная информация доступна сразу, в начале обработки. При работе с ответом же Envoy приходится дожидаться следующей стадии.
Поэтому, если исследование можно построить вокруг признака самого запроса — стройте его именно так. Условие по статусу (:status) оправдано лишь тогда, когда заранее неизвестно, какой запрос сломается. Но такая гибкость имеет свою цену, поэтому добавлять response matching «на всякий случай» не стоит.
Широкий workloadSelector
Даже идеально составленное условие станет проблемой, если применить его слишком широко. Поле workloadSelector определяет, на какие sidecar установится фильтр.
Если он совпал с сотней Pod, стоимость эксперимента умножается на сто. Каждый прокси получает конфиг, обрабатывает трафик и пишет свои файлы. Кроме того, изменение нужно доставить во все Pod — это лишняя нагрузка на control plane.
Если расследуется один Deployment, распространять Tap на весь namespace обычно нет смысла.
Время жизни конфигурации
Есть менее очевидная ловушка, когда диагностика закончилась, данные собраны, а EnvoyFilter остался в кластере. Через неделю никто уже не вспомнит, зачем он был нужен, и временный инструмент станет частью постоянной конфигурации.
Tap не выключается сам. У него нет TTL, лимита событий или встроенной ротации файлов. Ответственность за отключение всегда лежит на том, кто включил фильтр.
Поэтому перед запуском ответьте на простой вопрос: что произойдет с Pod, если tap-файлы будут копиться быстрее, чем их успевают удалять? Если ответа нет, конфигурация ещё не готова даже для стенда.
Чувствительные данные
У Tap есть стоимость, которую нельзя измерить в CPU или памяти. Перехватываемое сообщение может содержать то, что не должно покидать кластер, например, токены авторизации, куки, сессионные ключи и персональные данные.
Включая фильтр, вы создаёте ещё одну копию этих данных на диске или в памяти (sink).
Перед запуском диагностики нужно чётко понимать:
какие именно поля попадут в файлы;
кто имеет доступ к этому хранилищу;
когда эти данные будут гарантированно удалены.
Это часть проектирования конфигурации, а не задача, которую можно отложить на потом.
Все эти ограничения сводятся к одному практическому правилу — двигаться от узкого условия к широкому, а не наоборот:
начинать с одного
workloadи явного признака вродеx-debug: true;пропускать анализ тела, если достаточно заголовков;
расширять условие ровно настолько, насколько нужно, если данных в заголовках мало;
держать буферы минимально достаточными;
удалять
EnvoyFilterи связанные с ним данные сразу после завершения расследования.
Условно стоимость Tap можно представить как произведение нескольких факторов:
область применения × доля совпадений × размер события × конкурентность × время жизни данных
Все эти факторы увеличивают итоговую стоимость. Поэтому эффективнее всего сокращать те параметры, которыми проще управлять. На практике это чаще всего область применения и доля совпадений: гораздо безопаснее перехватить пару запросов на одном Pod, чем записывать весь трафик большого workload.
Сложность самого условия пугать не должна. Проверка пары заголовков почти ничего не стоит. Гораздо опаснее широкое условие, где каждый лишний match запускает цепочку работы — буферизацию, формирование события, сериализацию и запись файла.
Заключение
Главный вывод немного контринтуитивен. Усложнять условие не страшно, страшно его расширять. Лишняя проверка стоит немного, тогда как каждое лишнее совпадение может привести к буферизации, сериализации и записи очередного события.
У описанного подхода есть естественная граница. Все рассмотренные предикаты работают только с HTTP-трафиком — его заголовками, трейлерами и телом. Это возможно лишь потому, что Envoy уже распознал протокол и разложил данные на составляющие. Если нужный признак находится ниже уровня L7, привычные HTTP-предикаты не сработают, и задачу придётся решать другими средствами фильтрации.
Поэтому воспринимайте Tap не как инструмент мониторинга, а как скальпель для диагностики, сформулируйте узкое условие, соберите данные, проверьте гипотезу и удалите конфигурацию сразу после работы.
Примеры в статье проверялись на Envoy и Istio версии 1.28.7. Синтаксис Tap Filter относится к конкретной версии Envoy, поэтому перед применением конфигурации в другом окружении рекомендуется сверить её с API соответствующей версии.