
Я десять лет пишу десктопные приложения. За это время в компании, где я работаю, сменилось четыре системы учёта заявок. Выбирала их каждый раз компания, и каждый раз на вопрос «а может, сделать своё?» звучал один ответ: «зачем изобретать велосипед — лучше купить готовое, там уже собаку съели». Логику понять можно: своя разработка — это люди, сроки и поддержка на годы вперёд, а готовый продукт обещает всё это сразу. Но проходила пара лет, и начинались поиски следующей системы.
В какой-то момент я решил не ждать пятой и написать свою — уже по собственной инициативе, в свободное время (у нас её, скорее всего, всё равно не запустят: пришла эпоха Битрикса =). Не «убийцу Jira», а систему для обычной службы поддержки небольшой или средней организации: чтобы ей было удобно пользоваться, чтобы она не съедала сервер и чтобы её можно было поставить на ту базу данных, которая уже есть. Ниже — что из этого получилось, как устроено внутри и на какие грабли я наступил по дороге.
Сразу о главном, чтобы не возвращаться к этому в комментариях: система бесплатная — без пробного периода, без ограничений по числу пользователей и заявок — и делать её платной я не планирую. Подписку или «расширенную версию» я не продаю. Статья — про опыт и инженерные решения, ссылка на сайт одна, в самом конце.
Что не устраивало в готовых системах
Конкретные продукты называть не буду — дело не в них, а в типичных проблемах, которые повторялись от системы к системе.
Интерфейс. Чтобы создать заявку или ответить на неё, нужно было пройти пять экранов и заполнить десяток полей, половина из которых никому не нужна. Пользователи начинали писать в мессенджер «вместо системы», а исполнители переносили заявки руками.
Прожорливость. Отдельный сервер, отдельный администратор системы, свой стек, который нужно обновлять, — ради учёта заявок в отделе на тридцать человек.
Интеграции. Это то, обо что спотыкались почти всегда. Связать заявки с 1С, с внутренними отчётными приложениями, с Telegram — либо нельзя, либо через платный модуль, либо через костыль, который ломается на следующем обновлении.
С чего начал
Около года ушло не на код, а на продумывание: движок, структура базы, мелочи поведения. Логику закладывал не «как у других», а так, как, по моему опыту, удобно людям, которые пользуются системой каждый день: заявитель, исполнитель, администратор. Это не значит, что я год упорно сидел над ней: работал по настроению, а его порой неделями не было =)
Несколько принципов, от которых потом не отступал:
База данных — в центре. Вся бизнес-логика живёт в хранимых процедурах, а не размазана по коду приложения.
Две СУБД наравне: MS SQL Server и MySQL. Многие организации уже держат одну из них, и ставить вторую ради сервис-деска никто не хочет.
Работает без интернета. Интернет нужен только для того, что без него невозможно: Telegram, внешняя почта.
Ставится как обычная программа. Установщик регистрирует службу Windows, дальше всё настраивается в браузере.
Как устроено
Серверная часть — служба Windows на C++ со встроенным веб-сервером. Пишу на C++Builder: это мой основной инструмент последние десять лет, и для задачи «одна служба, которая ставится в два клика» его хватает. Веб-часть сделана на фреймворке uniGUI. Пользователи работают в браузере: основной интерфейс построен на ExtJS, там, где нужно что-то своё (например, портал для внешних заявителей), — обычный HTML и JS.
Одна логика — две СУБД
Сейчас в базе 322 процедуры и функции. Каждая существует в двух вариантах: T-SQL для MS SQL Server и диалект MySQL. Приложение при этом не знает, с какой базой работает: вызов процедуры собирается в одном месте.
// Текст вызова под текущую СУБД: в MS SQL - EXEC с параметрами, в MySQL - CALL со скобками
String __fastcall SQLProc(String proc_name, int param_count)
{
	String params = L"";

	for(int i = 0; i < param_count; ++i)
		params += (params.IsEmpty() ? (String)L"" : (String)L", ") + L":" + IntToStr(i);

	if(GlobalData()->bd_type == L"MySQL")
		return L"CALL " + proc_name + L"(" + params + L")";

	return L"Anjyta.dbo." + proc_name + (params.IsEmpty() ? (String)L"" : (String)L" " + params);
}
В коде формы это выглядит одинаково для обеих баз:
Query->SQL->Text = SQLProc(L"a_get_all_work", 11);
Звучит просто, но на практике диалекты расходятся в десятках мелочей, и каждую пришлось решать отдельно:
в MySQL нет
STRING_SPLITиINSERT ... EXEC, поэтому, например, создание задачи разделено на «ядро» с выходным параметром и обёртку;в MySQL нет параметров процедур по умолчанию, поэтому число аргументов из C++ должно совпадать с сигнатурой ровно;
сравнение строк по умолчанию не различает регистр, и там, где это важно, приходится сравнивать побайтно;
COMPRESS()в двух СУБД — разные форматы, поэтому данные между ними не переносятся, а лишь согласованы внутри каждой.
Миграции и проверка схемы
У базы есть номер версии. Обновление программы приносит пронумерованные миграции для обеих СУБД, а свежая установка сразу создаёт актуальную схему. Чтобы «свежая» и «обновлённая» базы не разошлись, я написал отдельный проверочный скрипт. Он:
ставит схему с нуля во временные базы (для MySQL поднимает отдельный экземпляр на своём порту);
вызывает каждую процедуру, на которую есть вызов в C++, — MySQL проверяет ссылки на колонки только при выполнении;
сверяет число параметров в вызовах из C++ с сигнатурами процедур;
накатывает миграции на базу предыдущего выпуска и сравнивает результат со свежей установкой.
Самая неприятная ошибка при этом была не в самом SQL.
Одна строка вместо трёх. В MySQL условное изменение схемы делается через PREPARE / EXECUTE / DEALLOCATE. Программа выполняет эту тройку по-своему и пропускала её, только если каждая команда стояла на отдельной строке. Записанная в одну строку, тройка уходила на сервер с пустой переменной, и обновление останавливалось. Проверочный скрипт гонял миграции клиентом mysql одним сеансом и ошибки не видел — нашлась она, только когда базу старой версии обновила сама программа. Вывод, который я сделал: проверочный скрипт — это хорошо, но финальная проверка обновления должна идти через само приложение.
Миллион задач
Чтобы понять, где система начнёт задыхаться, я заполнил тестовую базу миллионом задач. Результат был отрезвляющим: на MySQL список задач у исполнителя открывался 42 секунды, поиск — 52.
Причины были типичные: видимость задач собиралась объединением нескольких выборок по сотням тысяч строк, фильтры шли мимо индексов, подсчёт и страница считались каждый раз заново. После переделки отбор страницы стал общим для списка и для таймера обновления, поиск идёт сначала по подходящим названиям, а фильтры подставляются так, чтобы оптимизатор видел значения. Список на том же миллионе стал открываться за десятые доли секунды, поиск — за 2–3 секунды.
На MS SQL Server Express вылезла своя особенность: список периодически «зависал» не из-за данных, а из-за очереди на выделение памяти — запрос просил сотни мегабайт, а использовал единицы. Лечилось переписыванием выборки, а не железом.
Очередь вызовов в браузере
Ещё один урок — уже про веб-фреймворк. В uniGUI все запросы одной вкладки браузера к серверу выполняются строго по очереди. Если один из них долгий (например, обращение к внешнему сервису), вся вкладка ждёт: не нажимаются кнопки, не обновляется список. А таймеры, которые срабатывают, не дожидаясь ответа, складывают свои запросы в ту же очередь.
Правила, к которым я пришёл:
таймер отправляет следующий запрос, только когда пришёл ответ на предыдущий;
всё долгое (сетевые обращения, проверки внешних сервисов) — в фоновом потоке, а форма лишь периодически спрашивает «готово?»;
поиск по мере ввода — с паузой: запрос уходит, когда пользователь перестал печатать, а не на каждую букву.
Что умеет система
Кратко, без перечисления каждой галочки:
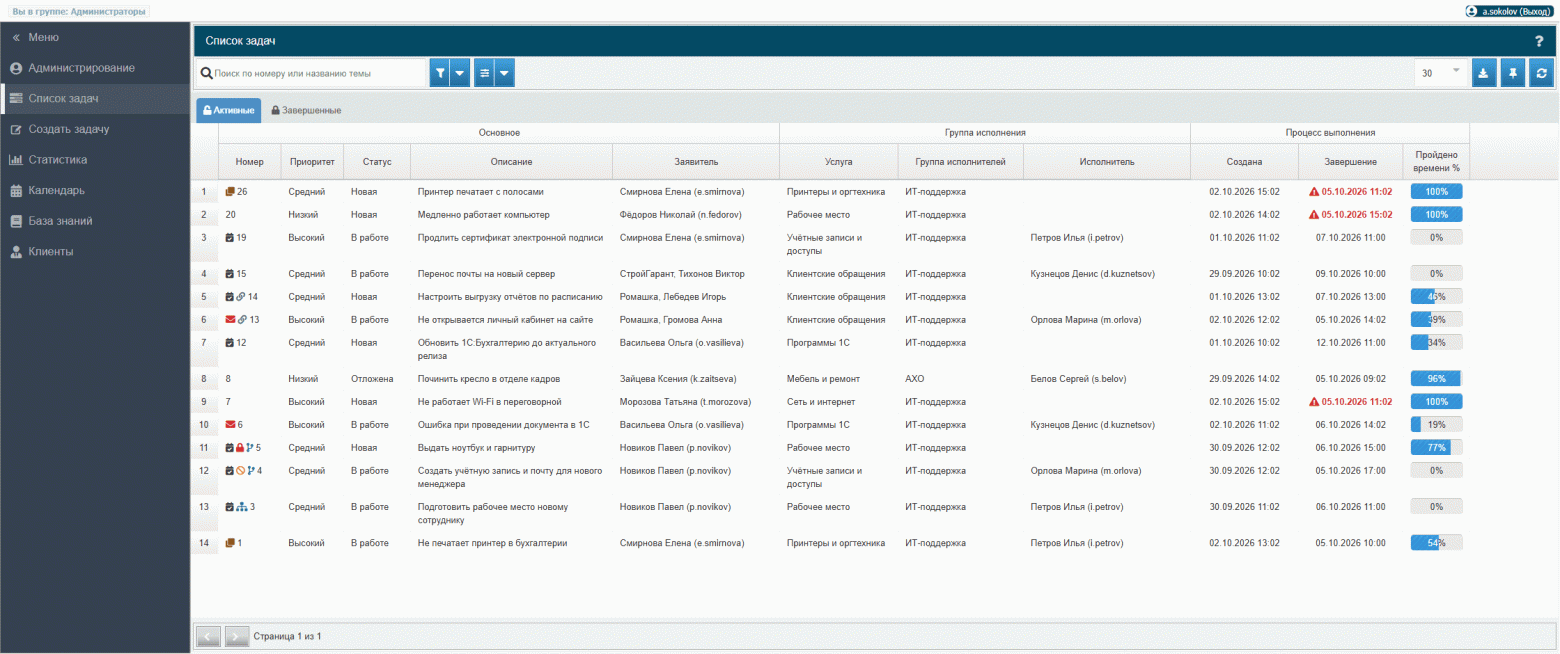
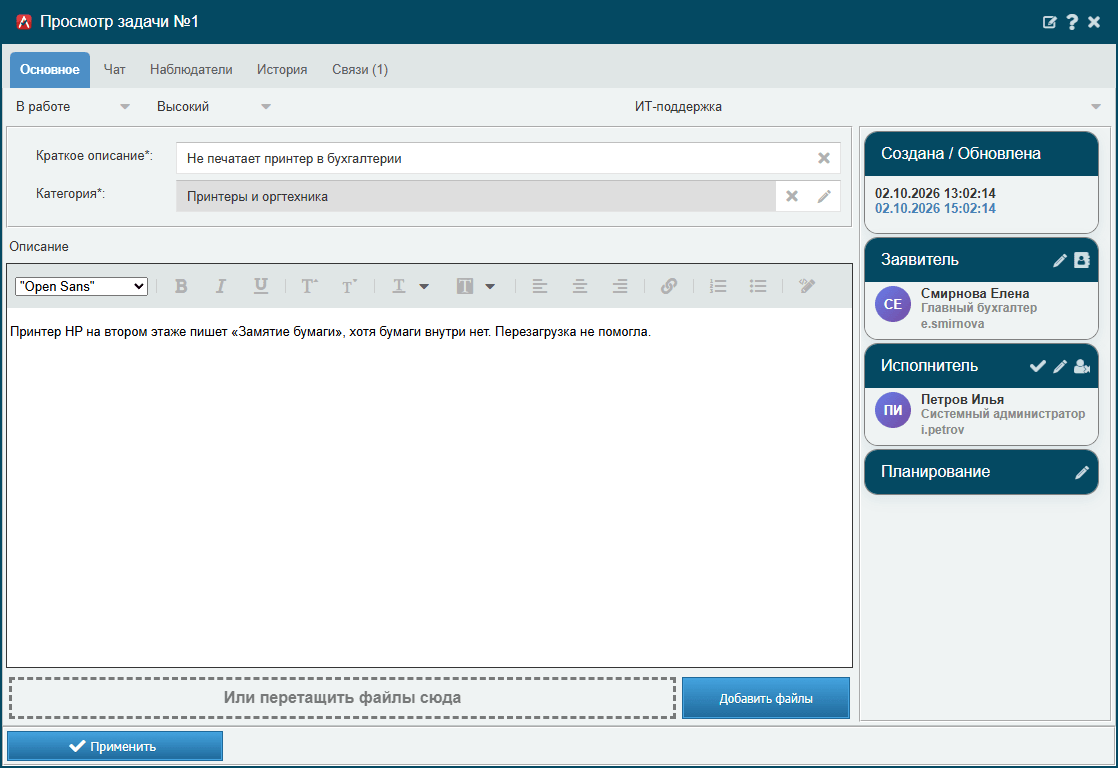
заявки с услугами, приоритетами, связями между задачами, наблюдателями и историей изменений;
сроки (SLA) по рабочему календарю организации;
база знаний, куда закрытая заявка превращается в статью;
клиенты и контакты, учёт оборудования, личные заметки исполнителей;
заявки из почты (IMAP) и уведомления на почту;
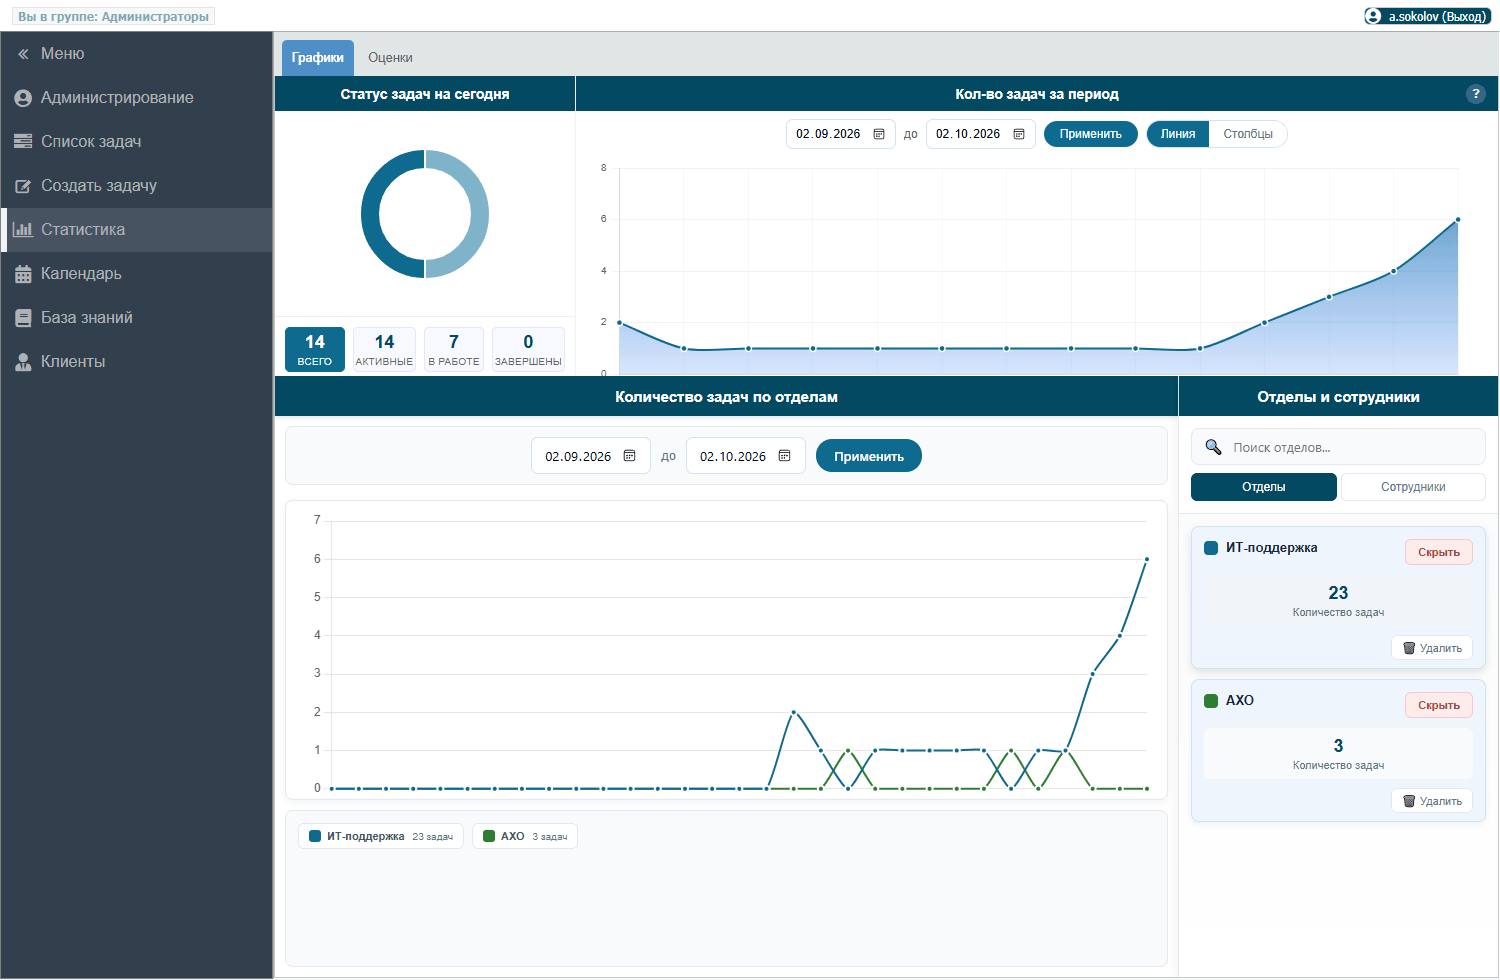
статистика и календарь.
Отдельно про интеграции — ради них во многом всё и затевалось.
REST API. Отдельный порт, ключ на пользователя, ключ показывается один раз и хранится в базе только хэшем. Через ключ видно ровно то, что видит этот пользователь в интерфейсе.
curl -H "Authorization: Bearer $API_KEY" \
  "http://server:8081/api/v1/tasks?id_status=1&limit=20"
Есть создание, изменение и удаление задач, справочники услуг, групп и пользователей. Этого хватает, чтобы связать заявки с 1С или внутренней отчётностью без доработки самой системы.
Telegram. У каждой установки свой бот (токен от @BotFather), а не общий сторонний сервис. Сотрудник привязывает аккаунт одноразовым кодом и дальше получает уведомления, создаёт задачи прямо из переписки и меняет им статус в пару нажатий.
Про ИИ в разработке
Раз уж сейчас время вайб-кодинга, скажу прямо. Архитектура, структура базы и логика поведения — мои, это и были тот год продумывания и годы опыта до него. ИИ я использовал как инструмент для рутины: перенести процедуру из одного диалекта SQL в другой, написать проверочный скрипт, найти, где ещё встречается тот же паттерн. Каждое изменение проверял сам: собрать, запустить, посмотреть в интерфейсе. На некоторых местах это сильно сэкономило время, но решения за меня он не принимал.
Дополнительные модули
Кроме основного состава есть несколько модулей:
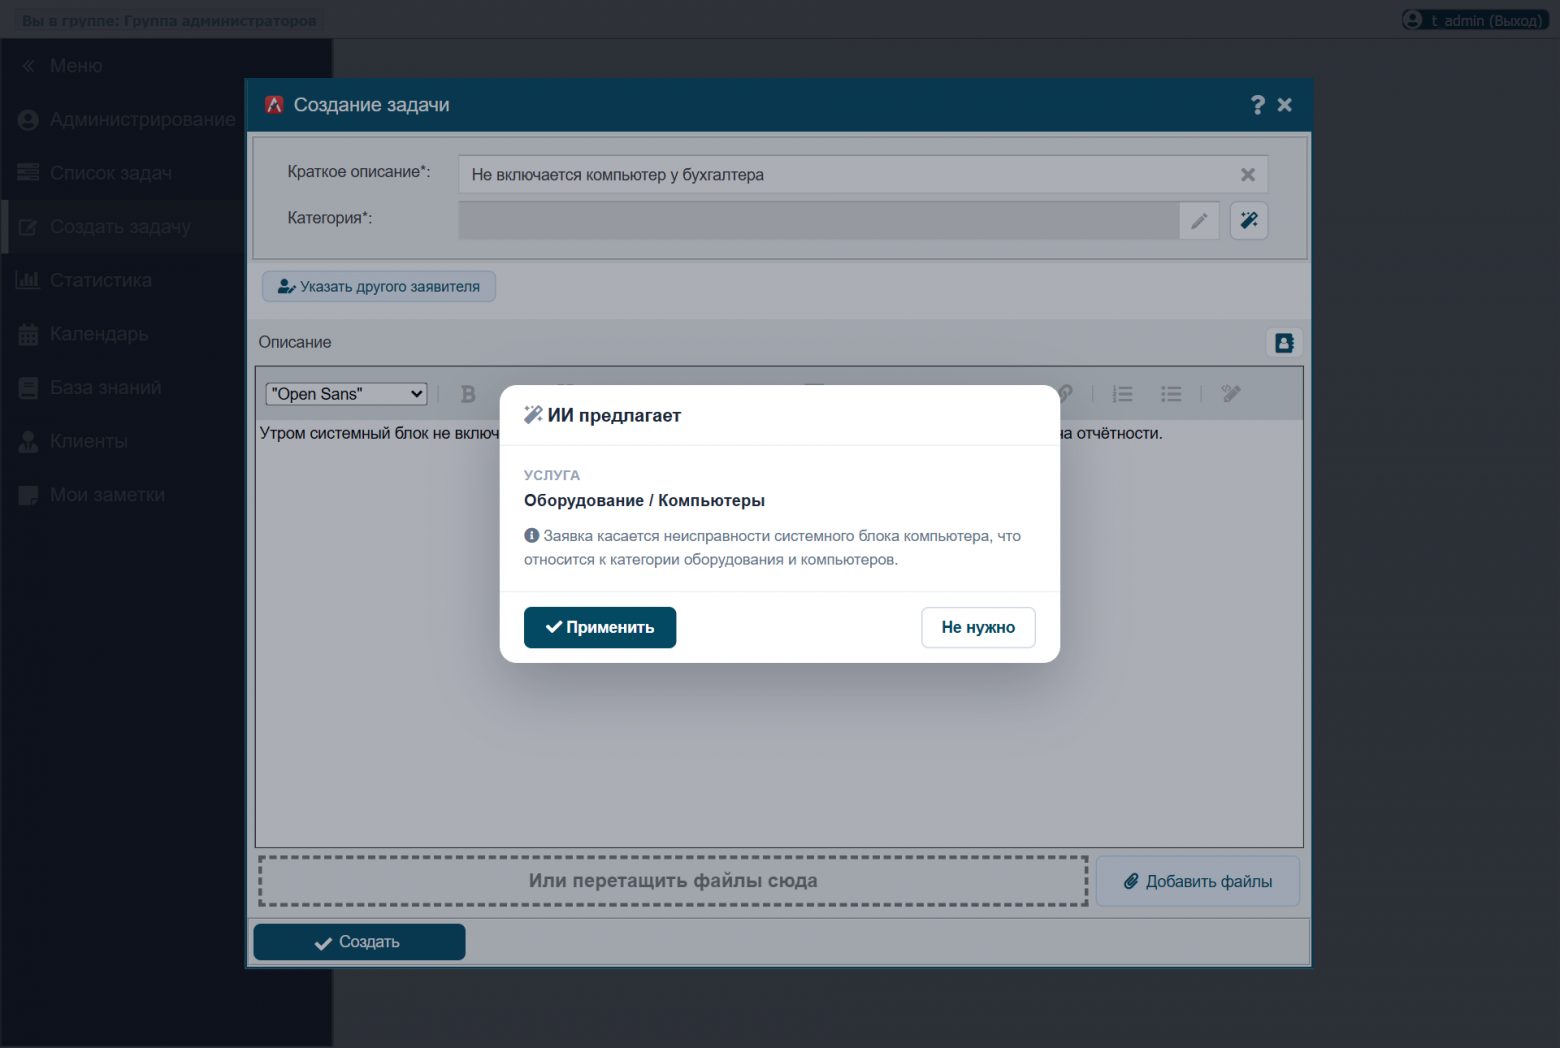
ИИ-помощник: черновик ответа, краткая суть длинной переписки, подсказка услуги и приоритета для новой заявки. Работает и с локальной моделью (LM Studio, Ollama), тогда текст заявок не уходит за пределы сети;
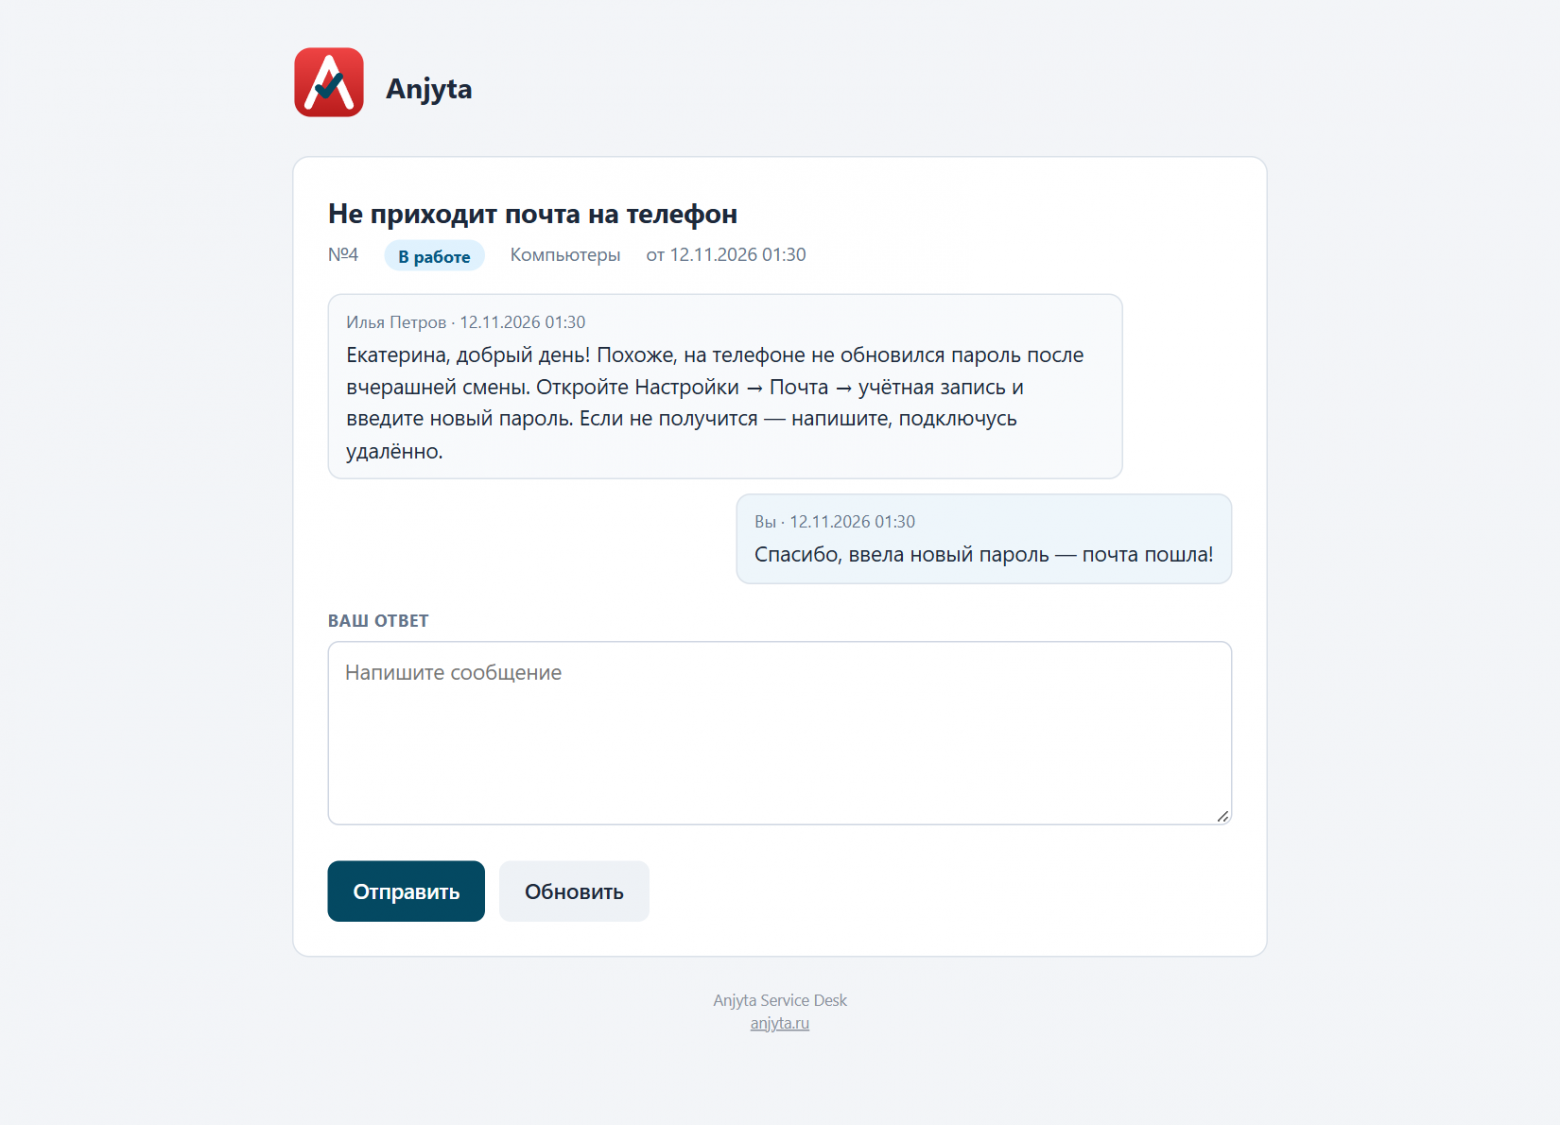
портал для заявок от людей без учётной записи — со ссылкой, по которой заявитель видит ход работы и может ответить;
отчёты по расписанию на почту руководителю;
свой логотип и название организации рядом с названием системы.
Модули тоже не продаются: за обратную связь дарю любой один на выбор. Напишите, как пользуетесь системой и чего в ней не хватает, — пришлю код активации. Новые функции и так появляются в основном по таким письмам.
Чего в системе нет
Чтобы не было разочарований:
сервер работает только на Windows (клиенту достаточно браузера);
исходный код закрыт;
интерфейс только на русском;
это не ITSM-комбайн с CMDB, change management и прочим — сознательно. Новые функции появляются по запросам тех, кто пользуется, а не впрок.
Что было после релиза
С первого выпуска прошло несколько месяцев. Рекламы не было, но понемногу набрался небольшой пул отзывов и вопросов — и, что для меня важнее всего, теперь я хотя бы знаю, что где-то система действительно работает.
Чаще всего спрашивают одно: можно ли открыть её наружу, в интернет, и на что при этом обратить внимание. Можно — в ответ я отправляю короткий чек-лист на пару минут чтения. И каждый такой вопрос заодно подсказывает, что стоит сделать в самой системе, чтобы этот чек-лист со временем становился короче.
Итог
За десять лет я понял простую вещь: «купить готовое, там уже собаку съели» работает, только если ваши задачи совпадают с задачами тех, кто эту собаку ел. Если не совпадают — вы годами подстраиваете процессы под чужую систему. Своя система тоже даётся не даром: это годы работы и ответственность за каждую ошибку. Но зато каждая её деталь сделана так, как нужно тем, кто ею пользуется.
Систему можно скачать и посмотреть на anjyta.ru. Буду рад вопросам и критике в комментариях — особенно от тех, кто тоже прошёл через несколько сервис-десков.
