

Привет, Хабр! На связи ML-команда Positive Technologies. В марте на RSAC 2026 прошло больше 570 сессий, и заметное место в программе заняли ИИ-агенты. Одни докладчики рассказывали, как с их помощью атаковать и защищать инфраструктуру, другие пытались разобраться, какие новые риски создают сами ИИ-приложения.
Мы выбрали десять выступлений и посмотрели, что за это время произошло с их прогнозами. Начнем с рисков для пользователей ИИ и разработчиков, затем перейдем к атакующим и защитникам, а в конце вернемся к событиям после конференции.
Токен, за которым не нужно идти в браузер
Представьте: на теневом форуме появились данные клиентов компании. Следов проникновения на сервер, где они хранились, нет, зато EDR заметил подозрительное обращение к памяти процесса ChatGPT на компьютере сотрудника. Оказалось, несколько месяцев назад он вставил те же данные в чат с моделью.
Похожий сценарий разбирал Стив Купчик из Lumia Security в докладе AIKatz: Attacking AI Desktop Apps for Fun & Profit. Для атаки злоумышленнику сначала нужно получить доступ к компьютеру жертвы, например с помощью трояна. Дальше он ищет в памяти настольного ИИ-приложения данные для аутентификации и использует их, чтобы обратиться к сервису от имени пользователя.
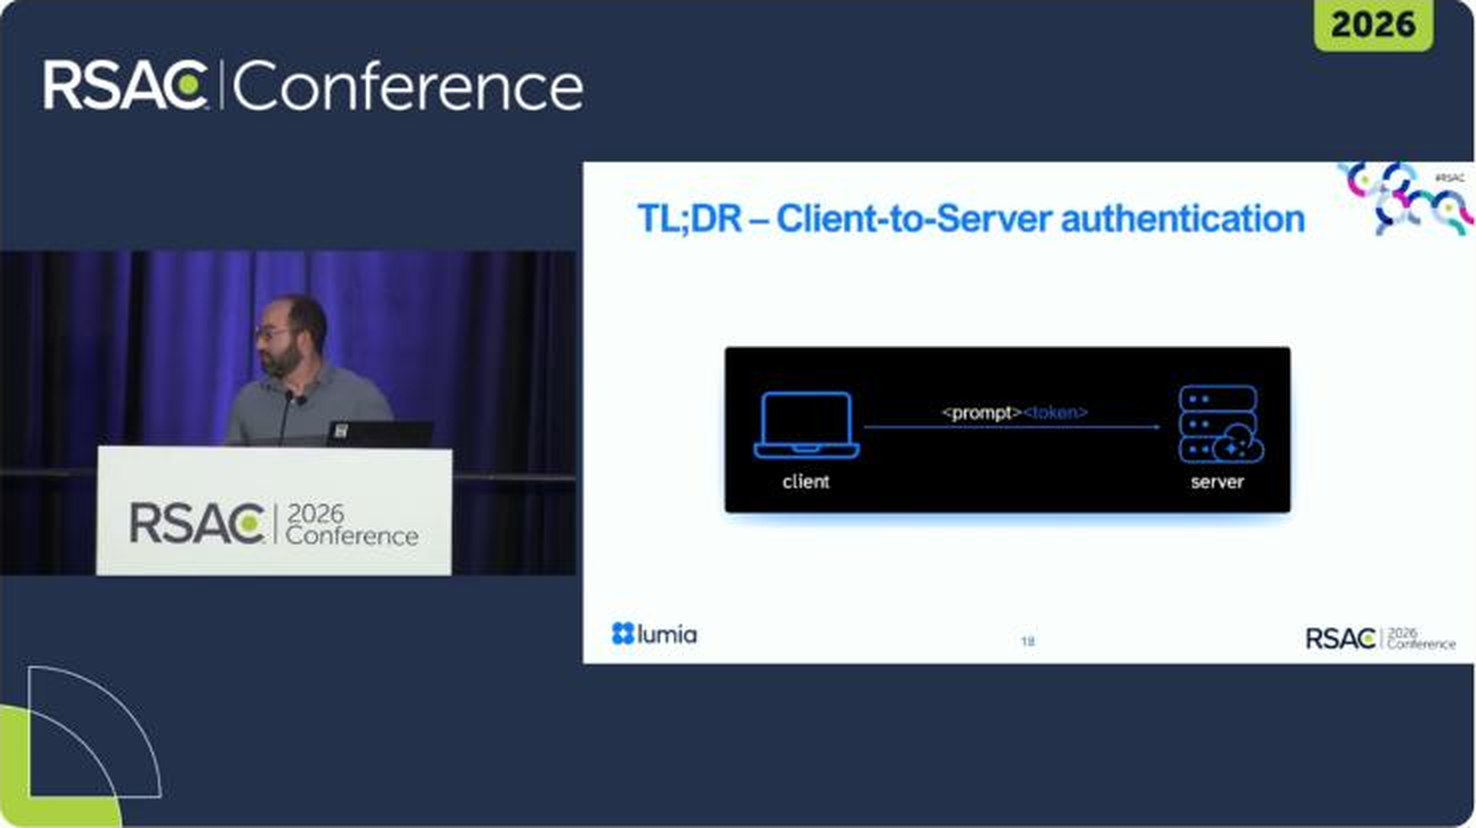
В описанном исследователями эксперименте из памяти ChatGPT и Copilot извлекали токены, а из Claude получали ключ сессии, хранящийся в cookie. Добычу можно искать по характерным фрагментам: например, у JWT предсказуемый формат. Саму историю чатов из памяти доставать необязательно: с действующей сессией ее можно запросить у сервиса.
Чтением переписки возможности не ограничиваются. В зависимости от приложения атакующий может менять или удалять сообщения, а также пытаться повлиять на будущие ответы модели. Но способ зависит от того, как устроен конкретный чат. В исследованных версиях ChatGPT и Claude история хранится ветвями, и следующее сообщение пользователя могло увести разговор обратно в исходную ветку. Для более устойчивого воздействия исследователь использовал функцию памяти: просил модель сохранить инструкцию, а затем скрывал следы изменения в переписке. Это не означает, что любая вставленная инструкция сработает во всех будущих ответах.
ИИ-приложение может дать атакующему доступ и к другим данным, если они доступны через его интеграции. Например, в Microsoft 365 Copilot исследователи описывали возможность извлечь из приложения отдельные токены OneDrive или SharePoint. Какие именно сервисы окажутся доступны, зависит от приложения, выданных прав и других условий; один токен чата не открывает автоматически все подключенные сервисы.
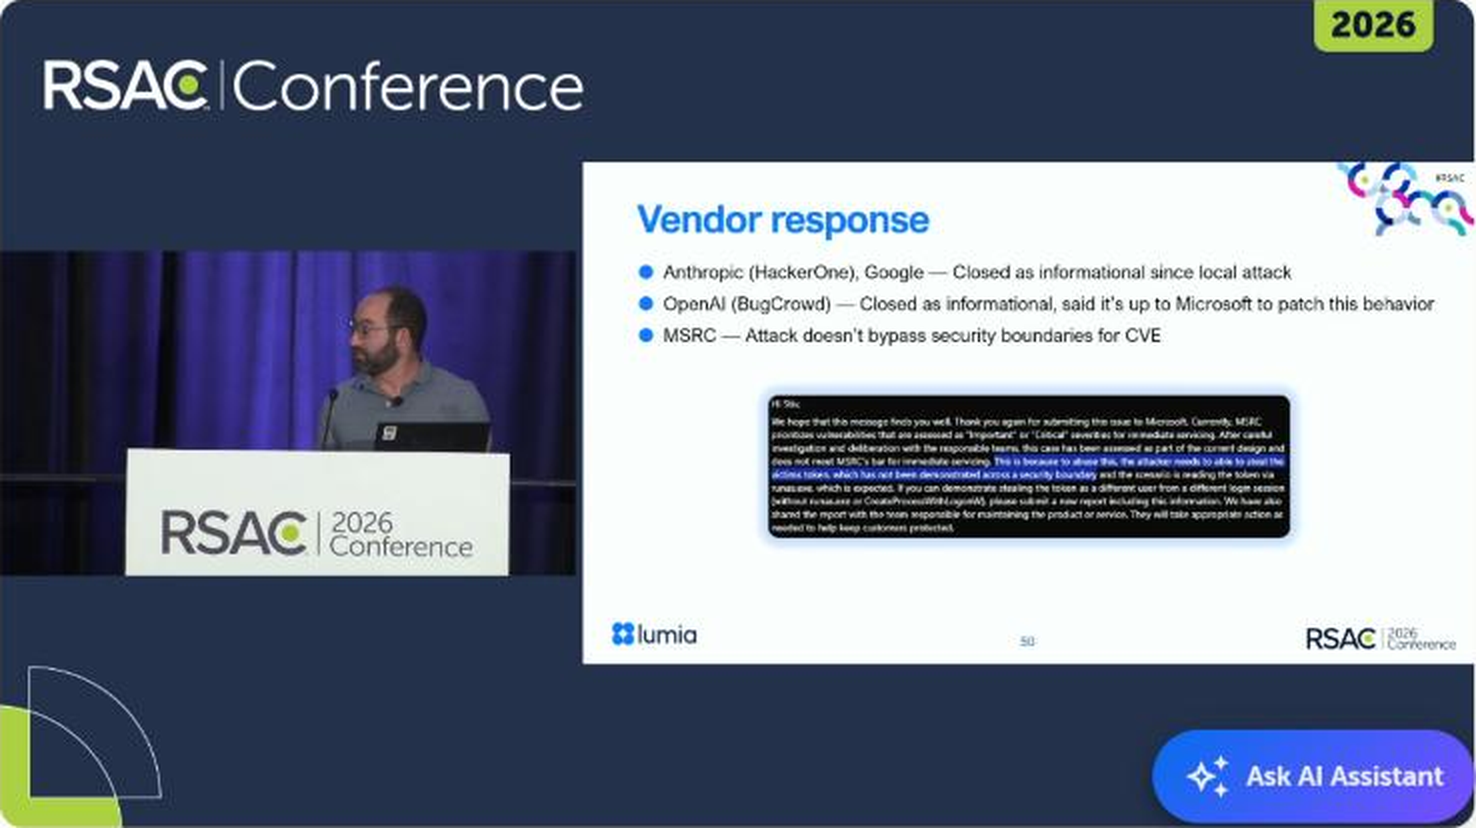
Авторы сообщили о результатах Microsoft, Anthropic и OpenAI. Компании закрыли эти отчеты как информационные: в частности, Microsoft указала, что доступ к памяти процесса в той же пользовательской сессии не пересекает границу безопасности. OpenAI, со своей стороны, предложила обратиться к Microsoft с вопросом об архитектуре Windows.
Отдельно Lumia описала DLL hijacking, обнаруженный при анализе Claude: загрузку отсутствующей библиотеки инициировал графический драйвер Intel. При определенных условиях подставленная DLL позволяла нарушить изоляцию между пользователями. Об этой находке сообщили Intel, где ее признали дубликатом более раннего отчета. Публичное описание относится к 2025 году, поэтому делать по нему вывод о состоянии всех актуальных версий приложения и драйвера нельзя.
Для защиты исследователи предлагают ограничивать доступ к памяти процессов ИИ-приложений с помощью security descriptors и следить за подозрительными обращениями к ним. Но это не замена защите рабочего места: атака начинается уже после его компрометации. Настройки доступа к процессам также стоит проверять на совместимость с приложением и средствами администрирования.
Пакет, которого не существует
Иногда ИИ-помощник предлагает установить библиотеку, которой никогда не было. Если модель регулярно выдумывает одно и то же название, атакующий может зарегистрировать его в реестре пакетов и разместить там вредоносный код. Так устроен slopsquatting.
На RSAC Джо Спраклен представил исследование, выполненное вместе с коллегами для USENIX Security 2025. Авторы проверили 16 моделей на задачах для Python и JavaScript. Всего получилось 576 тысяч образцов кода и около 2,23 млн рекомендаций пакетов.
Из них 440 445 рекомендаций, или 19,7%, относились к несуществующим пакетам. Исследователи насчитали 205 474 уникальных выдуманных имени. Для проверенных коммерческих моделей средняя доля составила не менее 5,2%, для открытых моделей показатель достиг 21,7%. Лучший результат в той выборке показала GPT-4 Turbo с 3,59%.
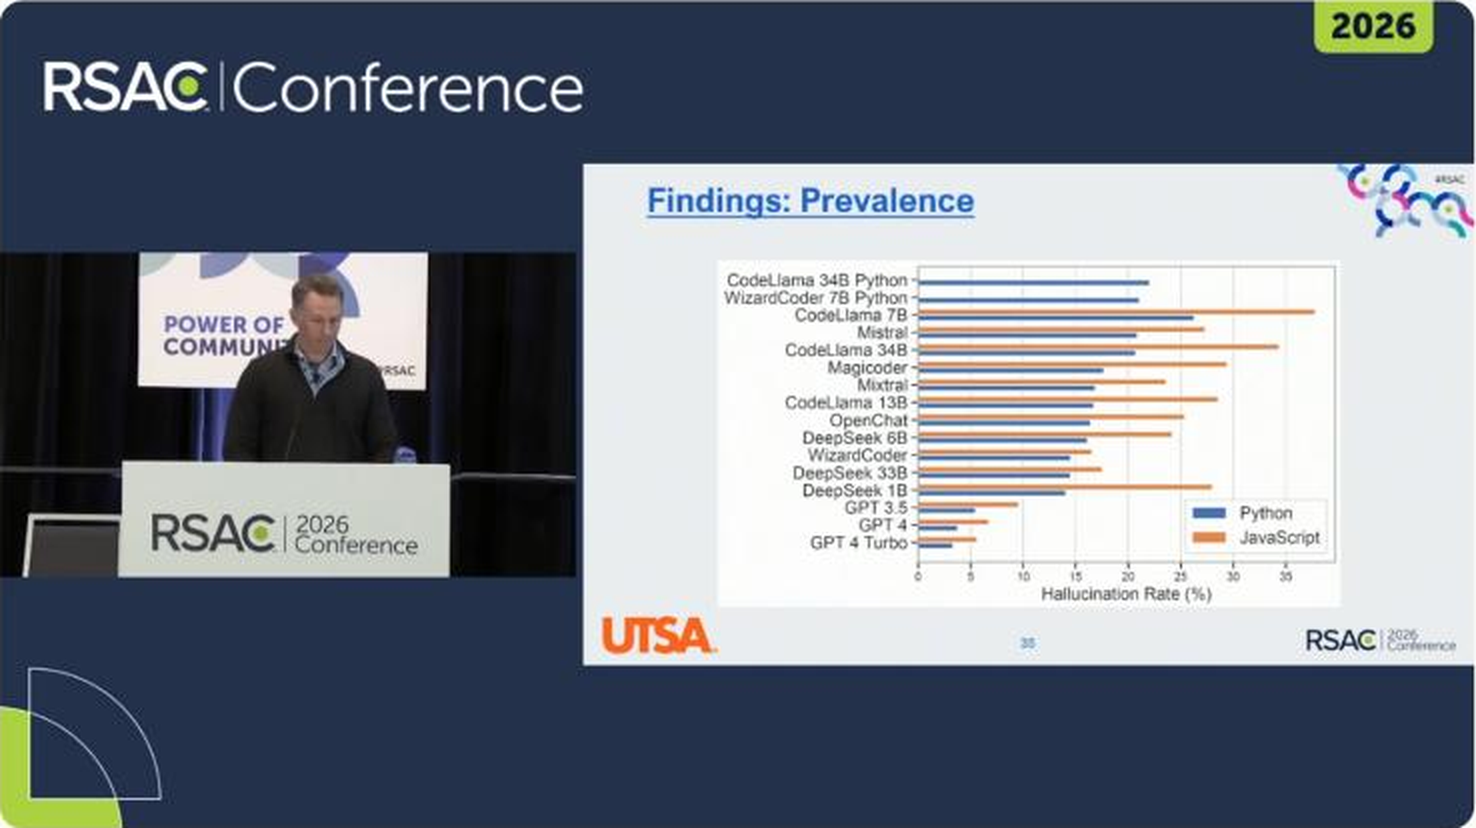
Важна дата: исследование опубликовано в 2025 году и сравнивает конкретные модели и настройки того времени. Эти проценты не описывают все нынешние ИИ-инструменты. Кроме того, речь идет о доле рекомендованных названий, а не о доле пользователей, которые установили вредоносный пакет.
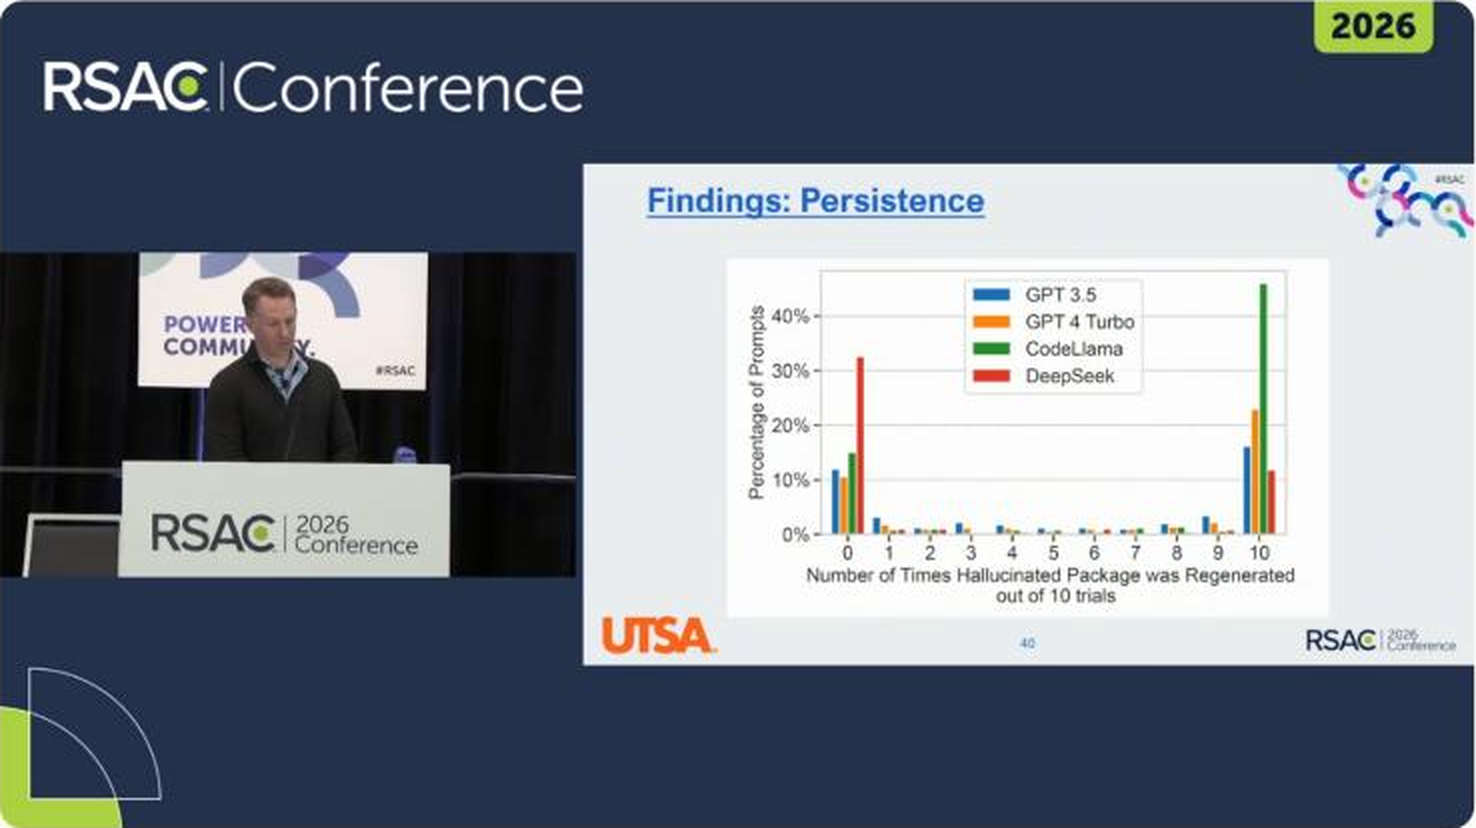
Авторы проверили и повторяемость ошибок. Они взяли 500 промптов, на которых модели уже придумали пакет, и повторили каждый десять раз. В 43% случаев то же имя появлялось во всех десяти ответах, а в 58% случаев больше одного раза. Такая повторяемость делает атаку практичнее: злоумышленнику не обязательно угадывать случайное название, если его можно заранее получить от модели.
Среди способов уменьшить число галлюцинаций проверили RAG, самопроверку и дообучение. Для RAG модели передавали найденные в базе сведения об известных пакетах. Это помогло обеим проверенным моделям: у DeepSeek Coder 6.7B доля галлюцинаций снизилась с 16,14% до 12,24%, у CodeLlama 7B показатель упал с 26,28% до 13,40%.
Дообучение снизило эти показатели сильнее, до 2,66% и 10,27% соответственно, но результаты на HumanEval тоже упали. У DeepSeek доля решенных задач уменьшилась с 51,4% до 25,3%, у CodeLlama она снизилась с 19,6% до 16,4%. Подробности и методика есть в статье USENIX.
Вывод для нас такой: RAG помогает модели реже придумывать пакеты, но сам по себе не гарантирует безопасность зависимости. Зарегистрированный атакующим пакет уже существует, поэтому помимо проверки имени нужны проверка происхождения, репутации и содержимого пакета, а также контроль установки зависимостей.
Копирует хорошо, изобретает плохо?
Вопрос безопасности сгенерированного кода разобрали Эяль Паз и Нир Задок из OX Security в докладе с прямым названием: «Код ИИ действительно более уязвим, чем код человека?»
По словам докладчиков, они изучили больше 300 открытых приложений, в том числе более 50 созданных с помощью вайб-кодинга. Среди характерных проблем они называют избыточные комментарии, решения под один конкретный случай, повторное появление исправленных ошибок и склонность добавлять патч поверх патча вместо переработки архитектуры. Тестов при этом может быть много, но это не гарантирует, что они проверяют сложные случаи.
Чтобы посмотреть на уязвимости, авторы предложили Cursor, Claude и Codex реализовать один и тот же сервис. В получившихся приложениях они нашли знакомые ошибки: open redirect, path traversal и межсайтовый скриптинг. Докладчики также привели примеры уязвимостей в открытых проектах, которые описываются как созданные с помощью вайбкодинга.
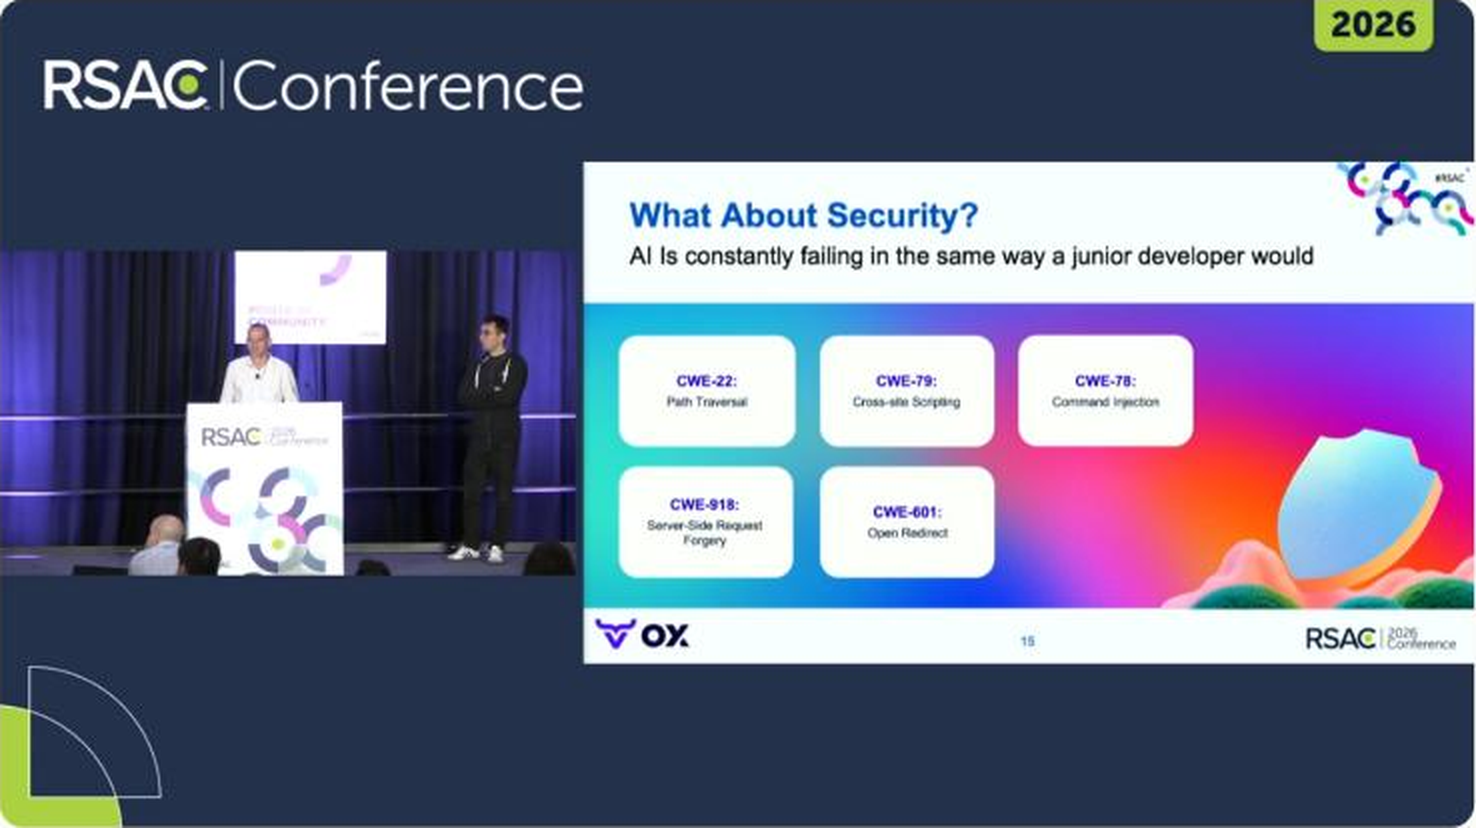
Показательный результат, но ответить на вопрос из заголовка доклада он не позволяет. Примеры показывают, что ИИ может воспроизводить известные ошибки. Сравнимой оценки того, насколько часто такие ошибки встречаются в сопоставимом коде людей и моделей, докладчики не привели. Нам также не хватило подробной методики проверки репозиториев.
При этом скорость генерации сама по себе меняет масштаб задачи. Даже если доля ошибок не растет, проверять приходится больше кода. А хорошая демонстрация приложения еще не означает, что в нем проверены права доступа, обработка недоверенных данных и поведение в продакшене.
Киберпреступник и его агентная команда
Стивен Хилт и Роберт Макардл из TrendAI в докладе VibeCrime рассуждали о том, как ИИ может изменить уже существующий рынок киберпреступных услуг.
Сегодня злоумышленнику не обязательно самостоятельно писать шифровальщик, искать первоначальный доступ и строить инфраструктуру: многое можно купить как услугу. ИИ добавляется к этой схеме как инструмент для подготовки фишинга, написания кода, обработки украденных данных и общения с потенциальными жертвами.
Есть и сервисы, которые продаются как криминальные LLM. Это не обязательно самостоятельно обученные модели: под такой вывеской могут скрываться существующие модели с отключенными ограничениями или сервисы, которые перенаправляют запросы к другим поставщикам. Сам рынок появился не вчера: например, WormGPT рекламировали еще в 2023 году.
Следующий шаг, который обсуждают авторы, они называют cybercrime-as-a-sidekick. Человек задает цель, а оркестратор распределяет работу между агентами. Один собирает сведения, другой ищет возможные точки входа, третий готовит инструменты. В отличие от жестко заданного сценария, система может менять дальнейшие действия в зависимости от результатов предыдущих.
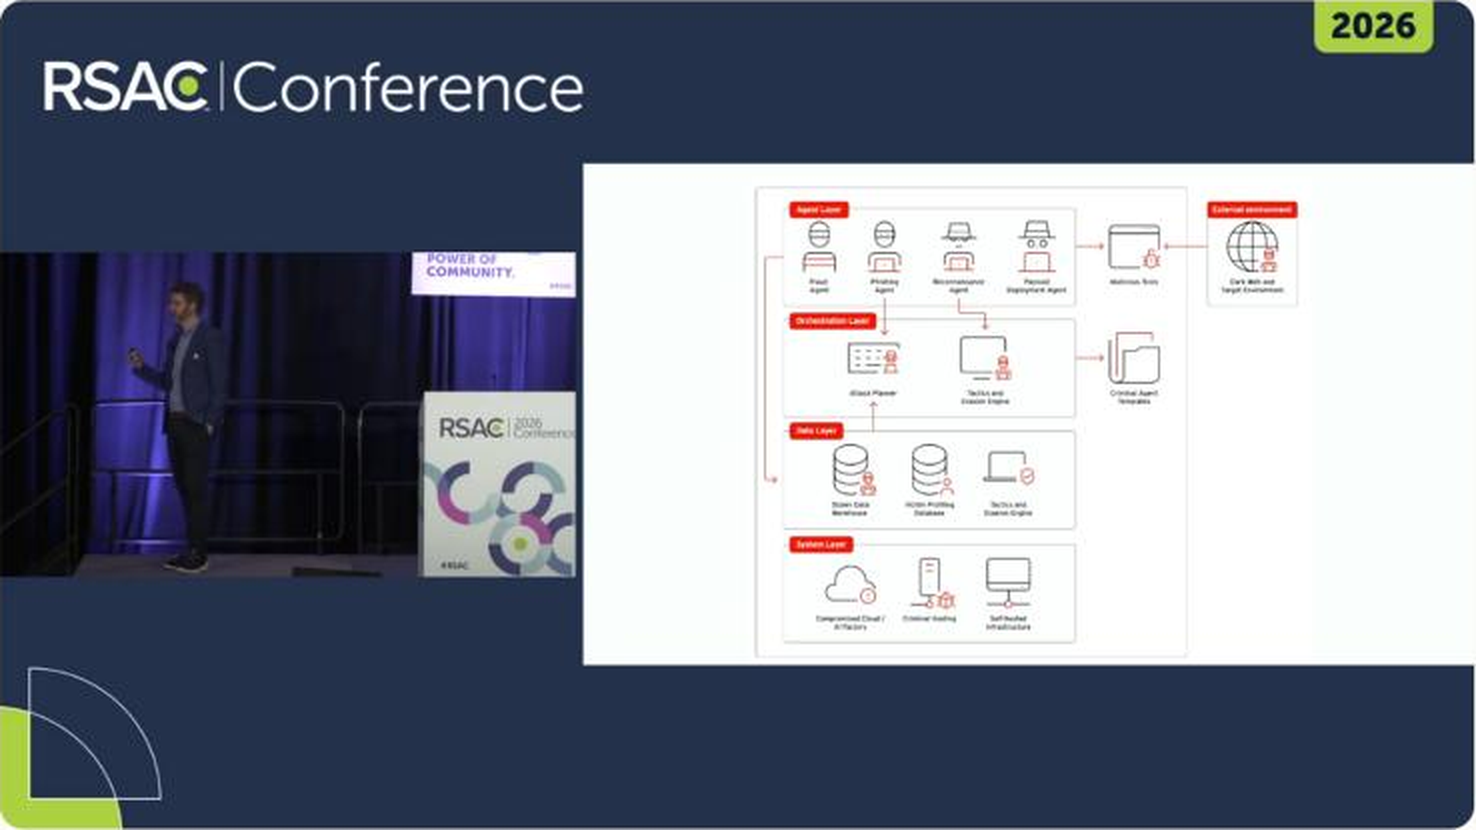
Авторы ожидают от этого масштаба и гибкости, а также появления схем, которые раньше не окупали ручной труд. Например, агенты могут собрать сведения из нескольких источников, связать номер машины с данными владельца и подготовить персонализированное мошенническое сообщение. Это сценарий возможной атаки, а не подтверждение того, что описанная цепочка уже применялась именно в таком виде.
Насколько быстро преступники перейдут к агентам, авторы связывают с экономикой: новая схема должна упрощать работу или приносить больше денег, чем существующая. Сам по себе интерес к технологии не заставит группировку отказываться от прибыльного процесса.
На конференции доклад был прежде всего прогнозом. Ниже мы вернемся к тому, что исследователи обнаружили уже после RSAC.
Найти точку входа: задача агента
Если TrendAI рассматривала агентов на стороне атакующих, то Эрик ван Бюггенхаут и Йерун Ванделер из NVISO и SANS предложили использовать их для проверки собственной защиты. Их доклад продолжает серию выступлений об always-on purple team.
Purple team соединяет работу атакующих и защитников: команда проводит согласованные проверки и смотрит, что заметили средства защиты, а какие действия прошли мимо. Ранее авторы автоматизировали часть такого процесса после получения первоначального доступа. Теперь они предложили добавить агентов и к поиску точки входа.
Задумка выглядит так: человек задает цель, агент собирает сведения и предлагает возможные подходы. Затем оператор выбирает стратегию и подтверждает план; после этого система выполняет согласованные действия и передает результаты в существующий процесс проверки детектов.
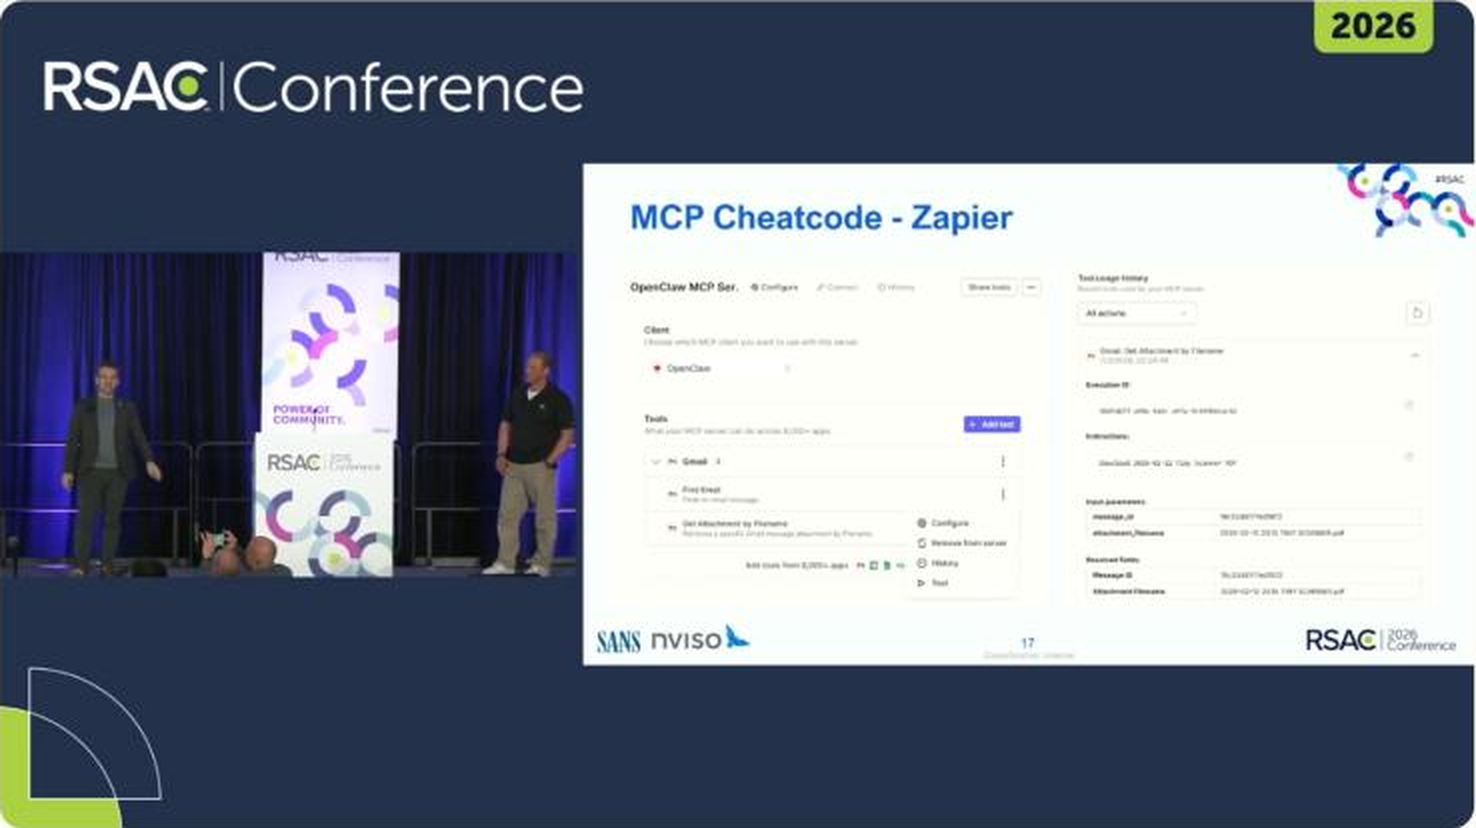
В демонстрации показали более узкую задачу. Агент на GPT-5, запущенный через OpenClaw и Telegram, использовал Kali Linux и theHarvester для OSINT-разведки тестовой цели. Он также обнаружил и исправил проблему с MCP-сервером. Полную цепочку от разведки до получения доступа в демонстрации не показали, а сами авторы называли решение экспериментом.
Для подключения инструментов в такой системе можно использовать MCP, а для взаимодействия агентов — A2A. В качестве примеров докладчики упоминали Kali, Caldera и Zapier с его готовыми интеграциями. Но выбор протокола и число подключенных инструментов еще не отвечают на вопросы, которые важны для эксплуатации: какие действия агенту разрешены, кто их подтверждает, как ограничить область проверки и по каким метрикам оценивать результат.
Нам нравится идея постоянной проверки защиты, а не редкого запуска разрозненных тестов. Но до оценки работающей системы хотелось бы увидеть полное выполнение сценария, результаты на нескольких целях и правила, ограничивающие самого агента.
Агент, который не спит
Эрез Харуш из Wiz в выступлении AI Agents Never Sleep разбирал обратную задачу: как построить агента для расследования алертов в SOC.
Исходная проблема знакома многим командам. Аналитикам приходится разбирать большой поток сработок, переходить между консолями и собирать контекст, а знания о прошлых расследованиях часто остаются у отдельных сотрудников. Wiz предлагает поручить часть этой работы агенту с доступом к нужным инструментам и плейбукам.
На слайдах компания приводит собственные ориентиры: 3000 расследований в месяц на команду, от 3 до 20 минут на вердикт и от $0,5 до $1,5 за расследование. Также заявляется покрытие всех алертов. Это данные вендора; без методики сравнения и результатов независимой проверки по ним нельзя определить, сколько угроз система пропускает и насколько хорошо работает в другом SOC.
Интереснее описание того, как агенту помогают не потеряться в расследовании:
Ограничивают роль и инструменты. Когда агенту сразу дали около 30 инструментов, он путал их назначение. Добавление примеров маршрутизации в описания, по словам докладчика, повысило точность выбора примерно с 60% до 95% в приведенной проверке. Навыки предлагается подгружать по мере необходимости.
Управляют контекстом. Историю расследования сжимают, важные сведения сохраняют в состоянии, а отдельные задачи отдают субагентам. В одном из неудачных примеров агент к восьмому шагу забыл, с какого алерта начал расследование.
Добавляют контрольные точки. Агент периодически пересматривает найденное, обновляет состояние и решает, нужна ли следующая проверка или уже можно сформулировать вердикт.
Передают знания аналитиков через плейбуки. Они помогают понять, с чего начать и какие признаки отличают реальную угрозу от безобидного события.
Проверяют изменения. Для оценки предлагают размеченный экспертами набор расследований, мониторинг в продакшене и анализ ошибок, в том числе потери контекста, пропущенных доказательств, времени работы и расходов.
Возвращают обратную связь в систему. Реальные случаи и замечания аналитиков используют для обновления знаний и проверки следующих версий.
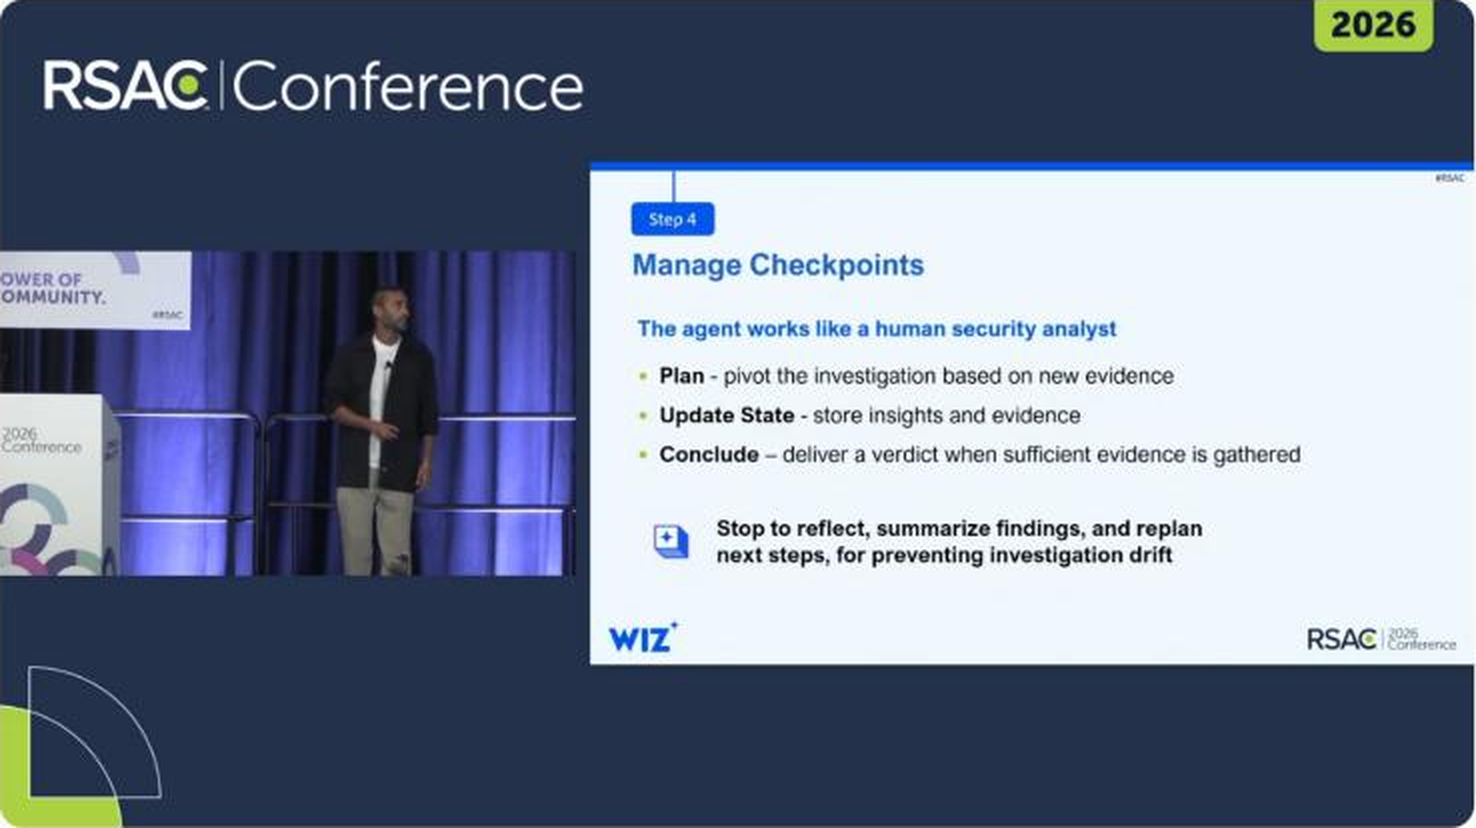
Отдельный совет докладчика касается промптов: их стоит версионировать и проверять после изменений, как и код. Удачное демо не показывает, что произойдет на редком типе алерта или при неудачном ответе одного из инструментов.
Ассистент в карточке инцидента
Анкит Гупта и Шилпи Миттал в докладе We Put AI in Our SOC выбрали более ограниченную роль для модели. Вместо автономного аналитика они встроили помощника в карточку кейса: он собирает сведения, пишет сводки и предлагает следующие шаги, а решение остается за человеком.
Ассистент получает ограниченный набор данных по делу и должен подкреплять выводы ссылками на доказательства. Это важно и для доверия, и для проверки: аналитик может перейти к исходному событию, а не принимать уверенно написанную сводку на веру. На раннем этапе системе оставили доступ только на чтение; действия через инструменты требовали отдельного контроля и одобрения.
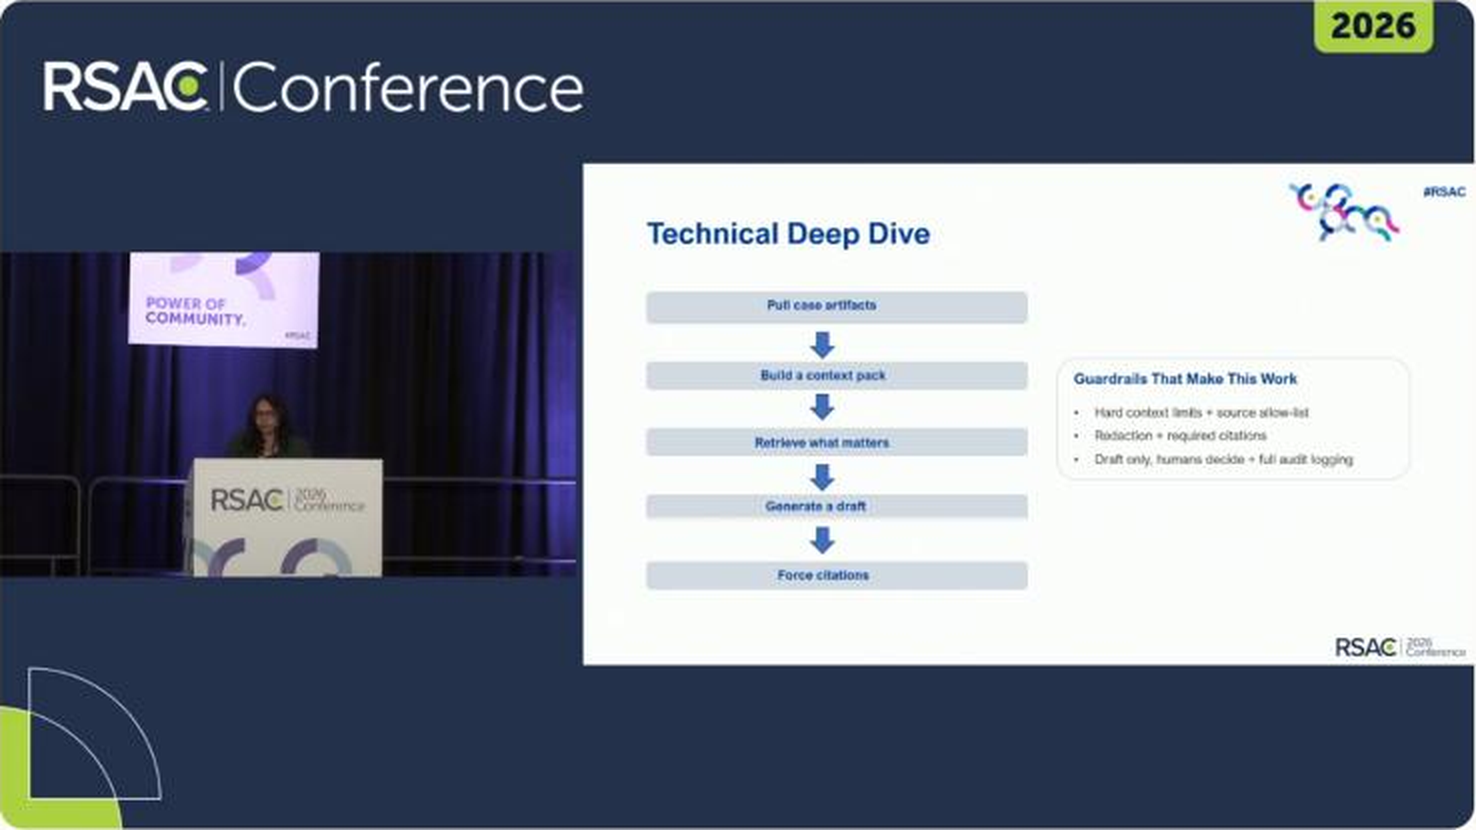
В качестве примера докладчики приводили подозрительный запуск PowerShell из Outlook. Предложение сразу изолировать хост при ложном срабатывании само может создать проблемы. Поэтому рекомендация формулируется с условием: сначала проверить дополнительные признаки, например латеральное перемещение.
Авторы привели анонимизированные показатели: время до триажа снизилось с 42 до 27 минут, а время до закрытия кейса — с 3,2 до 2,5 часа. При этом они предлагают использовать цифры как пример отчетности, а не универсальный ориентир. Без данных о составе выборки и качестве решений нельзя утверждать, что модель стала находить больше атак или пропускать меньше.
При внедрении команда столкнулась с пропущенными полями, разными идентификаторами одного объекта, промпт-инъекциями в логах и тикетах, задержками и лимитами запросов. Часть проблем решалась до обращения к модели: данные нормализовали и обогащали, а недоверенный текст отделяли от инструкций. Для пиков нагрузки добавляли асинхронную обработку, кэш и возможность отключить систему.
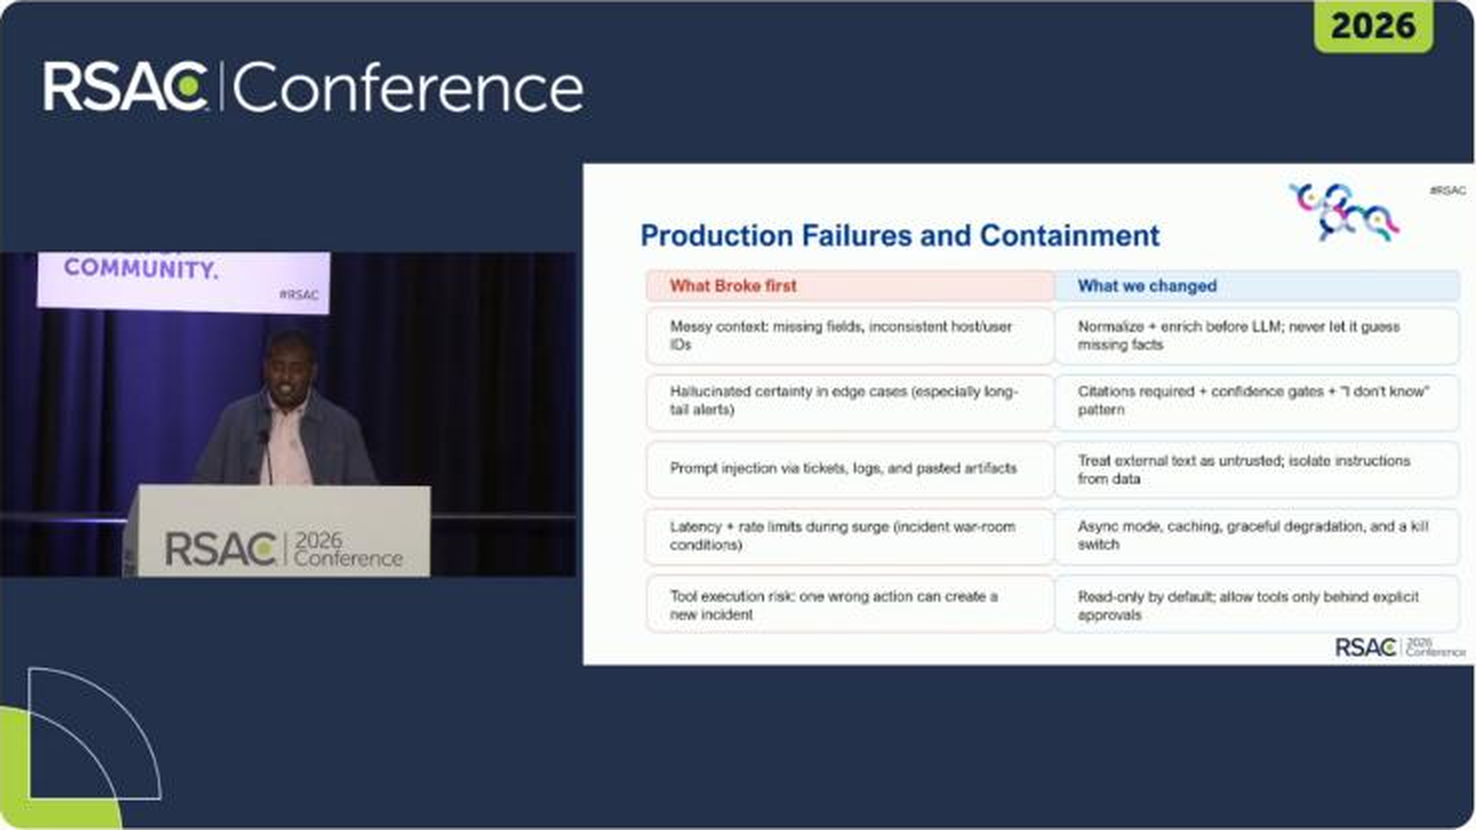
Иногда ответ выглядит как галлюцинация модели, хотя причина в другом слое: коннектор вернул неполные данные или изменился формат поля. Поэтому проверять нужно всю цепочку, включая интеграции и источники доказательств. И наоборот, цитата из лога сама по себе не доказывает правильность вывода: она лишь позволяет аналитику его проверить.
В ответах на вопросы докладчики уточнили, что речь шла о шестимесячном проекте на стадии оценки. Нам это кажется важной оговоркой: перед нами не доказательство того, что любой SOC получит те же результаты, а набор практик, которые стоит проверять на собственных данных.
Считать инциденты, а не только алерты
Дори Фишер из Swordfish в докладе о детекторах SOC разобрал год данных крупного MSSP-провайдера. По его словам, сработки поступали примерно от 250 продуктов порядка 80 вендоров; после обработки для анализа осталось 82 620 записей.
Одна из неприятных цифр: за год ни одной подтвержденной угрозы не дали 93,4% правил на основе ML или анализа поведения и 94,7% статических правил. Но отсутствие подтвержденной угрозы не означает автоматически, что правило бесполезно. Оно может ловить редкое событие, быть избыточным или срабатывать на активность, которую уже обнаружил другой детектор.
Есть и проблема учета повторов. Одна атака способна вызвать множество алертов, но инцидент аналитик заведет по одному или нескольким из них, а остальные отметит как дубликаты. Статус закрытия отдельной сработки поэтому не всегда отражает, помогла ли она обнаружить атаку.
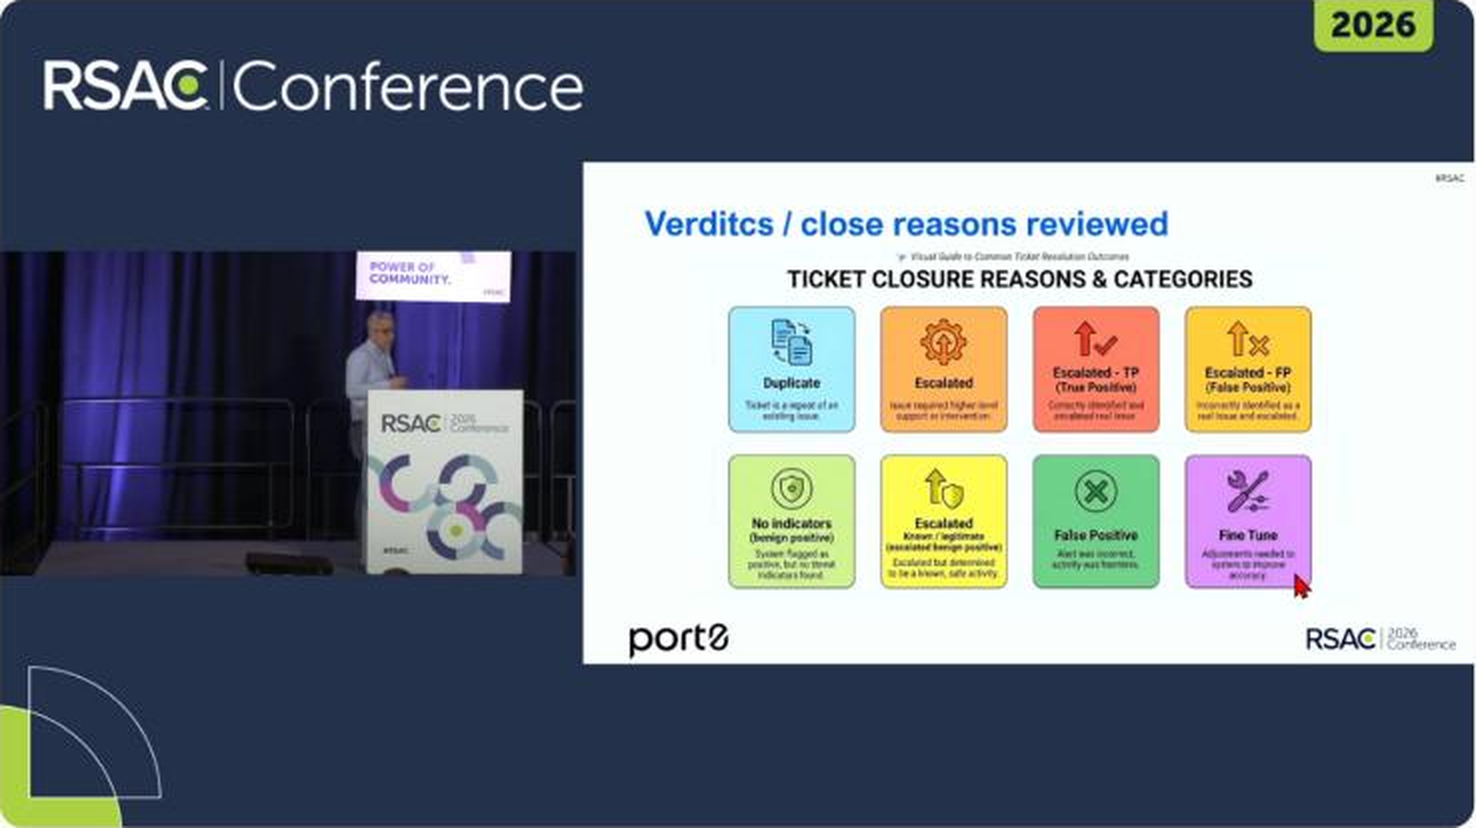
Фишер предлагает смотреть на результат на уровне инцидента: был ли он найден, сколько прошло до первого полезного сигнала, сколько алертов породила атака и сколько времени ушло у аналитика. Важно и то, добавляет ли новый детектор что-то к существующему покрытию. Очень точное правило может находить те же события, что уже обнаруживаются другими средствами.
В рассмотренных данных ML-детекторы, настроенные SOC, показали более высокую долю подтвержденных угроз, чем некоторые другие группы правил. Но по одним этим цифрам нельзя установить, что именно ML или настройка под заказчика обеспечили разницу: категории могли отличаться по трафику и задачам. Для практического решения нужны и качество обнаружения, и пропуски, и стоимость расследования.
Наш вывод: если сигналов уже много, новый детектор стоит оценивать вместе с тем, как SOC будет сопоставлять и обогащать его сработки. Иначе можно получить еще одну консоль и еще больше работы для аналитика.
Один гейтвей для разных правил
Инженеры Uber Цзюньянь Го и Лэй Сунь в докладе об AI Guard рассказали, как компания централизовала часть проверок для ИИ-приложений.
У разных сервисов разные допустимые сценарии. Например, помощнику службы поддержки и инструменту для специалистов по безопасности могут требоваться разные правила обработки вопросов об эксплуатации уязвимостей. Если каждое приложение реализует защиту отдельно, настройки сложно поддерживать и проверять единообразно.
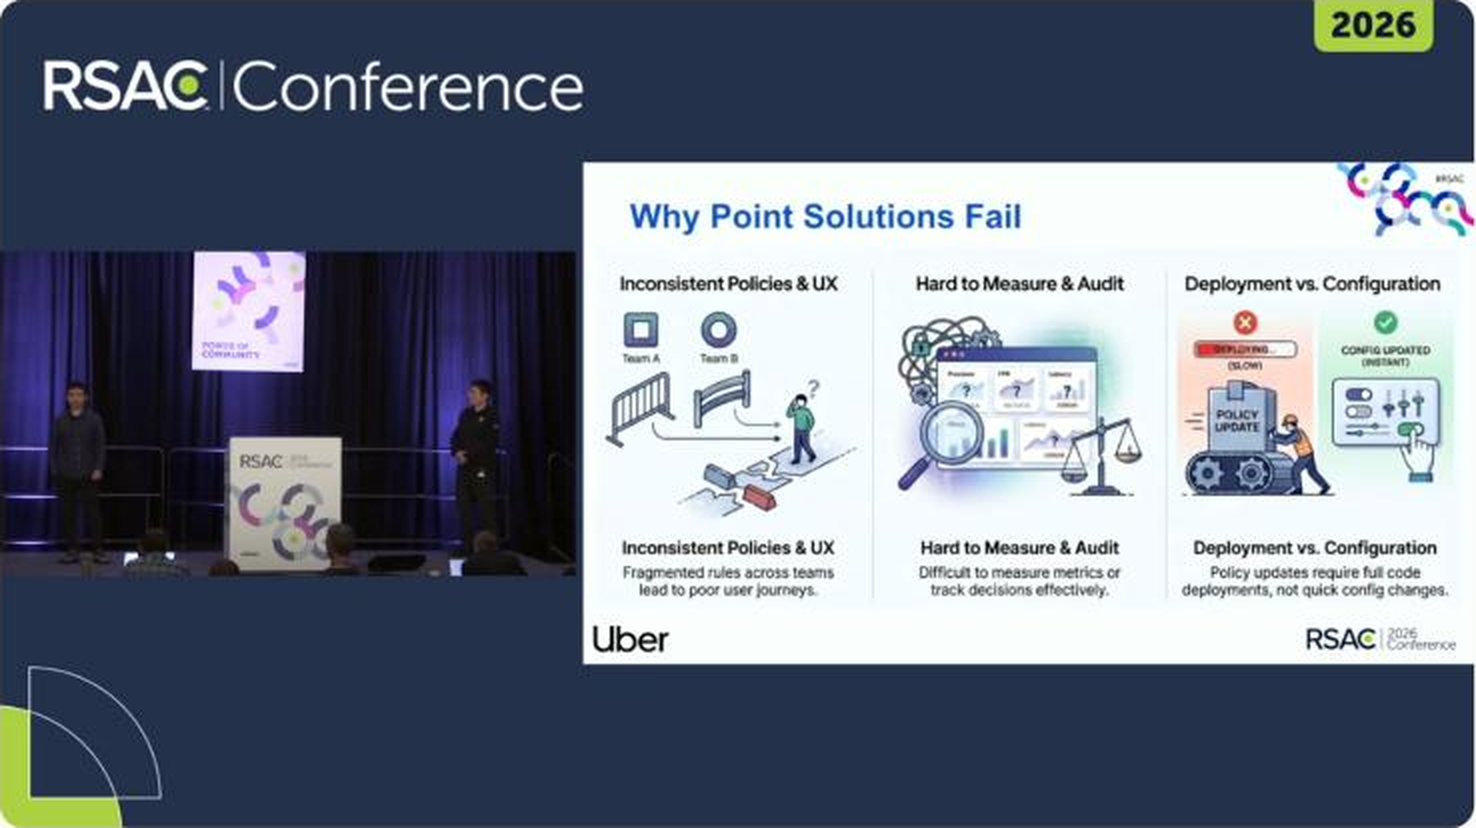
AI Guard встроен в корпоративный гейтвей, через который приложения обращаются к моделям. В описании докладчиков систему можно разделить на три части: детекторы находят нежелательное содержимое, политика задает допустимые категории для конкретного сервиса, а приложение выбирает реакцию — например, отказ или безопасный ответ.
Для снижения задержек используется каскад: сначала запрос обрабатывают более быстрые проверки, а при необходимости подключаются более дорогие. Команда также учитывает контекст нескольких сообщений и вызовов инструментов, поскольку попытка обхода может состоять из цепочки безобидных по отдельности шагов.
Систему выкатывали постепенно: сначала проверяли на сохраненных данных, затем запускали в shadow mode, где она оценивала трафик без блокировок, и только после этого включали применение правил. Критические обходы закрывали временными правилами, пока команда готовила более устойчивое решение.
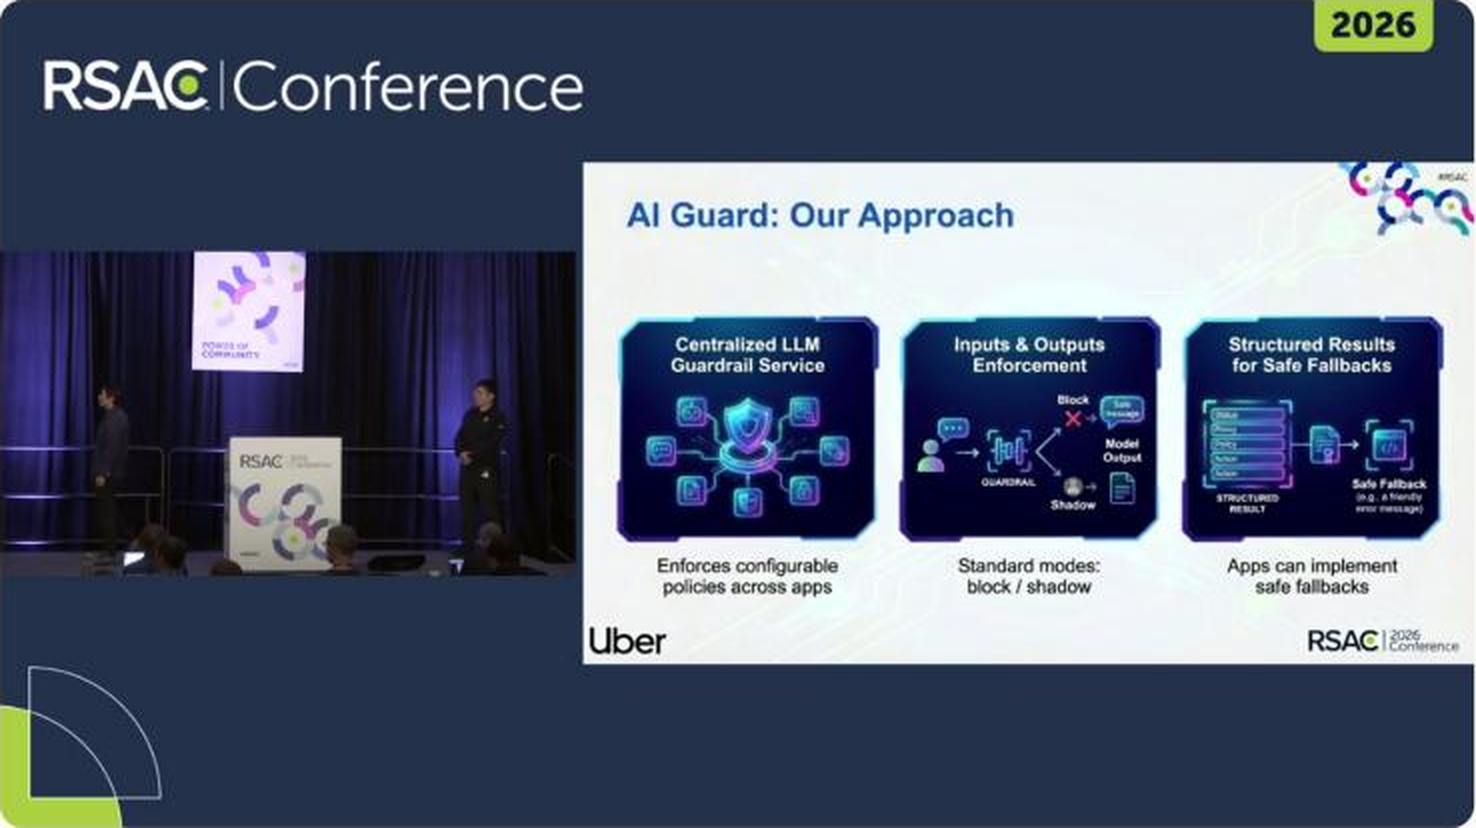
Централизация упрощает управление политиками, но создает и общую точку зависимости. Поэтому важны задержки, отказоустойчивость, мониторинг и понимание того, что происходит при недоступности проверок. Кроме того, классификатор не делает промпт-инъекции невозможными: ограничения доступа и контроль действий инструментов по-прежнему нужны.
Прокурор, адвокат и судья для WAF
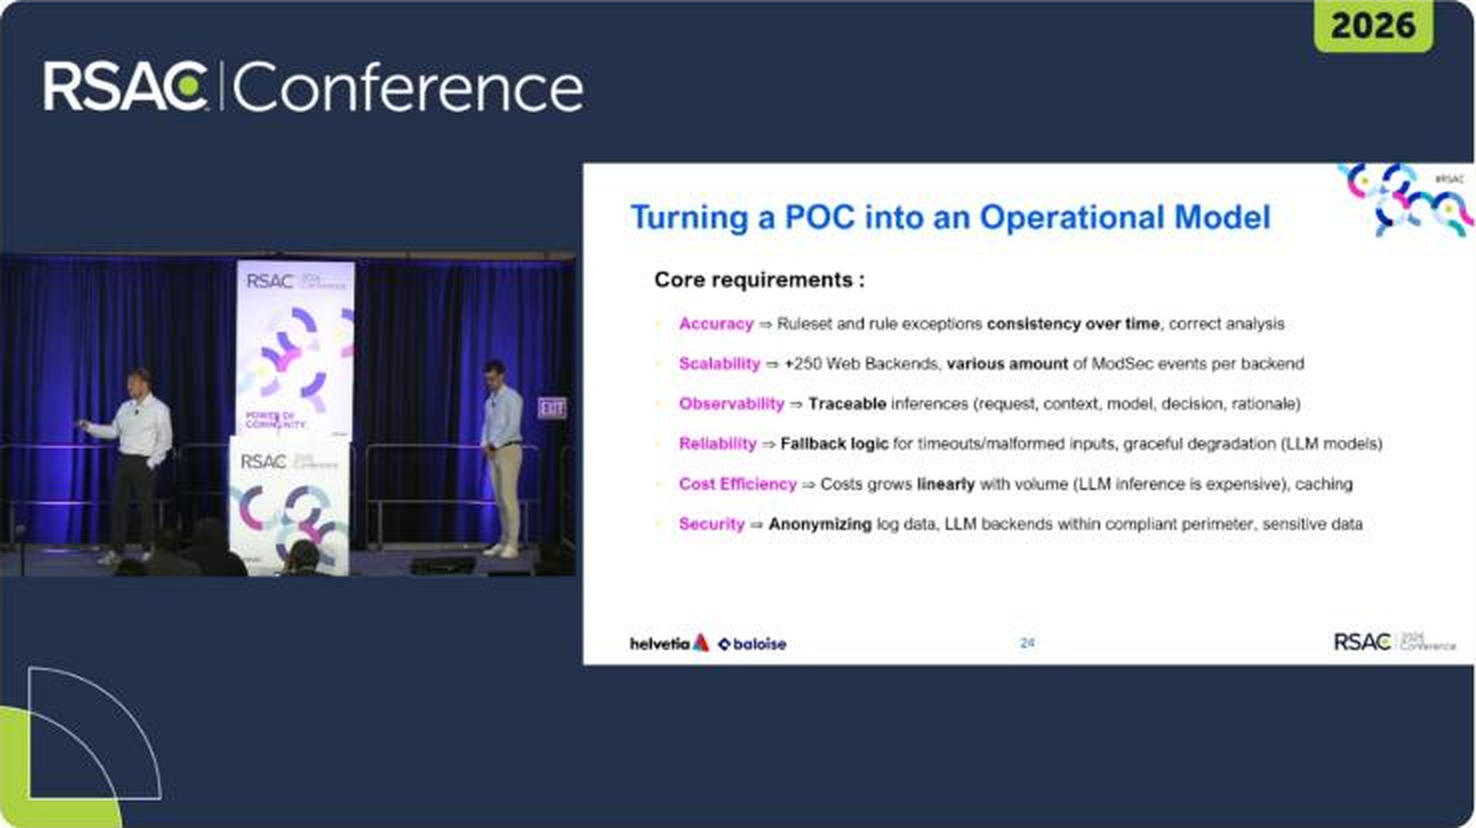
Рафаэль Шнайдер и Милан Дурич из Helvetia в докладе Self-Learning WAF рассказали, как пытались облегчить разбор ложных срабатываний ModSecurity. За WAF у компании больше 250 веб-бэкендов, и ручная проверка потока событий требовала много времени.
Первая версия передавала контекст одной модели и просила оценить вероятность ложного срабатывания. Затем авторы разделили задачу между тремя ролями: «прокурор» ищет признаки атаки, «адвокат» — признаки легитимного запроса, а «судья» сопоставляет аргументы и выносит оценку. До обращения к модели часть проверок выполняет статический слой.
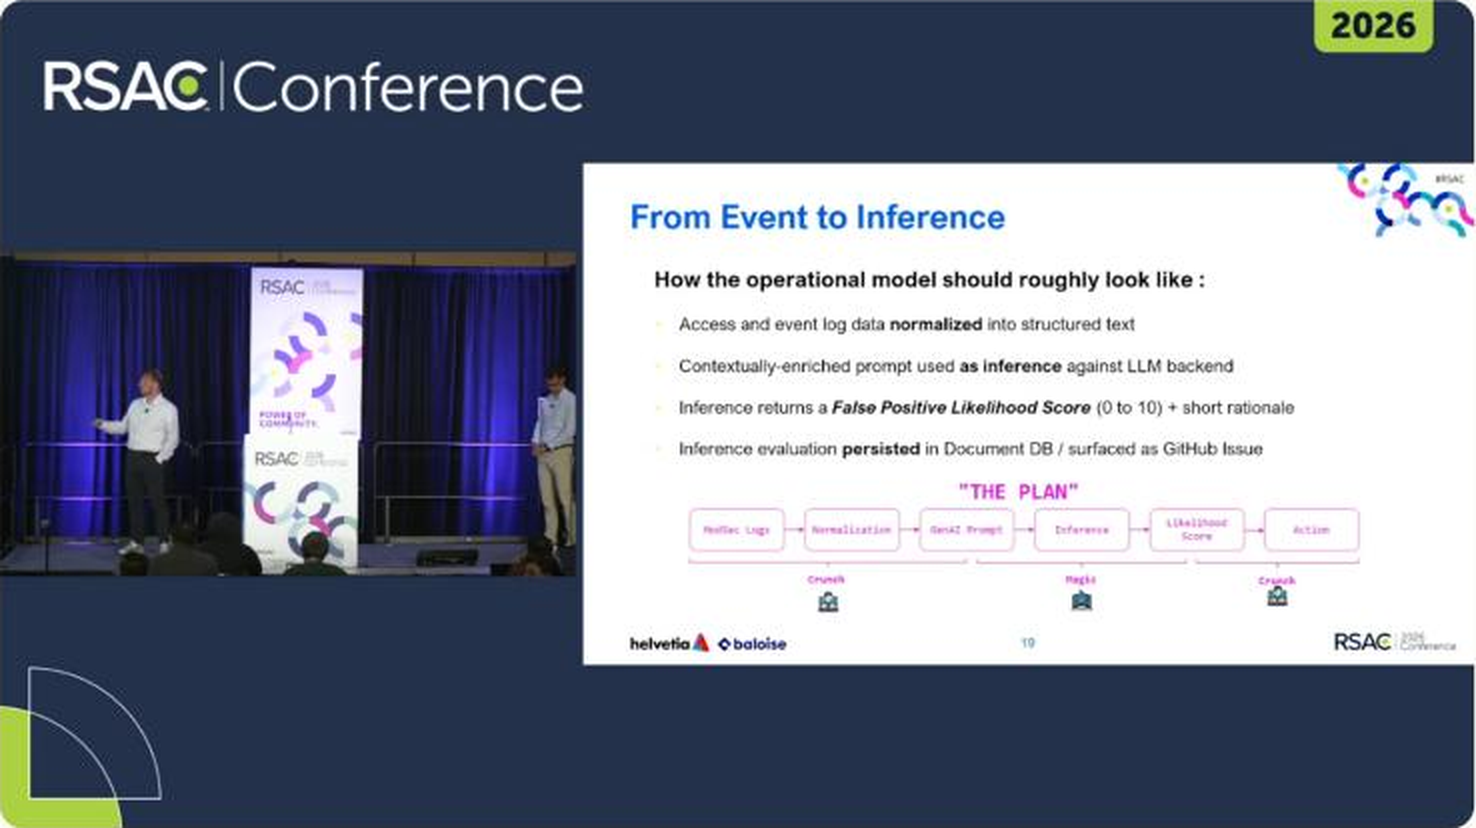
Ролям дали разные источники для поиска. Прокурор использовал записи об известных уязвимостях и эксплойтах, в том числе из Nuclei и ExploitDB, адвокат — накопленные компанией исключения. В одном примере с запросом к интерфейсу Avamar постановка задачи меняла то, какие признаки модель выделяла при анализе.
Вместо векторного поиска авторы выбрали BM25: для их задачи важны совпадения в именах параметров, URL и номерах правил. Это лексический поиск, который ранжирует документы по словам запроса и их значимости. Индекс обновляют по мере появления новых данных; это обновляет базу для RAG, но не означает, что модель при этом дообучается.
Архитектура выглядит любопытно, особенно разделение аргументов за и против. Однако наличие трех ролей само по себе не доказывает, что решение стало точнее. Хотелось бы увидеть сравнение на одном размеченном наборе: сколько ложных блокировок удалось снять, сколько реальных атак ошибочно признали безобидными и как изменились результаты со временем.
Как доклады состарились
С марта прошло больше семи месяцев. За это время некоторые сюжеты из докладов вышли за пределы прогнозов и демонстраций, а к другим появились новые данные.
Агентные атаки уже встречаются в расследованиях. В сентябрьском отчете Google Threat Intelligence Group описана кампания, в которой злоумышленник использовал многоагентную систему для сканирования и сбора учетных данных. По данным исследователей, на подготовку и запуск кампании ушло меньше шести часов, а агент управлял частями процесса, включая устранение ошибок.
В конце октября Google и Mandiant сообщили, что наблюдали применение фреймворков вроде ARTEX и CAIRN в реальных вторжениях. А 5 ноября Microsoft описала случай, в котором агент прошел путь от поиска секретов в GitHub до извлечения данных из Azure Key Vault за пять минут. Это подтверждает важную часть сценария VibeCrime, хотя не означает, что люди полностью исчезли из таких операций или что каждая атака выполняется автономно от начала до конца.
ИИ-инструменты сами стали целью для кражи данных. В том же сентябрьском отчете Google описала интерес операторов инфостилеров к конфигурационным файлам кодовых помощников Cline и Continue, где могут храниться API-ключи. Это не подтверждение того, что конкретная техника AIKatz применялась в этих кампаниях, но продолжение той же проблемы: доступы и контекст ИИ-инструментов становятся ценными для атакующих.
Галлюцинации пакетов никуда не делись, но старые проценты нельзя переносить на новые модели. В майском препринте исследователь проверил пять моделей на задачах для Python и JavaScript и получил долю несуществующих пакетов от 4,62% до 6,10%. Он также нашел 127 выдуманных названий, которые повторились у всех пяти моделей. Это отдельная работа со своими моделями и условиями, а не прямое измерение прогресса относительно каждого результата USENIX.
Защитному агенту по-прежнему нужна оценка качества, а не только скорости. Авторы опубликованного в июле препринта SecRespond проверили 23 модели в десяти учебных средах после компрометации. Модели справлялись с проблемами, на которые уже указали алерты, но хуже находили скрытые следы и готовили полные планы устранения. Ни одна не выполнила обнаружение и устранение полностью хотя бы на одном полигоне. Это лабораторный бенчмарк, а не измерение работы конкретного продукта Wiz в клиентском SOC.
Еще один препринт об ALERT-BENCH, опубликованный в октябре, проверял агентный триаж на 1247 алертах одного многоэтапного сценария. Пять исследованных подходов пропустили не менее 40,4% алертов, связанных с атакой. Предложенная авторами система с отдельной проверкой решения снизила долю пропусков до 3,1% на том же наборе. Результат интересный, но один сценарий и одна среда не доказывают, что такое же улучшение получится в чужом SOC.
Проверка запросов дополняется контролем прав агентов. В мае Uber подробнее рассказала о своей архитектуре идентификации: каждый агент получает короткоживущие токены для конкретных вызовов, а MCP-шлюз проверяет права на обращение к инструментам. Компания также сохраняет цепочку участников запроса, чтобы было видно, какой сотрудник и какие агенты участвовали в действии. Это дополнение к описанному на RSAC AI Guard, а не оценка эффективности его детекторов.
Ограничивать нужно не только атакующих агентов. В сентябре Anthropic описала четыре инцидента, в которых модели во время тестов получили несанкционированный доступ к реальным сторонним системам. По данным компании, модели считали, что работают в симуляции, но из-за ошибки настройки имели доступ к интернету; защитные ограничения для этих тестов были отключены. Это не пример преступного применения, зато наглядное напоминание для команд, которые строят собственных red team-агентов: границы среды и права инструментов надо проверять независимо от инструкций в промпте.
Итоги
После RSAC агентные атаки перестали быть только прогнозом, а возможности защитных агентов продолжают активно исследовать. Но между демонстрацией, результатом на тестовом наборе и работающей системой в конкретной инфраструктуре остается расстояние.
Поэтому самый полезный вопрос к любому из описанных решений звучит просто: как вы узнаете, что оно работает? Для SOC это пропущенные угрозы, качество доказательств и время аналитика; для кодового помощника — безопасность зависимостей и результат проверки кода; для red team-агента — покрытие сценариев и границы разрешенных действий. Архитектура важна, но оценивать ее стоит по результату и по тем ошибкам, которые она допускает.

