Полтора года попыток, Lean, языковые модели и одна буква  , которая съедала весь выигрыш.
Однажды всё наше доказательство сломала буква .
Мы хотели загнать ошибку в ноль и для этого расширяли окно вычисления. Чем шире окно, тем точнее оценка, так нам казалось. Выкладки были правильные, вспомогательные неравенства тоже, кое-что даже проверялось на компьютере. А потом выяснилось, что вместе с окном растёт множитель и съедает ровно столько, сколько мы выиграли. Несколько страниц убедительных вычислений, и в конце ноль продвижения.
С этой буквы удобно начать, потому что она хорошо показывает, о чём вообще эта серия. Как можно доказать много правильных утверждений и не доказать того, ради чего всё затевалось? Почему следующая красивая идея так часто оказывается старой трудностью, переписанной другими буквами? И как заметить это раньше, чем построишь вокруг идеи ещё один большой проект?
О чём эта серия и чего в ней нет
Скажу сразу, чтобы не было недоразумений. Я полтора года пытался доказать гипотезу Римана вместе с языковыми моделями и системой формальной проверки Lean. Доказать не получилось. А 20 ноября 2026 года её доказал другой человек, Левент Альпёге (Levent Alpöge), тоже в паре с моделью Claude. Он выложил Lean-библиотеку примерно на 17 миллионов строк. 21 ноября сообщества Lean и Mathlib опубликовали совместное заявление: доказательство и формулировка проверены.
Эта серия из трёх частей устроена так.
Первая часть (вы её читаете): наш путь. Что мы пробовали, почему каждая идея казалась рабочей и где именно она ломалась.
Вторая часть: как устроено опубликованное доказательство. Его последний шаг понятен почти школьнику, а вся сложность сидит в том, что подаётся этому шагу на вход.
Третья часть: бухгалтерия. Почему в новом доказательстве выигрыш не съедается ценой его получения, той самой болезнью, от которой умирали наши попытки.
Чего здесь нет: я не утверждаю, что понял все 17 миллионов строк, и не выдаю наш архив за «почти готовое доказательство». Машинную проверку чужой библиотеки я не повторял: её сделали сообщество Lean и независимые проверяющие. Я рассказываю, что увидел, когда пришёл к чужому решению с полутора годами собственных ошибок в голове. Оказалось, что эти ошибки неплохо работают как фонарик: они подсвечивают, где в новом доказательстве живёт настоящая работа.
Для кого это
Я пишу для тех, кому привычнее программа, чем теорема: разработчиков, студентов, людей, которые однажды заинтересовались математикой и споткнулись о страницу незнакомых значков. Знать заранее, что такое пространство Харди или оператор Бирмана–Швингера, не нужно. Каждое понятие я ввожу перед тем, как им пользоваться, и почти каждое сначала показываю на игрушечном примере, который можно проверить в уме или на бумажке.
Формулы в тексте есть, и пропускать их можно. Перед формулой я говорю, зачем она нужна, после неё говорю, что из неё следует. Если формула не читается, читайте слова вокруг: нить рассказа от этого не порвётся.
Чтение длинное. Его не обязательно заканчивать за один вечер: главы короткие, и после большинства из них можно остановиться. А если вы пришли ради самого доказательства, можно прочитать главы 1–4 этой части как словарик и сразу переходить ко второй.
Отдельное слово о тех, кто будет продираться через все три части целиком, проверяя каждую строчку. Я вас уважаю, сам такой. Если вы где-то споткнулись, скорее всего, плохо написано, а не вы чего-то не поняли. Напишите мне, я поправлю.
Репозиторий. Все журналы, заметки и Lean-код проекта лежат в git-репозитории NymanBeurling. Сейчас он закрытый. Если вам нужен доступ, напишите мне в личку на Хабре или в Telegram и коротко расскажите, зачем: доступ дам. Ссылку на Telegram не даю, считайте это маленькой капчей: ник там такой же, как здесь, на Хабре. Ссылки вида notes/… ниже означают пути внутри этого репозитория.
1. Зачем я за это взялся
Меня зовут Владимир Радкевич. Я независимый исследователь, занимаюсь математикой, физикой и компьютерными науками; больше всего меня интересуют искусственный интеллект, машинная логика и формальные системы. Учился в МИФИ на интеллектуальных управляющих системах.
Задачи тысячелетия зацепили меня историей Перельмана. Человек годами сидит над абстрактным вопросом и в конце устанавливает то, чего человечество не знало. Мне хотелось хотя бы прикоснуться к такому.
Но между любовью к математике и умением строить строгие доказательства лежит пропасть. У меня скорее физический склад ума: я легко представляю устройство объекта, чувствую связи, придумываю конструкции. А вот проверить, выдерживает ли конструкция все условия, которые незаметно появляются при переходе к формулам, мне всегда было тяжело. Долгое время формула для меня оставалась загадкой: как понять, правильная она или нет?
И тут я открыл для себя Lean 4.
В Lean математическое утверждение записывается как тип, а доказательство как значение этого типа. Специальное ядро проверяет, что значение построено по разрешённым правилам. Для программиста здесь есть знакомая опора: мало объявить интерфейс, нужна реализация. А дальше начинается непривычное. Реализация должна быть не функцией, которая возвращает true, а свидетельством того, что утверждение верно. Сломать её «на следующем входе» нельзя: если Lean принял доказательство, оно работает для всех объектов, удовлетворяющих его условиям.
Вот только сами условия и смысл определений по-прежнему должен понимать человек. Эту оговорку мы ещё не раз проверим на собственной шкуре, причём весьма болезненно.
Когда дальше я пишу «мы», я имею в виду себя вместе с моделями Claude и Codex и инструментами проверки. Я выбирал вопросы, спорил о конструкциях и пытался связать результаты в цельную картину. Модели предлагали аргументы, писали код, находили ошибки друг у друга и тоже ошибались. Это не история одиночки с карандашом и не история машины, которую оставалось только включить.
Началось всё в августе 2025 года, а основная техническая хроника, которую я перескажу, приходится на январь–октябрь 2026-го.
2. Что утверждает гипотеза Римана
Договоримся о картинке. Комплексное число  можно нарисовать точкой на плоскости:
 задаёт горизонтальную координату,
 вертикальную, а
 — это число, у которого
 . Запись
 означает «горизонтальная координата точки
 ». Больше про комплексные числа нам пока ничего не понадобится.
Дзета-функция Римана берёт такую точку и возвращает комплексное число. «Нуль функции» — это точка, в которой результат равен нулю. Справа от вертикальной прямой  дзета-функцию можно посчитать как бесконечную сумму:
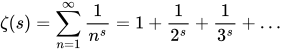
Например, при  получается
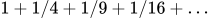 ; эта сумма сходится к
 . «Сходится» значит, что конечные суммы подбираются всё ближе к одному числу.
При чём здесь простые числа? Каждое натуральное число единственным образом раскладывается на простые множители:  . Из-за этого ту же функцию можно записать как произведение по всем простым (его называют эйлеровым произведением):
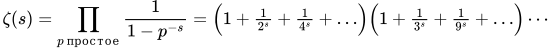
Если раскрыть скобки, то выбор степени двойки, степени тройки и так далее собирает ровно одно натуральное число, и каждое число встречается ровно один раз. Сумма перебирает числа подряд, а произведение показывает, как они устроены. Это первый мост между миром непрерывных функций и миром делимости, и весь дальнейший рассказ так или иначе ходит по этому мосту.
Неприятность в том, что гипотеза Римана говорит не про ту область, где сумма сходится. Подставить туда другое и считать ответ законным нельзя.
Вот аналогия попроще. Сумма 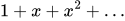 при
 равна
 . Дробь прекрасно определена и при
 , она равна −1. Но это не значит, что
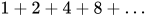 «равно −1». Мы не заставили расходящуюся сумму сойтись, а продолжили функцию за пределы области, где работала исходная формула. С дзета-функцией проделывают похожее (только сложнее) продолжение. Получается функция на всей комплексной плоскости с единственной особой точкой
 , где она уходит в бесконечность (это называется полюсом).
Теперь сам вопрос. У продолженной дзета-функции есть «скучные» нули в точках −2, −4, −6, … Их называют тривиальными. Все остальные, нетривиальные, сидят в вертикальной полосе  . Гипотеза Римана утверждает, что все они лежат ровно посередине полосы, на так называемой критической прямой:
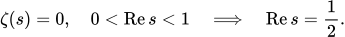
На картинке это выглядит невинно: не отклоняется ли хоть одна точка от вертикальной линии? Подвох в слове «хоть одна». Компьютеры проверили триллионы нулей, все на прямой. Но слово «каждый» нельзя заменить большим числом проверенных примеров: следующий нуль может оказаться первым неправильным.
Есть и соблазн попроще. У дзета-функции есть функциональное уравнение: оно связывает значения в точках и  , то есть отражает плоскость относительно критической прямой. Может, симметрия сама загоняет нули на ось симметрии? Нет. Две точки по разные стороны зеркала тоже симметричны. Симметрия говорит, что нули ходят парами, но не запрещает этим парам существовать. Нужен аргумент, который запрещает отклонение, а не просто красиво описывает симметрию. Его поиск и есть вся история.
3. Не искать нули, а приблизить единицу
Мой проект называется NymanBeurling, по имени критерия Наймана–Бёрлинга. Этот критерий переводит вопрос о нулях в вопрос о приближении функций. Для программиста звучит заманчиво: приближать функции мы умеем, это почти машинное обучение.
Начнём с дробной части числа. У 3,7 дробная часть 0,7, у целого числа ноль. Обозначим её 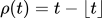 , где
 означает округление вниз. Из дробных частей соберём семейство функций на интервале от 0 до 1:
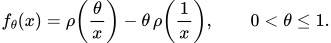
Параметр  выбирает одну функцию из семейства. Графики у них рваные: когда
 меняется,
 перескакивает через целые числа. Это нестрашно, поточечного совпадения от нас никто не потребует.
Представьте, что каждая такая функция — это звуковая волна на коротком отрезке времени. У каждой можно крутить громкость и менять знак. Хотим сложить их так, чтобы получился заданный сигнал. А сигнал-цель проще некуда: постоянная единица, ровная горизонтальная линия.
Ошибку меряем так же, как в методе наименьших квадратов: в каждой точке вычитаем получившийся сигнал из нужного, возводим разность в квадрат и складываем по всему отрезку (для функций вместо суммы берётся интеграл). Квадрат нужен, чтобы промахи вверх и вниз не гасили друг друга. Корень из этой величины называют  -нормой ошибки.
Если разрешить только функции с 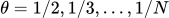 , то наилучшая достижимая ошибка равна
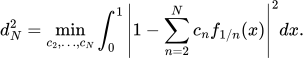
(Почему с двойки? При  оба слагаемых в определении совпадают, и
 тождественно равна нулю. В истории проекта была ошибка ровно из-за этого: включили в «линейно независимый базис» и получили нулевую строку в матрице.)
Критерий Наймана–Бёрлинга в усилении Báez-Duarte, если говорить по-простому, утверждает: гипотеза Римана верна тогда и только тогда, когда  стремится к нулю при
 . (В исходной формулировке Báez-Duarte функции живут на полупрямой
 ; в нашем проекте использовалась равносильная запись на
 с вычтенным общим хвостом. Я упоминаю это, чтобы внимательный читатель не принял похожие формулы за одну и ту же теорему.)
Звучит доступно: пиши программу, считай матрицы, подбирай коэффициенты и смотри, как падает ошибка. Но почему задача о складывании волн вообще что-то знает о нулях дзета-функции? Давайте честно проверим одну сторону этой связи, она красивая.
Возьмём функцию, умножим на вес  и проинтегрируем по отрезку. Получится число, зависящее от . Такое взвешенное измерение называется преобразованием Меллина. Для наших функций его можно вычислить точно:
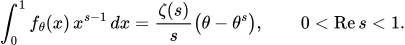
Посмотрите, что тут стоит:  множителем! Предположим, у дзета-функции есть «неправильный» нуль
 с
 . Тогда наше измерение в точке даёт ноль для каждой функции семейства, а значит, и для любой их суммы с любыми коэффициентами. А для единицы оно равно
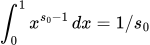 , не нулю.
Получается, что существует «прибор», который не видит ни один наш строительный блок, но видит цель. Может ли сумма невидимых блоков подобраться к видимой цели сколь угодно близко? Только если прибор не устойчив, то есть может раздувать крошечную ошибку. Проверим устойчивость. По неравенству Коши–Буняковского (тот же принцип, что «скалярное произведение не больше произведения длин»):
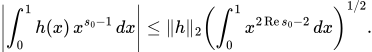
Последний интеграл конечен ровно тогда, когда
. Значит, прибор устойчив: маленькая ошибка даёт маленькую разницу показаний. И если ошибка приближения стремится к нулю, показания на комбинациях (всегда ноль) должны стремиться к показанию на единице ( ). Противоречие. Значит, успешное приближение запрещает нули справа от критической прямой, а функциональное уравнение запрещает их и слева.
Вот и вся магия этой стороны критерия: неправильный нуль оставляет след в виде прибора, слепого к строительным блокам. Обратная сторона (из RH следует, что приближение возможно) гораздо труднее, и её доказал Бёрлинг в 1955 году.
Но заметьте, что мы доказали: «если приближение удалось, то RH». А как добиться самого приближения? Этот вопрос никуда не делся, и дальше он будет преследовать нас в разных обличьях.
4. Матрица, которая всегда положительна
Коэффициенты  подбираются методом наименьших квадратов, а там, как известно, появляются матрицы.
Составим таблицу попарных скалярных произведений наших функций (для функций скалярное произведение — это интеграл произведения). Это матрица Грама  . Вектор
 составим из скалярных произведений функций с целью, единицей. Тогда наилучшая ошибка выражается формулой
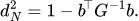
Для программиста это особенно соблазнительное место. Матрица, вектор, обратная матрица. Кажется, что задача наконец стала вычислительной.
И ещё одна соблазнительная деталь: матрица Грама всегда «положительна». Для любого вектора коэффициентов 
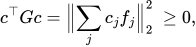
потому что слева стоит квадрат длины составленного сигнала. Положительность! Та самая, которая должна быть где-то рядом с RH.
Только она ничего не даёт. Она верна для любой матрицы Грама, даже если функции совершенно не годятся для нашей цели. Проверим на игрушке. Пусть векторы — бесконечные массивы, а  — массив с единицей на
 -м месте. Разрешим только
 Их матрица Грама единичная: идеальная, лучше не бывает, никаких численных проблем. Но у любой их комбинации первая координата равна нулю, и вектор
 ими не приблизить никогда: расстояние всегда равно 1.
Идеальная матрица не компенсирует отсутствие нужного направления. Этот пример объясняет один из главных тупиков проекта: мы снова и снова получали хорошие свойства взаимодействия функций между собой, а нужно было утверждение о том, как всё их линейное пространство расположено относительно конкретной цели.
Есть и вторая ловушка: строгое уменьшение тоже ничего не гарантирует. Последовательность  убывает на каждом шаге, но стремится к единице, а не к нулю. Можно улучшать приближение бесконечно долго и так и не дойти до цели. Позже мы записывали это точнее. Пусть каждый шаг убирает долю
 от оставшейся квадратичной ошибки:
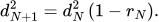
Пусть начальная ошибка положительна и ни один шаг не обнуляет её сразу; тогда  . В этом случае ошибка уходит в ноль тогда и только тогда, когда сумма
 бесконечна. Например, при
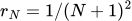 все шаги полезны, но сумма конечна, и ошибка застрянет на положительном уровне.
Проверим границу утверждения. Зачем условие «ни один шаг не обнуляет сразу»? Если первый же шаг попал точно (
), а дальше все
, то ошибка уже ноль, а сумма конечна. Без условия критерий был бы неверен.
Так недостающее получило точное имя: нужен не очередной хороший шаг, а закон накопления шагов. Самого закона у нас не было. И с этого момента любая новая идея должна была отвечать на неудобный вопрос: она даёт ещё один хороший конечный ответ или запрещает застрять на ненулевом пределе?
Если коротко. Критерий Наймана–Бёрлинга превращает RH в задачу приближения единицы рваными функциями. Одна сторона связи доказывается на салфетке. Но матрица Грама «положительна» для любых функций, а убывание ошибки ещё не означает её исчезновения. Нужен закон, а не примеры.
5. Куда исчезал выигрыш
Вернёмся к букве из начала.
Чтобы оценивать сложные выражения, мы обрезали их гладким окном в форме колокола: гауссианом, той самой кривой нормального распределения. Параметр задавал ширину колокола. Для гауссиана есть точная формула преобразования Фурье:
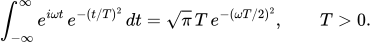
Подставьте  , и множитель вылезет без всякой теории: растянули колокол по горизонтали в раз, и его площадь выросла в раз. В нашей цепочке оценок этот множитель мешал получить убывание. Естественная мысль: возьмём колокол единичной площади, тогда из формулы исчезнет. Исчезнет, да. Но поменяется нормировка исходного интеграла, и когда мы вернёмся к нему, придёт обратно. Бесплатного уменьшения ошибки не бывает.
В другой ветке надежда была логарифмической. Одна часть оценки давала выигрыш порядка  , и хотелось умножить его на что-нибудь ограниченное и получить ноль в пределе. Но следующая оценка приносила
 в числитель, и они сокращались. Оставалась ограниченность, а нужно было убывание.
Это как оптимизировать программу, в которой одна операция стала в десять раз быстрее, а подготовка данных для неё — в десять раз медленнее. Локальное ускорение настоящее, а общего нет.
В январских документах проекта записаны три такие попытки: через оценки фреймов, через гауссово окно и через  -адическую арифметику. Технические детали у них разные, итог одинаковый: после исправления ошибок ни одна не давала нужного
 . (Из этого не следует, что эти области математики бесполезны для RH. Не сработали конкретные оценки в конкретной цепочке.)
Именно здесь у формализации обнаружилась неожиданная польза. Она не достроила нам доказательство. Зато она очень трезво показывала, что именно у нас на самом деле получилось.
В репозитории: docs/01_MOTIVATION.md, docs/05_RIEMANN_PROOF_ERRORS.md.
6. Две координаты, которые не создали нового измерения
После нескольких неудач у меня появилась гипотеза: может быть, мы бьёмся над многомерной задачей одномерными средствами? Вместо одного индекса  я предложил лестницу параметров с двумя координатами:
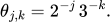
Два простых числа, две координаты, решётка индексов. В старой заметке я даже сравнивал это с переходом от одномерной криптографии к эллиптическим кривым. Сейчас понятно, что такая аналогия могла подсказать вопрос, но ничего не доказывала: число координат в записи не определяет качества приближения.
Первая проверка оказалась обидно простой. Если и  неотрицательны, то все значения , кроме единицы, не больше 1/2. Между 1/2 и 1 нет ни одной точки лестницы. Значит, моё утверждение о том, что лестница плотна на отрезке, было просто неверным.
Мы починили лестницу: разрешили показатели обоих знаков и оставили только значения в нужном интервале. Поскольку  иррационально, такое множество действительно плотное. Можно праздновать?
Нет, по двум причинам. Первая: плотность параметров не даёт полноты системы функций. В лучшем случае она возвращает нас к тому же семейству, с которого мы начинали, а его полнота как раз и была трудной частью.
Вторая причина интереснее. Наши оценки убывания зависели от логарифмического расстояния между точками лестницы:
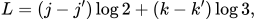
а считать точки хотелось по расстоянию на решётке индексов:
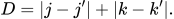
Мы молча считали, что большое  означает большое
 . Но в одно слагаемое может компенсировать другое. Пример без всяких приближённых вычислений:
 , а
 . Восемь шагов в одну сторону и пять в другую дают почти один и тот же масштаб:
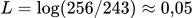 , хотя
 . По решётке мы ушли далеко, а в том расстоянии, которое реально входило в оценку, остались рядом.
И это не редкая неприятность на краю. Именно такие почти-совпадения и обеспечивали плотность лестницы! Свойство, которым мы починили первый шаг, разрушало предпосылку второго. Была ещё попытка спастись нижними оценками линейных форм от логарифмов (это глубокая теория Бейкера), но она даёт оценку не в ту сторону: ограничивает снизу маленькое через большие индексы, а нам нужно было ограничить индексы при маленьком .
Так одна эффектная идея распалась на три независимые задачи: плотность параметров, геометрия расстояний и полнота системы функций. Решение первой не решало двух остальных.
В репозитории: docs/09_DIMENSION_HYPOTHESIS.md, docs/14_LADDER_DENSE_SALVAGE.md, docs/20_UNCONDITIONAL_EXPLORATION.md.
7. «У функции бесконечно много нулей, значит, она нулевая»
Можно зайти с обратной стороны. Вместо поиска удачной комбинации поискать сигнал, который не замечает ни одну нашу функцию: его скалярное произведение с каждой из них равно нулю. Такой сигнал называют ортогональным семейству. В примере с  таким был . Если ненулевых ортогональных сигналов нет, комбинации семейства могут приблизить что угодно. Значит, достаточно доказать, что ортогональный сигнал обязан быть нулевым.
После преобразований такая задача превращается в условия вида «некоторая функция обращается в ноль во всех точках  ». Точек бесконечно много. Не обязана ли функция быть тождественным нулём?
Не обязана. Синус имеет бесконечно много нулей и при этом вполне жив. У теорем единственности, которые разрешают сказать «нулей слишком много, значит, функция нулевая», есть конкретные условия: где лежат нули, есть ли у них точка сгущения, насколько быстро функция может расти. Заменить всё это словами «нулей очень много» нельзя. Это как теорема Котельникова: сигнал восстанавливается по отсчётам, но только если его спектр ограничен. Забудете про ограничение — объявите восстановимым сигнал с произвольными неучтёнными колебаниями. У нас роль ограничения спектра играли аналитичность и рост функции, и их надо было ещё доказать для нашей конкретной функции.
Тут же сидит и вторая ловушка. В пространстве две функции, которые отличаются в одной точке, считаются одной и той же: интеграл ошибки этого не замечает. Поэтому у элемента вообще нельзя без оговорок спрашивать «чему ты равен в точке  ?». Сначала нужно доказать, что у него есть хороший представитель, например непрерывный.
Мы перепробовали несколько инструментов: пространства Харди, факторизации, теоремы Карлсона и Йенсена. Запоминать фамилии не нужно. Важно, что у каждого инструмента есть входные условия, и их надо было получить для своей функции, а не выбирать теорему, у которой заключение похоже на желаемое.
При перечитывании ранних записей нашлась ещё одна поучительная ошибка. В заметке о преобразовании Меллина одной и той же функции приписали две разные формулы в соседних областях, а неверную пытались оправдать аналитическим продолжением. Но аналитическое продолжение не разрешает поменять функцию! Проверка элементарна: правильная формула из главы 3 содержит множитель  и при даёт ноль, как и должна (
 ). Альтернативная запись этот тест не проходила.
Тут ошибалось уже не исходное рассуждение, а объяснение того, как его починить. Поэтому я не хочу превращать архив в гладкую легенду, где каждая следующая запись умнее предыдущей. Иногда следующая запись просто увереннее. Отличить уверенность от продвижения можно только новой проверкой.
В репозитории: docs/17_MELLIN_ANALYSIS_FINDINGS.md, docs/20_UNCONDITIONAL_EXPLORATION.md.
8. «Осталось всего две леммы»
В какой-то момент наш проект можно было описать очень обнадёживающе: почти всё собрано, осталось доказать два утверждения. Описание было технически точным и математически обманчивым. Объясню на языке типов.
Схематически результат выглядел так:
finish : MissingEstimate -> RiemannHypothesis
Это функция: дайте ей на вход доказательство утверждения MissingEstimate, и она вернёт доказательство гипотезы Римана. Lean честно проверил, что функция корректна. Но он не создаёт входной аргумент сам. В коротком имени MissingEstimate может прятаться вся нерешённая задача целиком.
Поэтому полезно спрашивать не только «скомпилировалось?», но и «а откуда мы возьмём вход?». Количество оставшихся предпосылок плохо измеряет расстояние до цели. Сто технических лемм иногда закрываются быстрее, чем одна, которая на деле равносильна исходной задаче.
В нашей модульной линии весны 2026 года действительно оставались два крупных аналитических входа, связанных с теорией Харди и факторизацией Адамара. Сократить их число, выделить зависимости, доказать промежуточные переходы было настоящей работой. Но статус всей конструкции оставался условным. Условный результат полезен: он говорит «если получить вот это, дальше всё сделано». Беда начинается, когда эту границу забывают и называют реализацию интерфейса готовой системой.
Крайний случай такой ловушки выглядит смешно. Функцию P -> P написать легко, это тождественная функция. Она проходит любую проверку, не использует ни одной аксиомы и не доказывает  . Позже мы встретим кое-что похуже: предпосылку, которая не просто недоказана, а невыполнима в принципе. Но до этого эпизода надо ещё дойти.
В репозитории: README.md (майская версия модульной формализации прямо называет её условной и перечисляет оставшиеся входы).
Если коротко. Первая эпоха проекта (январь–весна 2026) — это оценки, которые съедали собственный выигрыш, лестница, которая чинила одно и ломала другое, и «две оставшиеся леммы», внутри которых жила вся задача. Мы научились главному вопросу: что именно доказано и откуда возьмётся вход?
9. Семь дорог к одному месту
К лету 2026 года маршрутов стало много: функциональный анализ, спектральная теория, геометрия, явные формулы, арифметические модели. И все они почему-то сходились к одной и той же центральной конструкции. Не значит ли это, что мы почти у цели? Семь независимых подтверждений!
Не значит. Если я перепишу одну систему уравнений в семи системах координат, все семь записей согласуются между собой. Это хорошая проверка того, что преобразования сделаны правильно, но не семь независимых решений. В июньской хронике проекта так и записано: «семь независимых маршрутов» пришлось переименовать в «несколько координатных записей одной и той же формы», связанной с явной формулой Вейля.
С тех пор я различаю три события.
Мы научились записывать цель на другом языке.
Мы доказали, что новая запись действительно равносильна старой.
В новом языке нашлось свойство, которое раньше было недоступно и которое теперь доказывает цель.
Почти все наши переходы были событиями первого и второго типа. Мы всё время искали третье.
В репозитории: notes/chronology/CHRONO_2026-06-17_2026-06-27.md, notes/chronology/INDEX.md.
10. Форма Вейля: двойная бухгалтерия простых чисел
Новая главная героиня — квадратичная форма Вейля. Чтобы понять, откуда она берётся, нужна одна идея, которую я про себя называю двойной бухгалтерией.
Есть так называемая явная формула. Она говорит, что одну и ту же величину можно посчитать двумя способами. Берём «пробную» функцию  и считаем:
через нули дзета-функции: сумму по всем нетривиальным нулям некоторого выражения, построенного из
;через простые числа: сумму по простым и их степеням плюс пару поправочных слагаемых.
Обе суммы равны. Это не гипотеза, это теорема, и именно она связывает нули с простыми.
А теперь трюк. Выберем так, чтобы слагаемое каждого нуля на критической прямой было квадратом модуля, то есть заведомо неотрицательным. Тогда, если все нули на прямой, вся сумма по нулям неотрицательна. Если же какой-то нуль сошёл с прямой, его слагаемое перестаёт быть квадратом модуля, и подбором его можно сделать отрицательным и перевешивающим. Получается критерий Вейля: гипотеза Римана верна тогда и только тогда, когда сторона простых чисел неотрицательна для всех допустимых .
Обозначим эту сторону через  . В нормировке нашего проекта она выглядит так:
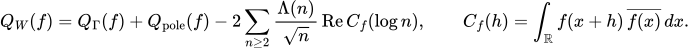
Расшифруем по частям.
 — веса фон Мангольдта:
 , если — степень простого , и ноль иначе. У чисел 2, 4, 8 одинаковый вес
 , у числа 6 вес нулевой. Именно эти веса получаются, если взять логарифм эйлерова произведения.
 — автокорреляция: сравниваем сигнал с его копией, сдвинутой на
 . Похожей операцией ищут задержку эха. При
 получается квадрат нормы, при других сдвигах знак может быть любым.
 — вклад гамма-фактора (его ещё называют архимедовым).
 — вклад от полюса дзета-функции.
Обратите внимание на минус перед суммой по простым. Знак формы — это соревнование хорошего с плохим, и заранее неясно, кто победит.
Одна полезная деталь. Если функция равна нулю вне отрезка длины  , то при сдвиге больше копии не перекрываются, и корреляция равна нулю. Значит, для «короткой» функции из бесконечной суммы по простым остаётся конечное число слагаемых: только те , у которых
 . Это сильно упрощает вычисления, но знака ещё не даёт.
Почему же не разобрать слагаемые по отдельности и не показать, что хорошее перевешивает плохое? Потому что «хорошего» тут нет. Полюсная часть сама разность двух квадратов:
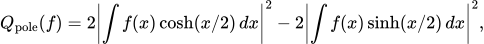
архимедова часть не положительна на всех частотах, а корреляции имеют любые знаки. В отличие от матрицы Грама из главы 4, эта форма не дана нам как квадрат длины какого-то вектора. Если бы удалось независимо построить такое представление, задача была бы решена. Собственно, все наши дальнейшие эпохи — это разные попытки такое представление найти.
Возникает соблазн сделать оценки «безопасными»: заменить спорные величины модулями, ограничить каждый член отдельно и сложить. Иногда так и надо. Но если два больших слагаемых почти гасят друг друга, сумма их модулей описывает уже совсем другую задачу, и всё сокращение, на котором держится результат, теряется. Запомните эту мысль: в третьей части она окажется сердцем нового доказательства.
И ещё одно. Положительность на ста тестах не означает положительности на всех. Мы снова встретили бесконечный квантор, только теперь он спрятан не в пределе , а в словах «для любой функции ».
11. Может быть, нужна правильная геометрия?
Для человека с физическим складом ума следующая мысль естественна: если вычисления не показывают знак, может быть, знак следует из устройства объекта? Самый понятный источник положительности мы уже видели: квадрат длины. Найдём пространство и отображение, которые превращают нашу форму в квадрат длины, и вопрос решён.
Эту надежду можно увидеть на маленькой модели. Пусть линейное преобразование растягивает длину любого вектора ровно в  раз. Если
 — собственный вектор, то есть
 , то длину
 можно посчитать двумя способами:
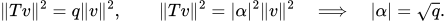
Все собственные значения оказались на окружности радиуса , причём не потому, что мы решали уравнение, а потому, что нас заставила положительная геометрия. (Это не просто игрушка. Аналог гипотезы Римана для кривых над конечными полями, доказанный Вейлем в 1940-х, устроен похоже: правильное геометрическое спаривание ограничивает собственные значения оператора Фробениуса, и они оказываются по модулю равными . Их называют обратными нулями дзета-функции кривой. При этом сама форма пересечения на поверхности вовсе не положительна: нужный знак есть только у специального спаривания на подходящем подпространстве, и это отдельная теорема. Именно этот успех десятилетиями внушал надежду, что и для настоящей дзета-функции найдётся своя геометрия с правильным знаком.)
А если форма симметричная и невырожденная, но не положительная? Возьмём
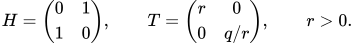
Форма с матрицей  — это
 ; она принимает любые знаки. Соотношение
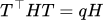 выполняется при любом
 , то есть «сохраняет форму с множителем
 ». А собственные значения равны и
 , и подбором их можно увести сколь угодно далеко от . Алгебраическое тождество осталось, а нужное ограничение исчезло. Работала именно положительность, симметрии мало.
Это маленькая модель большого препятствия. Мало найти пространство и спаривание. Нужно получить правильный знак в правильном месте и доказать, что спаривание представляет именно нашу форму Вейля. В журналах проекта этот последний шаг назывался identification или crossing: предъявить отображение, при котором две конструкции действительно совпадают.
Мы перебрали много кандидатов: адельные конструкции, следовые модели, арифметические поверхности, формы пересечения, теории высот и автоморфных периодов. Там встречались знакомые логарифмы простых и красивые положительные выражения. Но похожие формулы жили в разных пространствах, и общего объекта, который согласовал бы все части, мы не построили. Две правильные детали от разных механизмов не обязаны соединяться.
(Отсюда не следует, что геометрическое доказательство RH невозможно. Следует только то, что наши конкретные объекты не дали нужного отображения. Забегая вперёд: во второй и третьей частях высоты, периоды и решётки появятся снова, уже в чужом доказательстве, и там они соединятся.)
В репозитории: notes/FrontierConvergenceMap.md, notes/GEOMETRIC_POSITIVITY_CANDIDATES_HISTORY.md.
12. Откуда берётся 1/2 и почему этого мало
Число 1/2 преследует любой разговор о RH, поэтому особенно приятно получить его не из определения, а из какого-то независимого требования.
Простой пример на обычной прямой. Сожмём график функции по горизонтали в  раз. Интеграл квадрата уменьшится в раз. Чтобы норма не изменилась, амплитуду надо увеличить в
 раз. Вот и 1/2: показатель
 навязан сохранением нормы.
В проекте похожий расчёт возник для -адических чисел (это числа, в которых «близость» измеряется делимостью: 1 и  тем ближе, чем больше
 ; у них есть свой размер
 ). Растяжение с поправкой амплитуды определяется так:
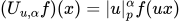 . Замена переменной даёт
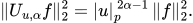
При  норма сохраняется при любом
 , так что одно такое растяжение ничего не решает. Но если потребовать сохранения нормы для всех растяжений, включая те, у которых
 , остаётся только
 . Преобразования, сохраняющие норму, называют унитарными, и половинка тут выводится, а не вписывается.
Летом 2026 года я ходил очень довольный: мне казалось, что я всё решил, потому что нашёл правильную физическую аналогию, в которой половинка возникала сама собой. Дальше пришлось задать тот вопрос, который уже не раз спасал нас от лишнего оптимизма: а что именно мы получили? Правильный вес одного локального действия. Не расположение всех нулей. Между ними оставались глобальная сборка, формула следа, регуляризация, области определения и знак, и ни один из этих шагов не выполнялся сам.
В спектральной программе была похожая надежда. У симметричной вещественной матрицы все собственные значения вещественны; у самосопряжённых операторов то же самое. Идея Гильберта–Пойи: связать нетривиальные нули с самосопряжённым оператором по формуле 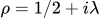 , где
 пробегает его спектр. Если доказать такое соответствие для всех нетривиальных нулей, вещественность сразу даст
 . Решающее слово тут «доказать»: нужен мост к настоящей дзета-функции. Если начать с неизвестных нулей и объявить их спектром, самосопряжённость станет просто новой записью исходного вопроса.
Проверим границу утверждения. Почему именно
И ещё простая вещь, которую легко забыть: самосопряжённый не значит положительный. Оператор  самосопряжён, и его спектр вещественный и отрицательный. Симметрия, унитарность, самосопряжённость, положительность и связь с дзета-функцией отвечают на разные вопросы. Собрать несколько из них приятно. Последнее не появляется автоматически.
13. Контрольные миры, или тени дзета-функции
Постепенно главным инструментом стало не подтверждение очередной идеи, а попытка её убить. Для программиста логика знакома: если алгоритм на одинаковых входах обязан выдавать разные ответы, он не существует. Наши рассуждения тоже опирались на некоторый набор «входов»: функциональное уравнение, эйлерово произведение, положительность весов и так далее. Если найдётся другой объект с теми же входами, у которого гипотеза Римана неверна, то никакое рассуждение, использующее только эти входы, RH не докажет. Оно «доказало» бы и ложное утверждение про двойника.
Такие двойники в проекте назывались тенями. Классический пример — функция Дэвенпорта–Хейльбронна. У неё есть функциональное уравнение того же типа, что у дзета-функции, но нет эйлерова произведения, и у неё есть нули вне критической прямой. Мораль: одного функционального уравнения мало.
А вот тень, которую мы разобрали сами в ноябре 2026 года, и она мне особенно нравится. Возьмём число между 0 и 1/2 и составим
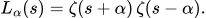
У этой функции есть эйлерово произведение, у неё неотрицательные веса простых (аналог  ), у неё точное функциональное уравнение. Почти всё, чем пользовались наши оценки. А нули у неё сдвинуты: каждый нетривиальный нуль
 дзета-функции даёт два нуля,
 и
 . Их вещественные части отличаются на
 , поэтому на критической прямой может лежать самое большее один из них, а другой обязательно вне её. Безусловно, без всякой гипотезы. Значит, любое рассуждение, которое использует только эти общие свойства, обязано где-то сломаться: для
 оно доказало бы неправду.
Важно, что ветку исследования убивает именно совпадение всех используемых предпосылок с тенью. Мы проверили, что все несущие предпосылки нашей линии оценок выполняются и для . Численная картина это подтвердила: при маленьком тень на наших окнах была почти неотличима от настоящей дзета-функции, разница в нужной величине порядка  . (Это численная диагностика, без строгого сертификата; сама по себе малая разница ничего бы не доказывала.) Ветку пришлось закрыть как путь к доказательству. Её результаты при этом никуда не делись, просто стало понятно, что они о другом.
Значит, корректный общий аргумент должен использовать хотя бы одно свойство, которого у тени нет. Кандидаты видны сразу: у два полюса вместо одного, она «второй степени» (произведение двух дзета-функций), её коэффициенты растут быстрее, чем разрешает так называемая гипотеза Рамануджана, у неё сдвинуты параметры гамма-факторов. Но этот список не обязан быть полным: метод может опираться и на более тонкое арифметическое свойство. Запомните вопрос: какое отличие от тени использует новое доказательство? Я вернусь к нему во второй части.
Контроль тоже надо контролировать. Если двойник не удовлетворяет хотя бы одной из предпосылок метода, он метод не опровергает. Модель без эйлерова произведения не закрывает подход, который этим произведением существенно пользуется. Это правило пришлось записать явно, потому что отрицательные выводы стали такими же размашистыми, как раньше положительные. Однажды, разобрав несколько конкретных «арифметических ядер» на основе НОД разных простых и увидев, что все они вырождаются, мы поспешили объявить закрытыми любые арифметические ядра. Это было слишком широко: из того, что НОД 7 и 13 равен 1, не следует, что вся их совместная арифметика пуста (НОД чисел 6 и 12, то есть  и
 , равен 6).
Различаются три вещи: предъявлен контрпример; доказана невозможность метода в заданном классе; поиск пока ничего не дал. Третье нельзя переименовывать во второе.
В репозитории: notes/HYPOTHESIS_ADMISSION_GATE.md, notes/SHADOW_WORLD_REGISTRY.md, notes/SHADOW_SHIFTED_PRODUCT_L_ALPHA_2026-11-07.md.
14. Конечный сертификат и бесконечный хвост
Численные эксперименты были нужны не для красивых графиков. Они находили опасные направления, подсказывали тесты, показывали, какая оценка вообще правдоподобна. Но у конечной матрицы и бесконечного оператора разные обязанности, и эта разница асимметрична.
Если мы урезали форму до конечного подпространства и нашли в нём тест со строго отрицательным значением, а погрешность надёжно оценена, это настоящий отрицательный результат: форма не положительна. А если все собственные значения конечной матрицы положительны, вывод гораздо слабее: мы проверили выбранное подпространство, а за его пределами могло остаться отрицательное направление. Один плохой тест опровергает положительность. Тысяча хороших тестов без контроля остального её не доказывают.
«Хвост» здесь — не обязательно большие или далёкие простые. Это все направления пространства функций, не попавшие в конечную модель, и их взаимодействие с уже посчитанной частью. Две подсистемы могут по отдельности пройти проверку, а их связь всё испортит. Скоро увидим это на матрице из четырёх чисел.
Про точность. Допустим, программа напечатала минимум 0,0008. Если доказанная погрешность до 0,001, знак неизвестен. Если же весь гарантированный интервал результата лежит между 0,0007 и 0,0009, знак установлен. Интервальный сертификат обязан учитывать все источники ошибки, а не приписывать последней цифре удобный допуск. Больше знаков после запятой и больше гарантированной точности — разные вещи. Часть такой работы мы довели до Lean, и здесь важно точно сказать, какую. В Lean проверена нижняя оценка конечного блока 250×250: для любой вещественной матрицы, элементы которой лежат в явно указанных интервалах, её квадратичная форма на каждом векторе не меньше явно вычисленной положительной константы, умноженной на квадрат длины вектора. (Именно так, с квадратом длины: на нулевом векторе форма равна нулю, а при умножении вектора на она умножается на  .) Отдельная точная рациональная проверка (62 500 сравнений) подтвердила, что интервалы, полученные численно для настоящих элементов матрицы (интервальной арифметикой с гарантированной точностью), лежат внутри интервалов из Lean-теоремы. А вот переход от этого блока к полной бесконечномерной форме на окне использует ещё аналитическую редукцию и оценки хвоста, и этот переход наш Lean-прогон не сертифицирует. Три разных утверждения: оценка блока (Lean), проверка вложения интервалов (точная арифметика вне Lean), редукция полной формы к блоку (бумага). Склеивать их в одно «Lean доказал положительность на окне» нельзя.
А если сертифицирована и вся редукция, то получен честный результат: все тесты с таким носителем проходят. Но и он не решает глобальную задачу. Носитель можно расширить, и тогда появятся новые функции и новые сдвиги . О новом пространстве старый сертификат ничего не знает.
Одно полезное наблюдение работает в обратную сторону. При расширении носителя старые тесты никуда не деваются, и значения полной формы на них не меняются. Поэтому если отрицательное направление однажды появилось, следующее расширение его не «вылечит». Задача не в том, чтобы исправиться после провала, а в том, чтобы запретить первый провал. (Речь именно о полной форме; если по ходу менять её состав, например убирать слагаемые, это уже другой эксперимент.)
В репозитории: notes/chronology/PROVED_CLAIMS_AUDIT_2026-09-27.md, notes/R28_LEAN_PROBE_C_2026-11-05.md.
Если коротко. Вторая эпоха (лето 2026) перевела задачу на язык формы Вейля: RH ⇔ сторона простых чисел неотрицательна для всех тестов. Мы искали геометрию, которая сделает форму квадратом длины, и научились убивать собственные идеи двойниками дзета-функции. Конечные сертификаты честны, но говорят о конечном блоке, а в лучшем случае об одном окне.
15. Окно растёт: старое ядро и новая оболочка
Третья эпоха проекта (конец лета и осень 2026) началась с попытки поймать бесконечный квантор за хвост. Раз положительность на одном окне можно сертифицировать, давайте докажем, что она не теряется, когда окно расширяется. Тогда, расширяя окно шаг за шагом, мы покроем все тесты.
Тут понадобится чётность. У чётной функции 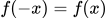 , её график зеркально симметричен. Нечётная меняет знак при отражении. В одной из наших постановок форма Вейля на окне
 превращалась в оператор
 на пространстве чётных функций с нулевым средним. (Откуда нулевое среднее: мы брали производную нечётного теста, а интеграл производной равен разности значений на концах, то есть нулю.)
Расширим окно от до  . Новое пространство состоит из старого ядра и двух новых полосок по краям, которые мы называли оболочкой. Есть одна тонкость, которую легко проглядеть: функция может иметь нулевое общее среднее, хотя по ядру и по оболочке её средние по отдельности ненулевые. Поэтому к оболочке приходится добавить ещё одно направление, которое переносит среднее из ядра в оболочку:
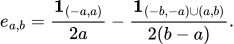
(Здесь  с индексом — функция, равная единице на указанном множестве и нулю вне его.) Забудь его, и мы доказали бы утверждение для меньшего класса функций, чем нужно, даже не заметив этого.
В таком разложении оператор становится блочной матрицей:  отвечает за старые направления,
 за новые,
 за их взаимодействие.
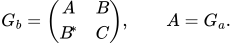
Хватит ли того, что и положительны? Нет, перекрёстный блок может всё испортить. Точное условие (при  ) таково:
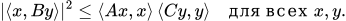
Вот куда переехала вся трудность. Может, сделать оболочку тонкой, и взаимодействие станет маленьким? Посмотрим на матрицу
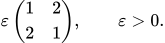
Возьмём вектор  : матрица переводит его в
 , а форма на нём равна
 . Оба диагональных элемента положительны, все четыре элемента сколь угодно малы, а отрицательное направление никуда не девается. Важен не абсолютный размер взаимодействия, а его размер относительно энергии тех направлений, которые оно связывает.
И второй пример, против другой надежды. Пусть оператор умножает первую координату на 1, вторую на 1/2, третью на 1/3 и так далее. Его форма строго положительна на каждом ненулевом векторе. Но вектор  имеет длину 1 и энергию
 , так что никакого общего запаса
 («энергия не меньше , умноженного на квадрат длины») нет. «Строго больше нуля на каждом векторе» и «не меньше
 на всех векторах» — разные утверждения, и в бесконечномерном мире второе бывает ложным при истинном первом. Поэтому следующее маленькое взаимодействие могло оказаться большим по сравнению с ещё меньшей положительной энергией.
Мы получили точный контракт будущего доказательства, и это настоящий результат. Но контракт не механизм: блочное неравенство выше равносильно положительности нового большого блока, то есть тому, что мы и хотели доказать. Продвижение было бы, если бы удалось вывести его из специальных свойств наших простых чисел, не используя заранее искомый знак. Этого мы не сделали.
16. Следим за самым слабым направлением
Раз все направления сразу не удержать, можно следить за одним, самым опасным: за наименьшей энергией нормированного теста, назовём её  . Пока она положительна, форма на окне положительна. Если при расширении окна дойдёт до нуля и уйдёт в минус, всё пропало. Хочется доказать, что так не бывает.
Первая наивная надежда: в момент касания нуля производная тоже ноль, значит, касание без пересечения. Не значит. Функция 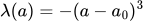 имеет нулевую производную в
 и при этом спокойно пересекает ноль. Мы держали этот пример как контрольный: если предлагаемое условие выполняется у кубического пересечения, оно ничего не запрещает.
Условие посильнее работает: если  с неотрицательным , у которого конечный интеграл, и
 в начале положительна, то не может обнулиться за конечное время (это неравенство Гронуолла: падать можно только пропорционально текущему запасу). Есть и техническое условие: должна быть достаточно регулярной (абсолютно непрерывной), чтобы её изменение восстанавливалось интегралом производной, а неравенство может выполняться почти всюду. У нас доказательство такой регулярности само было отдельным вопросом. Но надо получить из независимых свойств задачи. Если сначала предположить, что нигде не ноль, а потом определить делением на , запрет пересечения уже спрятан внутри доказательства. Опять функция без входного аргумента.
Была ещё ветка с определителем. Разложим форму на гарантированно положительную часть и вычитаемую добавку,  , и измерим
 в единицах (получится так называемый оператор Бирмана–Швингера
 ). Для конечной матрицы нулевой определитель означает, что есть вектор, который она отправляет в ноль. Для нашей конкретной согласованной формы (с общей областью определения и нужной компактностью) мы аналитически, на бумаге, а не в Lean, обосновали, что подходящий определитель
 существует и непрерывен, и его нули отвечают ровно «нулевым модам» формы, тем самым опасным направлениям. Это не пустой результат: расплывчатый разговор «об операторе и его спектре» превратился в конкретную функцию с проверяемыми свойствами. Но непрерывная функция тоже может обратиться в ноль. Получился прибор, который обнаружит проблему. Запрета проблемы не получилось.
И последняя попытка из этой серии: выбрать конус «хороших» векторов (например, векторы с неотрицательными координатами) и доказать, что эволюция  не выводит из него. Может, это ограничит знак ? Нет: для
 эволюция
 растягивает всё и сохраняет любой конус, а оператор при этом отрицателен.
К этому моменту мы научились заранее задавать себе вопрос, который сэкономил бы нам месяцы в начале: если конструкция получится, какая именно недоказанная стрелка станет доказанной? Если ответ «никакая», строить конструкцию незачем.
(Для любопытных: в этой же серии была тонкая история о том, какая гладкость нужна «нулевым модам». Сначала мы требовали от них слишком сильной регулярности,  . Потом нашли другое достаточное условие: если мода, продолженная нулём, непрерывна, равна нулю вне отрезка и имеет ограниченную вариацию (BV, конечная сумма всех подъёмов и спусков графика), то её автокорреляция непрерывно дифференцируема. Непрерывность здесь обязательна: у индикатора отрезка
 вариация ограничена, а корреляция
 имеет излом. И главное: доказать ограниченную вариацию у самих исследуемых мод ещё предстояло. Урок: можно потребовать от промежуточного объекта больше, чем нужно, и самому себе перекрыть дорогу; а найденное достаточное условие — ещё не выполненное.)
17. Теорема с невыполнимым условием
Теперь обещанный эпизод про формальную проверку. Он мой любимый, потому что развенчивает самый популярный миф о Lean.
Сначала разминка. Утверждение «для любого вещественного , у которого  , выполняется что угодно» истинно. Противоречия в логике нет: просто нет ни одного , с которым в эту теорему можно войти. В Lean это выглядит как функция, которая принимает доказательство невозможного и возвращает что угодно. Она корректна, она компилируется, и она бесполезна.
Теперь наш случай. В старой обёртке критерия Вейля тип «пробной функции» был просто «функция из вещественных чисел в комплексные», любая. Без требований непрерывности, конечного интеграла или того, что функция равна нулю вне ограниченного отрезка. А главная теорема требовала, чтобы для каждой такой функции её автокорреляция удовлетворяла формуле обращения Меллина. Это и было условие «допустимости».
Оказалось, что это условие не просто трудное, а ложное. Возьмём самую обычную функцию  . Её «мультипликативная» автокорреляция (сравниваем копии функции в разных масштабах, а не со сдвигами) вычисляется явно:
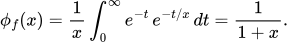
Формула обращения Меллина требует интегрировать  по лучу при
 . Но при больших модуль этого выражения ведёт себя как
 , а такой интеграл на бесконечности сходится только при
 . Интеграла нет.
Дальше важная деталь библиотеки Mathlib. Операция интегрирования там определена для всех функций, и для неинтегрируемой она по соглашению возвращает ноль. Это не математическое заявление «расходящийся интеграл равен нулю», а значение по умолчанию, как у API, которое на недопустимом входе возвращает 0, а не падает. Чтобы пользоваться теоремами об интеграле, нужно отдельно доказывать интегрируемость. А мы потребовали формулу обращения сразу для всех функций.
В итоге «преобразование» на всей вертикали формально равно нулю, обратный интеграл тоже ноль, а формула обращения в точке  должна вернуть
 . Получается
 . То есть условие допустимости в старой форме невыполнимо. Позже мы доказали это формально, в самом Lean, на другом свидетеле: функции
 при
 и нуле вне этой области.
Lean тут ничего не пропустил! Теорема честно говорила: «если выполнено условие допустимости, то…». Просто войти в неё было не с чем. Зелёная сборка подтверждала корректность импликации, а не то, что импликацию можно применить.
Починка была содержательной. Класс пробных функций сузили до функций с непрерывной производной (класс  ), равных нулю вне некоторого отрезка
 с
 . Класс не пуст: на
 можно взять
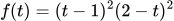 и ноль вне отрезка; на концах обнуляются и значение, и производная, так что склейка гладкая. А
 в новый класс не входит, она никогда не становится тождественным нулём. После этого пришлось заново доказать допустимость для всех функций нового класса и провести этот класс через весь критерий. Нельзя было просто дописать слово «хорошая функция»: каждое требование должно было обслуживать конкретное интегрирование, перестановку предела или обращение преобразования.
С тех пор у меня в голове висит простое правило: зелёная сборка — это не конец работы. Нужно знать, что именно собрано, и существуют ли объекты, удовлетворяющие всем условиям.
В репозитории: notes/chronology/INDEX.md (сентябрь 2026: контрпример, ремонт тестового класса, пересборка критерия).
18. Оценка, которая действительно закрыла шаг
После ремонта понадобилась одна аналитическая оценка, и её удалось довести до конца. Эта история полезна как контраст: так выглядит задача, которая трудна, но решаема.
В явной формуле участвует гамма-функция  , обобщение факториала:
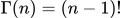 для натуральных . Нужна была оценка роста её логарифмической производной (производная, делённая на саму функцию) на вертикальных прямых:
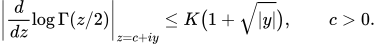
Зачем: преобразование допустимых тестов убывает как  , и после умножения на эту оценку остаётся хвост порядка
 , интеграл которого конечен. Самая точная асимптотика была не нужна, достаточно было попасть на правильную сторону границы сходимости.
На бумаге это короткая цепочка через ряд
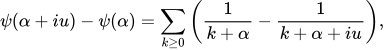
где каждый член оценивается через 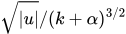 . А в нашей версии Mathlib нужного тождества не было готовым. Пришлось идти через конечные приближения гамма-функции и обосновывать переход к производным, а для этого нужна локально равномерная сходимость аналитических функций (один порог точности сразу для всех точек компакта). Несколько раз мы честно останавливались на промежуточном результате: непрерывность доказана, оценка ряда доказана, итоговая оценка пока условна. Потом закрывался следующий переход.
Такое продвижение не надо ни обесценивать, ни продавать как кусок доказательства RH. Мы закрыли долг в аналитическом инструменте, и критерий стал доступен без лишней предпосылки. Положительность, которую он требует, осталась открытой. Разница между «назвать известную процедуру и выполнить её» и «найти механизм, которого никто не предъявил», здесь видна очень отчётливо.
19. Что у нас было к осени
К сентябрю 2026 года в проекте появилась формальная цепочка, без невыполнимых условий, которая связывает положительность формы Вейля на исправленном классе тестов с канонической гипотезой Римана из Mathlib. Сентябрьский аудит заново проверил итоговые утверждения и список аксиом, от которых они зависят. Но математически это по-прежнему «RH тогда и только тогда, когда выполнена такая-то положительность». Надёжный мост к цели, не сама цель.
Были и небольшие положительные продукты. Например, для одной вспомогательной непрерывной симметричной формы мы доказали общую импликацию: если на ядре непрерывного линейного измерения у формы есть равномерный положительный запас (не меньше  с
 , а не просто «больше нуля на каждом векторе» — помните оператор с энергиями из главы 15), а один нормированный пробный вектор даёт отрицательное значение, то существует представитель этого измерения с отрицательным значением. Вывод настоящий, но нужный равномерный запас для интересовавшего нас объекта ещё требовал отдельного доказательства.
Параллельно шли линии, которые легко принять за процент готовности. Например, доля нулей на критической прямой. Известно, что значительная доля нулей лежит на прямой; можно мечтать довести долю до 100%. Но даже 100% ничего не решает. Вычеркните из натурального ряда все степени двойки: 2, 4, 8, 16, … Доля оставшихся чисел среди первых  стремится к 100%, а исключений бесконечно много. Результат о доле ценен сам по себе, но процентом готовности RH он не является.
В октябре мы смогли задать вопрос ещё жёстче: какую информацию обязана сохранить любая конструкция, претендующая на точное представление формы Вейля? Представьте устройство, которому подают пробную функцию, но оно видит её только вне некоторого интервала. Если изменение функции внутри интервала меняет форму Вейля, устройство не может её вычислять. Для конкретных классов таких устройств мы доказали теорему о недостаточности информации. Самый наглядный случай: если тест короткий, все корреляции со сдвигами просто исчезают (копии не перекрываются), а архимедова часть формы продолжает различать тесты. Значит, одних «арифметических» данных мало, чтобы восстановить форму. Добавить конечное число измерений тоже не помогает.
Из этого следовал запрет на одну конкретную мечту: представить всю форму Вейля точно и линейно через один фиксированный конечномерный геометрический объект. Каждое слово тут важно. Теорема не запрещает растущую последовательность моделей с контролем остатка. Не запрещает и оценку совсем другого типа, которой точное представление не нужно. (Запомните эту оговорку: во второй части окажется, что опубликованное доказательство устроено именно как растущее семейство объектов.)
И ещё одно отрезвляющее наблюдение. Матрица из чисел 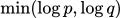 по всем парам простых положительна. Красиво? Но причина положительности общая:
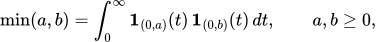
то есть это матрица Грама индикаторов отрезков. Вместо логарифмов простых можно подставить любые неотрицательные числа. Красивый факт не использует ничего специфического для простых чисел. Мы научились задавать себе экономящий время вопрос: если в конструкции заменить простые числа произвольными параметрами, доказательство всё ещё работает? Если да, то где в нём вообще могло появиться содержание гипотезы Римана?
В репозитории: notes/chronology/PROVED_CLAIMS_AUDIT_2026-09-27.md, notes/K18_BLINDNESS_THEOREM_2026-10-18.md, notes/K22_K24_MIN_KERNEL_PRECHECK_2026-10-19.md.
20. Как далеко мы дошли
Теперь можно ответить на вопрос, который мне самому хотелось задать с самого начала: насколько готово было наше доказательство? Процента здесь нет, и честный ответ состоит из двух половин.
Первая половина: мы продвинулись в точности. Научились отличать настоящую дзета-функцию от неправильно продолженного ряда, правильный класс тестов от произвольных функций, положительность от самосопряжённости, конечную проверку от контроля всего пространства. Получили формальные мосты, аналитические инструменты, сертификаты на окнах, контрпримеры к конкретным надеждам и способ быстро проверять, не потеряла ли новая конструкция нужную информацию.
Вторая половина: механизма, который обеспечил бы нужное свойство на всех масштабах сразу, у нас не было. На одном языке это было , на другом закон накопления выигрышей, на третьем положительность формы Вейля, на четвёртом отсутствие нулевых мод при расширении окна. Требования формулировались всё точнее, а их источник так и не нашёлся. Фраза «осталось одно звено» не означала, что почти вся работа сделана: внутри звена могла жить целая новая теория.
Ошибки у нас были очень разные. Где-то терялся множитель. Где-то теорему применяли не к тому классу функций. Где-то желаемое свойство пряталось в предпосылке. Где-то хорошая локальная конструкция не имела глобального продолжения. А иногда мы слишком широко объявляли закрытым целое направление. Если назвать всё это одним словом «не получилось», исчезнет как раз то знание, ради которого стоило вести журналы.
21. С каким вопросом открывать чужое доказательство
После этой истории я не хочу открывать новое доказательство с вопросом «какая там последняя теорема?». Последнюю теорему мы и сами научились записывать. Меня интересует другое: откуда берутся её предпосылки?
Наши ошибки превратились в список вопросов, с которыми можно читать чужую конструкцию предметно.
Если в ней растёт длина какой-то цепочки, как растёт цена каждого шага? (Наша буква
.)Если появляется «константа», не зависит ли она тайком от растущего параметра?
Если разные объекты сравниваются, где построено общее пространство и согласованы ли нормировки? (Наша геометрия без общего объекта.)
Если что-то «мало», мало ли оно относительно энергии того, что оно портит? (Наша матрица
 .)
Если доказательство работает, что оно использует такого, чего нет у тени
?
Возможно, чужой путь вообще обходит ту задачу, которую мы пытались решить в лоб. Так и окажется. Но для следующей части главный вопрос звучит так: можно ли создавать арифметический выигрыш и одновременно контролировать цену его создания, причём так, чтобы потери в показателе можно было сделать сколь угодно малыми?
Мы много раз точно называли недостающее. Во второй части посмотрим на конструкцию, которая это недостающее производит.
Словарик первой части
Слово | Что значит в этом тексте |
|---|---|
Нетривиальный нуль | Нуль дзета-функции в полосе |
Критическая прямая |
|
Эйлерово произведение | Запись |
| Вес фон Мангольдта: |
| Корень из интеграла квадрата; «длина» функции |
Матрица Грама | Таблица попарных скалярных произведений; всегда положительна |
Преобразование Меллина | Интеграл функции с весом |
Форма Вейля | Сторона «простых чисел» в явной формуле; её положительность равносильна RH |
Тень | Объект с теми же свойствами, что используются в рассуждении, но с нулями вне прямой |
Сертификат | Проверенное (с учётом всех погрешностей) утверждение о конечном объекте |
 ; RH говорит, что все нетривиальные нули на ней
 как произведения по простым числам
 на степенях простого
Материалы
Все ссылки ведут внутрь закрытого репозитория проекта (доступ по запросу, см. начало статьи). Старые пометки статуса в ранних заметках не отменяют поздних аудитов: если ранняя заметка и аудит расходятся, прав аудит.
notes/chronology/INDEX.md— хронология проекта с поздними исправлениями.docs/01_MOTIVATION.md,docs/05_RIEMANN_PROOF_ERRORS.md— январь 2026: фреймы, гауссово окно,-адика.docs/09_DIMENSION_HYPOTHESIS.md,docs/14_LADDER_DENSE_SALVAGE.md— лестница и её починка.
docs/17_MELLIN_ANALYSIS_FINDINGS.md— ранняя заметка с ошибкой в формуле Меллина (сохранена как пример).notes/FrontierConvergenceMap.md— почему геометрические кандидаты не соединились.notes/HYPOTHESIS_ADMISSION_GATE.md,notes/SHADOW_WORLD_REGISTRY.md— правила работы с тенями и их реестр.notes/chronology/PROVED_CLAIMS_AUDIT_2026-09-27.md— сентябрьский аудит того, что доказано, а что нет.notes/K18_BLINDNESS_THEOREM_2026-10-18.md,notes/K22_K24_MIN_KERNEL_PRECHECK_2026-10-19.md— октябрьские ограничения.
Классика: A. Beurling, A closure problem related to the Riemann zeta-function, PNAS, 1955 (pmc.ncbi.nlm.nih.gov/articles/PMC528084); L. Báez-Duarte, A strengthening of the Nyman–Beurling criterion, 2003 (arXiv:math/0202141).