Комментарии 18

Хорошо написанные концептуальные статьи сообщество одобряет. См "пружинный предел". В статье должна быть ценность либо практическая, либо хотя бы "любопыственно-развлекательная". Абстрактных потоков мыслей у каждого хватает своих.

Вы про личную ценность говорите ?
Я видел много ценной информации "для людей", но её минусуют , потому что она не ценна лично читателю "здесь и сейчас".
.

Забавно смотреть на человека, который с 2015 года сидит тут, комментирует, аккуратно держит "карму" и ни разу не рискнул написать собственный текст. Только раздаёт другим методички про «правильные» посты. Любой выход за привычный формат тут же объявляется «абстрактным потоком мыслей» и «без практической ценности». Этот пост как раз про таких: про людей, которым проще записать чужую работу в чушь, чем признать, что она не укладывается в их собственную рамку.
Есть такая штука "инженерное мышление". Инженеры любят прикладные науки, абстрактные мы терпим, пока те помогают развивать прикладные. Есть в науке, в частности, в математике и очень абстрактные вещи, но пока компьютеры оперируют числами, среднему инженеру будет казаться полезнее информация про численные методы, чем, например, про топологию(как минимум до тех пор, пока не появится задача, где знание топологии будет полезно хоть краешком). Хорошая информация с точки зрения инженера это то, что помогает как-то очень определенным образом воздействовать на мир для получения каких-то определенных результатов, либо объясняющая устройство мира таким образом, что оно имеет (хотя бы очень потенциальную) предсказательную ценность. Вы можете у себя в голове строить замки любой структуры и сложности, использовать какой угодно собственный понятийный аппарат, но пока это не позволяет решать какие-то конкретные задачи или хотя бы что-то предсказывать лучше и проще чем уже существующие методы с уже существующим и понятным большинству тех, кто в теме понятийным аппаратом, то среди инженеров понимания вы не найдете. И хабр судя по всему всё ещё инженерный ресурс, судя по распределению голосов. Вы можете сказать мы скучные, мы снобы, мы зануды в штыки принимающие всё новое, но мы просто не хотим забивать свой ментальный ресурс тем, что не работает, а следовательно не очень интересно и не нужно. Вы можете храбро грести против мнения большинства, отплевываясь от минусов, рассчитывая на то, что хотя бы человек один из тысячи что-то для себя найдет, или поискать более подходящую аудиторию на других ресурсах.
По-моему, вы сейчас описали не 'инженерное мышление", а фильтр: всё, что не даёт сразу готовый инструмент, автоматически записывается в "не работает и не нужно" .
Только новые методы как раз и рождаются из этих самых "замков в голове" , которые поначалу выглядят лишней абстракцией.
То, что вам неинтересно и не вписывается в привычный Хабровский формат, ещё не значит, что это бесполезно.
У меня был пост с онко-моделью: ОНКО ИИ , данные, код, метрики, GitHub , полный набор "практической ценности" . Его так же дружно заминусовали.
Поэтому рассказывать мне про "инженерное мышление" и "мы ценим только то, что работает" странно.
То, что не является ни готовым инструментом, ни его компонентом, ни теорией обобщающей инструменты позволяющей создать новый, ни моделью с предсказательной ценностью, позволяющей лучше понять устройство мира, а теорией состоящей из плохо связанных абстракций и шансом породить новую научную методологию примерно таким же, как встретить на улице настоящего живого тиранозавра действительно отсекается пресловутым фильтром инженерного мышления. Можете считать это снобизмом, дело ваше.
Касательно статьи про онко модель. Если вы придумали новую сложную методолгию что даже пришлось вводить свои термины, а ваша статья состоит из нескольких абзацев, которые не объясняют можно сказать ничего это очень странно и подозрительно. Методология такого уровня написанная по всем правилам раздула бы статью настолько что её даже пришлось бы дробить на несколько. У вас нет никакой информации как тренировалась модель, что за коэффициенты, откуда они вообще берутся, как другой человек мог бы повторить их расчет и получилось ли бы у него такими же. Я могу взять модель достаточного размера, натренировать её на датасете, получить точность 99% (на том же датасете), потом взять выходы нейронов предпоследнего слоя и назвать их красивыми метафизическими именами: "Мудрость", "Воплощенность", "Статичность", "Восхождение", "Одухотворенность", и хопа я автор новой научной методологии куда подставлять мешок с деньгами.
В онко-посте нет ни "метафизических нейронов", ни скрытых коэффициентов.
R, I и G это просто три группы признаков из стандартного датасета, а не "новые символы".
Полные веса модели, отчёт по кросс-валидации и пример кода лежат открыто на Zenodo и GitHub , любой желающий может взять sklearn.load_breast_cancer, запустить и получить те же метрики.
Хабровский пост это короткое описание с ссылками, а не перепечатка всего отчёта.
Так что проблема не в "отсутствии методологии", а в нежелании открыть ссылку и посмотреть на реальные файлы.
Я могу взять модель достаточного размера, натренировать её на датасете, получить точность 99% (на том же датасете)
Вы это не сделаете. Потому что инженерный мозг, который потребляет, а не является автором идей 😉
У вас бинарные веса какой-то модели в репозитории. Ни слова ни об архитектуре, ни о том как тренировали её, ни в чём чем заключается новшество подхода. Невозможно повторить, потому что нигде нет ни кода ни методики тренировки модели. Распечатанный инференс на три(карл!) строчки.
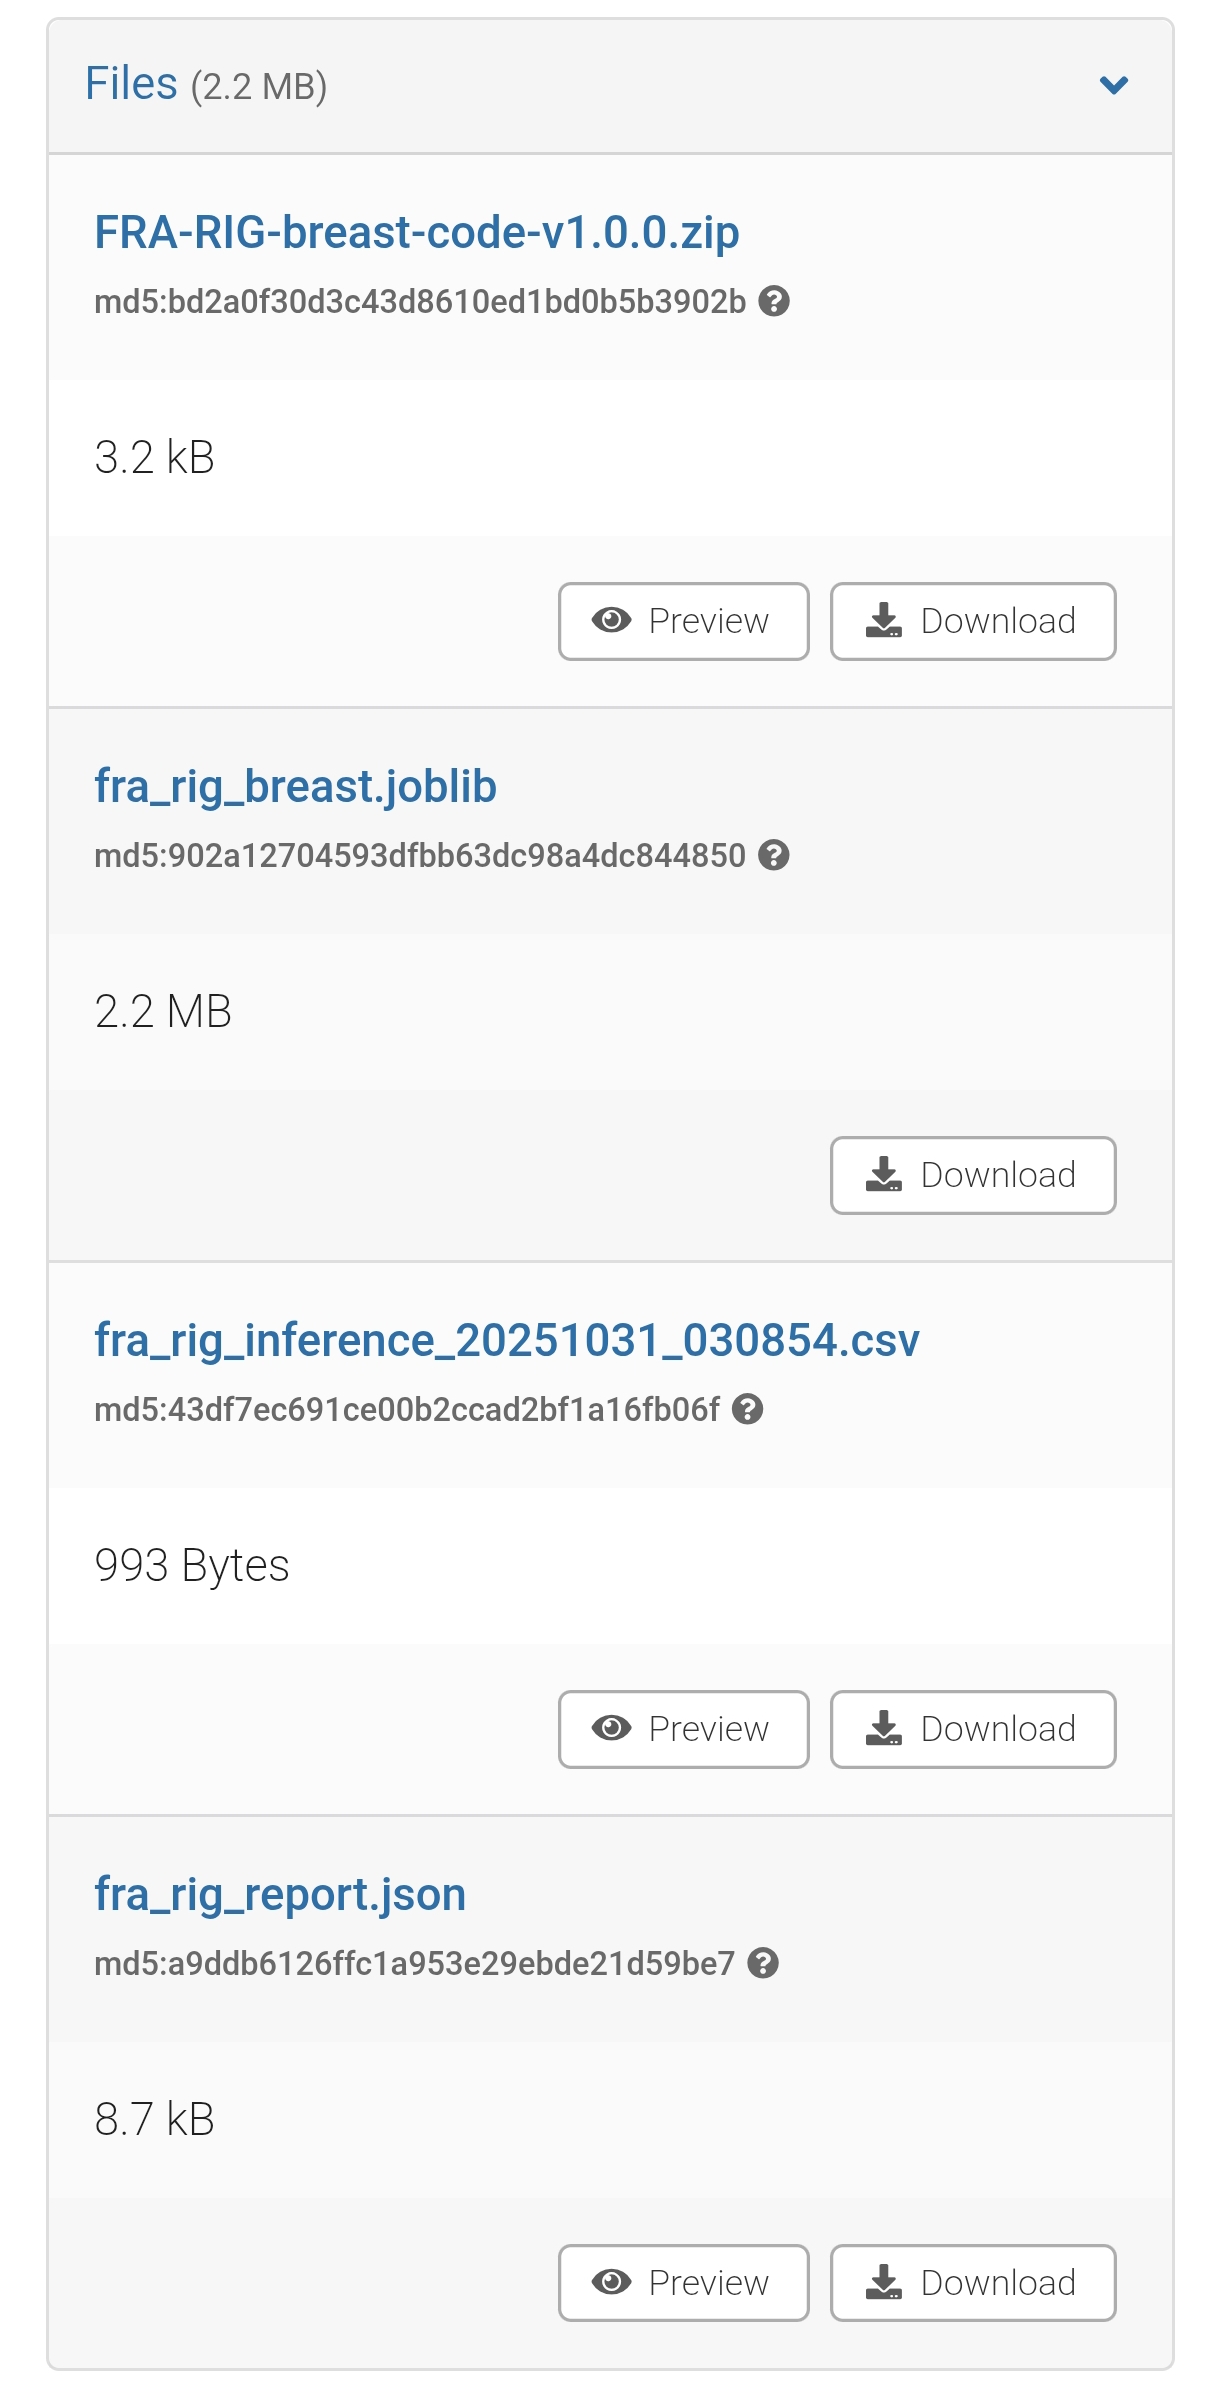
И что я должен тут увидеть? Там нет абсолютно ничего связанного с процессом обучения модели. Нет описания архитектуры на человеческом языке. Нет никакого описания метода. Попросить ChatGPT или любой модный вайбкодерский инструмент написать классификатор под известный датасет может сейчас кто угодно, кто знает эти названия.


Чтобы подтвердить изложенное этот материал надо будет минусануть

Интересные дебаты в комментариях. 😆

Намёк понят
Зарегистрируйтесь на Хабре, чтобы оставить комментарий
На техплощадках важен не только смысл, но и ритуал. Привычная «правильная» статья выглядит так: узкая задача, немного...