Обновить

🤡 Новый фреймворк на NodeJS

Это не draft, а работающий код из прода. Посмотрите код сервиса, код http контроллера и код декларации

Шутки шутками, а существующие реализации DI на ноде либо перегружены, либо используют декораторы, для которых нет единого стандарта у старого и нового кода.

import { provide, inject } from "di-kit";

export class WalkerLogicPublicService {

  private readonly loggerService = inject<LoggerService>("loggerService");

  ...

}

...

provide("loggerService", () => new LoggerService());

Вот почему нельзя просто вот так? Никаких минусов нет, выносите типы в enum, создавайте изолированные пространства имен.

import { createActivator } from "di-kit";

export const { init, inject, provide } = createActivator("separate-scope");
Теги:
Всего голосов 6: ↑6 и ↓0+8
Комментарии0

125 токенов в секунду на RTX 4070 Ti SUPER: как я заставил локальную LLM работать полноценным кодинг-агентом

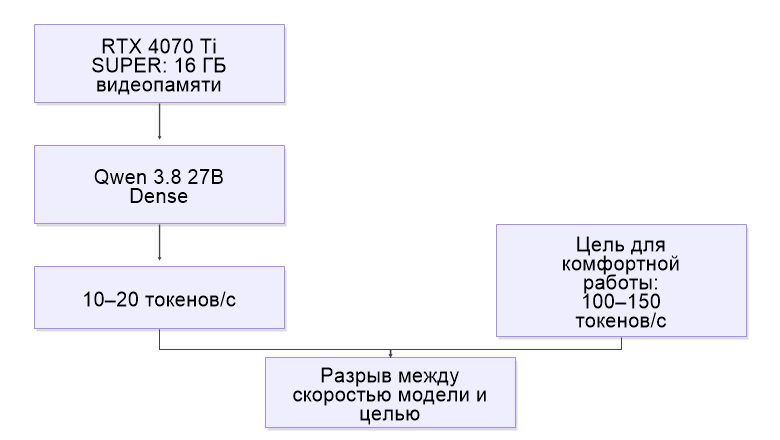
По статистике, среди рядовых пользователей настольных компов самая распространенная видеокарта имеет 16 ГБ видеопамяти. По опросам GaugeDB, такие карты занимают 27,21% рынка. У меня как раз видеокарта NVIDIA GeForce RTX 4070 Ti SUPER с 16 ГБ видеопамяти GDDR6X, которая на текущий момент стоит 900$. До сего момента главной проблемой было то, что на видеокарте такого класса невозможно было запустить LLM-агента, который будет достаточно умным и достаточно быстрым. Если запускаешь умную модель типа Qwen 3.8 27B (Dense архитектура), то на выходе получаешь 10-20 токенов в секунду. А для комфортной работы кодинг-агента надо 100-150 токенов в секунду.
125 токенов в секунду на RTX 4070 Ti SUPER: как я заставил локальную LLM работать полноценным кодинг-агентом

Публикации