Обновить

Роузберри, креативный директор французского дома моды Schiaparelli («Скиапарелли»), представил кутюрный показ бренда 2024 года в Париже.

Когда нормальные люди думают об одежде от кутюр — экстравагантном индивидуальном дизайне с использованием всех, кроме устаревших технологий, материалов и мастерства, — они, вероятно, мечтают о вещах, изготовленных из роскошного шелка, мягкой кожи, кристаллов и тюля. Дэниел Роузберри думает о твоём старом телефоне-раскладушке.

Кукла-робот в натуральную величину и короткое коктейльное платье, оба полностью покрыты техническими отходами. Старые телефоны, калькуляторы, провода, материнские платы и компакт-диски используются в качестве украшений так же, как блестки или бусины могут украсить менее амбициозную одежду. Роузберри сказал, что малыш был отсылкой к фильмам «Чужой», и рассказал, что он искал вдохновение в своих воспоминаниях в эпоху ремиксов своих коллекций, созданных искусственным интеллектом.

Младенец и платье, получившее прозвище «Мать», наполовину человек, наполовину объект, восстающий из прошлого и преследующий будущее. Собранные с использованием материалов, существовавших до появления iPhone, эти предметы, кажется, предупреждают о бесчеловечном существовании роботов. В то же время они реконтекстуализируют технологические отходы более простых времен.

«Теперь технология, на которой я вырос, настолько устарела, что ее почти так же сложно найти, как некоторые винтажные ткани и украшения», — написал Роузберри в аннотации к выставке.

Теги:
Всего голосов 4: ↑4 и ↓0+4
Комментарии3

125 токенов в секунду на RTX 4070 Ti SUPER: как я заставил локальную LLM работать полноценным кодинг-агентом

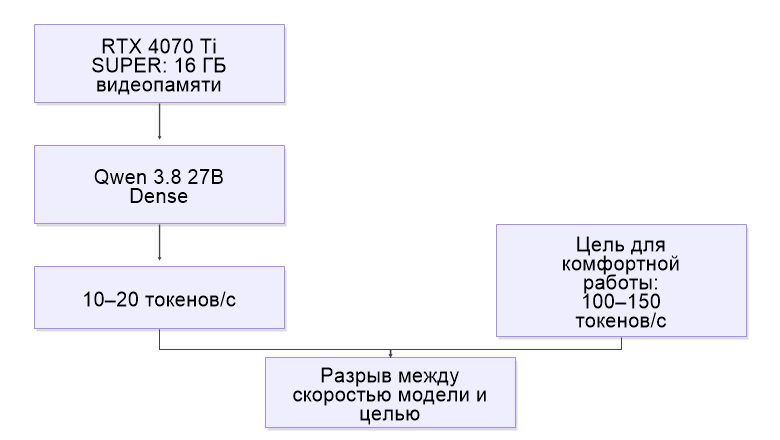
По статистике, среди рядовых пользователей настольных компов самая распространенная видеокарта имеет 16 ГБ видеопамяти. По опросам GaugeDB, такие карты занимают 27,21% рынка. У меня как раз видеокарта NVIDIA GeForce RTX 4070 Ti SUPER с 16 ГБ видеопамяти GDDR6X, которая на текущий момент стоит 900$. До сего момента главной проблемой было то, что на видеокарте такого класса невозможно было запустить LLM-агента, который будет достаточно умным и достаточно быстрым. Если запускаешь умную модель типа Qwen 3.8 27B (Dense архитектура), то на выходе получаешь 10-20 токенов в секунду. А для комфортной работы кодинг-агента надо 100-150 токенов в секунду.
125 токенов в секунду на RTX 4070 Ti SUPER: как я заставил локальную LLM работать полноценным кодинг-агентом

Публикации