Обновить

🌐 HTTP-метод QUERY: новый метод для поисковых запросов

В мире HTTP давно существует проблема с передачей сложных поисковых запросов. Когда разработчику нужно передать большой набор параметров для поиска или фильтрации, у него есть два не самых удачных варианта.

Можно использовать GET и передавать всё в URL:

GET /feed?q=foo&limit=10&sort=-published&filters[]=status:active&filters[]=type:post

Но URL дефакто имеет ограничения по длине, а кодирование сложных параметров становится громоздким.

Второй вариант — использовать POST и передавать параметры в теле запроса. Однако POST не предназначен для таких операций: он не кэшируется и не является идемпотентным, что усложняет работу с CDN и повторную отправку запросов.

Именно поэтому появился новый метод QUERY. Он позволяет отправлять поисковые параметры в теле запроса:

QUERY /feed

Content-Type: application/json
{
  "q": "foo",
  "limit": 10,
  "sort": "-published",
  "filters": ["status:active", "type:post"]
}

При этом QUERY сохраняет все преимущества GET: он безопасный, идемпотентный и кэшируемый. Cочетает поддержку тела запроса с возможностью кэширования.

Метод официально получил статус PROPOSED STANDARD, что означает скорое появление поддержки в браузерах и веб-фреймворках.

Если вам интересны подобные посты, подписывайтесь на tg-канал Cross Join

Теги:
Всего голосов 7: ↑6 и ↓1+6
Комментарии14

125 токенов в секунду на RTX 4070 Ti SUPER: как я заставил локальную LLM работать полноценным кодинг-агентом

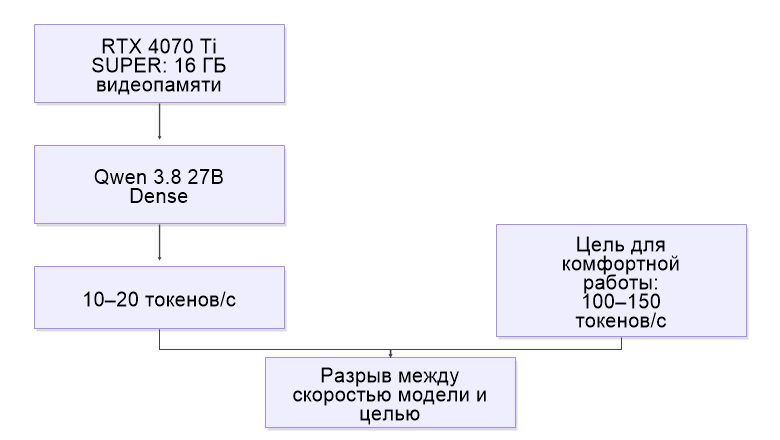
По статистике, среди рядовых пользователей настольных компов самая распространенная видеокарта имеет 16 ГБ видеопамяти. По опросам GaugeDB, такие карты занимают 27,21% рынка. У меня как раз видеокарта NVIDIA GeForce RTX 4070 Ti SUPER с 16 ГБ видеопамяти GDDR6X, которая на текущий момент стоит 900$. До сего момента главной проблемой было то, что на видеокарте такого класса невозможно было запустить LLM-агента, который будет достаточно умным и достаточно быстрым. Если запускаешь умную модель типа Qwen 3.8 27B (Dense архитектура), то на выходе получаешь 10-20 токенов в секунду. А для комфортной работы кодинг-агента надо 100-150 токенов в секунду.
125 токенов в секунду на RTX 4070 Ti SUPER: как я заставил локальную LLM работать полноценным кодинг-агентом

Публикации