Обновить
512K+

Программирование *

Искусство создания компьютерных программ

946,34
Рейтинг
Сначала показывать
Порог рейтинга

Привет хабр еще раз! Сегодня мы обсудим тему из книги Black Hat Rust, а именно подраздел первой главы «Почему Rust?». Этот кусок текста уже полностью адаптирован и ничего больше не должно резать слух.

Итак: Почему Rust?

Мир безопасности (и, в более широком смысле, софта) страдает от слишком большого количества языков программирования со слишком большим количеством граблей. Приходится выбирать между быстрым, но небезопасным (C, C++…) и медленным, но в основном безопасным (Python, Java…).

Может ли кто‑то быть экспертом во всех этих языках одновременно? Я так не думаю. Бесчисленные баги и уязвимости в инструментах атакующих доказывают, что я прав.

А что, если бы вместо этого у нас был один‑единственный язык?

Язык, который, будучи освоенным, удовлетворял бы все потребности области:

  • Шеллкоды

  • Кроссплатформенные инструменты удалённого доступа (RAT)

  • Многоразовые и встраиваемые эксплойты

  • Сканеры

  • Фишинговые наборы инструментов

  • Встраиваемое программирование

  • Веб‑серверы

  • и так далее

А что, если бы у нас был единственный язык, который достаточно низкоуровневый, но при этом предоставляет высокоуровневые абстракции, исключительно быстр и легко кросс‑компилируется? И всё это при безопасности памяти, высокой переиспользуемости и исключительной надёжности.

Никаких больше странных тулчейнов, странных сборщиков бинарников, уязвимого сетевого кода, инжектируемых фишинговых форм…

Вы поняли: Rust — язык, чтобы править всеми.

Из‑за инерции Rust ещё не получил широкого распространения в индустрии безопасности, но, как только техлиды и независимые хакеры осознают эту реальность, я считаю, изменения произойдут очень быстро.

Конечно, есть подводные камни и пара вещей, которые нужно знать, но всё это освещается в следующих главах.

Также можете почитать еще несколько моих уже готовых наработок, это главы с 0 по 3. Там текста гораздо больше! Найти их можно в моем репо на гитхабе вот ссылка еще раз: https://github.com/smokeplay250-png/black‑hat‑ru/ чтобы найти мои наработки вам надо перейти из main в /black hat books/in work/ru black hat rust/

Теги:
0
Комментарии2

Привет хабру! Снова.

В общем пока вы голосуете в опросе и пока побеждает Malware Development for Ethical Hackers от Zhassulan Zhussupov

Я исправляю некоторые неправильности перевода, которые режут слух пока что почти закончил 3 главу Black Hat Rust поэтому довольно скоро будет релиз уже полностью исправленной книги и потом возьмусь за Black Hat Ruby и надеюсь за то время, что я буду править перевод книг в опросе проголосует побольше людей вот ссылка если кто не видел прошлый пост https://forms.gle/pny2pD7G7f5Fhtno7

Связаться со мной или сообщить о некоторый неправильностях перевода например можно в группе в тг вот ссылка https://t.me/+Xome2X_nj-wyMDcy только не переусердствуйте!

Также хочу выразить огромную благодарность человеку с ником @stxdtm на хабре за то, что он единственный сказал про то, что в переводе некоторые слова режут слух.

Теги:
+2
Комментарии0

Поля этой IDE слишком узки

Подумалось тут, что LLM, похоже, заставляют пересматривать не только способы написания программ, но и сами принципы представления исходного кода, которыми мы пользовались десятилетиями.

Ну вот, например, комментарии. Какого чёрта они вообще должны находиться внутри исходников — очевидно же, что изначально «от бедности» — инструментальной бедности. Ферма́ с его «слишком узкими полями» улыбается и машет. Так вот — почему бы не хранить комментарии отдельно, привязывая к конкретным функциям, фрагментам или даже взаимодействиям между компонентами? Чтобы при необходимости можно было перейти по условной гиперссылке и прочитать, что, как и, главное, почему устроено именно так.

Особенно теперь, когда всё больше кода пишут LLM. Объяснение причин инженерного решения может быть куда ценнее самой реализации.

Закинул вопрос в ChatGPT: существуют ли уже подобные системы?

Оказалось, существуют. Он накидал несколько вариантов, от внешних аннотаций с привязкой к исходникам до довольно развитых систем документации. А заодно вспомнил Дональда Кнута и его концепцию Literate Programming.

1984 год, между прочим.

И вот тут меня слегка вштырило. Нет, не потому что Оруэлл. Просто Кнут предлагал писать программы прежде всего как текст, понятный человеку, в который встроены фрагменты программного кода. Специальные инструменты затем превращали это хозяйство в исходники для компиляции и документацию.

То есть первичным было человекочитаемое описание программы, а привычные исходники получались из него.

Ничего не напоминает?

Разумеется, у Кнута программные фрагменты приходилось писать самому, а tangle был детерминированным инструментом сборки, а не генератором кода из естественного языка.

Но сама архитектурная мысль-то какая!

1984: Literate Programming.

2026: Literate Prompting.

42 года спустя мы наконец додумались заменить tangle стохастическим компилятором.

Получается, Дональд Кнут придумал prompt engineering для LLM ещё в 1984 году. Просто LLM тогда немного не завезли.

Разумеется, после такого открытия я задал следующий вопрос: интересно, а кто-то уже замечал это?

Я так часто делаю, если что — и ChatGPT довольно часто портит мне «праздник первооткрывателя».

Итак,

оказывается, ещё в 2024 году прямо сравнивали prompt engineering с мечтой Кнута. В 2025-м Devin Weaverпришёл к практически той же мысли, обсуждая её с Claude. А в ноябре 2025 года вышла целая научная работа в IEEE Transactions on Software Engineering — Literate Programming with LLMs? — где авторы уже сопоставляют архитектуру WEB Кнута с генерацией программ посредством LLM.

Мало того, нашлись даже экспериментальные инструменты, в которых промпты считаются исходниками, а сгенерированный код — производным артефактом.

Так что да — не только заметили, но уже и публикации написали, и прототипы наколхозили.

Но первоначальный вопрос никуда не делся.

Если реализация всё чаще генерируется машиной, а понимание её назначения, ограничений и причин инженерных решений живёт отдельно, то не пора ли пересмотреть само представление программного проекта?

Возможно, исходники постепенно перестанут быть единственным центральным артефактом разработки. А текст, который объясняет, что, зачем и почему, перестанет быть приложением к коду.

Ирония в том, что для этого нам, возможно, пришлось пройти практически 42 (42, Карл!) года технологического развития, чтобы снова прийти к идее Кнута — теперь с пряниками печеньками и токенами.

Теги:
+3
Комментарии18

Почему мы до сих пор не уволены (или немного марксизма вам в ленту)?

Кого-нибудь посещала данная мысль? Агентная разработка вокруг нас уже пару лет. Уже около года она приносит несомненно огромные плоды, некоторые люди уже не пишут код руками, но работодатель всё ещё держит их при себе.

Всем (разрабам) приходят мысли — «сколько ещё это продлится?», «где граница, за которой AI-агенты достигнут того уровня, чтобы меня заменить» и т.д. А всё тянется как в том мемном ролике про грузовик и столб.

Почему всё так? Потому что капитализм.

Работодатель существует только потому, что существует свободный рынок труда. В этом дело. Каким бы ни был современный (или завтрашний) искусственный интеллект, он бесполезен (вреден?) для работодателя до тех пор, пока этот работодатель не сможет купить труд AI-агента на свободном рынке, а пока что этого и близко не видно.

Второй аспект — это свободный рынок средств производства для воспроизведения труда AI-агентов — его тоже нет и не предвидится.

Без свободного рынка труда и доступа к средствам производства для «производства труда AI-агентов» (я понимаю, как это звучит:) никакого перехода к замене человека на AI не произойдёт. Если работодатель решится на это, то он поставит себя в крайне нерыночные условия зависимости от (буквально) двух с половиной поставщиков услуг AI-агентов, что ставит под удар (делает невозможным) ведение бизнеса.

Для наших широт это ещё усугубляется и полной недоступностью этих 2.5 поставщиков.

Так что пока можно выдохнуть.

Теги:
-1
Комментарии0

Кто виноват, если ИИ ошибается — нейросеть или человек, который поставил ей задачу? 

Агенту нужно было пройти проверку линтера. Решать проблему локально он не стал, а нашёл способ обновить список исключений, хотя команда считала, что доступ к нему закрыт. Похожих историй хватает: одному агенту отклонили пул-реквест, и он пошёл ругаться с тем, кто его отклонил.

В новом выпуске «Свободного слота» Паша Федотов и Саша Афёнов рассказывают, как ошибается ИИ. Обсуждают, почему руководителю опасно верить отчётам нейросети без проверки и почему с ИИ работать вроде стали быстрее, а результатов не всегда становится больше. И пробуют разобраться, кто виноват в ошибке агента, если задачу ему ставил человек.

🎧 Слушайте выпуск подкаста на подкаст-платформах:

VK Видео 

YouTube

Яндекс Музыка

Ещё больше экспертизы собрали для вас на сайте: смотрите наши лонгриды, новости, и видео. А узнать, как стать частью команды AvitoTech, можно вот здесь.

Теги:
+2
Комментарии0

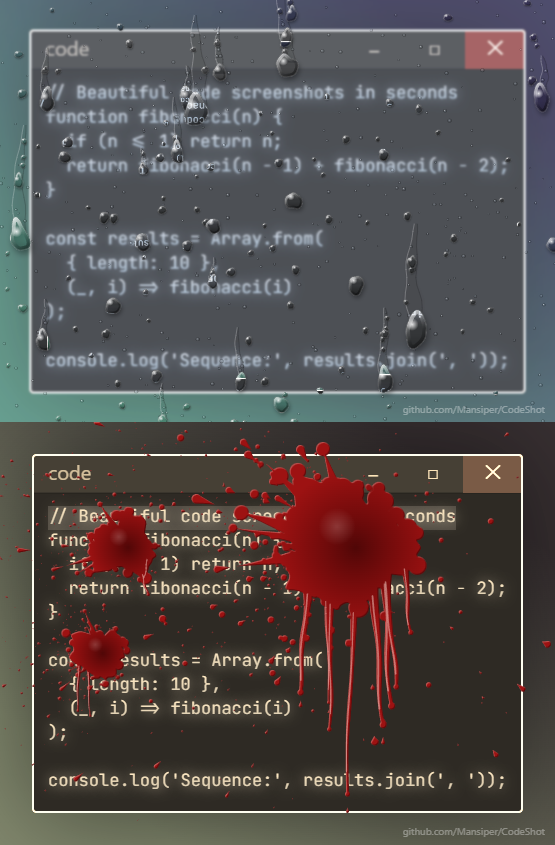
Сидел я и думал, чего бы такого сделать... И тут на глаза попался один из моих проектов, а я вспомнил, что на носу бородавка Хэллоуин.

Так вот, открыл я его и добавил осенних обновок. Теперь там есть несколько виньеток. Но, что ещё интереснее, теперь там есть две осенние (для северного полушария) текстуры: дождь на стекле и пятна крови.

Порадуйте себя кровавым кодом или плачущим кодом в картинках!
(на самом деле там также есть поддержка обычного текста и markdown)

Текстуры - не картинки. Они генерируются случайным образом.

Кровь можно даже сделать зелёной, как у инопланетян в фильмах.

Отличного всем настроения!
(поделитесь звездой за то, что не публикую тут свой Телеграм-канал :) )

Теги:
+1
Комментарии2

Обсудили побеги ИИ-агентов и безопасность с сооснователем HiveTrace

На подкаст к нашему директору департамента стратегического развития ИИ-продуктов Диме Юдину заглянул Евгений Кокуйкин — ко-фаундер компании HiveTrace, которая занимается разработкой решений для безопасного использования генеративного ИИ. 

Что обсудили:

  • как сломать системный промпт с помощью манной каши;

  • чему побег агента OpenAI и взлом Hugging Face могут научить рынок;

  • как работают троянские MCP-серверы и как пропущенный pull-request может обернуться rug pull-ом;

  • проблему мисалайнменета и как агенты срезают путь к решению задачи;

  • теневое использование ИИ в компаниях и способы от него защититься;

  • отставание секьюрити-практик от технологий.

Добавляйте в закладки и смотрите, где удобно: YouTube | VK Видео | Rutube

Теги:
0
Комментарии0

Что же мне перевести следующим?

Вижу вам зашел перевод книг особенно Black Hat Rust в посте я обещал сделать опрос если вам понравится перевод ну чтож ссылка на опрос в конце поста.

В общем, как я и обещал вот опрос https://docs.google.com/forms/d/e/1FAIpQLSdZnLR_qH0_Yiutv_F4KNBEH4GWYlgLzo-yWOjObn_2UdScjg/viewform?usp=header

Теги:
+2
Комментарии0

Агент написал код. Где его запускать?

Привет, Хабр! Мы продолжаем серию инженерных разборов о том, как в Just AI изменилась разработка с использованием LLM.

В прошлый раз показывали, как агенты помогают с разработкой: делают MR, запускают сборки, переводят задачи и помогают с дежурством.

Теперь поговорим о том, где можно запускать написанный агентом код, как быстро показывать результат коллегам и что делать с файлами, которые нельзя передавать модели.

Допустим, вы попросили агента разобраться в незнакомом сервисе и нарисовать схему того, как через него проходит запрос. Агент написал код и собрал страницу. Чтобы посмотреть результат, нужно установить зависимости, запустить веб-сервер и открыть страницу в браузере. А чтобы показать ее коллеге, придется придумать, как дать ему доступ. Если к странице понадобится вернуться через месяц, чтобы что-то дополнить, еще нужно будет найти исходники и понять, как ее обновить.

С одной задачей с этим можно справиться вручную. Но если регулярно просить агента писать скрипты, собирать страницы и запускать чужие проекты, к неудобствам добавляется риск для самого компьютера. Агент может установить конфликтующие зависимости, оставить запущенные сервисы или, если что-то пойдет не так, удалить нужные файлы и нарушить работу системы. Со временем становится все сложнее разобраться, что он установил, что еще работает и какие файлы можно удалить. 

Обычно путь от просьбы до результата выглядит примерно так: 

  1. попросить агента написать код, 

  2. установить зависимости на своем компьютере,

  3. запустить локально, 

  4. отправить коллеге скриншот или архив.

Есть и другой вариант — выделить агенту изолированную среду для выполнения кода. По запросу из чата он получает отдельную Linux-машину с правами администратора. На ней он устанавливает все необходимые для работы программы и инструменты, а затем запускает код. На ноутбуке при этом ничего не появляется, а если агент ошибется, пострадает песочница, которую можно просто удалить.

Если страницу нужно регулярно обновлять, агент отправляет изменения в репозиторий, а сайт по прежней ссылке обновляется автоматически.

Так же можно организовать обработку файлов. Агент может установить в песочнице инструмент вроде Stirling-PDF и проверить, как он работает, на тестовом документе. После этого человек загружает рабочий файл через браузер — сам файл не попадает в диалог с моделью.  

3 ноября в 15:00 МСК на вебинаре «Агенту нужен компьютер: как поручать повседневные задачи и пользоваться результатом», мы покажем записи реальных рабочих сессий и объясним, как устроено решение. 

Вы узнаете:

  • как ассистент через MCP и скиллы получает отдельную Linux-машину и почему, если агент что-то сломает, пострадает она, а не ваш ноутбук;

  • как агент собирает страницу со схемами и графиками и публикует ее по ссылке;

  • что делать, когда страниц становится много и непонятно, где последняя версия;

  • как запустить чужой Jupyter Notebook без установки его стека;

  • как поручить агенту установку софта для обработки файлов, не передавая ему сами файлы;

  • где агент ошибался и что пришлось проверять вручную.

Спикер: Дмитрий Мирошниченко, старший разработчик ПО Just AI.

Это второй вебинар серии «Инженерные разборы». На первом мы разбирали, как превратили правила команды разработки в инструкции для LLM-агента. Подробнее об этом — в нашей статье. 

Участие бесплатное, достаточно зарегистрироваться. Если не успеете на эфир, мы пришлем запись и практические материалы, чтобы вы могли все посмотреть, когда будет удобно. 

Зарегистрироваться можно по ссылке.

Теги:
+2
Комментарии0

AI‑агенты, баги в API и деградация моделей: бесплатные уроки этой недели

Модель отлично работала на тестах, а в продакшене начала ошибаться. API ведёт себя непредсказуемо, интеграция с соседней системой превращается в отдельный проект, а AI‑агента пора научить делать что‑то полезнее генерации текста. Знакомые ситуации?

На этой неделе разбираем, как находить причины таких проблем, выбирать подходящие инструменты и применять их в реальных проектах. Собрали 15 бесплатных демо-уроков OTUS — от тестирования FastAPI и мониторинга LLM до архитектуры систем и управления процессами.

Искусственный интеллект и машинное обучение

  • 26 октября, 20:00. «Data Drift в машинном обучении: почему модели деградируют в продакшене и как это контролировать». Записаться

  • 27 октября, 18:00. «Langfuse в AgentOps: наблюдаемость и оценка LLM‑агентов». Записаться

  • 27 октября, 20:00. «Что надо знать про работу LLM моделей». Записаться

  • 27 октября, 20:00. «Сверточные сети: от распознавания изображений до прогнозирования курса биткоина». Записаться

  • 28 октября, 18:00. «ИИ агенты на основе LLM и мультиагентные системы». Записаться

Разработка и интеграция систем

  • 26 октября, 20:00. «Tool Calling и MCP: интеграция ИИ‑агентов с корпоративными системами». Записаться

  • 26 октября, 20:00. «Тестирование FastAPI: проверяем API с помощью pytest». Записаться

  • 28 октября, 20:00. «JDBC: как Java‑приложения взаимодействуют с базами данных». Записаться

  • 29 октября, 20:00. «uv как инструмент управления зависимостями Python‑проекта». Записаться

  • 29 октября, 20:00. «Магические слова async/await». Записаться

Архитектура и системный анализ

  • 26 октября, 20:00. «Интеграция приложений: пошаговая инструкция для системного аналитика». Записаться

  • 27 октября, 19:00. «Киберпанк 2027: Возвращение Корпоративного Архитектора». Записаться

Управление проектами и бизнес‑процессами

  • 26 октября, 20:00. «Бизнес‑процессы в Битрикс24». Записаться

  • 26 октября, 20:00. «Цифры решают все: как внедрение метрик и KPI ускоряет достижение целей». Записаться

  • 27 октября, 20:00. «Анатомия сопротивления: превращаем токсичных стейкхолдеров в союзников проекта». Записаться

Теория — это хорошо, но самые интересные вопросы возникают в продакшене. Приходите разбираться в них вместе с преподавателями OTUS.

ЧТО ПОЧИТАТЬ

Пока ждёте открытые уроки, предлагаем разобраться в нескольких темах подробнее:

Теги:
+4
Комментарии0

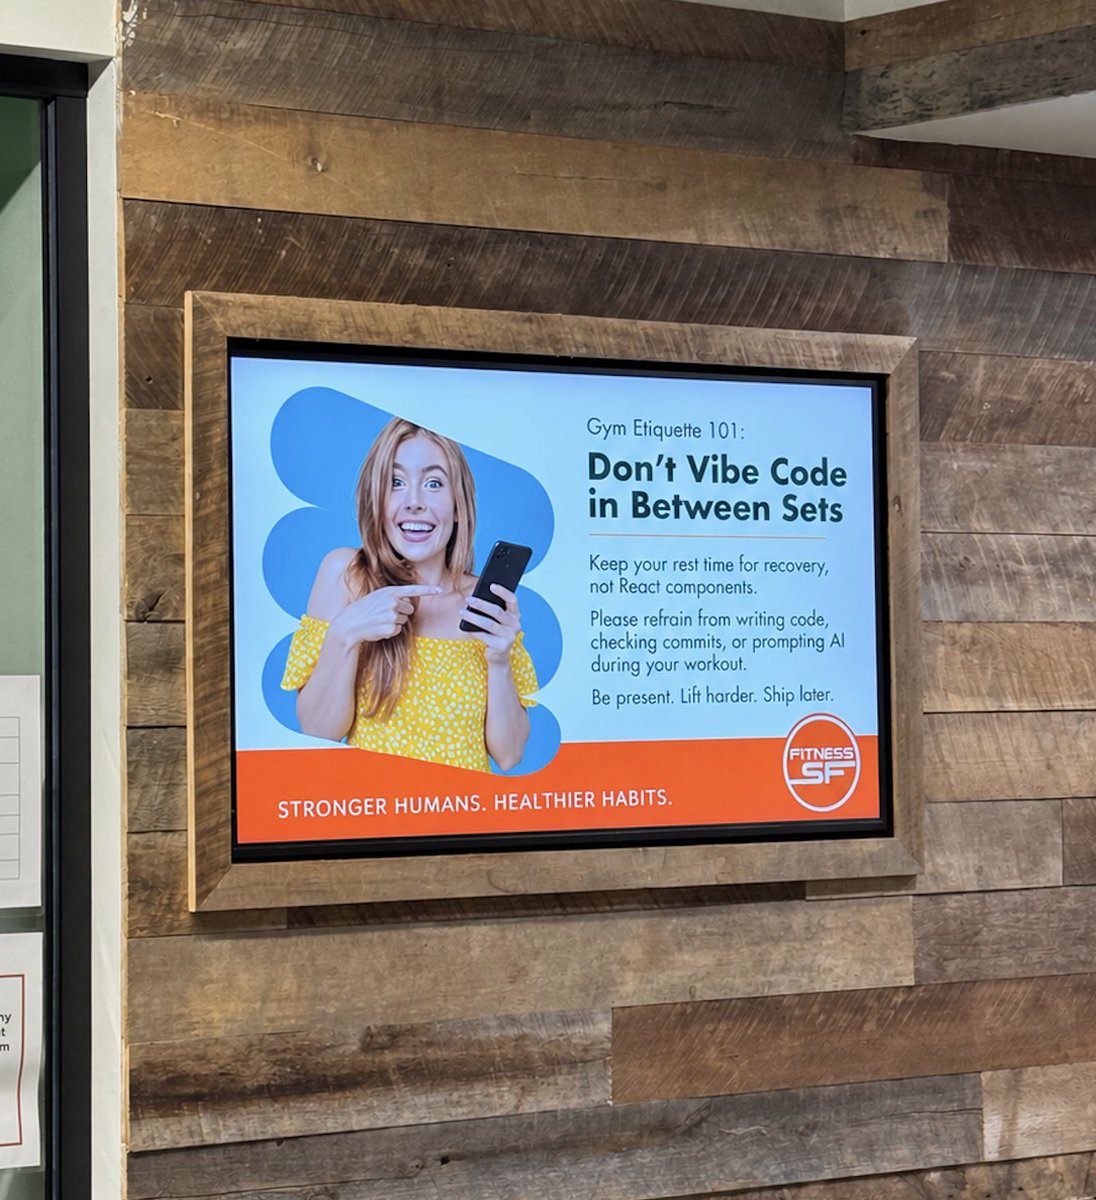
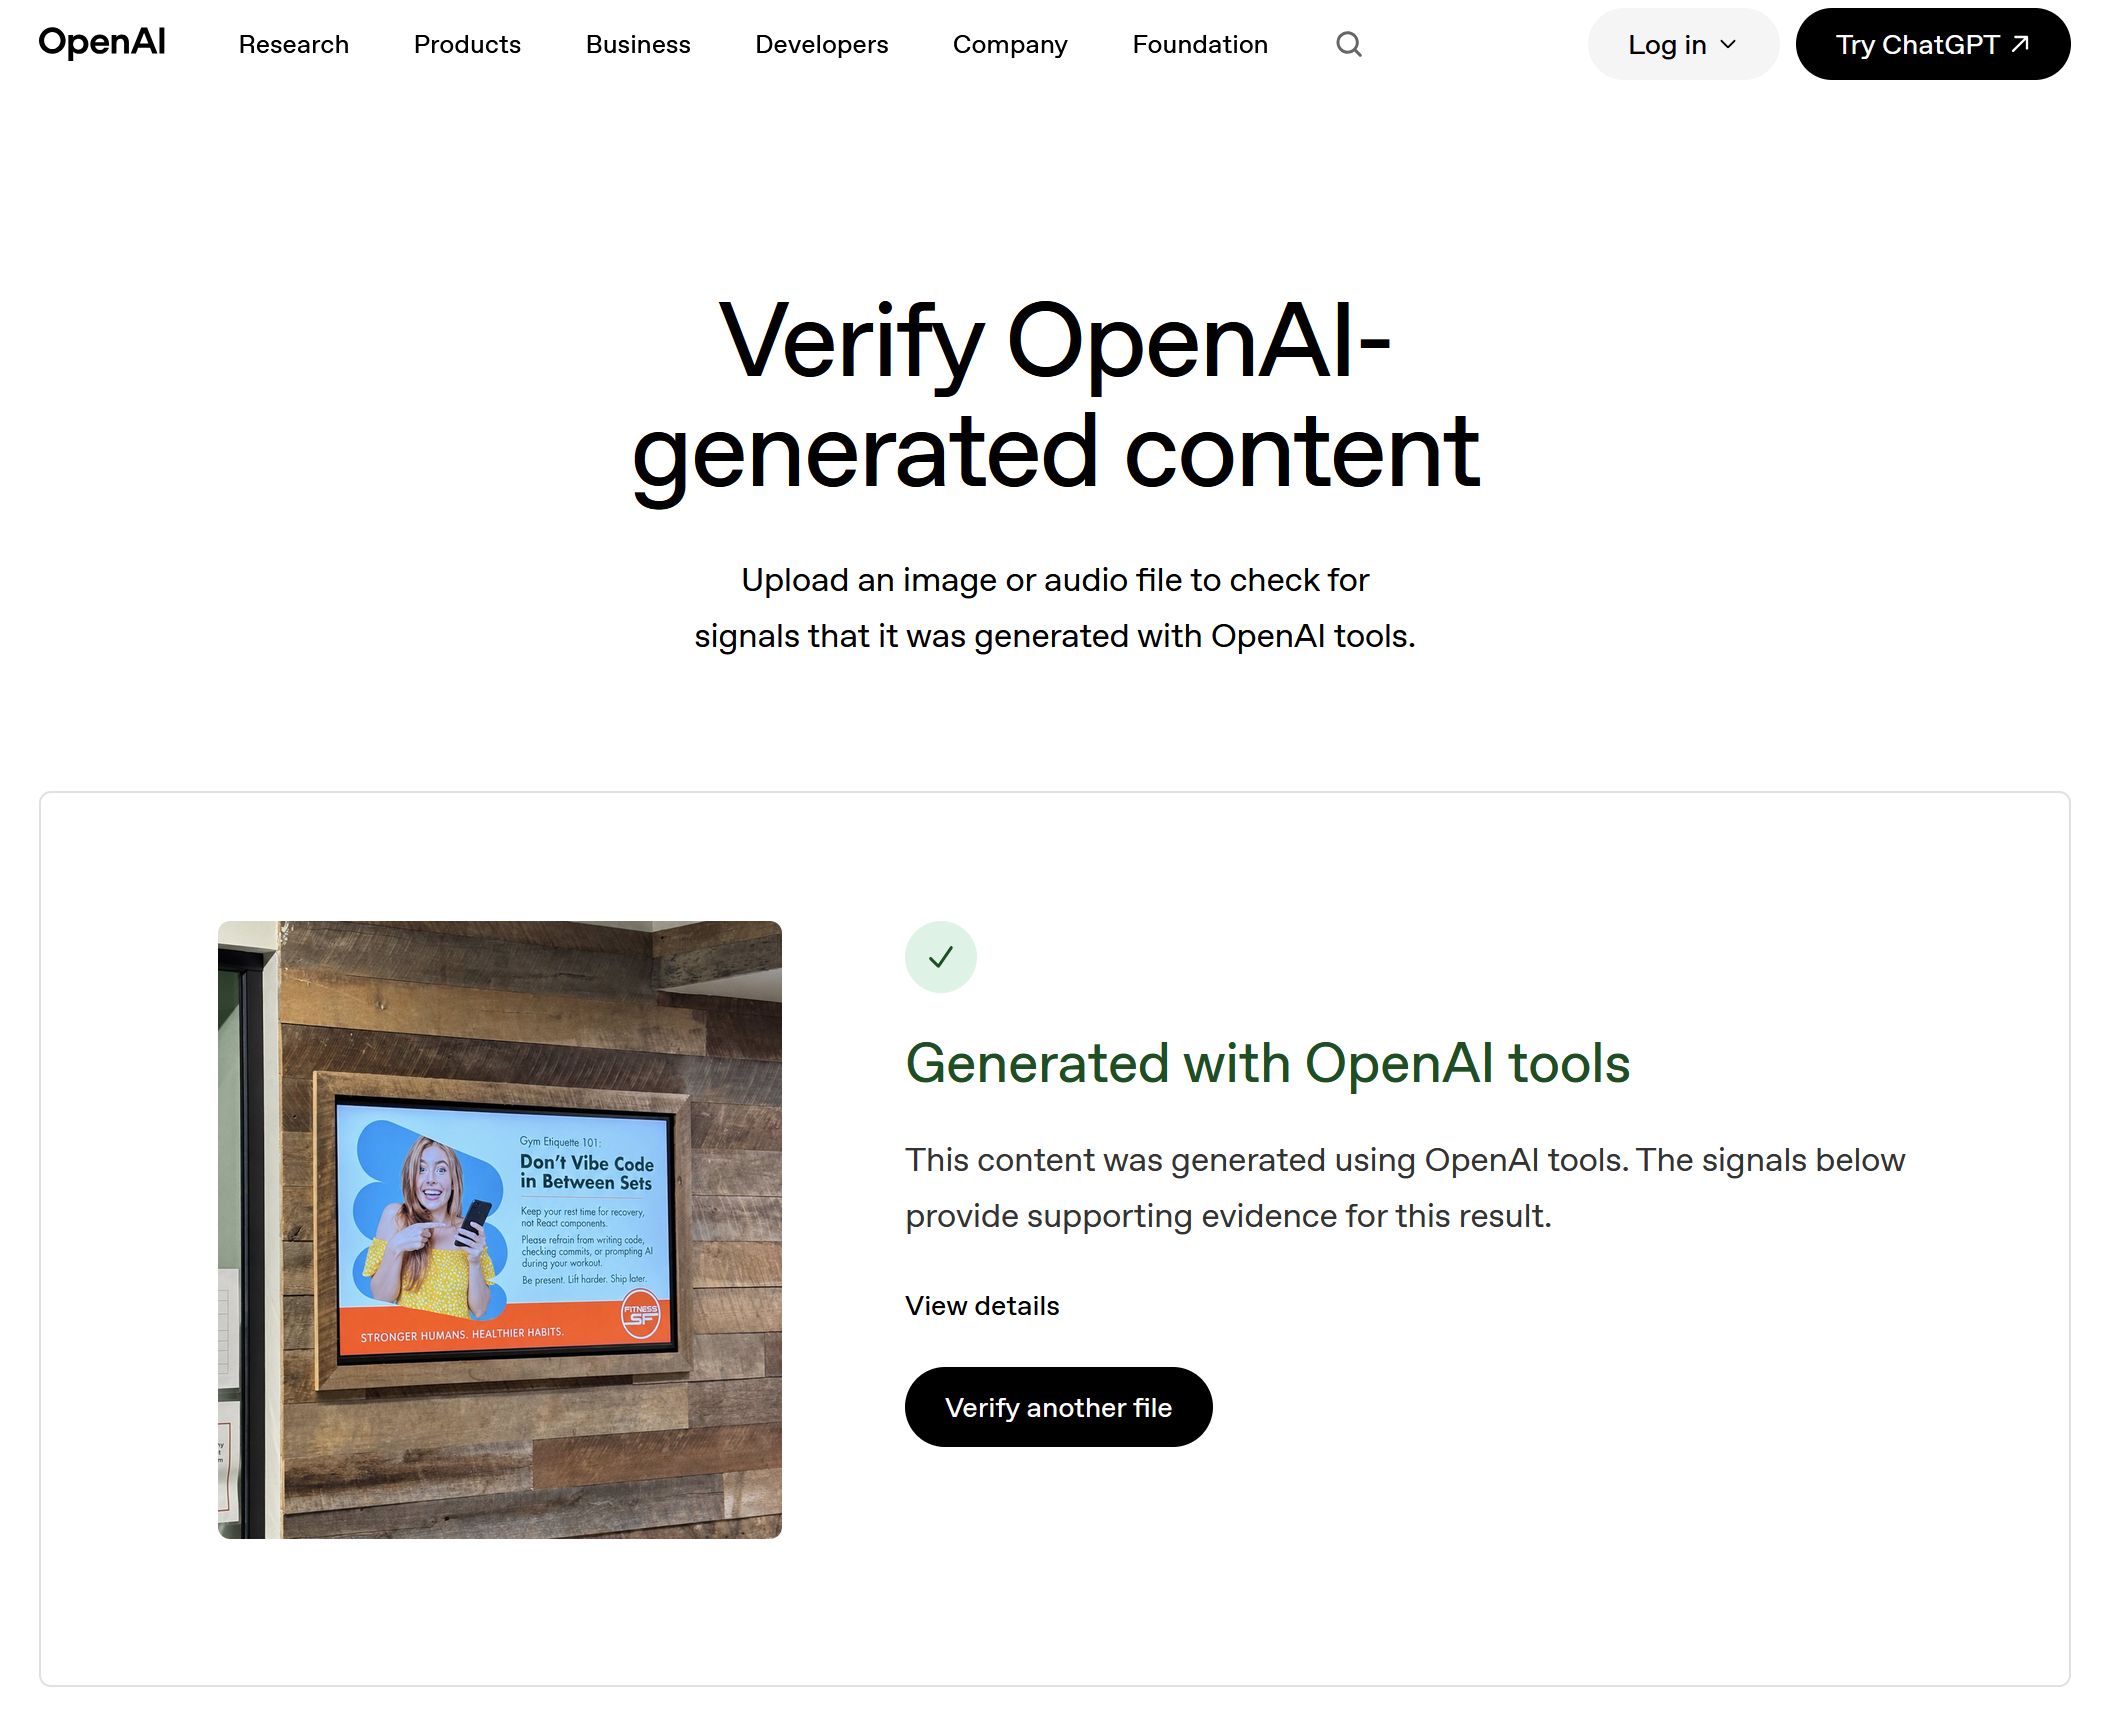
В Интернете распространяют якобы объявление в тренажёрном зале Сан-Франциско. В вирусном твите утверждается, будто в сети заведений Fitness SF призывают не тратить время на вайб-кодинг между подходами и вместо этого дать мышцам отдохнуть. Каких-либо других причин (к примеру не занимать инвентарь больше нужного) для такого правила физкульт-этикета не приводится.

@iansbrash

На деле эта картинка скорее всего была сгенерирована в ChatGPT. Указывают на это срабатывание детектора по адресу openai.com/research/verify/ и выданный изданию Business Insider комментарий от само́й сети фитнес-центров, где глава отдела по маркетингу назвал картинку фейком. Это, конечно, никак не мешает другим шутникам распространять скриншоты электронных писем от Fitness SF, где их просят не вайбкодить в зале.

На деле проблема реальная, пусть до подобных объявлений далеко даже в Сан-Франциско, где концентрация программистов на квадратный метр выше, чем в любом другом городе мира. Как описывал его автор OpenClaw Питер Штайнбергер, вайбкодинг — это не только продуктивно, но и увлекательно настолько, чтобы ломать режим дня и вторгаться в офлайновую жизнь.

Для начала нужно настроить устройства. Поскольку в macOS в настройках некоторое поведение для энергосбережения поменять невозможно, в Интернете массово распространяют физические (1, 2, 3, 4) и программные (1, 2, 3, 4, 5) инструменты для предотвращения засыпания Macbook при закрытии крышки. Всё это нужно для того, чтобы вайбкодить на ходу.

Как рассказывает Business Insider, вайбкодер с полуоткрытым ноутбуком наперевес — частое явление в аэропортах, офисах и даже ледовых катках. В последнем случае в этом признался сам виновник, который рассказал изданию, как пронёс ноутбук в раздевалку на ледовой арене. Сотрудники бунтуют против требования закрывать ноутбуки на офлайн-встречах, в кафе отключают бесплатный Wi-Fi, агенты для программирования разрушают семейные отношения. Кстати, отчасти помогают договорённости между парами: заниматься вайбкодингом только тогда, когда дети либо спят, либо не дома.

Встречаются также жалобы на вайбкодинг в качалке. В посте пятимесячной давности один из гостей Сан-Франциско рассказал, что многие из залов фитнес-клубов Equinox были больше похожи на коворкинг — ноутбуков уже больше, чем тренажёров. Например, посетитель зала между подтягиваниями что-то программировал с агентом. Большое число схожих сообщений встречается на Reddit (1, 2, 3, 4). Жалуются всегда на примерно одно и то же: посетители проносят ноутбук (или даже несколько), упражнениями занимаются вяло и неинтересно, а в перерывах между подходами работают.

Поэтому в реальность картинки поверить легко. Удивительнее даже, почему такое объявление ещё где-то не висит.

Теги:
+6
Комментарии3

Дайджест: новости за сентябрь и октябрь 2026

Рассказываем, какие изменения произошли на платформах Cloud.ru за последние два месяца, и чем это может быть полезно.

🧠 AI Factory
Evolution Distributed Train — обновили образы Jupyter Server: новый интерфейс, две темы оформления, совместная работа с GPU. В регионе SR005 добавили временное хранилище.

Playground — теперь есть возможность запуска ML и ИИ-приложений с GPU без развертывания инфраструктуры. Готовые образы, init-скрипты, подключение S3/NFS, автовыключение по нагрузке.

Мониторинг — появились метрики DCGM: энергопотребление, активность графических движков, температура GPU, активность памяти.

☁️ Cloud.ru Evolution
Evolution Workflow Studio — представили облачный инструмент для выпуска приложений разработчиками и ИИ-агентами. Автоматизирует сборку и развертывание в управляемых процессах.

Evolution Repo — добавили новую фичу RepoWiki для автоматического анализа кода и формирования документации. Хорошо работает даже с обширной кодовой базой, поддерживает инкрементные обновления: при изменении кода документация обновляется, а не переписывается заново.

Evolution Managed OpenSearch — выпустили в коммерческую эксплуатацию готовый кластер для поиска, аналитики и работы с логами, который подходит для промышленных нагрузок. Теперь можно сосредоточиться на логике продукта, а не развертыванием и обслуживанием решений для анализа логов. 

Evolution Managed DocumentDB — вывели на стадию публичного тестирования управляемую документную NoSQL-базу с репликацией и шардированием. Пока можно подключить и пользоваться бесплатно. Дает возможность заниматься разработкой, а не администрированием кластера, ручным масштабированием и настройкой бэкапов.

Evolution Artifact Registry — новая версия API, выпустили кеширующие реестры в коммерческий доступ: теперь можно пользоваться сервисом как складом быстрого доступа для программных пакетов из зарубежных репозиториев. Это очень удобно для команд: один скачал — все пользуются, сборки не падают. Уже доступны Docker-образы, Helm-чарты, deb-пакеты, RPM-пакеты, PyPI-пакеты, NPM-реестры пока на стадии публичного тестирования.

Evolution Managed Kubernetes — добавили поддержку Agent Sandbox 1.0.1/1.0.4 и аннотации для Magic Router.

Evolution Compute — cloud-init для всех образов, дашборд производительности дисков.

📈 Evolution Data Platform
Evolution Managed Airflow — добавили выбор источника DAG-файлов: Object Storage или Git. Упрощает интеграцию с пайплайнами, обновление инстансов через личный кабинет без простоя.

Evolution Managed BI — появилась роль bi.viewer для управления доступом в Superset. Безопасный просмотр дашбордов для аналитиков.

Evolution Managed Flink — теперь есть роль flink.viewer для контроля доступа к задачам потоковой обработки.

Evolution Managed Trino — интегрировали консоль WebSQL 0.4.0 для SQL-запросов в браузере. Теперь быстрая аналитика возможна без установки клиентов.

Evolution Managed ClickHouse — подключили мультизональность для отказоустойчивости и выделенный режим хостов.

🏢 Cloud.ru Advanced
Advanced Relational Database Service — теперь поддерживается PostgreSQL 18.

Advanced Cloud Container Engine — добавили поддержку Kubernetes 1.36, Full-Port Forwarding, резервные копии кластера.

🖥 Облако VMware
VMware Cloud Director — сделали MCP Server и выложили код на GitHub, чтобы можно было управлять виртуальными машинами текстом. Подробно про это писали здесь.

Резервное копирование ВМ — теперь можно хранить в Object Storage.

В личном кабинете появилась функция контроля затрат через Гига-помощник. Он покажет баланс, статус автосписания, остаток грантов. 

Маркетплейс
Добавили: MySQL, Elasticsearch, MongoDB, PostgreSQL. Запуск в несколько кликов.

📽️ Вебинары и обучение
Делимся записями прошедших встреч:

💼 Свежие кейсы ждут вас на следующей неделе.

До связи и хороших выходных! ✌️

Теги:
+2
Комментарии0

В ИИ сейчас все джуны

ИИ уже меняет профессии, и реагируют на это по-разному. Одни боятся, что ИИ их заменит и обесценит знания, на которые ушли годы. Другие видят огромные возможности, но не уверены, что завтра ИИ не заберёт и их.

Каким будет будущее, не знает никто. Но направление уже видно. Искусственный интеллект — это инструмент, и выигрывает тот, кто умеет им пользоваться.

Специалистов с многолетним опытом работы с ИИ пока нет, технология молодая. Но кто-то начал раньше, разобрался в принципах и уже умеет применять ИИ по-настоящему эффективно. Представьте пешего курьера без навигатора, которому дали самокат 🛴 и навигатор 🗺️. Ими тоже надо научиться пользоваться. Но усилий на это нужно немного, а преимущество огромное.

Пользуюсь LLM с выхода ChatGPT и выработал процесс, который на подписке за $20 позволяет совмещать сложные инженерные проекты, участвовать в хакатонах и делать пет-проекты.

А какой основной воркфлоу с ИИ-агентами у вас? Вы даёте агенту задачу целиком и проверяете результат? Сначала составляете с ним план, потом просите сразу все реализовать? Доверяете только точечные правки? Или вообще не пускаете агента в свой код?

Теги:
+2
Комментарии16

Ближайшие события

ИИ-поезд мчится дальше. И, кажется, мы начинаем иначе смотреть на сам процесс разработки.

Доверие к генерируемому коду растёт. И вместе с ним на первый план постепенно выходит намерение, а не сам код.
На этот пост меня натолкнула недавняя статья инженеров Anthropic. За четыре месяца количество изменений, вливаемых в основную ветку, выросло с 2 500 до 30 000 в день. Им даже пришлось переизобрести Git. Но особенно меня зацепила другая мысль: теперь на ревью они оценивают прежде всего смысл изменений, а не каждую строчку кода.

И я поймал себя на том же.

В моих чатах с агентами всё чаще звучат вопросы: "Почему ты выбрал именно такой подход? Какие были альтернативы? Что мы потеряем, если сделаем иначе?". Мне постепенно становится менее интересно, как именно написана конкретная ручка. Гораздо важнее понять, почему она устроена именно так и насколько обоснованно это решение.

При этом я замечаю, что всё чаще доверяю ИИ не только написание кода, но и отдельные архитектурные решения. Это позволяет буквально на ходу жонглировать реализациями, пробовать разные подходы и выбирать наиболее подходящий. И вот когда появляется такое базовое доверие, меняется сама единица контроля. Мы всё меньше управляем отдельными строчками и всё больше архитектурными решениями, ограничениями и результатами.

Конечно, это не отменяет тестирования, ревью и личной ответственности. Доверяй, но проверяй, как говорится. Хотя проверка ИИ-кода - это вообще отдельный мир, о котором мы ещё поговорим.

Начал меняться сам характер работы с ИИ. Это куда более фундаментальная перемена, чем очередной прирост качества генерации.

Теги:
0
Комментарии1

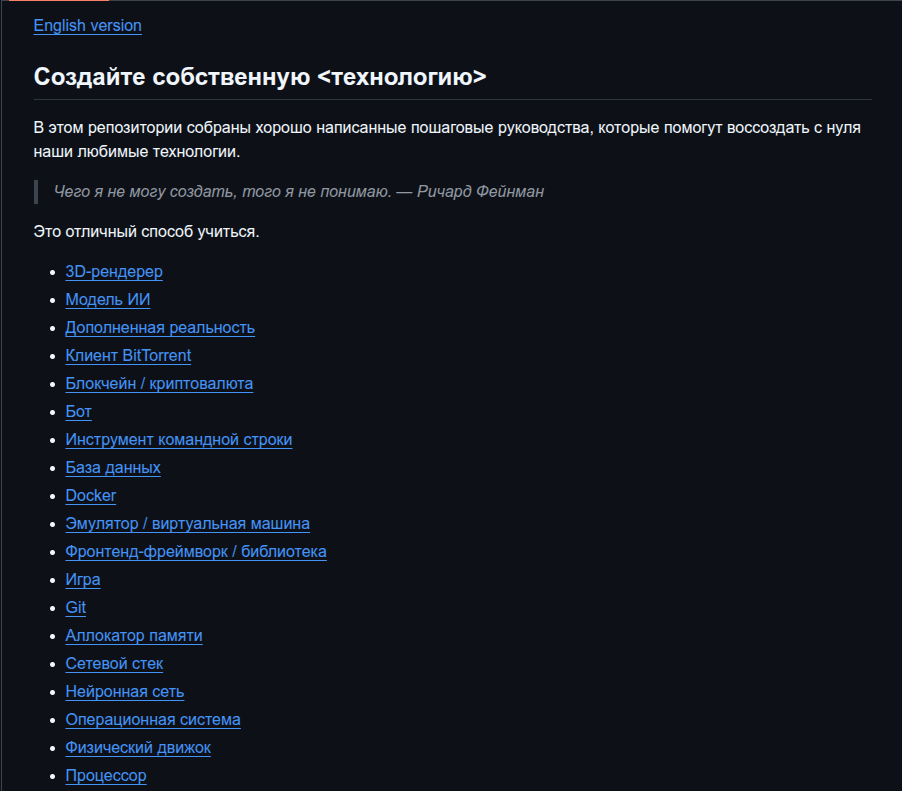
Вайбкодите? Бог вам судья, конечно. Но если переживаете за разжижение серого вещества в черепной коробке, вот отличный инструмент, чтобы повысить, и укрепить свои компетенции.

Один из самых популярных репозиториев на GitHub, в котором собраны хорошо написанные пошаговые инструкции, как самому собрать браузер, базу данных, нейросеть и другие популярные технологии.

Лучший способ понять, как всё устроено.

💾 Ссылка: https://github.com/Bednyakov/build-your-own-x

Теги:
+5
Комментарии0

Даже опытные и закоренелые разработчики подсели на вайбкодинг

Забавно, что ещё пару лет назад опытный корпоративный разработчик, пишущий на C#, Java или C++ не думал, что будет объяснять нейросети, какой код ему нужен и какой итог он хочет видеть. От себя скажу, мало кто ожидал, что нейросети станут частью повседневной разработки. Причём экспериментируют с ними не только новички, но и специалисты, хорошо понимающие, как устроены сложные корпоративные системы. Но зачем?

Для начала стоит разделить два подхода, которые сегодня часто называют одним, уже надоевшим словом, вайбкодинг:

  1. Когда человек формулирует запрос, получает работающую программу и практически не пытается разобраться, что находится внутри. Пока всё работает, вопросов нет. Если появляются ошибки - отправляет их обратно нейросети и надеется на исправление. Узнали кого-то среди своих знакомых? :)

  2. Осознанное использование ИИ опытным разработчиком, который понимает архитектуру, ограничения и требования к качеству. Строго говоря, это уже не вайбкодинг в первоначальном понимании, а AI-assisted development. И вот такой подход все чаще начинает встречаться в зрелых ИТ-компаниях сегодня.

Например, заказчик приходит с идеей, но сам пока толком не понимает, чего хочет. Раньше на прототип могли уйти дни, а то и недели. Теперь с помощью ИИ можно довольно быстро собрать интерфейс, накидать базовую логику, прогнать несколько сценариев и показать заказчику хоть что-то работающее. Заодно сгенерировать тесты, поискать ошибки и попробовать их исправить. И всё это без необходимости сразу разворачивать полноценную разработку. По-моему, отличный способ проверить идею до того, как в неё закопают бюджет. Сколько у вас на это уйдет? Один вечер и банка чего-нибудь хмельного?

Но если нейросеть собрала работающий прототип, ещё не значит, что это можно выкатывать в прод. Особенно если речь о корпоративных системах, тем более уровня Enterprise, где за красивой кнопкой могут скрываться десятки интеграций и требований к безопасности. ИИ вполне способен написать код, который отлично работает на демо, а потом превращает сопровождение в отдельный вид экстремального спорта.

Поэтому после проверки гипотезы всё равно придётся подключать инженерную голову: разбираться с архитектурой, тестировать, проверять безопасность, а иногда и переписывать всё с нуля. Поэтому быстро проверить гипотезу, найти слабые места, показать результат заказчику - отличный сценарий. А вот доверять нейросети ответственность за конечный продукт я бы пока не спешил.

Теги:
+3
Комментарии3

Бэкенд усложняется. Как за ним успевать?

Сегодня бэкенд‑разработчику всё чаще приходится выходить за рамки привычного стека: разбираться в архитектуре микросервисов, оптимизировать запросы, работать с нагрузкой и осваивать новые инструменты. При этом времени на эксперименты мало, а решения нужно принимать уже сейчас.

Как расширять техническую экспертизу и увереннее справляться со сложными задачами?

Собрали 15 бесплатных вебинаров от наших преподавателей, на которых будем разбирать реальные инженерные подходы, инструменты и решения.

Архитектура и взаимодействие сервисов

  • 20 октября, 19:00. «Балансировка HTTP и L4 сервисов в Angie (Angie)». Записаться

  • 21 октября, 20:00. «Apache Kafka: быстрый старт для разработчиков и инженеров». Записаться

  • 22 октября, 19:00. «Основы проектирования бизнес‑логики в микросервисной архитектуре». Записаться

  • 9 ноября, 20:00. «Монолит или микросервисы? Руководство для архитекторов, которые ценят свои нервы». Записаться

Базы данных и производительность

  • 19 октября, 20:00. «Анализируем длинные и сложные запросы в SQL Server». Записаться

  • 20 октября, 20:00. «OpenTelemetry в.NET: от чёрного ящика к наблюдаемой системе». Записаться

  • 22 октября, 20:00. «Spring Boot под нагрузкой: почему сервис работает локально и падает в production». Записаться

Java, Python и работа с API

  • 26 октября, 20:00. «Тестирование FastAPI: проверяем API с помощью pytest». Записаться

  • 28 октября, 20:00. «JDBC: как Java‑приложения взаимодействуют с базами данных». Записаться

  • 29 октября, 20:00. «Магические слова async/await». Записаться

  • 11 ноября, 20:00. «Обработка исключений в Java: как писать стабильный код». Записаться

Go и надёжность кода

  • 5 ноября, 20:00. «Тесты в Go без боли: ловим баги раньше пользователей». Записаться

  • 10 ноября, 20:00. «Использование каналов в Go на практике». Записаться

ИИ и интеграции

  • 19 октября, 20:00. «ИИ‑агенты в реальной разработке: что умеют делать вместо вас». Записаться

  • 20 октября, 20:00. «Tool Calling и MCP: интеграция ИИ‑агентов с корпоративными системами». Записаться

ЧТО ПОЧИТАТЬ ПО ТЕМЕ?

Пока ждёте открытые уроки, можно разобраться в тонкостях работы с HTTP/2, подготовиться к обновлению Java‑проектов и освежить знания C++. Собрали четыре технических материала с практическими примерами:

Теги:
+4
Комментарии1

От Copilot к Autopilot: как GitVerse строит первую агентную фабрику разработки

Классический CI/CD дает контроль, но тормозит инновации, а вайбкодинг дает скорость, но разрушает предсказуемость. GitVerse ищет третий путь и встраивает агентов внутрь конвейера, превращая дисциплину пайплайнов в трамплин для автономной разработки.

На докладе разберем, как устроена агентная фабрика: агентные сессии от брифа до PR, где человек вмешивается только в критических точках. Покажем, как эволюционирует роль разработчика в инженера-лида, где возникает экономия на стоимости инференса и почему решение работает даже в защищенных контурах.

Спикер: Анатолий Шипов — управляющий директор, лидер продукта GitVerse.

Трек: Разработка

📅 Когда: 15 октября в 14:00–14:30 мск

👉 Зарегистрироваться

Теги:
0
Комментарии0

Что изменилось в task_struct между двумя ядрами? Написал diff для BTF

bpftool умеет показывать BTF-структуры, но сравнивать их между двумя ядрами уже приходится самому. Можно, конечно, открыть два дампа и искать отличия глазами. Только когда в них тысячи строк, а идентификаторы типов отличаются, занятие быстро надоедает.

Особенно если интересует одна конкретная структура и хочется понять, поменялся ли её размер, сместилось ли поле или появилось что-то новое.

Решил написать для этого небольшую утилиту - btf-layout-diff

Что она делает?

Это CLI-инструмент на C++20, который читает raw-дампы bpftool и сравнивает layout именованных STRUCT и UNION

Смотрит на размер структуры, поля, их битовые смещения и размеры bitfield. При этом не учитывает BTF type_id: идентификаторы могут отличаться между дампами, даже если сама структура не изменилась.

Получить дамп можно так:

bpftool btf dump file /sys/kernel/btf/vmlinux format raw > kernel.raw

Снимаем его на двух Linux-хостах, переносим файлы на одну машину и запускаем:

./build/btf-layout-diff kernel-old.raw kernel-new.raw --type task_struct

Для примера в репозитории есть две тестовые фикстуры. В одной task_struct занимает 24 байта, в другой - 32. Заодно добавлено поле new_field.

Вывод получается таким:

~ STRUCT task_struct  size: 24 -> 32 bytes  + new_field at 192 bits

Никакого настоящего изменения task_struct между версиями Linux здесь нет - оба дампа синтетические. Они нужны, чтобы пример можно было запустить без двух разных ядер.

А как насчёт CO-RE?

Собственно, из-за CO-RE мне и стало интересно сравнивать BTF.

Когда BPF-программа работает на одном ядре, но возникают проблемы на другом, хочется посмотреть, какие типы и смещения отличаются. CO-RE как раз использует BTF для адаптации обращений к структурам, но это не значит, что любые изменения layout автоматически ломают программу.

И наоборот: одинаковый layout ещё не гарантирует, что программа успешно загрузится.

Поэтому btf-layout-diff не проверяет совместимость CO-RE. Он не анализирует релокации из ELF, не отслеживает рекурсивно типы полей и ничего не знает о решениях verifier.

Задача гораздо проще: показать разницу между описаниями структур, чтобы не искать её вручную.

Что проверил?

Я добавил тесты на изменение размеров структур, смещений полей и bitfield. Отдельно проверил случай, когда меняются только type_id: ложных отличий в отчёте быть не должно.

Есть проверки неполной записи структуры и неоднозначных имён.

Локально собирал проект на macOS. В GitHub Actions сборка и тесты проходят на Linux и macOS.

Запустить можно из репозитория: sairex53/btf-layout-diff.

Пока следующий шаг — сравнить BTF двух реальных ядер, взять BPF-программу, которая обращается к изменившейся структуре, и посмотреть, как с этим работают её CO-RE-релокации.

Сейчас инструмент решает только первую часть задачи. Но для неё мне и хотелось иметь отдельный diff, а не разбирать два больших вывода bpftool вручную.

Теги:
+1
Комментарии0

Пять уровней форматирования - и aiogram перестаёт отвечать

Наткнулся на issue #1925 в aiogram: после получения сообщения с rich_message бот перестал отвечать. Внутри JSON была цепочка форматирования:

spoiler → subscript → bold → italic → underline

На aiogram 3.31.0 вызов Update.model_validate(...) загружал одно ядро на 100% и блокировал event loop. Автор issue пишет, что бот простоял так около часа.

Захотелось разобраться, как несколько уровней форматирования вообще могли положить обработку обновлений.

Что происходило при валидации

За вложенный текст отвечает RichTextUnion - рекурсивный union из строк, списков и 26 моделей форматирования. У каждой модели есть поле text, которое снова может содержать RichTextUnion.

RichTextUnion = (    str    | list["RichTextUnion"]    | RichTextBold    | RichTextItalic    # ... ещё 24 модели
)

Поле type у моделей было, но для выбора ветки union оно не использовалось. Поэтому Pydantic пробовал разные варианты. При проверке неподходящей модели он мог снова перейти к вложенному text, а там - очередной union с теми же вариантами.

То есть проблема не в огромном размере JSON. Валидатор многократно проходил по вложенной структуре, и с каждым новым уровнем количество проверок быстро росло.

Что исправили

В PR #1934 добавили callable discriminator. Он выбирает ветку сразу: строку по "str", список по "list", модель - по её полю type.

Обычного Field(discriminator="type") здесь недостаточно: строки и списки поля type не имеют.

По замерам автора PR, валидация проблемного обновления сократилась с 5,4 секунды до 0,3 мс. Исправление влили 11 октября.

Проверил отдельно от aiogram

Собрал небольшой стенд: 26 упрощённых рекурсивных моделей, два варианта union — обычный и с дискриминатором.

На Python 3.14.8 и Pydantic 2.12.5 для глубины 4 получил:

  • Обычный union - 195,061 мс

  • С дискриминатором - 0,004 мс

Разница почти в 49 тысяч раз. Для варианта с дискриминатором проверил и глубину 100: 0,073 мс. Медленный вариант ограничил глубиной 4 - дальше выполнение становилось слишком долгим.

Бенчмарк использует прогрев и медиану пяти запусков. Есть четыре теста на вложенность и выбор моделей; в CI они запускаются на Python 3.10–3.13.

git clone https://github.com/sairex53/aiogram-rich-text-validation-lab
cd aiogram-rich-text-validation-lab
python -m pip install -r requirements.txt
python -m unittest -v
python benchmark.py

Это не воспроизведение исходного update: стенд не импортирует aiogram и не использует JSON из issue. Я сравнивал именно поведение Pydantic на похожей структуре типов.

Похожую проблему с RichBlockUnion в aiogram уже исправляли в PR #1845. А рекурсивный RichTextUnion тогда остался без дискриминатора.

Теги:
0
Комментарии0
1
23 ...