Обновить

QUBO как демонстрация разницы между математиком и инженером

QUBO (Quadratic unconstrained binary optimization) это метод поиска оптимального решения. В основе метода формулирование задачи в виде матрицы Q. Решение задачи - бинарный вектор x. Упрощено метод решения можно представить так:

xT * Q * x -> min

Суть решения задачи - определить такой бинарный вектор, при котором "энергия" минимальна. Код, который напишет математик, будет выглядеть примерно так:

int[] x = new int[size];
//...
for (int i = 0; i < size; i++)
{
    for (int j = 0; j < size; j++)
    {
        // Вычисление значения целевой функции: x^T * Q * x
        energy += x[i] * Q[i, j] * x[j];
    }
}

Это прямое выражение математической модели. Но инженер должен учесть постановку задачи (бинарный вектор) и знать, что исполнять код будет реальный компьютер с ограниченными ресурсами. А значит написать его иначе:

BitVector32 x = new();
//...			
for (var row = 0; row < size; row++)
{
    for (var column = 0; column < size; column++)
    {
        if (x[row] && x[column])
        {
            energy += Q[row, column];
        }
    }
}

Пример крайне простой, а потому наглядный. Спросите у LLM :-) В общем, математика и программирование - это не одно и то же.

Теги:
Всего голосов 1: ↑0 и ↓1-1
Комментарии4

125 токенов в секунду на RTX 4070 Ti SUPER: как я заставил локальную LLM работать полноценным кодинг-агентом

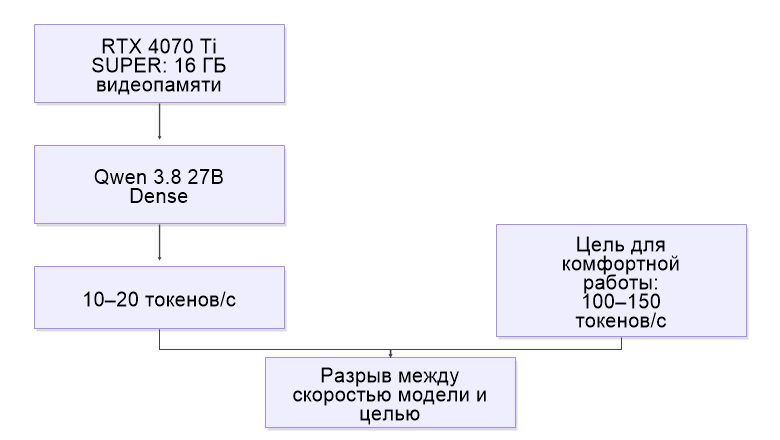
По статистике, среди рядовых пользователей настольных компов самая распространенная видеокарта имеет 16 ГБ видеопамяти. По опросам GaugeDB, такие карты занимают 27,21% рынка. У меня как раз видеокарта NVIDIA GeForce RTX 4070 Ti SUPER с 16 ГБ видеопамяти GDDR6X, которая на текущий момент стоит 900$. До сего момента главной проблемой было то, что на видеокарте такого класса невозможно было запустить LLM-агента, который будет достаточно умным и достаточно быстрым. Если запускаешь умную модель типа Qwen 3.8 27B (Dense архитектура), то на выходе получаешь 10-20 токенов в секунду. А для комфортной работы кодинг-агента надо 100-150 токенов в секунду.
125 токенов в секунду на RTX 4070 Ti SUPER: как я заставил локальную LLM работать полноценным кодинг-агентом

Публикации