Обновить

Разбираемся как принимать звонки в браузере. Основы WebRTC\SIP\RTP.

Во многих коммуникационных продуктах возникает потребность работы с голосом. В этой серии постов разберемся как организовать прием звонков непосредственно из вашего web приложения. Какие есть варианты передачи звукового потока и какая может быть архитектура backend приложения, обеспечивающего его работу.

Начнем с самой простой в реализации схемы, в которой передача голоса осуществляется напрямую между браузером пользователя, открывшего ваше web приложение и серверами провайдера "виртуальной телефонии"(aka "виртуальная атс" ).
При этом вся мета информация о поступившем входящем звонке и событиях всего жизненного цикла звонка принимает ваш backend. У разных провайдеров телефонии набор событий и строения api может отличаться, но общая схема работы схожа.

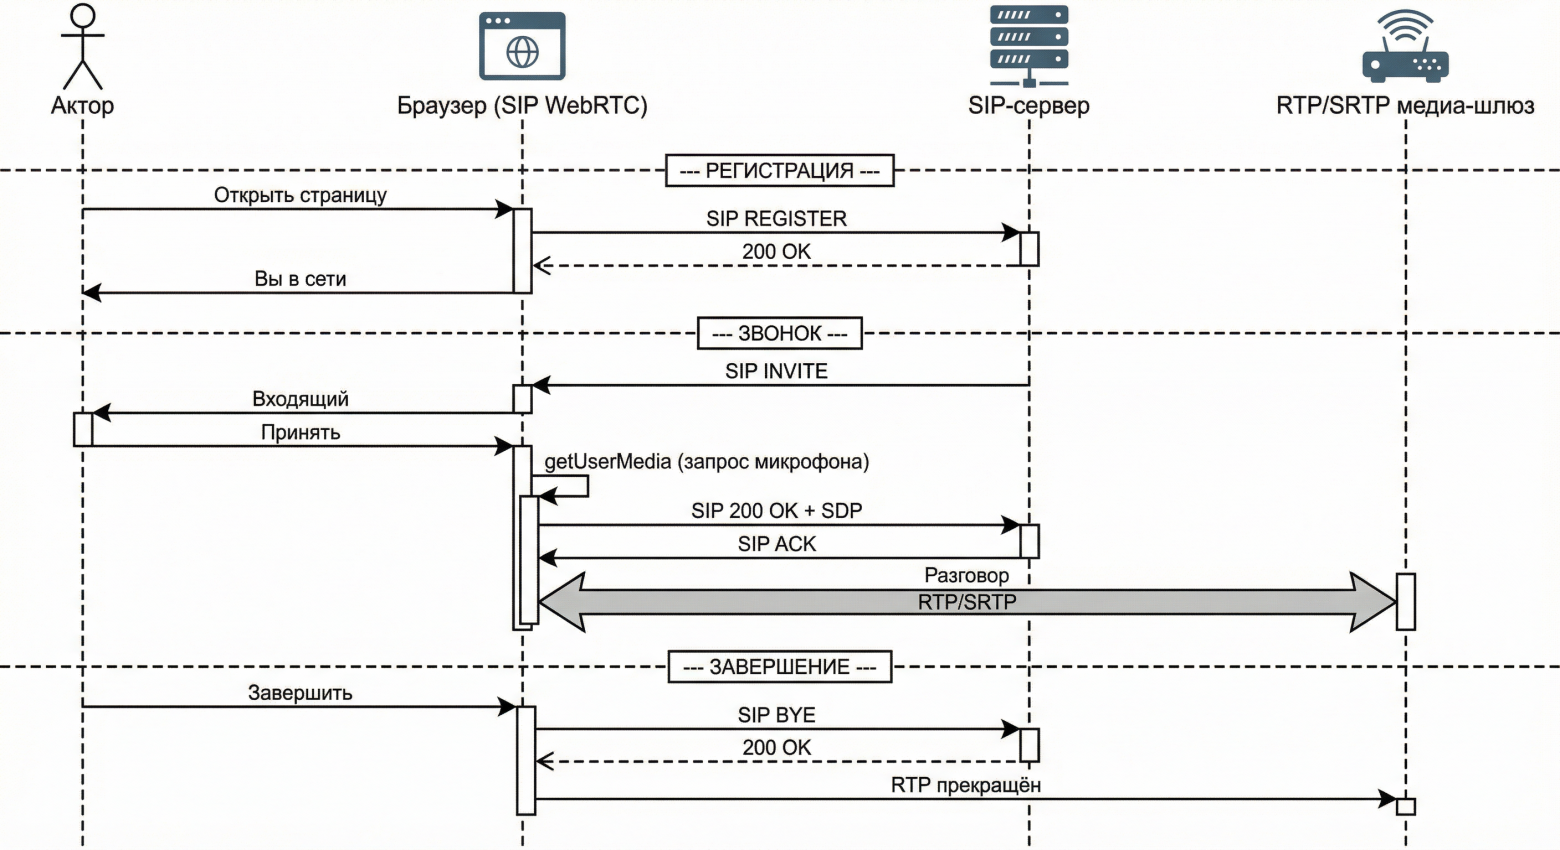
Разберем основную схему организации передачи голоса. Браузер по сути работает как SIP‑телефон: сигнализация через WebSocket, медиа — по RTP.

Упрощенно схему работы WebRTC/SIP можно разделить на "регистрацию", "звонок" и "завершение":

1. Регистрация в сети

  • Оператор открывает страницу в браузере.

  • Браузер отправляет SIP REGISTER на SIP‑сервер (WebSocket/TLS).

  • SIP‑сервер отвечает 200 OK.

  • В интерфейсе показывается «Вы в сети» — оператор готов к звонкам.

2. Звонок

  • SIP‑сервер отправляет SIP INVITE в браузер.

  • Браузер показывает уведомление «Входящий».

  • Оператор нажимает «Принять».

  • Браузер запрашивает доступ к микрофону (getUserMedia) — внутреннее действие.

  • Браузер отправляет SIP 200 OK + SDP на SIP‑сервер.

  • SIP‑сервер отправляет SIP ACK в браузер.

  • SIP‑сервер даёт команду RTP/SRTP‑шлюзу установить медиа‑сессию.

  • Медиа (RTP/SRTP по UDP) передаётся между браузером и RTP‑шлюзом.

  • Начинается разговор.

3. Завершение звонка

  • Оператор нажимает «Завершить».

  • Браузер отправляет SIP BYE на SIP‑сервер.

  • SIP‑сервер отвечает 200 OK.

  • Передача RTP/SRTP прекращается.

Если тема будет интересна, то далее обсудим схему работы backend'а и варианты развития общей схемы передачи голоса с плюсами, минусами и ограничениями.

В своем канале в Telegram и канале в Max о разработке в стартапах рассказываю еще больше интересного и делюсь опытом, заходите, буду рад!

Спокойных вам релизов и захватывающих решений !

Теги:
Всего голосов 2: ↑1 и ↓10
Комментарии0

Как мы запустили Qwen3.8–27B целиком на RTX 5060 8 GB и получили ~30 токенов/с

Наш проект называется ExVRAM Lab. Это открытая исследовательская лаборатория, в которой мы проверяем, насколько большие локальные LLM можно запускать на обычных видеокартах с ограниченным объёмом VRAM, если использовать ultra‑low‑bit quantization, полное размещение весов на GPU и существующие open‑source inference‑технологии.

ExVRAM расшифровывается как Exchange Compute for VRAM. Основная идея проекта — в ряде сценариев выгоднее потратить часть свободной вычислительной мощности GPU на работу с более компактным представлением весов, чем хранить часть модели в оперативной памяти и постоянно передавать данные через PCIe.

Когда мы начинали проект, исходный вопрос был достаточно простой: можно ли запустить dense‑модель примерно на 27 миллиардов параметров на видеокарте всего с 8 ГБ VRAM так, чтобы она не просто «запустилась», а работала полностью на GPU, поддерживала длинный контекст и обеспечивала нормальную интерактивную скорость генерации.

В качестве основной тестовой системы мы используем NVIDIA GeForce RTX 5060 8 GB на архитектуре Blackwell. Основная модель в текущих экспериментах — Qwen3.8–27B.

Сначала результат выглядел не слишком впечатляюще. Модель запускалась, но значительная часть весов оставалась в системной памяти. Около 5,7 GiB весов находилось на GPU, ещё примерно 2,5 GiB — на CPU. Скорость генерации составляла порядка 3,8–5,5 токена в секунду.

При этом сама видеокарта была загружена далеко не полностью.

Это стало одним из первых важных наблюдений проекта. Проблема заключалась не столько в нехватке вычислительной мощности RTX 5060, сколько в том, что часть decoder weights находилась в RAM. Во время autoregressive generation данные приходилось постоянно передавать между CPU и GPU через PCIe.

Как мы запустили Qwen3.8–27B целиком на RTX 5060 8 GB и получили ~30 токенов/с

Публикации