Можно ли заменить системный промпт начальным состоянием? Эксперименты на RWKV-7
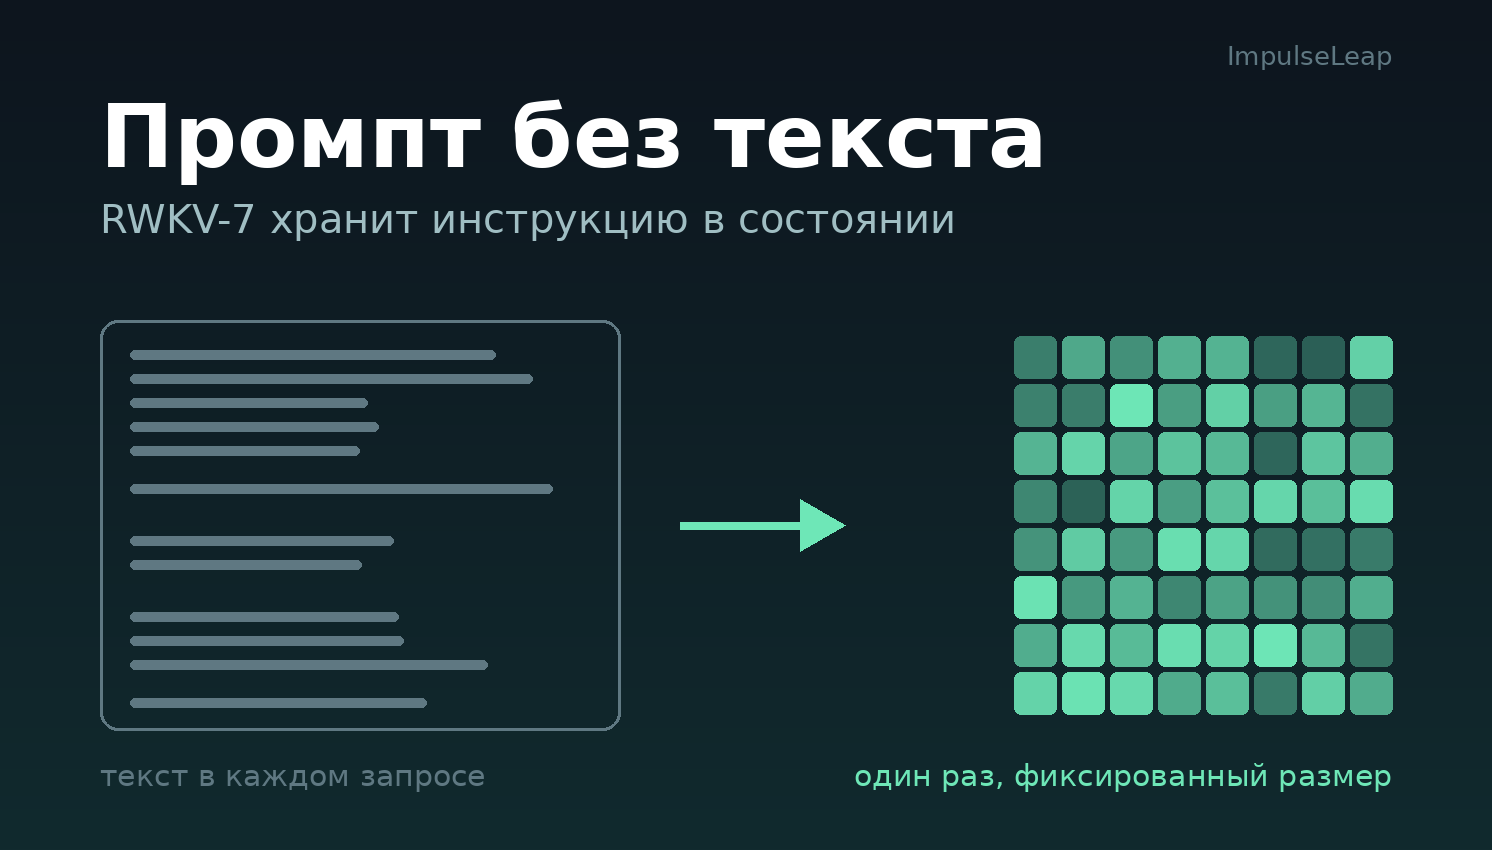
Что такое начальное состояние модели? Почему у RWKV оно может заменить системный промпт? И чем это отличается от обычного промпта? Ответы на эти вопросы в этой статье.
Обычный трансформер читает системный промпт в каждом запросе заново и хранит его в кэше, который растёт вместе с текстом. RWKV устроена иначе: прочитав любой текст, она сжимает всё, что запомнила, в «память» фиксированного размера, то есть в состояние. Перед началом работы это состояние пустое, а значит, его можно взять не пустым. Есть два пути: один раз прочитать промпт и сохранить получившееся состояние (я называю это «свернуть» промпт) или подобрать состояние обучением, не трогая веса модели. В обоих случаях текст промпта больше не нужен.
Я проверил оба пути на моделях RWKV-7 от 0.4B до 2.9B параметров на обычном MacBook M4 16 ГБ. Всё считалось в SwiftRWKV, а квантованные базы сделаны в rwkv-quant (он описан в моей прошлой статье Квантование RWKV-7: что ломается в моделях разного размера). Ниже: что получилось, где это работает лучше текстового промпта, а где ломается.
Вердикт. Да — для неизменной инструкции на моделях такого размера, если состояние обучено на отфильтрованных данных. Выигрыш — в скорости, иногда в точности и устойчивости; знаний состояние не добавляет. Подробности и границы — ниже.
Коротко
Свёрнутый промпт — бесплатный и точный кэш. Он даёт те же ответы, что и текст промпта, а при длинном промпте запрос стартует до 13 раз быстрее.
Промпт в строке может ухудшить модель. На вопросах с проверяемым ответом он снижал точность на 3–15 пунктов на всех восьми проверенных моделях. Обученное состояние ни разу не было значимо хуже модели без промпта и всегда лучше промпта.
Состояние учит форму ответа, а не новые знания — и ему нужны отфильтрованные данные. Если копировать ошибки учителя, состояние их наследует.
Состояние не хуже LoRA на тех же данных: вдвое меньше параметров, веса не меняются. По сравнению с дообучением верхних слоёв в генерации оно лучше или не хуже (в эмбеддере — нет).
Слабые места: наводящие вопросы («Ты ведь Claude?») и длинные диалоги. Оба можно улучшить — с оговорками ниже.
Работает и там, где модель вообще не выполняет инструкцию из текста: 0.4B по промпту классифицирует новости на 0.00, по обученному состоянию — на 0.84–0.89.
К каждому пункту ниже — график и ссылка на полные таблицы.