Обновить
0
Евгений@sofcom

HiTech Expert

Отправить сообщение

Thunderargs: практика использования. Часть 1

Время чтения6 мин
Охват и читатели5.8K
Недавно я писал пост про то, как был придуман и написан thunderargs. Сегодня я раccкажу о том, как его можно применять.

Напомню, что эта штука предназначена для обработки параметров функции при помощи аннотаций. Например, так:

OPERATION = {'+': lambda x, y: x+y,
             '-': lambda x, y: x-y,
             '*': lambda x, y: x*y,
             '/': lambda x, y: x/y,
             '^': lambda x, y: pow(x,y)}

@Endpoint
def calculate(x:Arg(int), y:Arg(int),
                       op:Arg(str, default='+', expander=OPERATION)):
    return str(op(x,y))


Постараемся по ходу тутора решать вполне определённые проблемы, а не какие-то эфемерные задачки. Ну а теперь — к делу.

Читать дальше →

Один вариант использования аннотаций

Время чтения4 мин
Охват и читатели14K
Сразу хочу объявить, что здесь под аннотациями подразумеваются НЕ декораторы. И я не знаю по какой причине декораторы иногда именуют аннотациями.

Недавно я открыл для себя что в питоне есть фишка, которую я очень давно искал — аннотации к функциям. Это — возможность пихнуть в декларацию функции какую-либо информацию по каждому отдельному её параметру.

Вот каноничный пример из PEP:

def compile(source: "something compilable",
            filename: "where the compilable thing comes from",
            mode: "is this a single statement or a suite?"):
    ...


Там же, чуть ниже, приводятся примеры, которые дают понять, что комментирование параметров — не единственное возможное использование данной фичи. Это натолкнуло меня на мысль об одной старой беде, которая досаждала моей нервной системе уже приличное время. А именно — получение данных из форм во Flask.

Читать дальше →

Thunderargs: практика использования. Часть 2

Время чтения12 мин
Охват и читатели3.1K
История создания
Часть 1

Добрый день. Вкратце напомню, что thunderargs — библиотека, которая даёт использовать аннотации для обработки входящих аргументов.

Кроме того, она даёт возможность достаточно просто накидать гейт, который будет эти самые аргументы для функции вытаскивать откуда-нибудь ещё. Например, из объекта request во фласке. И в итоге мы вместо

@app.route('/ugly_calc', dont_wrap=True)
def ugly_calc():
    x, y = int(request.args['x']), int(request.args['y'])
    op_key = request.args.get('op')
    if not op_key:
        op_key = '+'
    op = OPERATION.get(op_key)
    return str(op(x, y))

делаем
@app.route('/calc')
def calc(x:Arg(int), y:Arg(int), op:Arg(str, default='+')):
    return str(OPERATION[op](x, y))


Думаю, все хотя бы примерно поняли о чём будет речь в статье. Всё, что в ней описано — размышления о будущем проекта и примерная расстановка «майлстоунов» по нему. Ну и, разумеется, первые наброски всяких-разных фич.

В этой части


  • Рассмотрим структурные изменения в проекте и пару критических ошибок в изначальной структуре
  • Разберёмся как работают валидаторы и как можно кастомизировать выдаваемые ими ошибки
  • Создадим зачатки специализированных аргументов (IntArg, StrArg, ListArg и так далее)
  • Подготовим класс, который будет автоматически вытаскивать объект из базы по id, поступившему в запросе
  • Будем генерировать точки входа по классу модели
  • Реализуем листенеры и посмотрим как можно сделать валидатор для нескольких аргументов
  • Убедимся, что информацию о структуре аргументов можно смело переносить в БД, и ничего нам за это не будет
  • И, наконец, порассуждаем о мелких интересностях, так и не реализованных в рамках этих экспериментов

Читать дальше →

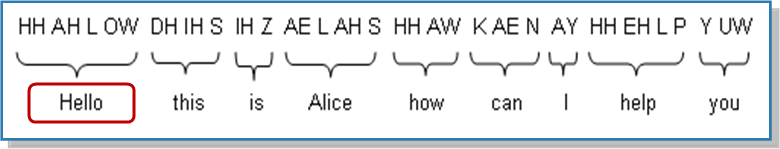
Распознавание русской речи для колл-центров и параноиков

Время чтения11 мин
Охват и читатели75K
Когда вы звоните в колл-центр, вас внимательно слушает, а иногда и отвечает, не только оператор и товарищ майор, но и робот-аналитик. Этот хитрый робот умеет распознавать нужные ключевые слова в вашей речи, но и производить полнотекстовое распознавание речи, и на основании этого всего, делать далеко идущие выводы.


Анализировать записи можно как «на лету» (что делается редко), так и постфактум, например, разыскивая конкретные звонки для анализа живым человеком. Я работал с несколькими программно-аппаратными решениями для этого, и сейчас поделюсь опытом.


Автоматическое распознавание уже начинает справляться с русским языком, за исключением некоторых особо сложных случаев

Сразу отмечу — да, эти решения могут сочетаться с определением конкретного человека по «голосовому отпечатку пальца», но это немного другая история и подробно останавливаться на этом здесь я не буду.
Читать дальше →

Масштабирование наоборот: БЭМ-методология Яндекса на небольших проектах

Время чтения21 мин
Охват и читатели63K
В разработке интерфейсов отдельные фреймворки уже не так важны: когда инструменты доступны, наша задача сводится к выбору нужных. Чтобы сделать правильный выбор, следует начать с общего подхода, с методологии. Большинство методологий, однако, разработаны крупными компаниями. Применимы ли они в маленьких проектах или для успешного использования их нужно переизобретать заново?

Скорее всего, вы уже знаете об одной из таких методологий, разработанной Яндексом, — БЭМ. БЭМ утверждает, что трёх сущностей (блоков, элементов и модификаторов) достаточно для написания HTML и CSS, задания структуры кода и компонентной структуры с последующим масштабированием проекта до самого высокого уровня.

Я проработал в Яндексе достаточно долго и видел, как эта методология работает на больших проектах. В Яндексе БЭМ используют для разработки CSS- и JavaScript-компонент, с помощью этой методологии также пишут шаблоны и задают зависимости между компонентами. Есть БЭМ-инструменты, поощряются различные эксперименты с кодом, исследования. В масштабах большой компании эти трудозатраты окупаются и дают Яндексу возможность быстро и качественно разрабатывать сотни сервисов одновременно.

Могут ли маленькие команды получить от БЭМ то же самое? Я совершенно не был в этом уверен. Всё же БЭМ — абстракция, которая поставляется вместе с инструментами и технологиями. Для маленькой компании польза от переключения на «полный стек» этих технологий — сомнительна, многие из инструментов изначально приспособлены под крупные и сложные задачи. Быть может, тогда полезной окажется сама идея, сама методология?

Изначально эта моя статья была опубликована в известном многим журнале Smashing Magazine. Но я решил, что и на Хабре она может быть интересна, ведь многие здесь занимаются собственными небольшими проектами.

Читать дальше →

Технологии идентификации и позиционирования в режиме реального времени

Время чтения10 мин
Охват и читатели63K


Идентифицировать интересующие объекты и контролировать их местонахождение можно по-разному. Все зависит от целей и условий.
Если цель – распознавание абонентов для оказания районированных услуг (например, прогноза погоды), то ошибка в десяток километров особой роли не сыграет, а если речь идет о позиционировании чипа на плате при автоматической сборке, речь пойдет о микронах.
Если нужно быстро найти нужную запчасть, периодичность опроса в системе может быть минимальной – только в момент, когда эта запчасть потребовалась или при инвентаризации. Остальное время система может проводить в спящем режиме. Но если требуется контролировать соблюдение маршрутов и скоростного режима движения погрузчиков в цехе, потребуется частота опроса до нескольких раз в секунду – режим реального времени.
Фуру на междугородном маршруте логичнее всего отслеживать с помощью спутниковой системы позиционирования, но как только она попадает на крытую разгрузочную площадку или в ремонтный бокс, связь со спутниками теряется и требуется что-то другое.
И таких особенностей применения много. Естественно, существует и множество различных видов систем идентификации и позиционирования.

В этом топике речь пойдет о системах идентификации и позиционирования. Но чтобы не утонуть в море информации, мы оставим в стороне системы локации (радио, акустической, инфракрасной), где местонахождение объекта определяется по отраженному сигналу. Не будем рассматривать роботизированные сборочные системы, где позиция объекта не измеряется системой, а задается ею. Оставим без внимания и интеллектуальные системы видеонаблюдения с их методами распознавания объектов.
Речь в топике пойдет о системах позиционирования с использованием индивидуальных меток – будь то собственно метка, GPS навигатор, Wi-Fi устройство или сотовый телефон.

Читать дальше →

Asterisk – система компьютерной телефонии уровня предприятия

Время чтения9 мин
Охват и читатели286K
Я хочу рассказать о свободном решении для компьютерной телефонии от компании Digium. Asterisk – это ATC созданная хакерами (в первоначальном смысле этого слова), а точнее, это супер конвергентная платформа компьютерной телефонии, распространяемая по лицензии GNU GPL, изначально разрабатываемая Марком Спенсером (Mark Spenser), позже ставшим президентом и техническим директором компании Digium. Благодаря коммерческой поддержке Его компании и лицензии GNU GPL Asterisk активно развивается и поддерживается тысячами людей со всей планеты.

Дaлее

Наш велосипед или скрипты, облегчающие жизнь админа

Время чтения2 мин
Охват и читатели39K
image
В комметариях к одной из предыдущих статей была просьба выложить на всеобщее обозрение все наши наработки, используемые в повседневной жизни. Общими усилиями все было собрано, описано и выложено на github.
Под катом ссылка на репозиторий и краткое описание скриптов.
Читать дальше →

Как собрать электробайк за семь дней

Время чтения1 мин
Охват и читатели132K
Уже очень давно и часто на канале меня просили показать, как же собрать «такую штуку» самому. Особенно после публикации "На электричестве до Крыма". Поэтому, при постройке нового проекта, было принято волевое решение заснять всё на камеру и потом предоставить страждущим в цивильном виде. Волевое, потому что руки всего две, глаз тоже всего пара, и уследить за тем, куда смотрит камера, а куда уже убежала дрель в рабочем процессе очень сложно. Так же это увеличило временные затраты, особенно после. Ролики я фактически собирал даже дольше, чем сам ебайк. Ну да ладно, все тяготы уже позади, встречайте:

День первый: крафтим раму из полуконструктора

Читать дальше →

Наш опыт тестирования LXC (Linux Containers) на примере Debian Wheezy

Время чтения8 мин
Охват и читатели40K


Мы в компании Centos-admin следим за появлением новых технологий, тестируем их и, конечно же, внедряем. Почти на всех серверах мы используем контейнерную виртуализацию OpenVZ. В целях расширения набора инструментов, применяемых в работе, мы решили изучить и протестировать нативную виртуализацию Linux LXC.
Под катом вы найдете небольшой обзор технологии и краткий мануал по использованию LXC в Debian Wheezy и наши выводы.
Читать дальше →

JSCS: JavaScript Code Style

Время чтения3 мин
Охват и читатели59K
Когда девять месяцев назад я написал для себя маленькую консольную утилиту, я и не подозревал, что вскоре она превратится в серьёзный и единственный в своём роде инструмент, которым будут пользоваться даже такие известные всем команды, как jQuery, Bootstrap, Angular. Сейчас, когда я пишу эту статью, у моего проекта на гитхабе 1010 звёздочек, и мне очень радостно думать о том, что так много людей смогли с помощью моей придумки сделать свою работу удобнее.

История этого проекта началась с моей личной боли.

Незадолго до этого момента я перевёлся из одной команды Яндекс.Карт в другую и постепенно вливался в разработку нового для меня продукта. Все было хорошо, новый проект мне нравился, но кодстайл, в котором писали ребята из моей новой команды, очень уж сильно отличался от того стиля кодирования, в котором писал я и ребята из моей прежней команды. Однажды меня даже посетила нелепая мысль, что кодстайл в этой группе писался в противоположность кодстайлу в прежней группе специально, чтобы запутать меня.

Читать дальше →

Многоуровневое меню в XSLT

Время чтения3 мин
Охват и читатели4K
Здравствуйте уважаемые Хабровчане. Хочу представить шаблон вывода многоуровневого меню, хотя, немного переделав, сойдет для вывода обычных деревьев. На нашем любимом сайте подобного не видел, в инете особо не искал. Для кого-то может показаться слишком легким, но надеюсь другим понадобиться.

Вот здесь уже разбиралась тема построение деревьев. В этом примере другая структура XML файла и заточка под другие задачи.

Начнем с XML файла. Структура не сложная. Каждый элемент состоит из идентификатора, идентификатора родительского элемента, ссылки и названия.

Читать дальше →

Случайная сортировка и вывод случайных элементов в XSLT

Время чтения4 мин
Охват и читатели3.8K

Вступление


В этой статье хочу поделиться с Вами моими попытками создать случайную (хотя уместнее буде сказать псевдослучайную) сортировку средствами XSLT, без использования сторонних приложений и расширений.

Изначально была задача сделать сортировку под PHP-ный XSLT процессор. Но захотелось сделать что-то более универсальное.

Опытный образец


Для начала нам понадобиться образец для тестирования сортировки. Не будем заниматься хитросплетениями и напишем просто.

Файл данных data.xml
<?xml version="1.0" encoding="UTF-8"?>
<?xml-stylesheet type="text/xsl" href="view.xsl"?>
<root>
<item id="1"/><item id="2"/><item id="3"/><item id="4"/><item id="5"/><item id="6"/><item id="7"/><item id="8"/><item id="9"/><item id="10"/>
</root>

Читать дальше →

Использование xslt-шаблонов в реальных проектах

Время чтения7 мин
Охват и читатели33K
В статье вы не найдёте сравнительных тестов шаблонизаторов. Зато найдёте информацию об использовании xslt в качестве шаблонизатора на реальных проектах. Рассмотрены возможности именованных шаблонов, использование шаблонов-функций, справочников.

1. Структура проекта


Обычно страница сайта состоит из нескольких общих блоков (меню, футер, ...) и контентной части, которую для общности будем называть основным блоком. Все эти блоки размещаются внутри некоторого индексного шаблона, который знает в каком месте какой блок отобразить: меню должно быть вверху, основной блок в центре, а футер внизу.

Получаем следующую структуру
/themes - здесь раполагаются все шаблоны
/themes/index/main.xsl - индексный шаблон
/themes/models/user.xsl - именованные шаблоны, которые относятся к модели пользователя
/themes/inc/functions.xsl - именованные шаблоны-функции
/themes/blocks/footer.xsl - шаблон футера
/themes/blocks/menu.xsl - шаблон меню
/themes/cabinet/main.xsl - шаблон основного блока главной страницы кабинета пользователя


Контроллер главной страницы кабинета пользователя работает следующим образом:
  1. получает данные для основного блока, обрабатывает их с помощью /themes/cabinet/main.xsl и результат (готовый html) помещает в итоговый xml
  2. аналогично обрабатывает данные для других блоков (меню, футер) и результат помещает в xml
  3. итоговый xml, в котором находятся данные всех блоков, обрабатывает с помощью индексного шаблона /themes/index/main.xsl и результат отдаёт пользователю в виде html.

Читать дальше →

Пагинатор (постраничная навигация) на XSLT

Время чтения14 мин
Охват и читатели10K
Время от времени всплывает умирающая технология XSLT и задаёт непростые вопросы. Как, например, взять максимум от 2 чисел в выражении или как организовать цикл. Соединением многих таких вопросов служит пагинатор — вывод навигации по нескольким страницам и, по возможности, удобный. На Javascript есть много примеров простых и удобных пагинаторов. Но если страницы с сервера выдаются в XML, то возникает крамольная мысль: почему бы всё оформление страниц, включая пагинатор, не сделать на статике, в XSLT? Ничего, что в эту статику можно включить JS и сделать всё проще. Кошерный подход лёгких путей не ищет.
Читать дальше →

PHP-расширение dom_varimport: быстрое преобразования вложенных массивов в DOMDocument

Время чтения3 мин
Охват и читатели8.1K
Некоторые проекты используют XSLT в качестве основного «движка» шаблонов. Помимо известных недостатков XSLT (например, его многословности, относительной медлительности и т.д.) у него есть и преимущества: «стандартность» языка, его идеология отсутствия «побочных эффектов» и pattern matching, возможность при необходимости вызывать методы helper-классов из шаблонов (через exslt-расширение). Какое-то время назад я выкладывал библиотеку ShortXSLT, позволяющую вместо громоздких <xsl:value-of select="/root/abc"/> и <xsl:choose>...</xsl:choose> писать просто {/root/abc} и {if...}...{elseif}...{/if} без потери производительности, так что проблема многословности отчасти решается.

Но сейчас речь не о преимуществах и недостатках XSLT (я уверен, и противники, и сторонники этой технологии найдутся в изобилии). Я бы хотел описать один прием, который удобно применять в существующих проектах с XSLT-шаблонами, и привести ссылку на библиотеку, реализующую данный прием с хорошей производительностью.

Передаем данные в XSLT, минуя генерацию текстового представления XML

Представьте, что у нас есть контроллер, генерирующий некоторый вложенный PHP-список объектов для отображения на странице. Он должен этот массив преобразовать в XML, который потом пойдет на вход XSLT-шаблону. Хорошо бы, чтобы данное преобразование из структур PHP в XML выполнялось не вручную в каждом контроллере, а был некоторый промежуточный слой абстракции, который умеет применять XSLT-шаблон прямо к PHP-данным, минуя текстовое XML-представление. Так мы уменьшим вероятность ошибок, да и письмо сократится. Мы сможем работать с XSLT-шаблонами напрямую, минуя XML-представление данных.

Некоторое время назад я написал на Си PHP-расширение dom_varimport (также выложено на GitHub). Оно содержит одноименную функцию, на вход которой подается объект DOMDocument и PHP-массив любой вложенности. Функция заполняет переданный ей DOMDocument XML-представлением входного массива, и делает она это очень быстро — примерно в 20 раз быстрее, чем делал бы код, написанный на чистом PHP. Большой документ размером около 1 МБ с тысячами вложенных свойств и объектов формируется примерно за 1-2 миллисекунды.

Например, вызов:
Читать дальше →

Книги о кибербезопасности: 5+ рекомендаций наших экспертов

Время чтения5 мин
Охват и читатели103K
Недавно у меня состоялся показательный разговор с Алексеем Малановым, сотрудником «Лаборатории» и опытным исследователем вредоносных программ, о том, может ли, например, сотрудник отдела по связям с общественностью (=не технарь) стать вирусным аналитиком? Ответ был простой и сложный одновременно: основы программирования, архитектура процессоров, особенности операционных систем, сетевые протоколы… В общем, «купи книжку по Ассемблеру и приходи лет через пять».

А что, если подняться на уровень выше? От анализа конкретных экземпляров вредоносных программ (что само по себе непросто) перейти к комплексному исследованию компьютерных инцидентов? Этим у нас занимается подразделение Global Research and Analysis Team (GReaT). К ним я недавно обратился с похожим вопросом: какие книги они могут порекомендовать другим специалистам по компьютерной безопасности (имея в виду, что азы программирования и прочие базовые вещи уже освоены)? В результате получился список из пяти книг — а на самом деле из десяти :-), — с которым можно ознакомиться под катом.
Читать дальше →

Дайджест интересных новостей и материалов из мира PHP № 46 (3 – 24 августа 2014)

Время чтения6 мин
Охват и читатели27K


Предлагаем вашему вниманию очередную подборку со ссылками на новости и материалы.

Приятного чтения!
Читать дальше →

Вебинар Крикета Ли — (со)автора книг о DNS и Bind. Безопасность DNS: угрозы и решения, Best Practices

Время чтения1 мин
Охват и читатели7.5K

DNS — один из важнейших сетевых сервисов, о безопасности, надежности и производительности которого часто забывают. По количеству атак DNS находится на втором месте после HTTP/HTTPS, и только за последний год число атак возросло на 216%.
Крикет Ли — автор и соавтор книг о DNS и Bind — проведет вебинар о безопасности DNS. Будут рассмотрены основные угрозы сервису (DDoS, cache poisoning, tunneling, amplification и т.д.) и предложены рекомендации по защите.

Вебинар пройдет 28 Августа 2014г. в 20:00 по московскому времени.
Зарегистрироваться можно тут.
Читать дальше →

Информация

В рейтинге
Не участвует
Откуда
Баксан, Кабардино-Балкария, Россия
Дата рождения
Зарегистрирован
Активность