
Есть проект клиента: сервер с двумя HDD в зеркале, 1,4 ТБ данных и около 24 миллионов файлов, в основном мелких, в раскладке вида ab1/c2d/<один файл>. Сайт пишет на этот же диск круглосуточно.
Я разрабатываю сервис резервного копирования: для него я написал агент, который снимает копии с машин клиентов в S3. Мне важно, чтобы повторный снимок укладывался в разумное время даже на тяжёлых машинах, где мало что меняется, а файлов очень много. Обычно проблемы с производительностью лежат в сети или в хранилище. Этот случай оказался другим.
Первый бэкап такого диска долгий, и тут всё понятно: надо передать 1,4 ТБ. Меня заинтересовал повторный. Данных изменилось немного, передавать почти нечего, а снимок шёл до 12 часов. Время уходило не на передачу, а на то, чтобы выяснить, что не изменилось.
Как устроен бэкап, о котором речь
Чтобы было понятно, чем именно я мерю время, коротко про схему.
Движок. Бэкапы делает
rustic— restic-совместимый инструмент на Rust с открытым кодом. Я использую его как библиотеку (rustic_core) внутри своего агента. Агент работает на машине клиента и сам, по опросу, забирает задачи. Репозиторий (в терминах restic) пишется напрямую в S3-хранилище: для каждой машины свой бакет и свой пароль шифрования.Что такое снимок. Файлы режутся на блоки переменной длины, блоки дедуплицируются, шифруются и пакуются, а снимок — это дерево каталогов со ссылками на блоки. Каждый снимок «полный» по смыслу, но передаётся только новое.
Как работает повторный снимок. Агент берёт предыдущий снимок как родительский и обходит диск. Если у файла по сравнению с родителем совпали время изменения, размер и inode, содержимое не читается: берутся готовые ссылки на блоки. Содержимое читают только у изменённых файлов. Поэтому повторный снимок быстрый по данным, но обойти нужно всё: узнать, что файл не менялся, можно только прочитав его метаданные.
Именно эта сверка по метаданным и оказалась узким местом.
Почему не rsync и не снимки файловой системы
Вопрос неизбежный, отвечу заранее.
rsyncне даёт ни дедупликации, ни шифрования, ни истории версий: каждая точка во времени — это отдельная копия или схема с--link-dest. На 1,4 ТБ и сотнях снимков в год это неподъёмно по месту.Снимки файловой системы (LVM, ZFS, btrfs) решают другую задачу — согласованность на момент времени. К тому же здесь ext4 на mdadm-зеркале, и менять файловую систему ради бэкапа никто не будет. А чтобы найти, что изменилось с прошлого раза, дерево всё равно придётся обойти.
Что я увидел
Я смотрел на машину во время повторного снимка:
обход идёт со скоростью порядка 300 файлов в секунду;
процессор, сеть и запись в хранилище простаивают;
поток агента стоит в состоянии
D(непрерываемое ожидание ввода-вывода), в стекеext4_read_bh;iowaitоколо 25%.
Всё упирается в диск, но не в передачу данных. Он занят чем-то другим.
Причина 1. Порядок, в котором запрашиваются метаданные
Чтобы понять, изменился ли файл, надо прочитать его метаданные. Библиотека обходит каталог в порядке имён и делает lstat на каждый файл по очереди.
Порядок имён никак не связан с порядком хранения. На ext4 метаданные лежат в таблицах inode, и файлы с соседними именами могут оказаться в разных местах диска. Один lstat — один seek, а запрос всегда один: следующий начинается после ответа на предыдущий. Очередь диска длиной 1 означает, что планировщику нечего переупорядочивать, это чистый случайный доступ. На HDD это порядка сотен операций в секунду, и процессор тут ничего не изменит.
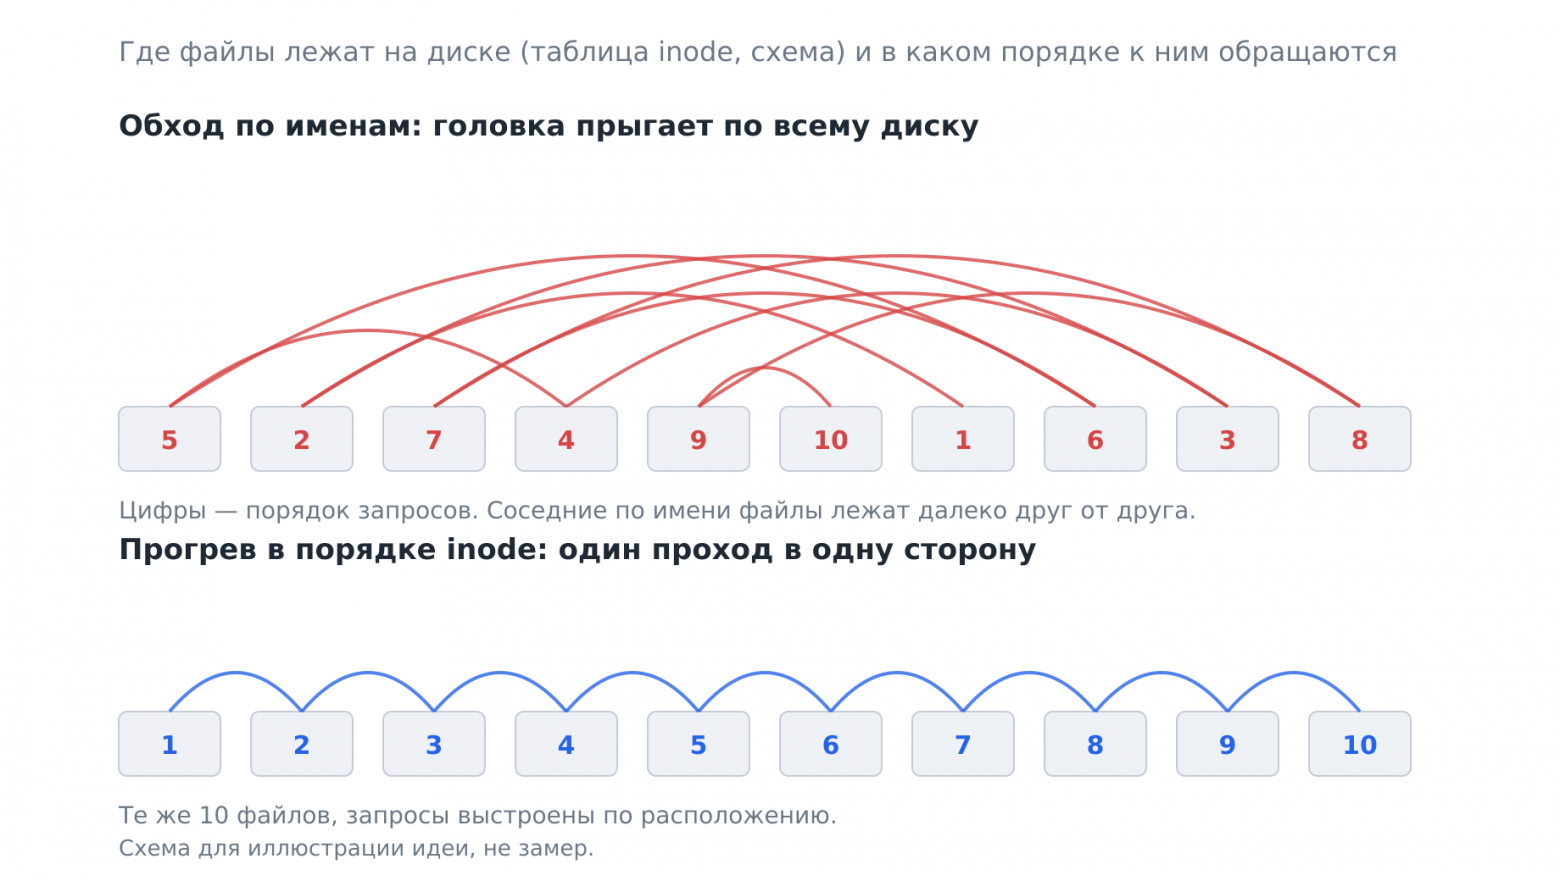
Borg решает это сортировкой каталога по номеру inode до stat (scandir_inorder). У меня так просто не сделать, и вот почему.
Обход в библиотеке построен на ignore::WalkBuilder с сортировкой по имени пути, и всё дальше по цепочке рассчитывает на этот порядок: дерево снимка записывается каталог за каталогом в порядке имён, а сверка с родительским снимком идёт по тому же порядку. Чтобы обходить в порядке inode, пришлось бы менять не одно место, а сам способ, которым обход, сверка и сборка дерева передают друг другу данные.
В принципе это можно: переписать ядро обхода внутри библиотеки. Но это большие правки чужого кода, форк, который потом придётся поддерживать при каждом обновлении версии, и риск тронуть то, что отвечает за целостность снимка. Для одной оптимизации цена слишком высокая, поэтому я выбрал другой путь.
Решение. Прогреть кэш заранее, в порядке inode
Сразу скажу: код агента закрытый, поэтому повторить мою реализацию целиком вы не сможете. Но сама идея не привязана к моему коду и переносится на любой инструмент, который обходит большое дерево. Ниже я описываю её так, чтобы её можно было воспроизвести у себя.
Я не менял порядок обхода, а подогрел кэш ядра сбоку. Рядом с обходом работают помощники:
Когда обход входит в каталог, помощники читают список его записей. Номер inode приходит вместе с записью каталога, без обращения к таблице inode.
Записи сортируются по inode.
8 потоков делают
lstatв этом порядке, кусками по 64 записи. Запросов в полёте много, диск их сортирует и обслуживает проходом по поверхности.Когда обход доходит до файла, ответ уже лежит в кэше ядра, и диск он не трогает.
Результат обхода не меняется. Если прогрев что-то не прочитал, обход прочитает файл сам.
Потоков 8, а не 64, потому что глубокая очередь удлиняет ожидание для всех, кто читает тот же диск, а там работает сайт.
Упрощённый набросок идеи на Rust (не мой рабочий код, а иллюстрация для одного каталога на Linux):
use std::{fs, os::unix::fs::DirEntryExt, path::PathBuf};

fn warm(dir: &std::path::Path) -> std::io::Result<()> {
    let mut entries: Vec<_> = fs::read_dir(dir)?.filter_map(Result::ok).collect();
    // номер inode приходит с записью каталога, диск для этого не нужен
    entries.sort_by_key(|e| e.ino());

    let paths: Vec<PathBuf> = entries.iter().map(|e| e.path()).collect();
    std::thread::scope(|s| {
        for chunk in paths.chunks(64) {
            s.spawn(move || {
                for p in chunk {
                    let _ = fs::symlink_metadata(p); // lstat: результат ляжет в кэш ядра
                }
            });
        }
    });
    Ok(())
}
Здесь на каждый кусок заводится свой поток, в реальной системе нужен пул фиксированного размера (у меня 8). Суть та же: отсортировать записи по inode и обратиться к ним пачкой, чтобы диск сам выстроил очередь. Ту же идею можно применить к find, к своему сканеру файлов или к любому инструменту, который делает stat на миллионы файлов.
Окно прогрева
Каталоги греются не только в тот момент, когда в них входит обход, но и немного вперёд. Набор каталогов, которые уже прогреты или греются впереди обхода, я называю окном.
Первая версия наполняла окно один раз, при входе в родительский каталог. Это сломалось на раскладке 142/6e2/<один файл>: в одном родителе 784 подкаталога с одним-двумя файлами. Прогревались первые 64, остальные 720 обход читал по-старому.
Теперь каждый каталог, в который заходит обход, снимает пройденное из окна и добирает ближайшие подкаталоги из очереди ожидающих. Окно движется вместе с обходом.
Бесконечным его делать нельзя: прогретое лежит в кэше inode, и если уйти далеко вперёд, оно вытеснит то, что нужно сейчас. Потолки: 512 каталогов, 200 тысяч записей на всё окно, 20 тысяч на один каталог. Размер каталога известен только после чтения, поэтому потолок проверяется после чтения и до lstat. Иначе каталоги, поставленные в очередь «с весом 1», успевали прочитать метаданные сверх лимита.
Грабли
Приоритет ввода-вывода. Чтобы не мешать сайту, я сначала поставил потокам прогрева класс idle. Не сработало: диск был занят записями сайта на 100%, а idle-запросы обслуживаются только когда диск свободен. Обход стоял на getdents64 (чтение списка каталога), потоки прогрева спали. Теперь потоки не ставят приоритет сами, а наследуют режим нагрузки, который владелец машины выбирает в настройках бэкапа.
Два корня. В настройках бэкапа указано два пути для обхода: / и отдельный диск с данными. Окно отслеживает, где сейчас обход. Когда я прогревал второй корень, окно принимало его за текущее место обхода и выбрасывало всё, что раньше, то есть окно первого корня. Корни до начала обхода теперь греются без сдвига окна.
Причина 2. Чтение каталога пишет на диск
После прогрева диск всё равно был перегружен, и странным образом: записями. Агент на диск клиента ничего не пишет.
Статистика блочного устройства: запись ~100 операций в секунду с задержкой 756 мс, чтение ~33 операции в секунду с задержкой 156 мс. Записей в несколько раз больше, чем чтений, и они не числятся за процессом агента (/proc/<pid>/io пуст): их делают потоки ядра. Dirty в /proc/meminfo доходил до сотен мегабайт.
Причина в параметре монтирования relatime. При первом чтении за сутки ядро обновляет время доступа (atime) у прочитанного. Обход 24 миллионов файлов даёт сотни мелких записей в секунду, и они конкурируют с чтением за те же головки.
Я перемонтировал диск на ходу, без перезагрузки:
mount -o remount,noatime /путь/к/диску
|
| |
|---|---|---|
запись | ~100 оп/с, 756 мс | 4 оп/с |
чтение | 33 оп/с, 156 мс | 176 оп/с, 15 мс |
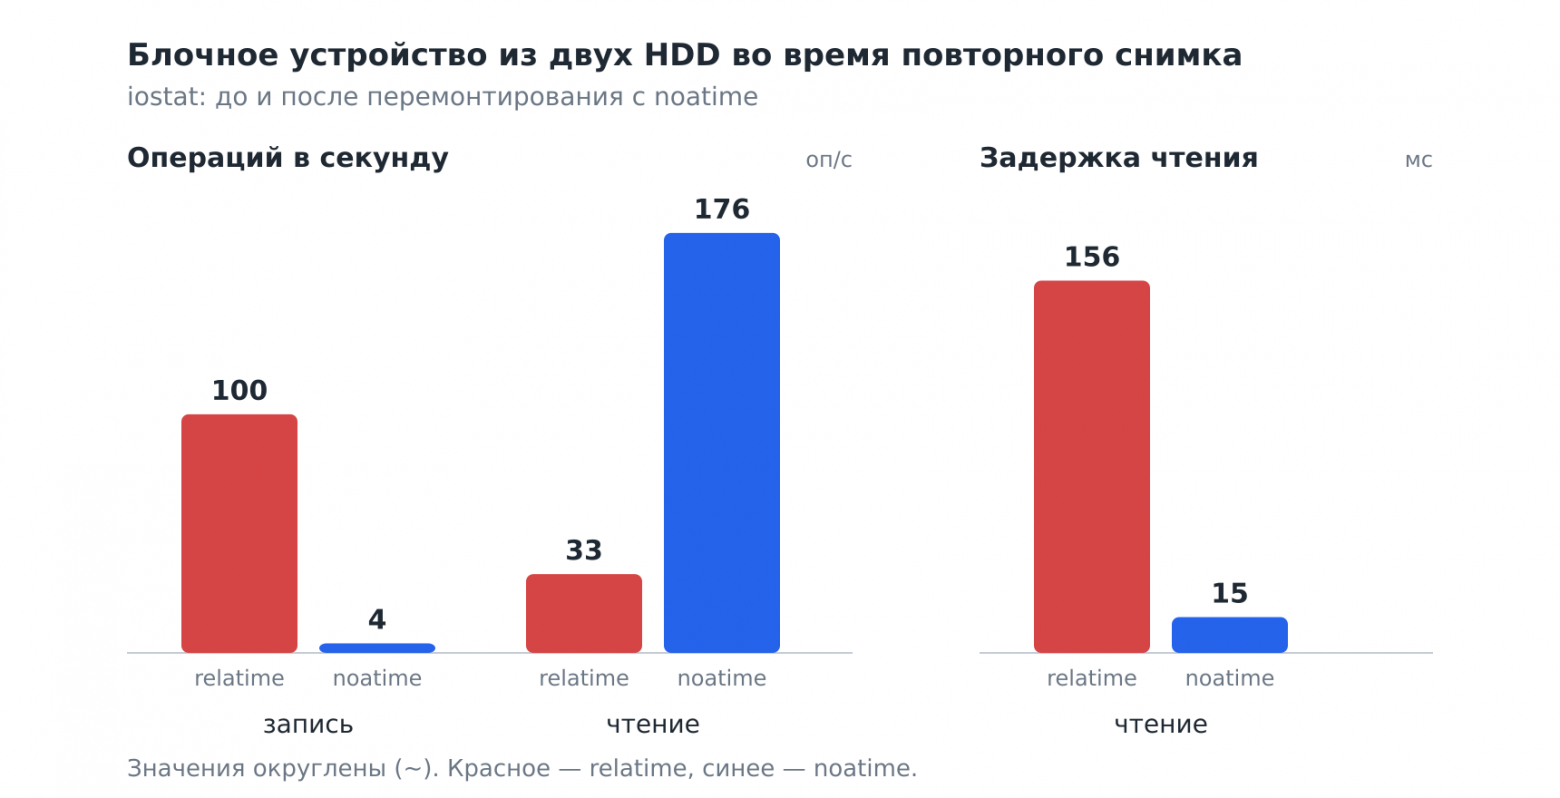
Чтение ускорилось более чем в пять раз, задержка упала в десять. Это лечится параметром монтирования, не кодом. Чтобы он пережил перезагрузку, я добавил noatime в /etc/fstab.
Побочный эффект: atime перестанет обновляться, и программы, которые на него опираются (например, очистка по давности чтения), будут работать иначе. Здесь это не проблема: на диске в основном лежат статические ресурсы сайта, и от времени доступа к ним ничего не зависит. На другой машине сначала стоит проверить, не опирается ли на atime что-то из ваших программ. Агент монтирование не меняет: это решение владельца машины.
Ещё один лишний обход
Чтобы показывать прогресс-бар с процентами, библиотека запускала рядом с основным обходом ещё один полный stat-обход, чтобы посчитать общий размер. Оба били по одному диску, а число приходило уже после конца основного. Теперь размер берётся из прошлого снимка, с тома или из подсчёта с лимитом.
Вопросы, которые наверняка возникнут
Не мешает ли прогрев сайту клиента? Это меня беспокоило больше всего. Поэтому потоков всего 8, окно ограничено, а приоритет ввода-вывода наследуется от режима нагрузки, который задаёт владелец машины.
А если файлы меняются во время обхода? Прогрев только заполняет кэш и ничего не решает за обход. Если файл изменился между прогревом и обходом, обход прочитает его сам и увидит свежие метаданные.
Почему не распараллелить сам обход? Обход и сверка с родителем идут в одном потоке внутри библиотеки, а параллельным конвейер становится только после сверки. Это ровно тот случай, о котором я писал выше: менять порядок и устройство обхода значит переписывать библиотеку. Прогрев сбоку даёт нужный эффект без этого.
Почему не Borg, если там это уже есть? Borg — отличный инструмент. Но у меня другой формат репозитория, прямая запись в S3 и агент на Rust, поэтому я перенёс идею, а не инструмент.
Итог
Повторный снимок (время всей задачи) | |
|---|---|
Было | до 12 часов |
Стало (прогрев по inode + | около 3 часов |
Какая доля ускорения приходится на прогрев, а какая на noatime, я не измерял: пока работал один, второй продолжал мешать. Нужны оба.
Что пригодится, даже если вы не пишете бэкапы:
На вращающемся диске порядок обращений важнее процессора. Если у вас миллионы мелких файлов, делайте
statв порядке inode, а не имён.Очередь длиной 1 убивает HDD. Много запросов в полёте дают планировщику шанс отсортировать их, но глубину надо ограничивать.
idleв ionice не работает на диске, который никогда не простаивает.Проверьте монтирование.
relatimeна дереве с десятками миллионов файлов превращает чтение в запись.Если процессор и сеть простаивают, а
iowaitрастёт, смотрите на блочное устройство, а не на программу.
Проверить у себя:
findmnt -T /путь/к/данным -o TARGET,OPTIONSiostat -x 1
iostat -x 1
Буду рад вопросам в комментариях, особенно если вы решали такую задачу иначе: через снимки файловой системы или журнал изменений.