В этой статье мы расскажем про более низкоуровневые оптимизации, которые можно делать на процессорах Эльбрус.
В принципе, оптимизации подобного уровня не являются необходимым этапом разработки под Эльбрус. Для большинства вычислительных операций, требующих высокой производительности, можно и нужно использовать функции из библиотеки EML.
Однако в текущей версии EML мы не нашли некоторых интересных нам функций, поэтому приняли решение написать их сами.
Для этого мы использовали интринсики. Интринсики – конструкции, выглядящие для программиста как обычные функции, но их вызовы заменяются компилятором “по месту” на высокоэффективный код. Чаще всего интринсики нужны, когда хочется использовать векторные расширения процессора, позволяющие выполнять одну и ту же операцию над регистром, содержащим сразу несколько элементов данных. Даже оптимизирующий компилятор не всегда может угадать, что такая конструкция ускорит ваш код. В таких случаях раньше, если не было подходящей оптимизированной библиотеки, приходилось использовать ассемблер. Но быстродействие ассемблерного кода существенно зависит от эффективности использования регистров, учета задержек АЛУ и прочих чудесных вещей. А Эльбрус еще и имеет VLIW-архитектуру, а значит, если мы хотим писать на ассемблере, нам предстоит самостоятельно следить за формированием широких командных слов. С другой стороны, для подобных тонкостей и создаются оптимизирующие компиляторы. Переход на интринсики позволяет разумно распределить работу между человеком и программой. Код, использующий интринсики, можно без проблем переносить между системами, поддерживающими все задействованные интринсики. То есть в нашей ситуации интринсики очевидно являются оптимальным решением.
Микропроцессоры Эльбрус-4С и Эльбрус-8С поддерживают векторные операции с регистром размера 64 бита. С помощью такого регистра можно одновременно обработать два 32-битных числа, четыре 16-битных целых числа или восемь 8-битных целых чисел. Набор интринсиков микропроцессора Эльбрус включает в себя операции для преобразования данных, инициализации элементов вектора, арифметических операций, побитовых логических операций, перестановки элементов вектора и, как нам показалось, достаточно похож на набор инструкций SSE/SSE2 процессоров x86.
Итак, приступим к оптимизации. Возьмем кусочек кода для сложения двух массивов типа uint16_t с записью результата в третий массив (такой операции в EML пока нет):
// Вариант 0
// eml_16u *src1 - указатель на первый аргумент суммы массивов
// eml_16u *src2 - указатель на второй аргумент суммы массивов
// eml_16u *dst - указатель на результирующий массив
// len - длина массивов
for (size_t i = 0; i < len; ++i)
  dst[i] = src1[i] + src2[i];
Теперь перепишем его с использованием интринсиков. Для простоты будем считать, что длина массивов len делится на 4, а остающиеся элементы массивов обрабатываются отдельно. Тогда получится примерно так:
// Вариант 1
// eml_16u *src1 - указатель на первый аргумент суммы массивов
// eml_16u *src2 - указатель на второй аргумент суммы массивов
// eml_16u *dst - указатель на результирующий массив
// len - длина массивов
static const size_t block_size = sizeof(eml_64u) / sizeof(eml_16u);
for (size_t i = 0; i < len; i += block_size, src1 += block_size, src2 +=
    block_size, dst += block_size)
  *(__di*)dst = __builtin_e2k_paddh(*(__di*)src1, *(__di*)src2);
Здесь __di – 64-битный тип данных, а __builtin_e2k_paddh – интринсик, осуществляющий 16-битное беззнаковое сложение.
Однако этот код неоптимален, поскольку для загрузки невыровненного 64-битного числа r по адресу p процессору необходимо осуществить следующие элементарные операции:
Определить смещение
sадресаpот границы выравнивания на 64-бита (см. Рис. 1). Адрес выровненного 64-битного числа, содержащего началоrбудет равенp - s. Адрес следующего за ним выровненного 64-битного числа, содержащего конецr, будет равенp - s + 8.
Загрузить из памяти 2 64-битных числа r1, r2, содержащих
r, по выровненным адресам.
- Найти число
r, зная r1, r2,s.
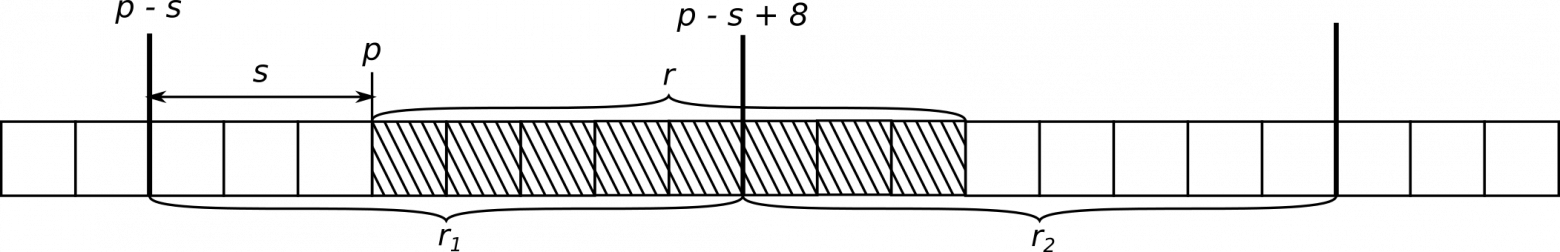
Рис. 1. Схема невыровненной загрузки 64-битных данных из памяти.
Для дальнейшей оптимизации запишем это в явном виде, используя макросы Эльбруса:
__di s = E2K_BYTES_FROM_ALIGN(p, 8);
__di tmp;
E2K_PREPARE_ALIGN(s, tmp);
const __di *p_aligned = (__di *)E2K_ALIGN_PTR_BACK(p, 8);
__di r1 = *p_aligned;
__di r2 = *(p_aligned + 1);
__di r;
E2K_ALIGN_DATA(r1, r2, r, tmp);
Такой код будет выполнять по 6 обращений в память на каждой итерации цикла, как и исходный вариант с невыровненной загрузкой. Однако явное обращение по выровненным адресам делает возможным использование специального буфера подкачки массивов, имеющегося в архитектуре Эльбрус для повышения эффективности доступа к памяти (кстати, в коде без интринсиков этот буфер также использовался).
Можно легко уменьшить число обращений в память на каждой итерации до 3, сохранив значения, загруженные на предыдущей итерации цикла. Кроме того, будем использовать только выровненную запись в массив-результат, обрабатывая начальную часть массивов отдельно. Благодаря этому и чтение, и запись в память будут происходить более эффективно.
// Вариант 2
// eml_16u *src1 - указатель на первый аргумент суммы массивов
// eml_16u *src2 - указатель на второй аргумент суммы массивов
// eml_16u *dst - указатель на результирующий массив
// len - длина массивов
size_t i = 0;
// Найдем количество элементов до границы выравнивания на 64-бита для dst и обработаем их
size_t offset = E2K_BYTES_TO_ALIGN(dst, sizeof(eml_64u)) / sizeof(eml_16u);
for (; i < offset; ++i)
  dst[i] = src1[i] + src2[i];
// Обработаем основную часть массива
__di spec0, spec1;
__di tmp0, tmp1;
__di align1 = E2K_BYTES_FROM_ALIGN(src1 + offset, sizeof(eml_64u));
E2K_PREPARE_ALIGN(align1, spec0);
__di align2 = E2K_BYTES_FROM_ALIGN(src2 + offset, sizeof(eml_64u));
E2K_PREPARE_ALIGN(align2, spec1);
const __di *v1 = (__di *)E2K_ALIGN_PTR_BACK(src1 + offset, 8);
const __di *v2 = (__di *)E2K_ALIGN_PTR_BACK(src2 + offset, 8);
__di *v3 = (__di*)(dst + offset);
__di d01, d11;
__di d00 = *v1;
__di d10 = *v2;
++v1;
++v2;
static const size_t block_size = sizeof(eml_64u) / sizeof(eml_16u);
size_t effective_len = offset + ((len - offset) & ~(block_size - 1));
for (; i < effective_len; i += block_size, ++v1, ++v2, ++v3) {
  d01 = *v1;
  d11 = *v2;
  E2K_ALIGN_DATA(d00, d01, tmp0, spec0);
  E2K_ALIGN_DATA(d10, d11, tmp1, spec1);
  *v3 = __builtin_e2k_paddh(tmp0, tmp1);
  d00 = d01;
  d10 = d11;
}
// Обработаем оставшиеся элементы последовательно, если они есть
Казалось бы, что можно ещё сделать?
Однако, как мы помним, на современных Эльбрусах имеется 6 каналов исполнения, в которые можно поместить до 24 инструкций, и они будут исполняться за 1 такт. Из этих инструкций только 6 могут быть арифметическими для целых чисел, т. к. на каждый канал есть только одно векторное АЛУ (другие инструкции могли бы относиться к вещественной арифметике, загрузке/записи и пр.) Кроме того, есть ещё одна тонкость: эти 6 АЛУ разные, и каждая арифметическая команда может быть исполнена только в определенных каналах. Для ненасыщающего сложения подходят только каналы 0 и 3. Поэтому за 1 такт мы можем выполнить не больше 2 сложений. Чтобы подсказать осторожному компилятору, что эти два сложения независимы (т. е. результат первого не используется во втором), развернем цикл. Это можно сделать вручную или с помощью директивы компилятора:
#pragma unroll(2)
Кроме того, можно подсказать компилятору количество ожидаемых итераций цикла, например, для цикла по строке изображения подойдёт число около 1024 (это вполне разумная оценка линейных размеров распознаваемых изображений, да и коллеги из МЦСТ рекомендовали такой размер; общая идея в том, что число должно быть достаточно большим, чтобы компилятор счёл уместным использовать специальные цикловые оптимизации):
#pragma loop count(1024)
Разумеется, в заведомо коротких циклах компилятору следует оставить противоположную подсказку (см. ниже).
// Вариант 3
// eml_16u *src1 - указатель на первый аргумент суммы массивов
// eml_16u *src2 - указатель на второй аргумент суммы массивов
// eml_16u *dst - указатель на результирующий массив
// len - длина массивов
size_t i = 0;
// Найдем количество элементов до границы выравнивания
на 64-бита для dst и обработаем их
size_t offset = E2K_BYTES_TO_ALIGN(dst, sizeof(eml_64u)) / sizeof(eml_16u);
#pragma loop count(3)
for (; i < offset; ++i) {
  dst[i] = src1[i] + src2[i];
}
// Обработаем основную часть массива
__di spec1, spec2;
__di tmp0, tmp1;
__di align1 = E2K_BYTES_FROM_ALIGN(src1 + offset, sizeof(eml_64u));
E2K_PREPARE_ALIGN(align1, spec1);
__di align2 = E2K_BYTES_FROM_ALIGN(src2 + offset, sizeof(eml_64u));
E2K_PREPARE_ALIGN(align2, spec2);
const __di *v1 = (__di *)E2K_ALIGN_PTR_BACK(src1 + offset, sizeof(eml_64u));
const __di *v2 = (__di *)E2K_ALIGN_PTR_BACK(src2 + offset, sizeof(eml_64u));
__di *v3 = (__di*)(dst + offset);
__di d01, d11, d02, d12;
__di d00 = *v1;
__di d10 = *v2;
++v1;
++v2;
size_t effective_len = offset + ((len - offset) & ~0x03);
#pragma unroll(2)
#pragma loop count(1024)
for (; i < effective_len; i += 4, ++v1, ++v2, ++v3) {
  d01 = *v1;
  d11 = *v2;
  E2K_ALIGN_DATA(d00, d01, tmp0, spec0);
  E2K_ALIGN_DATA(d10, d11, tmp1, spec1);
  *v3 = __builtin_e2k_paddh(tmp0, tmp1);
  d00 = d01;
  d10 = d11;
}
// Обработаем оставшиеся элементы последовательно, если они есть
Теперь приведем результаты замеров. Для этого мы измеряли время сложения двух массивов длины 105. Среднее время по 105 итерациям приведено в таблице.
| Вариант | Среднее время сложения массивов, мкс |
|---|---|
| 0 | 219,0 |
| 1 | 250,7 |
| 2 | 62,6 |
| 3 | 31,4 |
Наша оптимизация позволила в 7 раз ускорить сложение! Мы видим, что, задавшись целью выжать максимум производительности и потратив немного времени на изучение особенностей Эльбруса, можно добиться значительных результатов.
Большое спасибо сотрудникам МЦСТ, которые неоднократно консультировали нас при написании этого материала!