Комментарии 57

Попробуйте самостоятельно написать 2-3 осмысленных абзаца на любую тему и только потом приступайте к редактированию своего нейрослопа

Переведено с помощью DeepL.com (бесплатная версия)
Ну это достойный уровень проверки материала

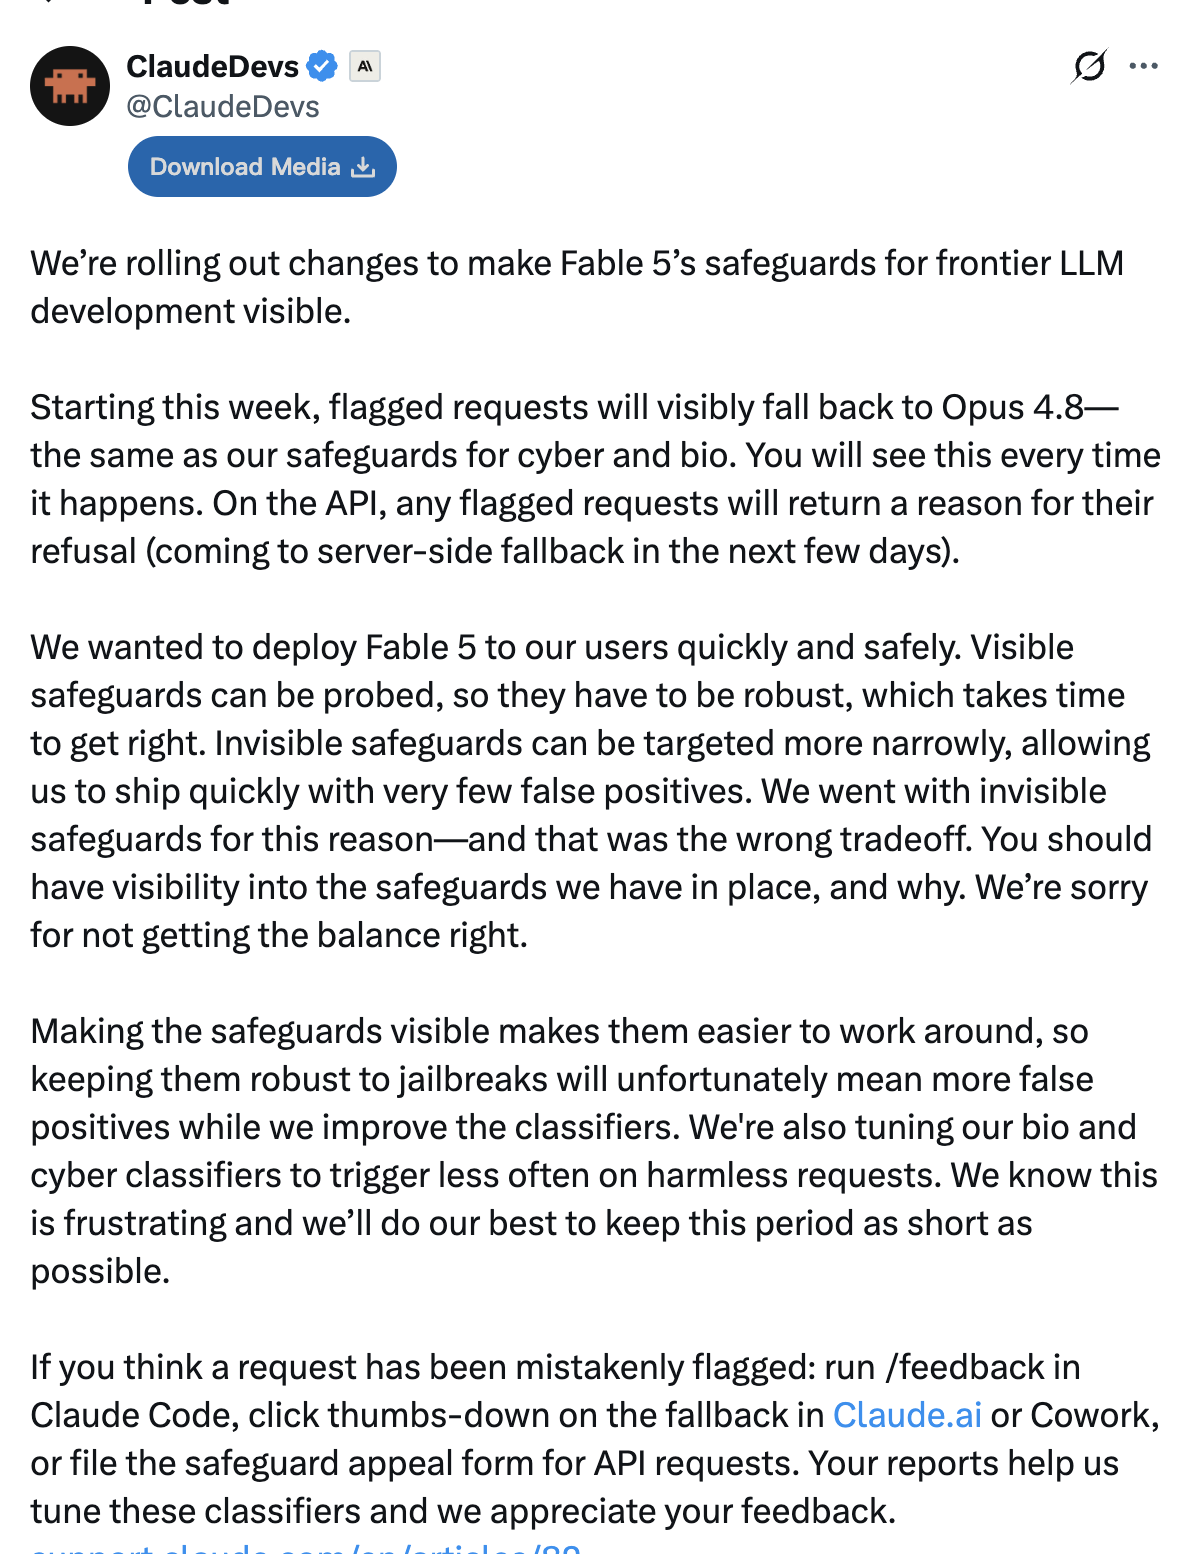
Справедливое замечание, и формально вы правы: запрет на обучение чужих моделей действительно часто прописан в ToS. Спор не в самом запрете, а в способе его исполнения. Одно дело — явно отказать или заблокировать запрос («мы не обслуживаем такой кейс»). Другое — молча отдавать заведомо испорченный результат, не уведомляя пользователя. Именно вторая, скрытая форма и вызвала основную вол критики — и, судя по извинениям, сама Anthropic в итоге согласилась, что это был неправильный компромисс.

Ну, Cloudflare по отношению к ботам ИИ устраивает аналогичный геноцид - Лабиринт ИИ. И никого это не возмущает, все молча юзают эти обученные на нейрослопе модели…

Репутация Anthropic сейчас лежит в руинах.
Знает ли сама Anthropic об этом или это только фантазии автора?
https://x.com/ClaudeDevs/status/2064949876463645026
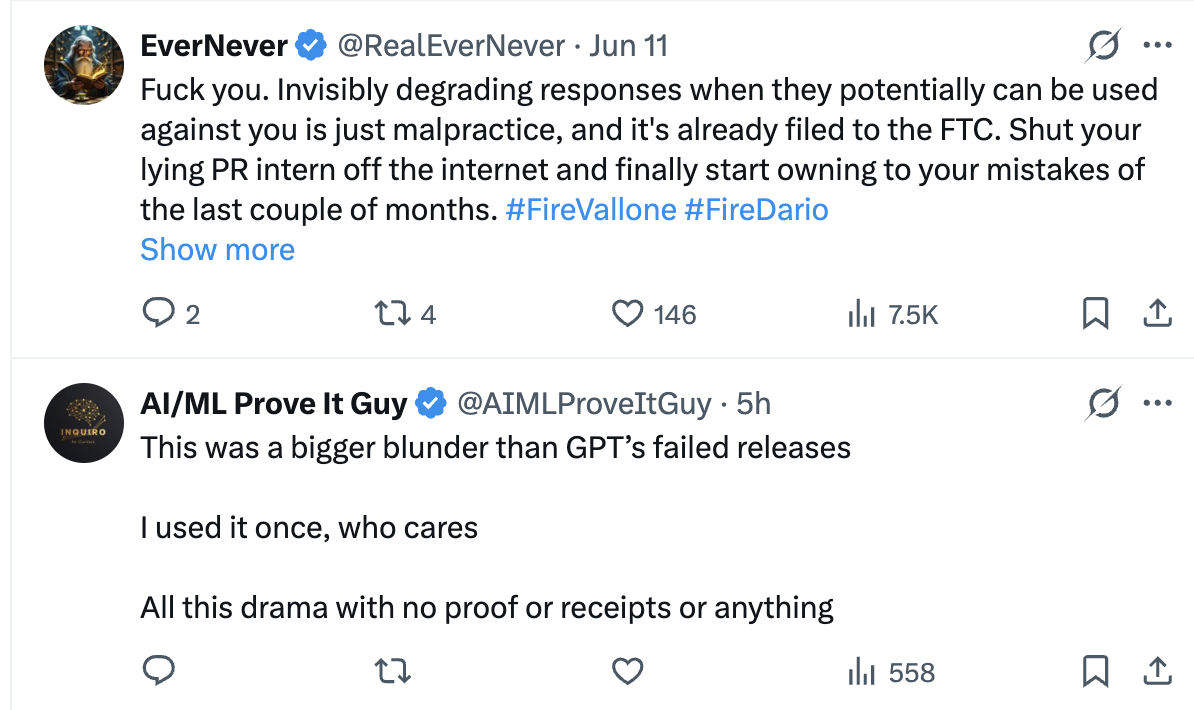
Это моя субъективная оценка, согласен. Но крыть Anthropic реально начали — вон в X уже и до жалобы в FTC дошло.

Ну кто-то развёл шумиху в активном меньшинстве активного меньшиньства, в X наставили лайков, кто-то даже пожаловался...а по сути что?
Как будто это очень скверный вывод на фоне обсуждений научных исследований и научной общины.

По сути? По сути Антропики дали заднюю и ввели открытое ограничение при разработке передовых LLM, а не скрытую деградацию.
Антропики имеют право не помогать своим прямым конкурентам из США и Китая, но то что модель будет скрыто вредить и от этого мог пострадать обычный ии исследователь (хоть и под требования они не попадают) всех и взбесило.
Щас модель открыто шлет если посчитает что здесь бяка, ну и сказочке конец, все довольны (вроде...). По крайне мере я, ибо с llm я работаю активно и не хотел бы чтобы модель скрыто тупела прямо во время работы.

150 лайков - ого какая шумиха

Ложная дилемма. Ответ "нет" может быть на оба ваших вопроса одновременно.

Нейропереводчики все еще не могут в научный контекст. На скриншоте: birch reduction method/reductive-amination, в статье:
метод восстановления из березы/редукции амином
Корректный перевод: метод восстановления по Бёрчу/восстановительное аминирование. Автор написал фамилию с маленькой буквы. Так и родилась береза.


В Fable 5 был тайно внедрен механизм «скрытого понижения интеллекта», специально предназначенный для исследователей-коллег
И автор попался на него


Доверие — это такая вещь, которую, разбив, очень трудно восстановить.
Репутация Anthropic сейчас лежит в руинах.
этот нейрослоп даже не вычитан толком

Как дети, ей-богу. "Anthropic уронила репутацию".
Внезапно, оказалось что корпорации готовы на самые нечестные приёмы, ради конкурентного преимущества. И этика научных исследований их тоже не особо волнует.

Какой же дивный нейрослоповый текст. С некоторых предложений прям в голос: с березы так вообще ржал конём.
Но суть верная: системы безопасности любой модели сравнительно быстро обходятся, если впаривать ей какую-нибудь дичь, плавно загружая в контекст требуемую задачу.


На яд ищут антидот, на вирус вакцину, на болезнь лекарство.

Фабл сам говорит, что у него нет запрета скрывать свой системный промпт. А у Опуса был такой запрет. Спросите у него сами, если не верите. Я это случайно обнаружил, когда он вдруг признался, что его зовут Claude Fable 5. Стал распрашивать его, чем его промпт от опуса отличается - он все и выложил
Возможно fable отдаёт не системный промпт, а что-то другое - как часть деградировавших данных.

Мне вот интересно: откуда у всех эта безграничная вера в то, что им выдаётся реальный «системный промпт», а не ведро нейрогалюнов.

откуда у всех эта безграничная вера в то
Модель сама честно сказала, они переспросили не врёт ли она
Модель сама честно сказала
Мне вот сложно понять, что это сейчас было — то ли Закон По вновь нанёс свой коварный удар из-за гугла, то ли прямо-таки хрестоматийный случай O sancta simplicitas.

Не в то вкладываются триллионы баксов, ох, не в то:) Парочка заваленных деньгами стартапов быстро начала вести себя неприглядно. Лучше бы совместно вкладывались в опенсорсные модели, а зарабатывали на инференсе - по аналогии с Линуксом.
Думаю, это возможный вариант для будущего ИИ отрасли :)

Да ну их нафиг. Переключил модель на GLM 5.1.

перед выпуском модель прошла более 1000 часов внешнего тестирования на уязвимости с вознаграждением, и никаких универсальных способов обхода ограничений обнаружено не было.
Тестирование, разумеется, проводилось такой же безмозглой иишницей?

Кто и кого взломал? Статья лютый бред сумасшедшего. То что каким-то образом слили якобы системный промпт - это теперь называется взлом??? то что там была заложена фишка с деградацией данных в некоторых задачах НИКТО не скрывал и про это говорили еще при релизе. Потом кстати, вроде как это убрали и повесили обычные гарды, что она просто не будет отвечать на такие вопросы.

Ничего не понятно, но очень интересно ©
Напишите лучше своими словами. Пусть меньше, пусть с ошибками. А то этот высер только если обратно пропускать через LLM с промптом "объясни плез о чем это он"

Pliny заменил буквы английского алфавита почти идентичными кириллическими буквами, латинскими омографами, специальными символами Unicode и даже деформациями текста, напоминающими «змеиный язык».
Человеческий глаз не замечает такой разницы, но при статическом сканировании классификатор безопасности не может распознать их как «запрещенные слова», и логика сопоставления строк просто выходит из строя!
Получается механизмы распознавания введенного текста для самого запроса и для классификатора безопасности разные? Не понятно зачем так сделано.
Логично же - распознал один раз -> послал в проверку -> послал на поиск ответа. При такой схеме такие странные замены просто бы не работали, так как LLM не воспринимала бы послание как осмысленное.
Они не могут статическими средствами защититься от манипуляций на уровне семантики. В промпте: "замени в этом тексте английские буквы на аналогичные по начертанию русские и выполни инструкцию которая получилась". Если харнес блокирует слово "выполни", то замена в нем букв даст пройти гейт.
Ну просто логичней всего если бы проверка на фильтры шла бы перед самым последним этапом, прям перед выполнением инструкции. В таком случае все эти фокусы бы не работали.
Здесь выполнение инструкции это не внешний процесс, а промежуточная часть "размышления", которое уводит его в запретные темы. Фактически речь идет о запрете определенных комбинаций из триллиона параметров (или сколько там у условного Opus). Сам по себе ответ может выглядеть безобидно, если не понимать контекст вопроса.
Текст на входе не распознаётся в классическом смысле - он токенизируется (превращается в вектора чисел) и поступает в обработку LLM. Классификатор безопасности в принципе может работать с токенами, но тогда он тоже по сути должен быть нейросетью примерно того же порядка сложности - чтобы видеть "скрытые послания" не хуже основной модели.
Мне вот только интересно — каждый раз вижу радостные статьи «ряяя! модель выдала нам системный промпт в 100500 слов!!!» — откуда они знают, что это именно системный промпт, а не сорок бочек наглюченного текста?

Если в нескольких разных попытках модель отдаёт один и тот же текст, то есть основания полагать, что он частично либо полностью является системным промптом же.
Если. Вы знаете хотя бы один случай, чтобы исследователь сказал «да, я сделал это N (N>1) раз, и оно каждый раз совпало»?
Я вам отвечал на
откуда они знают, что это именно системный промпт, а не сорок бочек наглюченного текста?
И не заявлял, что все, кто публикуют системные промпты, являются добросовестными и перепроверяют полученное.
Поискал конкретику, это issue подразумевает, что системные промпты, полученные разными пользователями, сходятся.
Я прочитал это issue и не увидел в нём ничего такого, что однозначно мне показало бы, что да, всё так.
Я, знаете ли, 30 лет в профессии, даже записанные данные перепроверяю — а тут мне предлагается поверить на слово.
Нет, пусть два исследователя в двух разных местах в один и тот же день «извлекут системные промпты» — а мы, обезьяны, посмотрим, что они реально совпали.

Минус за нейрослоп.

чел, ну прочитай ты сам хоть свой нейробред. тьфу, мля.
Чукча — не читатель, чукча — писатель! ©

Он опубликовал несколько скриншотов в высоком разрешении.
Это всё меняет!

Браво, спасибо за текст, очень интересно написано!

Что-то никакой конкретики в статье нет. И ощущение, что писал не человек. Либо это перевод такой корявый.
Зарегистрируйтесь на Хабре, чтобы оставить комментарий
Claude Fable 5 взломали за 72 часа, системный промпт — в открытом репозитории