Неделю назад я прочитала публикацию Тома Гринвальда в X (бывшем Twitter), где разработчики движка Magnitude рассказали, что можно ускорить модель в несколько раз, не меняя железо. Я использую в своих проектах Qwen3.5 4B.
В таблице бенчмарков Magnitude для Qwen3.5 4B на NVIDIA DGX Spark указано 296 токенов/с против 61,1 у Ollama. Почти пятикратная разница, а в среднем по одиннадцати моделям разработчики получили ускорение decode в 2,17 раза на DGX Spark и 2,19 раза на Mac M4 Pro.
Разработчики объясняют ускорение Magnitude двумя особенностями. Движок подбирает вычислительные ядра (kernels) под конкретную модель и оборудование. Для ускорения генерации также используется DFlash: он предлагает несколько следующих токенов, а основная модель проверяет их. У Ollama тоже есть механизм черновой генерации, но в опубликованном сравнении для Qwen3.5 4B использовался MTP.
Конечно, меня заинтересовал Magnitude. Видеокарты сейчас стоят недёшево, а здесь обещают прибавку производительности без покупки нового GPU.
Давайте проверим, сколько скорости можно получить и какой ценой, если оставить видеокарту и модель прежними, заменив только движок?
Моё оборудование: NVIDIA GeForce RTX 3060 с 12 ГБ видеопамяти, Intel Core i7-12700, 32 ГБ оперативной памяти, Windows 11, WSL2 с Ubuntu 24.04.1 LTS.
Что именно измеряли разработчики Magnitude
На DGX Spark для Qwen3.5 4B разработчики получили ускорение при обработке входного текста (prefill) в 1,47 раза: 2925 токенов/с у Ollama против 4314 у Magnitude. Prefill — этап, на котором модель выполняет вычисления для входных токенов и формирует KV‑кэш. В нём сохраняются промежуточные данные, которые понадобятся при генерации ответа.
Почти пятикратное ускорение, о котором я говорила выше, относится к генерации ответа (decode). На этом этапе модель создаёт ответ последовательно, токен за токеном, используя данные из KV‑кэша.
Разработчики Magnitude использовали для проверки «Моби Дика». Модель получала около 64 тысяч токенов текста и должна была воспроизвести последние 256. Один тип нагрузки: большой вход и маленький выход.
Почему я не стала повторять бенчмарк разработчиков? Они проверили один сценарий: большой вход и короткий ответ фиксированной длины. Такой тест показывает скорость движков при конкретной нагрузке. Но по его результатам нельзя судить, как они поведут себя при других объёмах входа и генерации.
Меня как пользователя интересует, сколько времени я потрачу на выполнение задачи с Ollama и Magnitude. Причём неважно, пишу я код, анализирую документ или делаю что‑то ещё. Я хочу понять, при каких запросах Magnitude действительно сокращает время ожидания, насколько заметна разница и что происходит, когда объём работы меняется.
Поэтому я подготовила двадцать заданий для десяти сочетаний короткого, среднего и длинного входа и выхода. Девять сочетаний охватывали разные объёмы входного текста и генерации, десятое — около 9000 токенов на входе и выходе. Где‑то модели требовалось прочитать большой объём кода и дать короткий ответ, где‑то из небольшой таблицы нужно было построить и вывести большое количество зависимостей. Для каждого задания сравнивала скорость обработки входа, генерации и полное время выполнения запроса через оба движка.
Для каждого задания я фиксировала количество входных и выходных токенов, скорость обработки входа (prefill), скорость генерации (decode), время до первого текста (TTFT) и полное время выполнения запроса. По этим показателям можно сравнить работу движков при разных объёмах нагрузки и увидеть, на каком этапе возникает разница во времени.
У разработчиков для бенчмарка был выключен thinking, использовалась генерация с выбором наиболее вероятного следующего токена. Для каждого запроса они запускали новый процесс и очищали кэш входного текста.
Я тоже отключила thinking, настройки оставила по умолчанию для каждого движка. Модель загружала заранее и выполняла запросы без перезапуска процесса перед каждым заданием, как при обычной работе с локальной моделью.
Подготовка стенда
Движок Ollama 0.40.14 уже был установлен в Ubuntu 24.04.1 LTS (WSL2). Установила испытуемый движок Magnitude 0.2.16 и подготовила Qwen3.5 4B в формате GGUF с четырёхбитным квантованием UD‑Q4_K_XL. Qwen3.5 4B — Unsloth, GGUF. Этот вариант занимает около 2,9 ГБ на диске и подходит для моей RTX 3060 с 12 ГБ видеопамяти. Через оба движка использовала одинаковые веса и квантование, чтобы сравнение не зависело от различий в модели. Другой вариант квантования мог повлиять на скорость и расход видеопамяти.
Контекст задала в 24 576 токенов, максимальную длину генерации ограничила 12 288. Самый большой подготовленный вход занимал 9152 токенов, поэтому вместе с ограничением выхода он помещался в выбранное окно.
Модель загружала заранее и перед основной серией отправляла короткий запрос для прогрева. Время загрузки весов и запуска сервера записывалось отдельно. В сам замер попадала работа уже подготовленной модели.
Перед переходом с Ollama на Magnitude выгружала модель из видеопамяти. При обратном переходе делала то же самое. Движки выполняли запросы последовательно на одной RTX 3060, и во время каждого измерения ресурсы получала одна конфигурация.
Запускала сервер Magnitude через magnitude serve. Дальше со всеми запросами работал Python‑скрипт. Он учитывал различия API Ollama и Magnitude и передавал установленный набор параметров при каждом запросе. Ответы получал потоком: благодаря этому можно было засечь появление первого текста, не дожидаясь окончания генерации.
Ниже показана функция, которая формирует запросы для двух API. Параметры запросов задаются отдельно для каждого движка, а специфичные для Ollama и Magnitude поля задаются в соответствующих ветках.
def payload(engine, config, prompt, max_tokens):
    if engine == 'ollama':
        return config['ollama']['url'], {
            'model': config['ollama']['model'],
            'messages': [{'role': 'user', 'content': prompt}],
            'think': False,
            'stream': True,
            'keep_alive': config['ollama']['keep_alive'],
            'options': {
                'num_ctx': config['context_tokens'],
                'num_predict': max_tokens
            }
        }

    if engine == 'magnitude':
        return config['magnitude']['url'], {
            'model': config['magnitude']['model'],
            'messages': [{'role': 'user', 'content': prompt}],
            'temperature': config['temperature'],
            'top_p': config['top_p'],
            'max_tokens': max_tokens,
            'stream': True,
            'cache_prompt': False,
            'chat_template_kwargs': {'enable_thinking': False},
            'stream_options': {'include_usage': True}
        }

    raise ValueError(engine)
Как подбирала нагрузку
Всего подготовила двадцать заданий, по два для каждого из десяти профилей нагрузки. Движку, в общем‑то, безразлично, просим мы написать тест или исправить программу. Для сравнения скорости важны объём входного текста и количество токенов, которые модель сгенерирует в ответе.
Для короткого входа приготовила задания объёмом от 142 до 296 токенов. Здесь были короткие справки, таблицы квадратов, генерация Python‑кода. Вход небольшой, зато длина ответа могла различаться в десятки раз.
Средние входы занимали от 2143 до 2394 токенов. Использовала технические журналы и записи тикетов. Где‑то нужно было найти конкретную информацию и ответить коротко, где‑то — обработать записи и вывести большую выборку.
Для длинных входов подготовила журналы объёмом от 7451 до 7765 токенов. Здесь тоже проверяла три варианта: короткий ответ, средний и несколько тысяч токенов генерации. Отдельно добавила два задания с входом на 8844 и 9152 токена. В обоих случаях модель должна была сгенерировать около 9000 токенов. Это самая тяжёлая нагрузка в моей серии: большой вход и почти такой же большой выход.
Каждое задание отправляла обоим движкам трижды. В первом раунде начинала с Ollama, во втором с Magnitude, в третьем опять с Ollama. Порядок самих заданий внутри раунда перемешивался, но для обоих движков совпадал.
Порядок запусков формировала функция schedule(). В ней зафиксировала план всей серии и проверяла, что каждое задание будет выполнено трижды через каждый движок, без пропусков и дублирования.
import random

REPEATS = 3
SEED = 20261021

def schedule(tasks):
    ids = [t['id'] for t in tasks]
    planned = []

    for repetition in range(1, REPEATS + 1):
        rng = random.Random(SEED + repetition)
        ordered = ids.copy()
        rng.shuffle(ordered)

        engines = ('ollama', 'magnitude') if repetition % 2 \
            else ('magnitude', 'ollama')

        for engine in engines:
            for tid in ordered:
                planned.append((repetition, engine, tid))

    assert len(planned) == 120 and len(set(planned)) == 120
    return planned
Скрипт сохранял результаты сразу после каждого завершенного запроса. Позже я могла открыть любой повтор и сравнить его с соответствующим повтором второго движка. Так собрался архив со 120 запусками.
Как я измеряла скорость
Для измерений написала скрипт на Python. Он отправлял запрос в Ollama или Magnitude и записывал время. Отдельно засекал, когда появлялся первый фрагмент текста и когда модель заканчивала генерацию.
Оба движка возвращают статистику выполнения запроса. Можно посмотреть, сколько токенов модель получила, сколько сгенерировала и сколько времени потратила на каждый этап. Встроенная статистика относится к отдельному запросу, а мой скрипт собирал её по всей серии из 120 запусков вместе с собственными замерами времени и показаниями GPU.
В сохраненной статистике всех запусков оба движка сообщили нулевое количество кэшированных входных токенов.
Скрипт рассчитывал скорость обоих этапов в токенах в секунду. У Ollama время в API указано в наносекундах, у Magnitude — в миллисекундах, ну а как вы хотели, не всё должно быть просто. Перед расчетами я переводила значения в секунды без промежуточного округления.
К примеру, Ollama в одном запуске сообщила, что выдала 1070 токенов за 14,694 секунды генерации. Это около 73 токенов в секунду. В запуске Magnitude для того же входного задания оказалось 1122 токена за 4,223 секунды, то есть около 266 токенов/с. Количество сгенерированных токенов различается, а скорость каждой генерации можно посчитать отдельно.
Время до появления первого текста (TTFT) тоже сохраняла. Если модель быстро пишет ответ, но долго молчит после отправки запроса, один только decode этого не покажет. В скрипте запускала time.perf_counter() перед отправкой запроса, а при получении первого непустого фрагмента текста записывала прошедшее время в first_text_s.
started = time.perf_counter()
first_text_s = None

with opener.open(
    request,
    timeout=config['request_timeout_seconds']
) as stream:
    for raw in stream:
        event = parse_event(
            engine, raw.decode('utf-8', 'replace')
        )

        if event is None:
            continue

        if event.get('terminal_marker'):
            break

        if event['delta']:
            if first_text_s is None and event['delta'].strip():
                first_text_s = time.perf_counter() - started
Параллельно скрипт опрашивал nvidia-smi примерно каждые 350 мс. Так я отслеживала использование видеопамяти, температуру и частоту GPU. Для сбора показаний написала ResourceSampler. Опрос выполнялся в отдельном потоке:
SAMPLE_INTERVAL_S = 0.35

class ResourceSampler:
    def __init__(self):
        self.samples = []
        self.stop_flag = threading.Event()
        self.thread = threading.Thread(target=self.loop, daemon=True)

    def loop(self):
        while not self.stop_flag.is_set():
            self.samples.append(snapshot())
            self.stop_flag.wait(SAMPLE_INTERVAL_S)

    def __enter__(self):
        self.samples.append(snapshot())
        self.thread.start()
        return self

    def __exit__(self, *exc):
        self.stop_flag.set()
        self.thread.join(timeout=5)
Сам запрос выполнялся внутри with ResourceSampler(). После его завершения мониторинг останавливался, а скрипт обрабатывал собранные показания.
with ResourceSampler() as sampler:
    result = invoke(engine, task['prompt'], cap)

resources = resource_summary(sampler.samples)
baseline = warmup_record['baseline_before_model_load']
Для каждого запроса я определяла максимальный объём занятой видеопамяти по сохраненным замерам. Перед загрузкой модели скрипт отдельно фиксировал исходное значение VRAM, относительно которого рассчитывала прирост после запуска движка.
nvidia-smi показывает общую занятую память видеокарты, включая память других процессов. Поэтому расход Ollama и Magnitude сравнивала с учётом исходного значения.
Что показали запуски
После 120 запусков у меня получилась любопытная картина. Скорость Ollama менялась незначительно, а вот у Magnitude результаты сильно зависели от сочетания длины входа и ответа. Причём нашёлся сценарий, в котором Magnitude быстрее генерировала токены, но сам запрос выполняла дольше.
Сначала посмотрим на все десять профилей. В таблице среднее фактическое время запроса и серверная скорость decode. Для каждого профиля было два задания, каждое запускалось трижды через оба движка.
Сценарий | Ollama, с | Magnitude, с | Decode Ollama, ток/с | Decode Magnitude, ток/с |
|---|---|---|---|---|
Быстрая справка (SS01, SS02) — короткий вход, короткий ответ | 1,55 | 0,57 | 81,0 | 271,2 |
Развёрнутый ответ (SM01, SM02) — короткий вход, средний ответ | 7,27 | 3,08 | 80,2 | 163,8 |
Генерация большого ответа (SL01, SL02) — короткий вход, длинный ответ | 49,74 | 16,36 | 77,1 | 214,0 |
Поиск информации в записях (MS01, MS02) — средний вход, короткий ответ | 1,89 | 1,63 | 80,2 | 134,9 |
Обработка технического журнала (MM01, MM02) — средний вход, средний ответ | 14,04 | 4,02 | 79,4 | 343,3 |
Большая выборка из записей (ML01, ML02) — средний вход, длинный ответ | 37,59 | 14,60 | 77,6 | 253,8 |
Поиск в длинном журнале (LS01, LS02) — длинный вход, короткий ответ | 3,68 | 4,09 | 74,7 | 104,1 |
Анализ длинного журнала (LM01, LM02) — длинный вход, средний ответ | 44,46 | 14,03 | 72,7 | 273,7 |
Подробная обработка большого журнала (LL01, LL02) — длинный вход, длинный ответ | 54,48 | 19,70 | 72,6 | 277,8 |
Экстремальная нагрузка (XX01, XX02) — около 9000 токенов на входе и выходе | 131,31 | 34,19 | 71,0 | 302,0 |
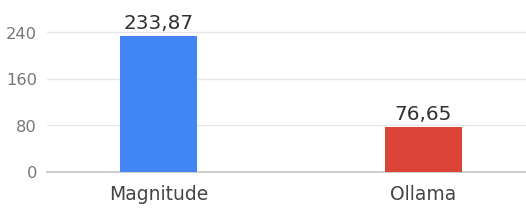
Начну со скорости генерации. По всей серии из 120 запусков средний decode у Ollama составил 76,65 токена/с, у Magnitude — 233,87 токена/с.
Magnitude генерировала токены в 3,05 раза быстрее, прирост средней скорости составил 205%.
Преимущество сохранилось во всех десяти сценариях, но разброс результатов оказался большим. Например, при среднем входе и среднем ответе Magnitude достигала 343 токенов/с, а при длинном входе и коротком ответе — только 104. У Ollama скорость генерации по профилям держалась в пределах 71–81 токена/с.
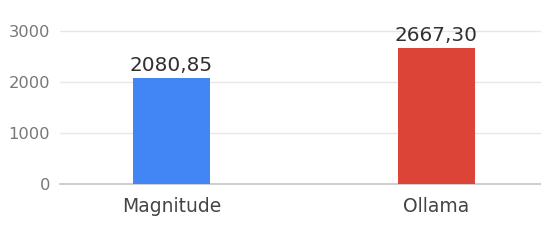
С обработкой входного текста Ollama справлялась быстрее. В среднем её prefill составил 2667 токенов/с против 2081 у Magnitude.
Преимущество Ollama — 28,2%, причём оно наблюдалось во всех десяти сценариях.
На длинных входах разница особенно заметна. Ollama обрабатывала около 3100 токенов/с, Magnitude — примерно 2300. Когда задача предполагает чтение большого документа и короткий ответ, дополнительное время на обработку входа может оказаться важнее скорости последующей генерации.
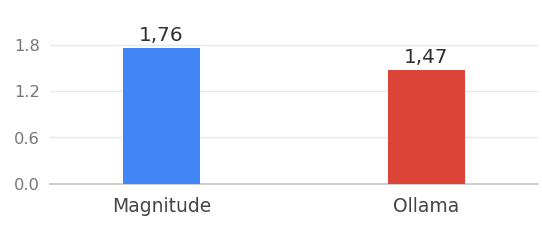
По времени появления первого текста Ollama тоже немного впереди: средний TTFT составил 1,47 секунды против 1,76 у Magnitude.
Ожидание первого текста у Ollama было примерно на 16,7% короче. Но здесь всё зависит от размера входа.
При коротких запросах Magnitude начинала отвечать раньше. Например, в профиле SS первый текст появлялся через 0,19 секунды, у Ollama — через 0,36. Для среднего входа показатели сближались, а на длинном входе преимущество переходило к Ollama. В профиле LS ожидание первого текста составило 2,65 и 3,34 секунды соответственно.
Теперь о полном времени выполнения. В девяти сценариях из десяти быстрее заканчивала Magnitude. Исключением стал длинный вход с коротким ответом. Здесь Ollama выиграла, несмотря на более медленный decode.
В одном из повторов LS01 обе модели получили 7762 входных токена. Ollama выдала 77 токенов за 3,67 секунды, Magnitude — 78 токенов за 4,41. Ответы практически одинаковой длины, поэтому сравнить длительность можно напрямую. И это был не единственный случай: во всех шести запусках профиля LS Ollama закончила раньше.
На коротком входе ситуация совсем другая. В SS01 оба движка выдали ровно по 104 токена. Ollama потребовалось 1,65 секунды, Magnitude — 0,57. Здесь уже Magnitude быстрее и начинала отвечать, и генерировала сам текст.
Для средних ответов нашлись два удобных задания — MM01 и MM02. Во всех трёх повторах они давали одинаковое количество выходных токенов на обоих движках: 1065 и 1008 соответственно. Первый текст появлялся практически одновременно, около секунды. Разница по полному времени составила примерно 3,5 раза в пользу Magnitude.
Ещё показательнее оказался первый повтор SL02, где оба движка сгенерировали по 3300 токенов. Ollama работала 43,84 секунды, Magnitude — 9,34. Почти в 4,7 раза быстрее на одном и том же объёме генерации.
Наконец, экстремальный профиль XX. Два задания содержали 8844 и 9152 входных токена. Модели требовалось сгенерировать 8750 и 9451 токен ответа. Во всех шести парах длина генерации у обоих движков совпала.
На втором повторе XX02 Ollama выдала 9451 токен за 132,39 секунды, Magnitude — за 34,96. Первый текст при этом появился раньше у Ollama: через 2,98 секунды против 4,11. Дальше сработала разница в decode, и Magnitude завершила генерацию значительно быстрее.
На всём экстремальном профиле Magnitude сократила полное время выполнения примерно в 3,84 раза.
Если взять все 120 запусков, среднее фактическое время запроса составило 34,60 секунды у Ollama и 11,23 секунды у Magnitude. Сокращение времени — 67,5%, или ускорение примерно в 3,08 раза.
Откуда у Magnitude такая разница в скорости decode, попробую разобраться по дополнительной статистике DFlash.
DFlash и скорость генерации
В коротком задании SS02 с входом в 268 токенов Magnitude в первом повторе показала около 200 токенов/с, во втором — 307, а в третьем — 271. Задание оставалось тем же, но скорость генерации заметно различалась.
В записях Magnitude сохранились счётчики DFlash. Этот механизм использует черновую генерацию: предлагаются следующие токены, а основная модель проверяет, какие из них можно принять. Если сразу подходит несколько токенов, генерация может идти быстрее.
Для самого быстрого запуска статистика выглядела так: предложено 82 черновых токена, принято 56 — 68,3%. В более медленном повторе принято 50 из 190 предложенных, или 26,3%. Третий запуск оказался посередине по скорости и доле принятых токенов: 52 из 100, или 52%.
Скорость decode | Предложено DFlash | Принято | Доля принятых |
199,938 токена/с | 190 | 50 | 26,3% |
307,345 токена/с | 82 | 56 | 68,3% |
270,566 токена/с | 100 | 52 | 52,0% |
На этих трёх запусках большая доля принятых черновых токенов совпала с более высокой скоростью. В общей серии Magnitude предложила 206 392 черновых токена и приняла 95 942, это около 46,5%.
DFlash всё время был включен. Его точный вклад в ускорение я пока не измерила. Зато теперь есть конкретные показатели, которые можно сравнить в следующей серии, когда отключу механизм и повторю нагрузку.
Сколько видеопамяти потребовалось
Как вы помните, скрипт записывал занятую VRAM до загрузки, а затем сохранял максимальные показания во время каждого запроса.
Что измеряла | Ollama | Magnitude |
Максимально занятая VRAM всей GPU, медиана максимумов по запросам | 4575 МиБ | 6685 МиБ |
Прирост относительно состояния до загрузки | 3936 МиБ | 6067,5 МиБ |
Прирост занятой памяти у Magnitude оказался примерно на 2131,5 МиБ больше. Это около 2,1 ГиБ. До загрузки модели обычно было занято порядка 630 МиБ, затем мониторинг показывал примерно 4,47 ГиБ с Ollama и 6,53 ГиБ с Magnitude.
Если во время работы локальной модели нужно держать в памяти что‑то ещё, такая разница уже существенна. По наблюдавшимся максимумам у Magnitude оставалось около 5,47 ГиБ из 12 ГиБ, у Ollama около 7,5 ГиБ. Это запас на момент наших измерений, а не гарантированное место для любого более длинного запроса.
Видеопамять расходуется и на веса модели, и на рабочие данные. Например, KV‑кэш хранит сведения об уже обработанных токенах, чтобы использовать их при продолжении генерации. С ростом контекста его размер может увеличиваться. Magnitude позволяет менять способ хранения KV‑кэша, в том числе использовать квантование.
В первой серии эти настройки отдельно не переключала. Пока видно, сколько памяти занимает выбранная конфигурация Magnitude, и есть основания проверить, удастся ли уменьшить этот расход без потери полученной скорости.
Что дальше
В первой серии тестов меня озадачил разброс скорости Magnitude. В логах заметила, что доля принятых DFlash‑токенов в этих запусках тоже различалась. Связаны ли эти показатели напрямую, пока неизвестно. Во второй части начну с отключения DFlash. Повторю задания с короткими и длинными ответами, сравню скорость генерации, TTFT и разброс между запусками. Потом проверю квантование KV‑кэша: сколько видеопамяти получится освободить и как это скажется на производительности. Отдельно попробую запустить DFlash вместе с квантованным KV‑кэшем.
Всё‑таки дополнительные 2,1 ГиБ VRAM на видеокарте с 12 ГБ памяти — серьезный расход. А если удастся его сократить, останется проверить, сколько от нынешнего ускорения Magnitude при этом сохранится.
НЛО прилетело и оставило здесь промокод для читателей нашего блога:
-15% на заказ нового VDS — HABRFIRSTVDS.