Обновить
32K+

Серверная оптимизация *

Разгружаем сервер

50,31
Рейтинг
Сначала показывать
Порог рейтинга
Уровень сложности
Формат публикации

Microsoft выпустила Windows Server 2028

Время чтения2 мин
Охват и читатели6K

На конференции Ignite 2026 компания Microsoft официально анонсировала Windows Server 2028 — следующий крупный релиз своей серверной операционной системы, который переходит на стадию публичного предварительного тестирования.

Читать далее

Теперь ничто не мешает программам быть быстрыми

Уровень сложностиСредний
Время чтения20 мин
Охват и читатели13K

На днях мне попался ставший вирусным твит, в котором говорилось, что люди, жалующиеся на то, что большие языковые модели (LLM) порождают медленный и раздутый код, ещё будут кусать локти, когда всё перепишут на сверхоптимизированном ассемблере. Мы пока не настолько продвинулись, чтобы захотеть писать всё на ассемблере, но нечто похожее на то, что Нолан Лоусон сказал о тестировании (теперь вы сами можете выбирать, сколько ошибок вам нужно), а я сформулировал менее изящно, становится всё более справедливым и в отношении производительности.

В ответ на комментарий к моей предыдущей статье о том, что стоимость работ по оптимизации производительности, которые раньше требовали узкоспециализированных навыков, снизилась на многие порядки, а задачи, для которых прежде требовался специалист или целая команда с редким набором компетенций, теперь может выполнять любой, кто способен набрать несколько предложений1, и значит, теперь можно применять самые разные оптимизации, которые раньше были слишком дороги и не окупались нигде, кроме крупнейших или наиболее прибыльных проектов, Марк Брукер ответил следующим образом:

Полностью согласен с вашим заключительным тезисом. Вполне вероятно, что в итоге мы придём к динамически создаваемому специализированному ПО, подогнанному под конкретную рабочую нагрузку, а не под целый класс нагрузок. (А это, в свою очередь, открывает массу интересных возможностей и несёт самые разные риски.) Это чем-то напоминает мне FFTW. А ещё — множество необычных старых трюков демосцены, суть которых заключалась в том, чтобы добиться максимальной скорости и компактности при решении какой-то одной очень специфической задачи (зачастую ещё и на конкретном оборудовании). Например, помню одно демо, в котором код использовался ещё и в качестве текстур, чтобы добиться высокой локальности данных в кэше.

Читать далее

Как ускорить локальную LLM на 50% без покупки новой видеокарты

Уровень сложностиСредний
Время чтения8 мин
Охват и читатели17K

На GTC Berlin 2026 участники воркшопа NVIDIA смогли ускорить генерацию Qwen3-32B с 16,4 до 24,5 токена в секунду, не меняя оборудование. Для этого использовали FP8 вместо BF16. Общая пропускная способность тоже выросла, хотя и заметно меньше: с 639 до 719 токенов в секунду.

Эксперимент проводили на Kubernetes-кластере с четырьмя NVIDIA A100 по 80 ГБ. У каждого участника был собственный кластер, на котором можно было разворачивать модели, менять конфигурацию и измерять производительность.

Помимо квантизации, на занятии разбирали NVIDIA Dynamo, маршрутизацию запросов с учётом KV-кеша, автоматическое масштабирование и разделение prefill/decode между GPU.

Материал основан на статье инженера Siim Tolk, опубликованной 4 ноября 2026 года.

Читать далее

Кэширование в Redis: типичные ошибки, которые превращают ускорение в деградацию

Уровень сложностиСложный
Время чтения5 мин
Охват и читатели7.4K

Вы добавили Redis, замерили p95 — стало быстрее. Прошла неделя, и карточка товара снова грузится секундами, а база почему‑то получает в разы больше запросов, чем до кэширования. Проблема не в Redis. Проблема в том, как вы его используете. Разбираем типичные антипаттерны cache‑aside — от «горячего ключа» до гонки при инвалидации — и показываем, как их диагностировать командами SLOWLOG и INFO.

Читать далее

Ложное срабатывание пожарной сигнализации едва не погубило нью‑йоркский дата‑центр Jane Street

Время чтения2 мин
Охват и читатели6.3K

Один из крупнейших маркетмейкеров на Уолл‑стрит Jane Street чуть не лишился единственного дата‑центра в Нью‑Йорке из‑за ложного срабатывания системы пожарной сигнализации. Об этом рассказал бывший участник команды системных администраторов.

Читать далее

AMD тестирует технологию MEXT для использования данных из DRAM на SSD

Время чтения5 мин
Охват и читатели6K

AMD тестирует технологию MEXT, которая обеспечит производительность на уровне 99% от максимума при использовании вдвое меньшего объёма оперативной памяти (DRAM) — при условии, что вместе с новым сервером на базе процессора Epyc приобретается лицензия на программное обеспечение.

Читать далее

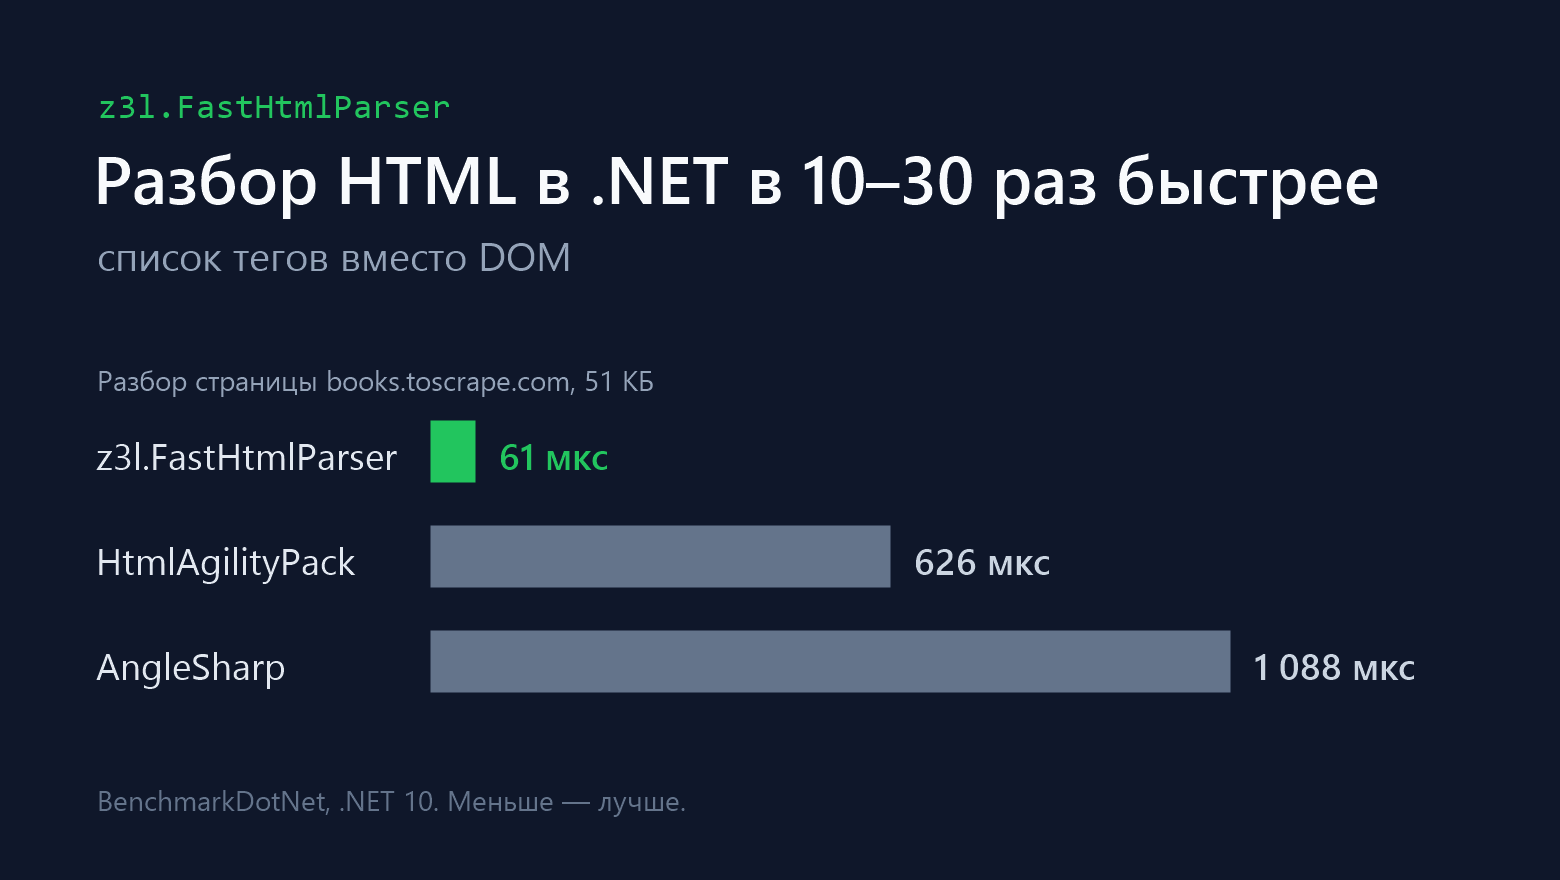
Как разбирать HTML в 10–30 раз быстрее HtmlAgilityPack и AngleSharp: список вместо DOM

Уровень сложностиСредний
Время чтения8 мин
Охват и читатели7.1K

Много лет занимаюсь парсингом: каталоги, цены, карточки товаров, объявления. Всё это время из проекта в проект кочевал мой самописный HTML-парсер. Он стабильно работал на миллионах страниц, но показывать его наружу было как-то неловко: тесты покрывали только нужные мне сайты, комментарии были на двух языках вперемешку, документации не было вовсе. Появилась иишка и доделала то что мне было лень и я выложил nuget: z3l.FastHtmlParser

Ниже разбираемся, почему стандартные библиотеки на таких задачах впустую тратят процессорное время, как уйти от аллокаций DOM и где проходят границы применимости легковесного подхода.

Почему DOM избыточен для парсинга

Парсинг — это работа с объёмами. Когда через сервис проходят миллионы страниц в сутки, разбор разметки оказывается самым горячим циклом, а затраты на серверы растут пропорционально.

Лидеры рынка в .NET — HtmlAgilityPack и AngleSharp — отличные библиотеки, но решают более общую задачу браузерного уровня. Они строят полноценный DOM: создают отдельный объект на каждый узел, достраивают неявные <html>, <head>, <tbody>, держат дерево для мутаций и обхода CSS-селекторами.

Для извлечения данных почти ничего из этого не нужно. Задача простая: найти элемент, забрать текст или значение атрибута и перейти к следующей странице. Всё остальное превращается в лишнюю работу процессора и сборщика мусора (GC).

Отсюда простая идея: не строить то, что не будет использовано. Документ можно представить как просто список кусков исходной строки.

Бенчмарки

Тестовый стенд: BenchmarkDotNet 0.15.8, .NET 10, Intel Xeon E-2236, Windows Server 2025. Страницы настоящие, сохранённые с books.toscrape.com, quotes.toscrape.com и webscraper.io/test-sites. Версии библиотек: AngleSharp 1.10.0, HtmlAgilityPack 1.13.1.

Читать далее

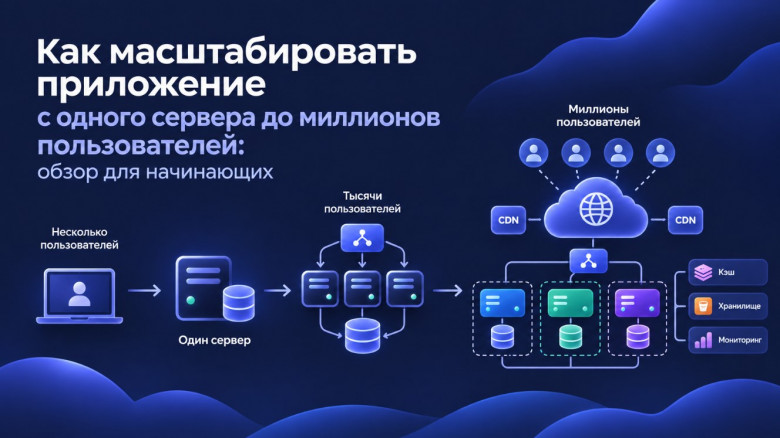
Как масштабировать приложение с одного сервера до миллионов пользователей: обзор для начинающих

Уровень сложностиСредний
Время чтения21 мин
Охват и читатели7.9K

В момент запуска ваш сервер может обслуживать совсем немного пользователей — вас и несколько десятков клиентов. Но если вы работаете над своим проектом долго, то постепенно растёт нагрузка: через месяц — 100 человек, через полгода — уже сто тысяч. А потом может случиться вирусный рост, и ваш сервер просто перестанет справляться с нагрузкой из-за миллионов запросов. Именно на этом переломном моменте обычный план по самому обычному деплою сервера уже перестаёт работать. База данных может начать захлёбываться, пользователи видят бесконечные экраны загрузки или, чего похуже, сообщения об ошибках, и проблемы в логике.

Проблема здесь может состоять не только в качестве кода, но и в архитектуре, рассчитанной на один сервер, которая физически не может масштабироваться для миллионов пользователей. И увы, апгрейд характеристик сервера не всегда помогает. В этой статье я расскажу о первых азах System Design — проектировании систем — для начинающих и продвинутых разработчиков, которые хотят перейти на новый уровень профессионализма. Мы пройдём путь от одного сервера до отказоустойчивой инфраструктуры, обслуживающей миллионы пользователей, с опорой на современные подходы и реальные кейсы. Вперёд!

Читать далее

Как переписанная libc Zig замедлила SQLite в 12 тысяч раз

Время чтения5 мин
Охват и читатели104K

В 2001 году Джоэл Спольски, сочинения которого сильно повлияли на мою карьеру, написал великолепную статью Back to Basics. Суть её заключается в том, что практикующим программистам нужно разбираться в основах: какой бы абстрактной и далёкой от базовых алгоритмов ни казалась наша работа, от них неожиданно глубоко зависят наши проекты.

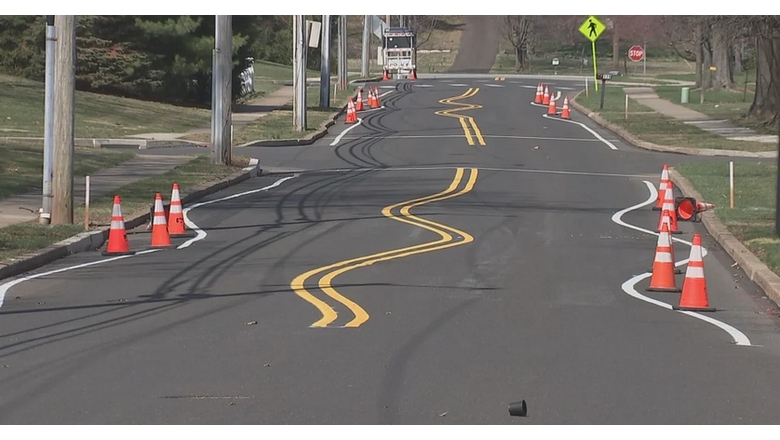
В качестве одного из примеров подобного Джоэл приводит ловушку «маляра Шлемиля», в которой кажущийся простым выбор приводит к квадратичной временной сложности. В притче о Шлемиле маляр, рисующий линии на дороге, не носит с собой банку с краской. Он движется вперёд, и ему приходится всё больше времени тратить на то, чтобы вернуться к банке.

Удивительно, насколько часто паттерн маляры Шлемиля встречается даже в 2026 году.

Читать далее

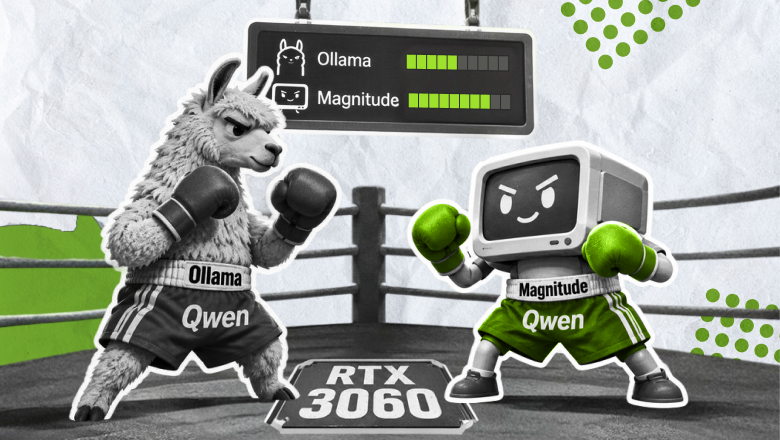
Ollama против Magnitude на RTX 3060: проверяю ускорение на своей видеокарте

Уровень сложностиПростой
Время чтения14 мин
Охват и читатели6K

Неделю назад я прочитала публикацию Тома Гринвальда в X (бывшем Twitter), где разработчики движка Magnitude рассказали, что можно ускорить модель в несколько раз, не меняя железо. Я использую в своих проектах Qwen3.5 4B.

В таблице бенчмарков Magnitude для Qwen3.5 4B на NVIDIA DGX Spark указано 296 токенов/с против 61,1 у Ollama. Почти пятикратная разница, а в среднем по одиннадцати моделям разработчики получили ускорение decode в 2,17 раза на DGX Spark и 2,19 раза на Mac M4 Pro.

Разработчики объясняют ускорение Magnitude двумя особенностями. Движок подбирает вычислительные ядра (kernels) под конкретную модель и оборудование. Для ускорения генерации также используется DFlash: он предлагает несколько следующих токенов, а основная модель проверяет их. У Ollama тоже есть механизм черновой генерации, но в опубликованном сравнении для Qwen3.5 4B использовался MTP.

Конечно, меня заинтересовал Magnitude. Видеокарты сейчас стоят недёшево, а здесь обещают прибавку производительности без покупки нового GPU.

Давайте проверим, сколько скорости можно получить и какой ценой, если оставить видеокарту и модель прежними, заменив только движок?

Моё оборудование: NVIDIA GeForce RTX 3060 с 12 ГБ видеопамяти, Intel Core i7-12700, 32 ГБ оперативной памяти, Windows 11, WSL2 с Ubuntu 24.04.1 LTS.

Читать далее

Аутентификация «Dual JWT». Минимум ресурсов при высокой безопасности

Уровень сложностиСредний
Время чтения15 мин
Охват и читатели5.2K

В статье — вариант реализации стандарта OAuth 2.0 (RFC 6749).
Цель схемы «Dual JWT» — минимизировать потребление ресурсов инфраструктуры при сохранении достаточно высокого (но не максимального) уровня безопасности. Разберём, как устроена схема аутентификации, параметры её безопасности, а также экономику решения: за счёт чего схема снижает затраты (FinOps).
Суть схемы: access в заголовке + refresh в cookie, оба — stateless-JWT, плюс deny list в Redis для отзыва сессий.

Читать далее

5G в России: что на самом деле запустили, и новшество ли это

Уровень сложностиПростой
Время чтения7 мин
Охват и читатели14K

11 сентября 2026 года в России официально запустили 5G, а через шесть дней журналисты прошли по Москве со спидтестом и в большинстве точек намерили скорости LTE, а местами даже ниже. И зачем нужна была эта помпезность…

Я постоянно вижу, как знакомые восторженно радуются значку 5G, и меня это трогает, ведь я когда-то был связан с телекомом… В связи с этим, под катом с технической стороны объясню, что именно у нас запустили, чем настоящий 5G отличается от быстрого LTE, и что пятое поколение принесло/принесет сисадмину.

Читать

Как восстановить сервис, если облачный регион отключился целиком

Уровень сложностиСредний
Время чтения9 мин
Охват и читатели8.2K

Реплика в соседней зоне, регулярные снапшоты, настроенные бэкапы — кажется, к аварии готовы. Но что произойдёт, если облачный регион отключится целиком, а резервные копии останутся внутри него? На примере октябрьских сбоев Yandex Cloud разбираемся, почему привычные схемы отказоустойчивости не всегда спасают, сколько на практике занимает восстановление и как подготовить инфраструктуру к потере целого региона.

Изучить план действий

Ближайшие события

Незначительные значительные улучшения в Zabbix 8.0

Уровень сложностиСредний
Время чтения9 мин
Охват и читатели7.6K

В презентациях, посвященных Zabbix 8.0, много внимания уделяется APM, OpenTelemetry, ClickHouse и интеграциям через MCP. Но для администратора системы мониторинга не менее важны другие вопросы: как сервер переживает перезапуск, что происходит с накопленными данными прокси-сервера и как открыть доступ команде только к настройкам тех прокси, которые работают именно в их филиале.

Меня зовут Антон Касимов, я работаю в Gals Software, провожу тренинги по Zabbix и веду телеграм-канал Zabbix Recipes. В предыдущей статье я разобрал хранение истории в ClickHouse. Здесь посмотрим на менее заметные изменения: кэши, housekeeping, DNS, SNMPv3, права доступа к прокси и работу с секретами.

Погнали!

Читать далее

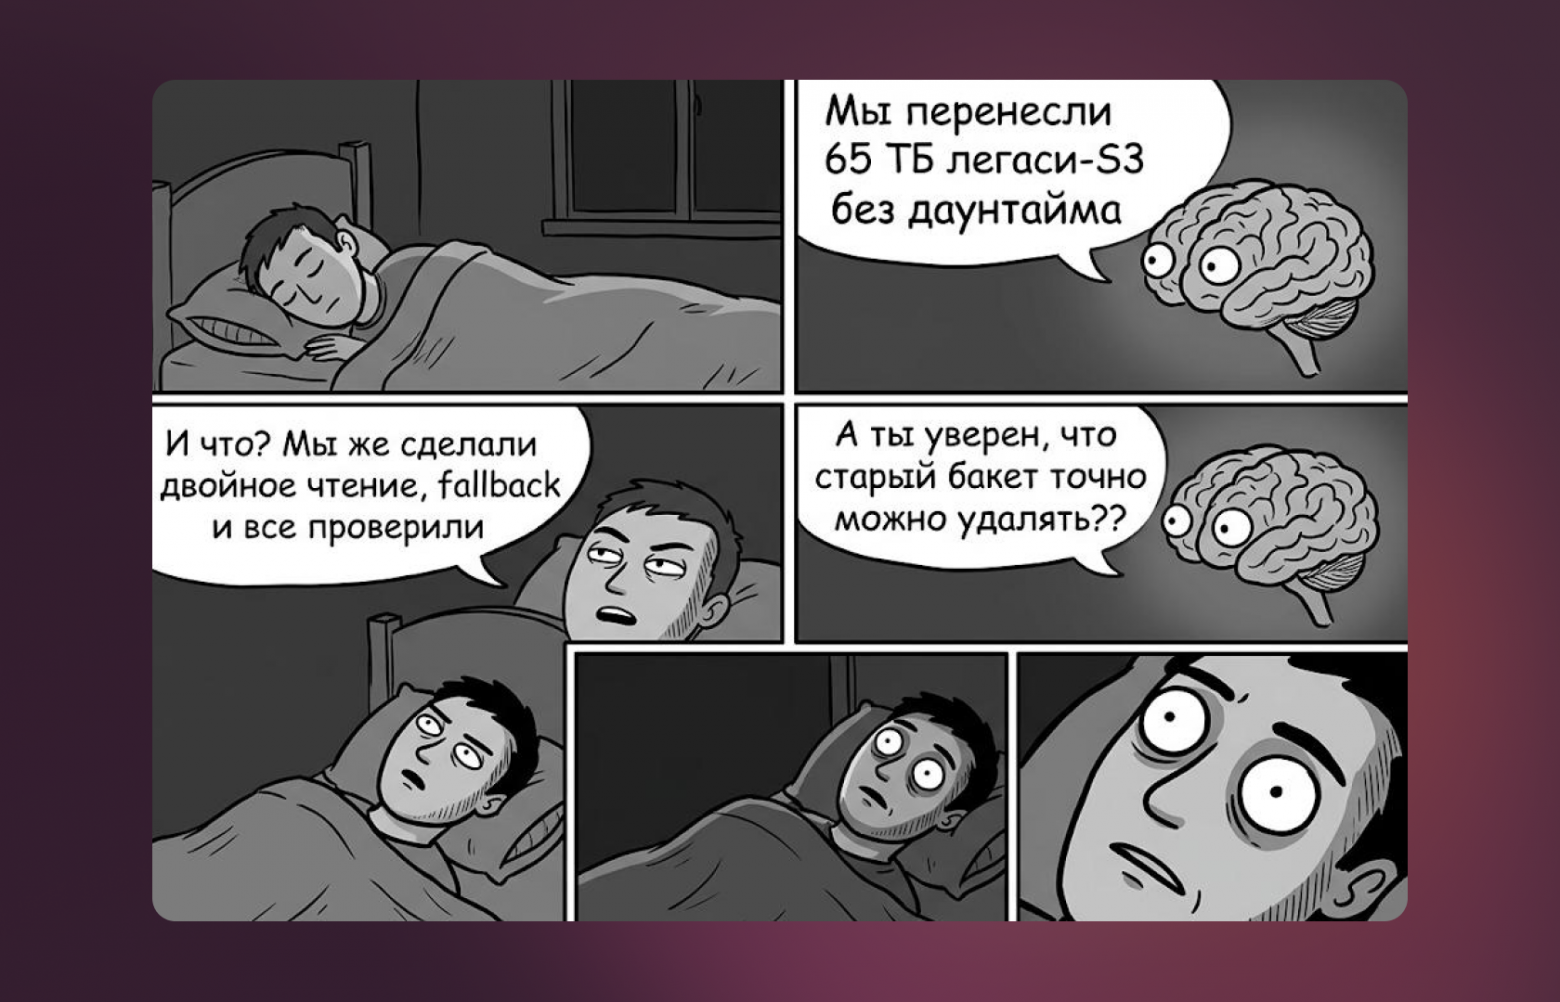
Удалять или не удалять? Как мы перенесли 65 ТБ легаси-S3 без downtime

Время чтения9 мин
Охват и читатели5.8K

У нас есть production S3-хранилище, которое годами переживало разные поколения сервисов, интеграций и команд. В какой-то момент в нем накопилось больше 65 ТБ данных и десятки миллионов объектов, а стоимость хранения превысила 150 тыс. рублей в месяц.

В статье я расскажу, как мы восстановили карту хранилища, организовали миграцию без остановки сервиса и сократили объем данных примерно с 65 до 45 ТБ.

Читать далее

Виртуальная электростанция для Google: как получить гигаватт мощности для дата‑центров

Время чтения3 мин
Охват и читатели5.7K

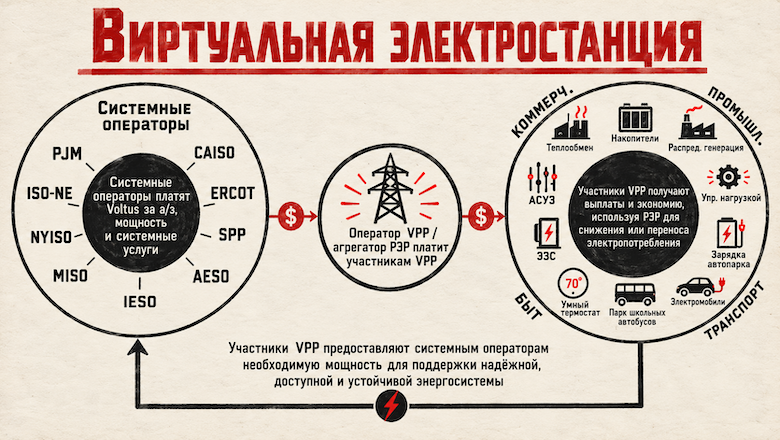
Google заключила соглашение с американской компанией Voltus о создании виртуальной электростанции мощностью около 1 ГВт. Суть идеи неожиданная: вместо строительства новой электростанции Google будет платить за то, чтобы тысячи домов и предприятий временно сокращали потребление электричества в часы максимальной нагрузки.

Большинство таких переключений можно выполнять автоматически. Участники получают денежные выплаты или скидки на электроэнергию, Voltus зарабатывает на организации процесса, а Google оплачивает мощность, которая становится доступной энергосистеме благодаря снижению спроса.

В этом и отличие идеи виртуальной электростанции от электростанции «классической»: речь идёт не о новом гигаватте непрерывной генерации, а о том, что благодаря применяемым мерам пояляется возможность снизить нагрузку всей энергосистемы примерно на такую величину в нужный момент — и использовать освободившийся задел в интересах Google. Такой подход помогает энергосистеме обслуживать новых крупных потребителей, в том числе дата‑центры Google, не наращивая генерирующие мощности исключительно ради кратковременных пиков.

Читать далее

НКЦКИ при ФСБ потребовал срочно обновить PHP. Тем, кто не успевает, предложено отключить сайты

Время чтения5 мин
Охват и читатели74K

Национальный координационный центр по компьютерным инцидентам (НКЦКИ), действующий при ФСБ России, направил операторам критической информационной инфраструктуры требование срочно устранить две критические уязвимости PHP. Если установить исправления оперативно невозможно, организациям предписано рассмотреть ограничение внешнего доступа к уязвимым серверам вплоть до их полного отключения. Об этом 22 октября сообщил РБК со ссылкой на письмо НКЦКИ, подлинность которого подтвердили три организации-получателя.

Предупреждение разослано через государственную систему ГосСОПКА и касается информационной инфраструктуры государственных органов, банков, операторов связи, энергетических, транспортных, медицинских и других организаций. Помимо обновления PHP, получателям предписано провести антивирусную проверку серверов, изучить журналы на предмет возможного взлома и сообщать о подозрительных инцидентах. Аналогичные рекомендации распространили центры кибербезопасности других стран, однако в России ситуация примечательна ещё и тем, что указания по обновлению конкретного программного обеспечения поступают непосредственно от структуры ФСБ.

Поводом стали две уязвимости, CVE-2026-109618 и CVE-2026-109619, получившие общее название PHP2Shell. Обе оцениваются в 9,2 балла по шкале CVSS 4.0 и при определённых условиях позволяют выполнять произвольный код на сервере без авторизации. Разработчики PHP 21 октября выпустили исправления в версиях 8.2.35, 8.3.36, 8.4.27 и 8.5.12, плюс отдельного упоминания заслуживает работа чешского разработчика Ондржея Суры (Ondřej Surý), сопровождающего популярные репозитории PHP для Debian и Ubuntu: он опубликовал обновления сразу для 12 веток PHP, включая давно неподдерживаемые версии 5.6, 7.0–7.4 и 8.0–8.1.

Читать далее

Представлен программно‑аппаратный AI KV‑cache offloading от «Тантор Лабс» с управлением в платформе «Боцман»

Время чтения4 мин
Охват и читатели5K

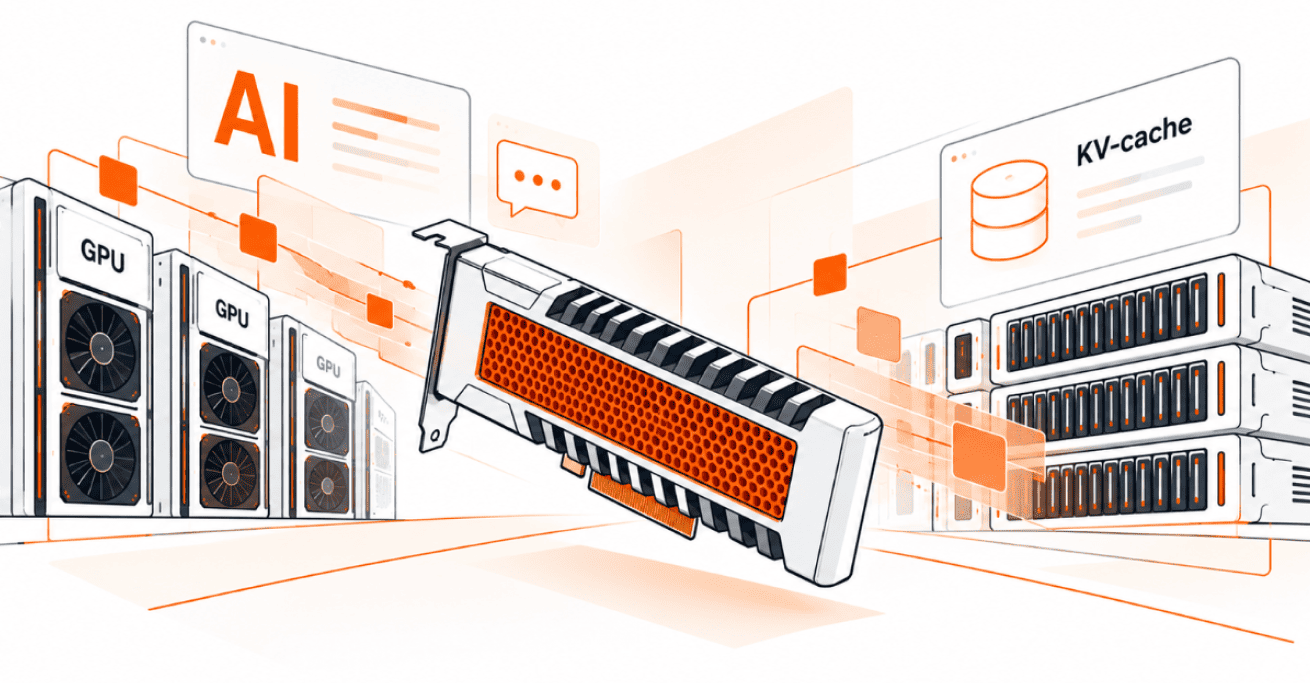
«Тантор Лабс» и разработчик платформы контейнеризации и управления ИИ-инфраструктурой «Платформа Боцман» представили новую программно-аппаратную технологию хранения кэша ключей и значений (KV-cache) без использования памяти DRAM. В отличие от решений с программной оптимизацией кэширования, уникальная для российского рынка технология работает на уровне специализированного оборудования и позволяет использовать для кеша нейросетей специализированное NVMe-хранилище контекстной памяти (context memory storage), снижая зависимость от ограниченного объёма дорогостоящей HBM-памяти GPU и DRAM. Это резко увеличивает число одновременно обслуживаемых пользователей, ускоряет инференс и сокращает задержки обработки запросов, масштабируя корпоративные ИИ-сервисы без пропорционального увеличения количества ускорителей. При этом скорость доступа к данным сопоставима с показателями памяти DRAM, но с более низкой стоимостью за терабайт.

Читать далее

Какие доклады участники INFOSTART TECH EVENT 2026 оценили выше всего

Уровень сложностиПростой
Время чтения3 мин
Охват и читатели5.8K

Прошло уже 10 дней с завершения нашей конференции и мы собрали первые данные от участников - самыми интересными были признаны два очень «железных» доклада: про лишние индексы и про загрузку процессора. Сразу за ними идёт честная проверка «1С:Напарника» в работе. Если вы не успели на всё, что хотели, или выбираете, какие записи посмотреть, этот рейтинг поможет.

Конференция прошла 8–10 октября в Петербурге. Собрались разработчики, архитекторы, тестировщики и руководители технических команд. Говорили о разработке на «1С:Предприятии», интеграциях, эксплуатации, DevOps и управлении командами.

Подборку мы собрали по взвешенному рейтингу со страницы обратной связи, данные на 20 октября. В неё вошли только доклады. Круглые столы, мастер-классы и другие интерактивные форматы оценивались отдельно. Рядом с рейтингом указаны средний балл и число оценок: так видно, насколько массовым было мнение зала.

Читать далее

GraphQL для ИИ‑агента: как мы превращаем GraphQL операции в MCP‑инструменты

Уровень сложностиСредний
Время чтения13 мин
Охват и читатели6.9K

Привет! На связи Данил, TypeScript‑разработчик в команде Platform V DataSpace в СберТехе. DataSpace — это модуль платформы для визуальной (low‑code) разработки бизнес‑приложений и управления данными. Он предоставляет GraphQL API для работы с базой данных. Мы развиваем продукт уже несколько лет, но сейчас из‑за бурного развития ИИ и MCP появилась вполне ожидаемая задача: подключить этот API к ИИ‑агентам через Model Context Protocol (МСP).

MCP нужен, чтобы ИИ‑клиент мог обнаруживать инструменты, понимать их входные параметры и вызывать внешние системы через стандартный протокол. На первый взгляд GraphQL хорошо подходит на роль источника MCP‑инструментов: схема уже описывает типы, входные аргументы и форму результата, но сама по себе не отвечает на главный вопрос: «какую часть API и с каким уровнем свободы следует открыть агенту?».

В DataSpace сценарий получился таким:

- есть API GraphQL поверх модели данных;

- есть ИИ‑агент, которому нужно выполнять прикладные действия;

- между ними нужен MCP‑адаптер;

- команда бэкенда хочет сохранить контроль над контрактом, типами и безопасностью.

Вопрос оказался не в том, можно ли подключить GraphQL к MCP. Можно. Интереснее другое: какой формы должен быть MCP‑адаптер для API GraphQL?

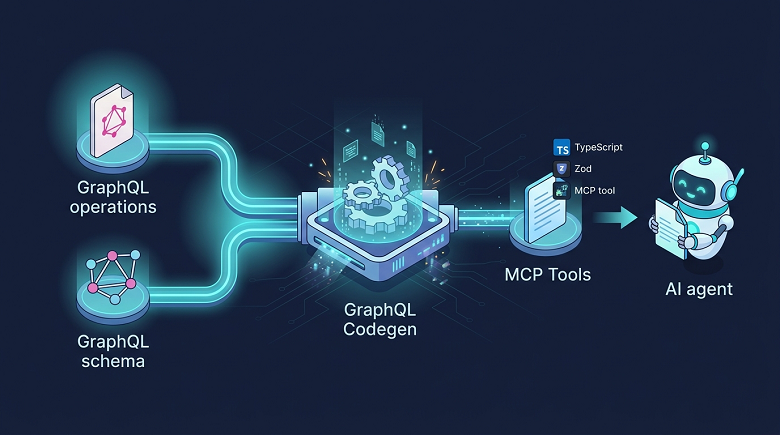
В этой статье я расскажу про несколько вариантов таких адаптеров и про наш выбор: генерировать MCP‑инструменты из заранее подготовленных GraphQL-операций.

Читать далее
1
23 ...