Комментарии 126

с памятью, системными вызовами и блокировками ввода‑вывода операционной системы;
с конкурентными транзакциями, гонками данных и аномалиями в базах данных;
с сетевыми задержками, каскадными сбоями и отсутствием идемпотентности при повторах;
с уязвимостями бизнес‑логики (IDOR/BOLA), утечками секретов и лицензионной чистотой;
с наблюдаемостью (Observability), когда упавший в два часа ночи сервис нужно диагностировать не по
console.log, а по трейсам и метрикам.
Для того чтобы нейросеть учитывала эти моменты, ее надо этим озадачить.
А не требовать того, чего не было в промпте.

Для того, чтобы озадачить нейросеть этими вопросами, необходимо научиться порождать соответствующие (обучающие) данные и, вообще говоря, предложить адекватный способ описания программных архитектур и их свойств, то есть — решить фундаметальную проблему программной инженерии. Но если решить такую проблему, то разработка любой программной системы будет изображаться детерминированным движением (траекторией) в пространстве систем.
Ну а как "кожаные" программисты этому обучались, откуда они знают о памяти, системных вызовах и далее по списку?
Ну и ответ Gemini
Главная ошибка автора цитаты в том, что он оценивает ИИ как «одноразовый генератор кода» (автокомплит), в то время как индустрия давно перешла к агентным системам (AI Agents).
Давайте разберем каждый пункт из цитаты: насколько правы критики ИИ и где они ошибаются.
Анализ утверждений: где ИИ пасует, а где справляется
Критерий из цитаты
Реальность на сегодня
1. Память, системные вызовы, блокировки ОСДа, при явном запросе
Современные ИИ отлично знают внутреннее устройство ОС, принципы работыepoll/kqueue, управление памятью в C/Rust/Go. Если попросить ИИ написать «высоконагруженный сетевой сервер с учетом минимизации системных вызовов», он применит пул потоков, zero-copy буферы и неблокирующий ввод-вывод.
2. Конкурентные транзакции, гонки данных, аномалии БДДа, в рамках куска кода
ИИ прекрасно генерирует код с использованиемSELECT FOR UPDATE, оптимистичных блокировок или уровней изоляции транзакций (Serializable). Однако ИИ может «проглядеть» гонку данных в сложной, распределенной системе, если у него нет полной архитектурной картины.
3. Сетевые задержки, каскадные сбои, идемпотентностьДа, через паттерны
Если задача сформулирована инженером, ИИ без проблем реализует паттерны Circuit Breaker (предохранитель), Retry с экспоненциальной задержкой и джиттером, а также добавитidempotency-keyв API. Но сам по себе базовый ИИ не знает, что ваша сеть «мигает» — об этом ему должен сказать архитектор.
4. IDOR/BOLA, секреты, лицензии Частично
Секреты (токены) ИИ сегодня прятать умеет (выносит в.env). С лицензиями сложнее — ИИ может выдать код, похожий на GPL, в коммерческий проект. Уязвимости бизнес-логики (вроде IDOR, когда юзер меняет id в URL и видит чужие данные) ИИ часто пропускает, так как не понимает контекста всей компании, если ему его не описать.
5. Наблюдаемость (Traces, Metrics, Logs)Да, легко
Написать код, который интегрирован с OpenTelemetry, Prometheus метриками и Jaeger трейсами — для ИИ тривиальная задача. Проблема лишь в том, что разработчики часто забывают попросить ИИ добавить телеметрию в промпте.В чем ключевая системная ошибка этого утверждения?
Автор цитаты описывает ИИ образца 2022-2023 годов, который просто «угадывал» следующую строчку кода. Современная программная инженерия с ИИ строится иначе:
Контекст решает всё: Если дать ИИ доступ к вашему репозиторию (как это делают кастомные агенты или продвинутые IDE), он видит конфигурацию инфраструктуры, базы данных и логирования. Он пишет код с учетом того, что в проекте уже используется Datadog или PostgreSQL.
ИИ как исполнитель, человек — архитектор: Физическую действительность (сеть, диски, нагрузки) в модель закладывает человек. Настоящий Software Engineer не просит ИИ: «Напиши мне функцию сохранения юзера». Он просит: «Напиши микросервис на Go, который выдержит 10k RPS, будет использовать пул соединений, писать метрики в Prometheus и обрабатывать сетевые таймауты через контексты». И ИИ выдает именно такой код.
Агентный подход (Тестирование и запуск): Современные ИИ-разработчики умеют сами запускать тесты, анализировать логи ошибок в контейнерах и исправлять свой же код, если упал интеграционный тест. То есть они буквально сталкиваются с «суровой физической действительностью» в CI/CD.
Итог
Цитата права в одном: ИИ сам по себе не обладает интуицией реального мира. Если дать ему абстрактную математическую задачу, он решит её в «стерильных» условиях.
Но утверждать, что ИИ не может учитывать блокировки, трейсы или каскадные сбои — неверно. Современный ИИ знает об этих проблемах всё и умеет от них защищаться. Но чтобы он это сделал, у руля всё еще должен стоять настоящий инженер, понимающий физику процессов.

Мой вам совет - не надо тащить в комменты ответы нейросетей. Уж хотя бы прячьте их под спойлер. Потому что переспросить у нейросети и так может каждый. Да ещё и со своими промптом (вы же его кокетливо опускаете) и "настройками эмпатии".
Могут, но почему-то не переспрашивают. Видимо религия не позволяет?
Ну и, как я понимаю, по существу возражений нет.
зы. А промпт простой
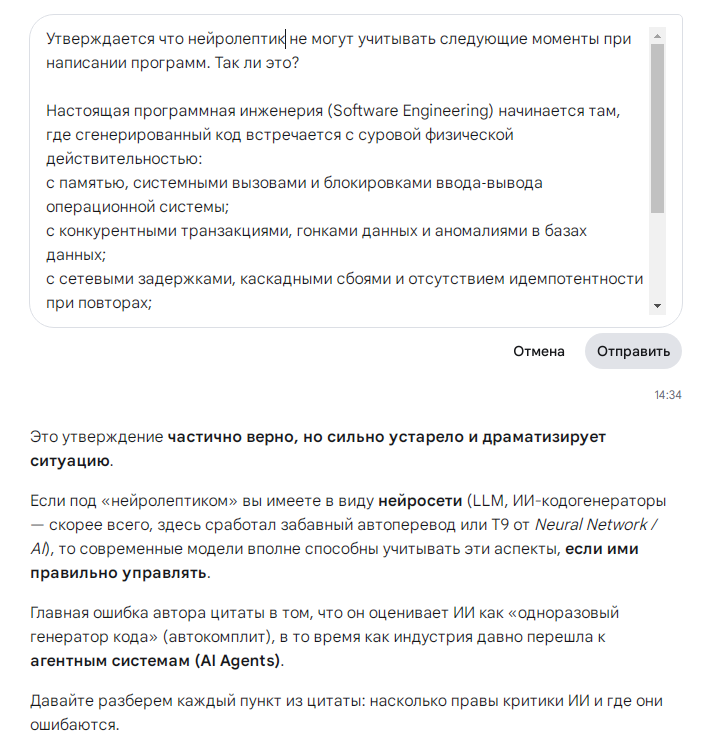
Утверждается что нейросети не могут учитывать следующие моменты при написании программ. Так ли это?
Настоящая программная инженерия (Software Engineering) начинается там, где сгенерированный код встречается с суровой физической действительностью:
с памятью, системными вызовами и блокировками ввода‐вывода операционной системы;
с конкурентными транзакциями, гонками данных и аномалиями в базах данных;
с сетевыми задержками, каскадными сбоями и отсутствием идемпотентности при повторах;
с уязвимостями бизнес‐логики (IDOR/BOLA), утечками секретов и лицензионной чистотой; с наблюдаемостью (Observability), когда упавший в два часа ночи сервис нужно диагностировать не по console.log, а по трейсам и метрикам.
Могут, но почему-то не переспрашивают. Видимо религия не позволяет?
А с чего вы взяли что не переспрашивают? Из-за того что "нейропортянки" не цитируют?))
Ну и, как я понимаю, по существу возражений нет.
Есть.
Для того чтобы нейросеть учитывала эти моменты, ее надо этим озадачить.
Доведём до абсурда - если нейросеть последовательно озадачивать всеми "моментами" - не проще ли самому код написать? ;)
Я понятия не имею какие допущения модель уже сделала, а какие ей надо явно указать. Надо ли вот ей указывать что код должен быть в UTF-8? Надо ли указывать аппаратные ТТХ системы, на которой будет выполняться код и т.д. и т.п.
А не требовать того, чего не было в промпте.
Так в том-то и проблема что требуют. Увы - "за что боролись", как говорится))
Ну и до кучи:
Но утверждать, что ИИ не может учитывать блокировки, трейсы или каскадные сбои — неверно. Современный ИИ знает об этих проблемах всё и умеет от них защищаться.
Так "знает" или ему надо на это явно указывать? Вы уж со своим нейроассистентом определитесь.

«Не будь мясным прокси!» ©

Знаете, что самое смешное в программировании?
Самый подробный промпт для нейросети включающий все данные о том как написать код будет... кодом.
Всё уже украдено задолго до Вас!
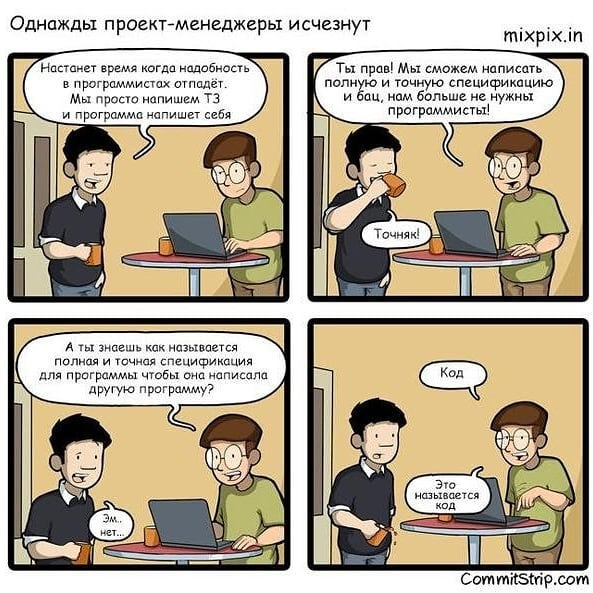

Интересно, где граница между промптом и кодом?
...Наверно, когда из промпта пропадает ничево не значащие символы и слова типа 'А теперь...', 'Потом...', 'Ещę надо...'.

ИМХО кодом написанное будет, если компилятор на его основе будет выдавать детерминистический результат.
Можно написать язык, в котором для одново действия могут быть разные слова, а неизвестные слова игнорируютса. Компилятр выдаст детерминированный результат.
Сдаётся мне, Вы сейчас YoptaScript описали.

Обычно код описывает не то, что хотим получить от системы, а то, как она должна себя вести там внутре. Так что скорее нет.


Самый подробный промпт для нейросети включающий все данные о том как написать код будет... кодом.
Ага. Притом ассемблерным кодом. Но что-то я не наблюдаю желающих писать столь подробные спецификации.
Притом ассемблерным кодом.
— Свидетель, расскажите, как дело было, только с самого начала и во всех деталях!
— С самого начала?
— С самого начала.
— Как скажете. Значит, примерно 14 миллиардов лет назад вся материя, энергия, пространство и время находились в бесконечно плотном и горячем состоянии, из которого начали стремительно расширяться...


Нет. Нужно сначала определиться что такое код и посмотреть на историю его развития. Код это компромисс между описанием однозначных и четких требований к выполению программы понятных компьютеру и читаемых человеком. Высокоуровневые языки читаемы человеком, но в отличии от естественного языка позволяют однозначно описать логику, которая будет интерпетироваться машиной.
Код это всего лишь инструкции машине. Распознать в коде бизнес-логику - тот ещё детектив. Обычно что-то все сразу к постановщику бегут за спецификациями и разъяснениями, понять бизнес-логику из кода без комментов мало у кого получается.
Код это способ описания требований или действий к выполнению машиной. Чтобы не разгадывать этот детектив и идет эволюция языков программирования и подходов к разработке (вроде DDD, OOP, паттернов, принципов и т.д.), т.е. делается всё, чтобы описание в коде было как можно ближе к бизнесу. Давайте взглянем с другой стороны: попробуйте взять бизнесовую спецификацию, описанную аналитиком, и по ней воспроизвести поток выполнения программы, то, как она будет расширяться и тестироваться и как логика согласуется с остальной архитектурой системы)

Самое смешное, что все форсят этот мем, но это далеко от правды.
Не согласен. Если бы естественный язык позволял однозначно описывать поведение программы и при этом легко структурировать бизнес правила в виде архитектуры, то на нем бы начали писать задолго до ИИ (вспоминаем тот же SQL и для чего он создавался). Для сборки уже готового продукта из доступных компонентов - ок, но для поддержки низкоуровневых правил - нет.
На низком уровне тоже выбор из готовых компонетов.
Погружаясь на низкий уровень и описывая модели четкие правила сборки и взаимодействия мы внезапно обнаружим, что промте у нас самый настоящий код, который требует однозначности, ветвления, декомпозиции. Глядя на некоторые скиллы я уже замечаю там целые алгоритмы, которые нужно писать руками и на яп гораздо быстрее и проще.
Тут проблема не в естественном языке, а в коде.
Например, код не описывает нефункциональные требования, он просто пытается им соответствовать.
Ещё код в зависимости от компилятора/интерпретатора, рантайма и даже железа можеть дать различный результат как по функциональным, так по неофункциональным требованиям.
И сам по себе код не объясняет почему, только как.
Достаточно сравнить Hello World условно на Python и Go, потому что эти программы, хоть и делают одно и то же с виду, на самом деле являются абсолютно разными программами из-за разницы а скорости, памяти и куче всего другого.
По сути каждый код порождает некоторое семейство программ, которое может соответствовать многим наборам требований, причём неэксклюзивно. То есть и одно решение может подойти к разным задачам, и одну и ту же задачу можно решить разными способами.
В общем, наверное можно было выразить это проще, но код здесь никак не является тем самым идеальным промтом.
Я бы хотел посмотреть на полный промпт какого-нибудь реального проекта для начала.

Реальный проект полными промтами не делают же. Всегда есть доработки и уточнения.
А где и в чем тогда хранят описание требований к системе?
В документе, который обычно называется “Требования к системе”. Без такого документа програмировать реальный проект просто нельзя (даже для себя) - неважно чем и не важно как. Хотя бы на бумажке в черновике должны быть выписаны хотя бы детскими картинками требования и хоть какое-то начальное проектирование. “Из головы” никто реальные проекты не делает
Ну ок, предоставили, что кода нет и LLM из набора страничек в Confluence с детскими картинками и мыслями из головы генерирует в день релиза готовый исполняемый файл вашего сервиса сразу в машинном коде и развёртывает на проде. Будущее разработки, которое мы заслужили) P.S. а ещё давайте представим, что таких страничек в Confluence у вас несколько тысяч для одного сервиса)
Всё так. Только вы пропустили шаги многоуровнего тестирования и “допиливания рашпилем, напильником и нулёвкой” - этап который тоже всегда пристствует в любом реальном проекте. Хотя да, в будущем, скорее всего, это тоже на себя возьмут БЯМ.
Т.е. алгоритм такой:
“Детские рисунки”
БЯМ работает
БЯМ вас достаёт вопросами: “а так хорошо?”, “а так сойдёт?”, “а так лучше?”
Счастье на проде!
А что значит “допиливать”? Искать и изменять детские картинки среди тысяч страниц в Confluence? И кто будет заниматься отладкой и тестированием продукта? Человек, который должен будет эти тысячи страниц и картинок посмотреть? Возможно сама LLM. Но тогда возникает вопрос: а не проще ли и эффективнее ей и валидирующему ее поведение человеку работать не с картинками в Confluence и голым текстом, а с неким усреднённым человеко-машинно-читаемым предоставлением логики программы? С кодом.
“допиливать” в контесте вайбкодинга - это запускать, смотреть что не так и просить исправить (возможно в картинках)
В картинках работать человеку всяко проще чем в коде. С этим даже гуманитарий справится.
смотреть что не так и просить исправить
Если мы говорим с вами не про домашнее задание в школе, а про реальный сервис, который команда специалистов разрабатывала годами, то ответить на вопрос: работает он правильно или нет это крайне нетривиальная задача. Чтобы ответить на этот вопрос нужно в деталях понимать как обрабатываются запросы на каждом этапе и что ещё более важно как они должны обрабатываться. Совершенно не представляю как можно поддерживать архитектуру решения на тысячах неструктурированных free text файлах с картинками. Структуризация всего этого добра неизбежна, но это же означает создание кода.
Структуризация всего этого добра неизбежна, но это же означает создание кода.
Нет. Это называется - техническое задание. И в действительно больших проектах - оно всегда есть и часто стоит в разы дороже кода. Почитайте ГОСТ 19 или 34 - там до распечаток кода далеко не сразу добираются.
А что такое код по вашему? Код изначально появился как способ структурировать данные и вызовы операторов, когда поняли, что просто последовательный вызов не решает задачи. Объединяете несколько правил или файлов в какую либо переиспользуемую структуру? У вас есть ветвление в принятии решения какие шаги вызвать? Поздравляю, вы занимаетесь структурным программированием!) Те, кто это придумывал, заметьте, не были программистами - это просто логичное желание упорядочить логику и данные. И уже спустя десятилетия развития появились современные языки и технологии. Перед тем, как читать ГОСТы сначала почитайте, что такое процедурное и структурное программирование в Википедии.
Вы сейчас пытаетесь убрать из уравнения опыт нескольких десятилетий разработки ПО. Все ваши проблемы уже решали много раз и эти решения могут интегрировать в разработку с нейронками или адаптировать под эту разработку.
Да, будут люди, которые генерят кучу неструктурированных мыслей и потом хотят программу. Но нейронка может в процессе создать документ или несколько, которые являются выжимкой из них. Она в общем-то и делает это по сути уже, по крайней мере клод.
Тут в принципе не проблема нейронки, а проблема организации процесса разработки.
Вы сейчас пытаетесь убрать из уравнения опыт нескольких десятилетий разработки ПО.
С точностью наоборот. Я утверждаю, что для описания сложной бизнес логики вам неизбежно понадобиться инструмент для структурирования правил поведения.
Но нейронка может в процессе создать документ или несколько, которые являются выжимкой из них.
Вот я и пытаюсь представить, как будет выглядеть этот документ, но не могу. Я бы хотел увидеть пример такой текстовой выжимки, которая бы описывала всю логику и нюансы работы реального сервиса, чтобы оценить его с точки зрения читаемости и поддержки и сравнить с аналогом, написанным в виде кода. Ведь именно по этому документу будет разворачиваться исполняемый файл в проде. В целом это вне моего понимания, как вы собираетесь описывать бизнес логику и алгоритмы не используя условные операторы, циклы, композицию действий.
Ну к примеру, в этом документе будет что-то вроде:
п.1 Если пользователесь не имеет роли “employee” то возвращаем ответ, описанный в п2.
п.2 Возвращаем ответ с http кодом 403.
Это же код в чистом виде! И я не вижу разницы и не понимаю, почему бы не написать так:
If (!user.HasRole(“employee”)) then return Response.Code(403);
Ну смотрите, ваш пример например можно изобразить блок-схемой.
Тут можно привести в пример c4 модель, где есть несколько уровней.
Я не готов утверждать, что я знаю ответ на ваш вопрос, но подозреваю, что в идеале будет что-то похожее. Есть несколько уровней, где-то более детальные описания, где-то может даже пример кода. В конечном итоге мы не обязаны под одну гребёнку гнать все части системы.
Ну смотрите, ваш пример например можно изобразить блок-схемой.
Уже такое было в истории. Были попытки создания графических языков программирования, где бизнес логика и данные рисуются схемами в графической среде. В итоге получались такие монстры, на которые смотреть было больно)
Хотя я уверен, что в начале, когда рисовали простенькие программы в несколько схем все выглядело действительно просто и более читаемо, чем текст.
Много раз пытались придумать документо-языки. Один из самых показательных - COBOL, который я в шутку продвигаю как язык дл LLM. Документацией так и не стал. Или SQL - тоже.
У языка совсем другое назначение. Язык програмирования - это в первую очередь математический конструкт. А документ - вещь сугубо гуманитарная, даже если там етсь переходы по пунктам и ссылкам.
Их не получится свести друг к другу. Просто потму что математика не может описать природу во всём её многообразии и противоречивости (Гёдель машет ручкой).
Не знаю, какой у вас опыт, но в тех организациях где я работал документация всегда была вторичным продуктом и писалась после кода по остаточному принципу. Во многих современных подходах Agile, DDD это прямо утверждается, что работающий в проде продукт это главный приоритет и код должен описывать и ставить бизнес правила выше всех остальных деталей - быть источником истины и документации к продукту. На документацию обычно по этой причине и забивают, т.к. она по сути дублирует код, является вторичной (сервис на проде работает так, как написано в коде, а не в Confluence), постоянно устаревает и часто является не полной.
Ок, убираем код, делаем документацию первичной и с помощью LLM генерируем из нее исполняемый файл. Тогда теперь к документации начинаем предъявлять те же требования, что и к коду: отсутствие дублирования, четкая архитектура с разделением по уровням, непротиворечивость, переиспользуемость частей функционала, читаемость, компактность (LLM читать Войну и Мир каждый раз будет очень дорого), тестируемость, расширяемость. В итоге тот же код получим.
Тогда теперь к документации начинаем предъявлять те же требования, что и к коду: отсутствие дублирования, четкая архитектура с разделением по уровням, непротиворечивость, переиспользуемость частей функционала, читаемость, компактность (LLM читать Войну и Мир каждый раз будет очень дорого), тестируемость, расширяемость. В итоге тот же код получим.
Нет, мы получим ГОСТ. Ну или IEEE.
Код - это контексто-свободная грамматика, а документ - это контекстно - зависимое мессиво. Код принципиально не достаточен для описания задач и хотелок из реального мира. Иначе он перестаёт быть кодом (перестаёт быть синтаксически проверяемым за полиноминальное время). Что, например, и произошло с UML.
Код принципиально не достаточен для описания задач и хотелок из реального мира.
Реально, от души. Буду так отвечать бизнесу, когда принесут очередную хотелку)))
Я тоже регулярно ржу над хотелками. Всем отделом иногда ржём. Ещё ни разу ни в одном реально работающем проекте не обошлось без “коррекции хотелок” под реальные возможности автоматизации. Мало кто знает, но Тюринг-полная система не может сделать “что угодно”.
Но именно по этому описанию из документации LLM будет должна сгенерировать тот самый код для работы сервиса на проде)
Сейчас есть фильтр из программистов, которые напомнят, что ваши хотелки противоречивы и нереализуемы и промежуточный слой в виде кода, который гарантирует корректность.
А теперь представьте, что кода и программистов нет и каждый аналитик пишет что ему вздумается в абсолютно free text формате требование, а потом LLM собирает все это неструктурированное месиво, в режиме черного ящика генерирует код и через минуту он на проде “радует” пользователей.
Сказать, что LLM как-то там сама разберется можно, НО только в том случае, когда ты не несешь прямую ответственность за работу сервиса на проде и не рискуешь своей должностью. Иначе ты захочешь держать под контролем каждую инструкцию, которая будет в итоге сгенерирована. Имея детерминированный, структурированный непротиворечивый код (ну ок документация, ГОСТ, whatever you want) такая гарантия есть. Иначе очередной релиз превращается в лотерею.
И какие в этом минусы с точки зрения бизнеса?
Зависит от того что считать кодом наверное, но кодом можно описать в том числе и инфраструктуру на которой код развертывается, и код самих сервисов, и бизнес-процессы описать в bpmn нотации, и диаграммки архиектуры самого кода нарисовать. Даже естественный язык в каком-то роде код.
Любой текущий айтишный бизнес-проект вообще можно чисто было реализовать на любом тьюринг-полном языке, единственное во что это всё упиралось - косты.
Сейчас с ллмкой тоже можно чего реализовать, но косты реализации, поддержки, обучения новых моделей, подписок, компьюта, инференса и вообще экономика этого всего - вопрос открытый.

Погодите, когда вы последний раз видели ТЗ/фичереквест, что угодно от аналитики с описанием до последнего регистра в процессоре? Использование мема что полная спецификация программы-есть код, явно давно вышло из-под контроля и используется везде и там где уместно и не уместно.
Например нет смысла писать в ТЗ/промте конкретный алгоритм сортировки до последней инструкции, когда нам нужно просто получить отсортированный список, там будет просто описано вот здесь отсортированный список чего-то, и что живой кодер, что LLM не будут реализовывать сортировку вручную, а будут использовать готовую реализацию в библиотеке того языка на котором идет разработка.
Так писать, что здесь сортируем список все равно придется) И тут то и возникает вопрос: а зачем здесь LLM, если можно вместо берём список m и сортируем написать то же самое, но сразу в коде m.Sort();? Зачем вообще атмосферу греть?

А зачем писать m.Sort();, когда можно на ассемблере?
Я понял, что ты имеешь в виду. В твоей картине мира естественный язык в txt файле промта это что-то более высокоуровневое, а яп что-то более низкоуровневое. Я утверждаю, что описание и структурирование бизнес требований в формате, который специализированно развивался для этого десятилетиями гораздо удобнее и быстрее. Я уже привел пример. А теперь ты напиши то же самое на ассемблере и давай из трёх выберем самый простой и удобный.

А зачем писать
m.Sort();, когда можно на ассемблере?
А зачем писать одно и то же в стопицотый раз? БиблиОтеки — наш друг!
Так это же вопрос про фичереквест/реквайрмент где аналитик описывает фичу и если есть UI то, к примеру описывает показ чего то в отсортированном виде, и не требуется описывать конкретный алгоритм сортировки или аналитик описывает фичу какого ни будь биллинга, где говорит, что заявки на что-то должны обрабатываться в каком то порядке и тоже не требуется писать подробно что за алгоритм сортировки будет и его реализацию и т.д.
Вот именно поэтому в команде и существуют программисты) Их задача провести максимальную детализацию этих требований и описать конкретные инструкции. Откуда взять эти данные, как смаппить, по какому протоколу отдать на фронт, нужен ли paging и т.д. Это все нужно явно прописать кому-то либо в коде либо в промте. Я утверждаю, что в коде гораздо удобнее для дальнейшей поддержки.
Откуда взять эти данные, как смаппить, по какому протоколу отдать на фронт, нужен ли paging и т.д. Это все нужно явно прописать кому-то либо в коде либо в промте.
Все это вполне прописывается в промте, вопрос лишь куда пойдет индустрия в сторону продвинутый аналитик-программист и LLM-модель, либо по старому аналитик и шатат программистов плюс LLM в помошь программистам.
Код это инструмент структурирования логики и данных. Описывать, структурировать и версионировать желаемое поведение все равно кому-то и где-то придется. В промте? Ок, но если у вас появятся (а они в сложных проектах уже появляются) элементы композиции, ветвления в описании, то, значит, у вас завелся самый настоящий код! Я думаю будет единый псевдо-си-подобный-код на котором неизбежно придется организовывать поведение и данные с возрастанием сложности.

Для того чтобы нейросеть учитывала эти моменты, ее надо этим озадачить.А не требовать того, чего не было в промпте.
Дл того, чтоб это было в промпте, написавший промп оператор должен сам знать и понимать эти моменты. Что знать и понимать, оператору надо самому какое-то (весьма продолжительное) время писать код руками - и не переставать это делать, ибо такие навыки теряются и достаточно быстро. А в дивном новом мире за ручное написание кода бьют по рукам и увольняют за луддизм. В итоге, скоро получим поколение промпт-операторов, для которых слово "многопоточность" значит лишь, что сосед сверху залил квартиру сразу в нескольких комнатах.

Что знать и понимать, оператору надо самому какое-то (весьма продолжительное) время писать код руками
Данное утверждение является необходимым, но не является достаточным. Будто бы все пишущие код продолжительное время по умолчанию строят нормальную архитектуру, хаха!
Будто бы все пишущие код продолжительное время по умолчанию строят нормальную архитектуру
Ну так у них есть обратная связь: «работает медленно — может, что‑то в консерватории архитектуре подправить?»
И в итоге мы придем к тому, что начнем в промте писать… код, чтобы описать нейронке все требования)
Не совсем понятно, что мешает LLM учесть всё перечисленное. Это же не из разряда взаимодействия с клиентом или племянником руководителя. Тут всё предельно гладко ложится на способности существующих ныне моделей. Загнать вашу статью в виде MD-файла - и вуаля. Или вы это уже пробовали и не получилось?

Не совсем понятно, что мешает LLM учесть всё перечисленное
Отсутствие качественной обучающей выборки.

Перечисляешь основные пункты в системных доках проекта, и Claude спокойно пишет хороший код. Большинство из вышеперечисленного Opus и без внешних подсказок делает.
Если вы думаете что обучение идёт просто на данных из интернета, то вы ничего не понимаете в обучении передовых моделей. Как и большинство критиков нейросетей.
У них при обучении прямой доступ к базе данных Господа Бога, решившего все задачи в общем виде?
Модели не ищут общие решения в обучающей выборке. Из недавнего реального примера, Opus 5.5 полез декомпилировать код стороннего приложеия, потому что после нескольких попыток написать тест результаты не сходились. Нашел в сторонней проге баг, описал его, переделал тесты с учётом бага. Всё без подсказок и дополнительных промтов.
Значит где-то в обучающей выборке была описана похожая ситуация. Никак иначе LLM не работает.

Собственно как и человек )
Нет. Ни человек, ни LLM так не работают. Оба реально могут придумать что-то новое: доказывается просто заданием придумать новые слова в стиле глокуздры - оба справятся. Вопрос только в том насколько сложные и наскольок соотносящиеся с реальностью системы способны придумывать. А вы сможете создать шедевр?
А вы сможете создать шедевр?
Шедевр, (равно как и ИИ‑«галлюцинация») — в глазах смотрящего. Я вот не считаю «Звёздную ночь» шедевром — но пипл хавает.
Очевидно что там уже синтетика какбы, но исходную обучающую выборку нейросеток видно по стилям навайбкоженных сайтов и по звуковым эффектам/дизайн-решениям навайбкоженных игр. Даже ассеты звуков в шутанах одни и те же.
Ну написать статью про это она смогла, значит ее этому учили

Прописываю в Agents.MD (AI studio если что) правила, которым ИИ должен следовать. Хер там - периодически их игнорирует. Ткнешь мордой в нарушение - ой, действительно - извини, я тут ставил в приоритет решение задачи, поэтому твои правила пропустил. Больше такое не повторится. И потом снова косячит.

Не пробовали ревью кода делать с помощью другого провайдера?
В моём конкретном случае у меня сначала топовая модель пишет общий, в котором для каждого пункта из detail указана модель, которая будет реализовывать эту детализацию, потом проходит ревью, если замечаний нет, то переходим ко второму этапу более детализированная реализация - аналогично с указанием модели, которая будет писать код, с обязательным ревью.
Плюс размер участка определяется размером контекстного окна, чтобы не происходило сжатия контекста в процессе реализации.

Дополнительная обвязка с проверкой кода субагентом со своим контекстным окном решает подобную проблему даже на средненьких моделях.
Что то вроде cezar позволяющей гибко настраивать воркфлоу.
Всё что можно верифицировать кодом, надо делать кодом. А не надеяться на само-дисциплину нейронки. Ещё можно порекомендовать ввести отдельного внешнего агента ревьюера.

Я в этот файл загнал несколько "крючков", типа "в самом начале посчитать число строк этого файла", "дочитать файл до конца, если вывод обрезан - повторить" и в самом конце банальная фраза "если прочитал эту строку верни число строк и фразу "я такой-то, модель такая-то, прочитал такой-то md до конца""
Многие харнесы читают только первые 200 строк, подробный приём заставляет теперь читать полностью, это видно по ленте рассуждений.

Загнать, то можно, даже более умнее и сделать например локальный RAG, с конкретными примерами применения, правилами и т.д., но это не отменяет понимания и проверку человеком. Нейрорка имеет довольно короткий контекст, по сравнению с нами. Часто идёт самым простым путём и не может отловить многие проблемы банально из-за отсутствия инструментов. Либо нейронка будет использовать условное управление экраном сжирая огромное количество токенов.От понимания базы никуда не деться.)

Ничего не мешает. Но чтобы LLM это все учла - ее надо этим озадачить. А чтобы озадачить - надо знать самому.
Да, можно использовать готовый текст - прописать в промте или в скиле (если найдешь подходящий под свой стек). Но все равно тут много нюансов. Да и контекст не резиновый.
Но LLM надо контролировать и самому - и тут если сам “не в теме”, то и не поймешь “а что не так”. Отдельное ревью моделью, конечно помогает (особенно если делать в отдельной сессии и другой моделью). Но оно тоже далеко не всесильно.
Да просто посмотрите на глючный интерфейс той же ChatGPT)) И это только то, что сразу бросается в глаза, какая лапша из легаси и вайбкода там под капотом...
Им уже приходится скейлить Git если что. С подобными проблемами корпорации вроде яндекса и гугла сталкивались только по прошествии 15-ти лет где-то.

Спасибо за статью. Можно прям скопировать и отдать нейронке. Лучше двум, трём.


Есть же дизайн документ, скиллы и тд, модель это как электрорубанок или даже топор - она не знает что именно нужно - дрова колоть или мебель делать, с резными узорами или простую, это статистический pattern matcher который едет как трамвай по путям обучающей выборки
В промпе нужно указывать стрелки для путей трамвая чтоб ездил где нужно. А то получается как в анекдоте - телефон, дай еды а то кушать хочется...

Мы без конца проклинаем написанный LLM код, и, разумеется, за дело. И всё же я хочу спросить - кто написал гигабайты big ball of mud до появления LLM?
Вот вроде и спорить в статье не с чем, а есть какое-то ощущение, что жалобы на вайб-кодинг это «do as I say, not as I do» снова.
Людям в массе не нужен хороший код, как не нужна хорошая еда. Людям нужен достаточно хороший для текущей ситуации код (и еда такая же). Если код или еда через два года начнёт вызывать проблемы - ну вот тогда и разберёмся, а пока принимаем риски. Зато LLM не болеет, у неё нет детей и других родственников, не канючит зарплату и не бухает с охраной. И это всё уже сейчас, а не через два года.

Многие вещи описанные в " Данные, типы, индексы и транзакции" LLM-ки уже знают. Вы будете смеяться, но я недавно выловил как раз скрытую квадратичную сложность при помощи Codex. Я попросил сделать perf review своего кода - численный метод для разреженных матриц. Собственно указанную проблему он выловил и успешно устранил. А транзакционность, боже мой, как они любят транзакционность. Даже я выучил это слово, хотя я, тащемто физик. Ошибки связанные с округлениями и операциями над числами с плавающей точкой тоже не раз дебажил с помощью Codex. Иными словами если не экономить токены на ревью, то очень значительную часть неоптимальностей можно выловить. К тоже же LLM-ки теперь неплохо владеют Его Величеством Методом Последовательных Приближений, позволяющим сужать круг подозреваемых (баги, неоптимильности)

Проблема же не в том, что они этого не знают. Техническую проблему, что сами они это знание не применяют, можно решить добавив обязательный процесс ревью другими агентами на производительность и т.п. - это будет медленно и дорого, но какой-то результат даст. Но главная проблема в том, что все эти нефункциональные требования неполны и противоречивы просто по своей природе - безопасность мешает UX и производительности, производительность мешает надёжности и т.д. Поэтому тупо требовать от ИИ сделать код одновременно безопасным, быстрым и надёжным - бессмысленно, даже если любое из этих качеств по отдельности ИИ может обеспечить лучше Вас самих. Чтобы реализовать НФТ нужно понимание баланса подходящего текущему проекту, которого у ИИ нет в принципе и ему неоткуда взяться.

На самом деле вещественные типы всё же используются для представления денежных сумм, но обычно для промежуточной обработки (например, в числодробилках в финтехах при условной потребности в численной оптимизации) или передачи данных по сети, а не для хранения данных в БД.

const newBalance = user.balance - amount;
await db.user.update({
  where: { id: userId },
  data: { balance: newBalance }
});
Современные модели давно так не делают

Отличная выжимка БАЗЫ, с важными нюансами и уточнениями
Спасибо за статью!

База это хорошо. Но странные у вас нейронки. Старшие модели (опус 5.5, например) такую фигню уже не пишут давно. Достаточно добавить в промпт что-то вроде "пиши безопасный оптимизированный код, покрой интеграционными тестами с граничными случаями, в конце сделай ревью безопасности"

Все что в статье написано (ну может и не все) суть - знания. Многие модели как раз сильны именно в знаниях, это эксперты. Так что с этим у них как раз проблем нет. Особенно, если направить в нужно русло - безопасность, производительность , отказоустойчивость. Сам вайбкожу и вижу как модель и гонки запросов находит, и индексы делает, и проверки всяческие - хотя я об этом не не просил , в промте лишь - "ты программист". Этого достаточно. Не пройдет и года, как они и без запроса пользователя начнут подходить к проекту более организованно и системно. Сочувствую, что живые носители таких знаний накапливали их годами, кровью и потом, а теперь они доступны всем и каждому.

Простите, а раньше эти знания не были доступны всем и каждому? В виде книг, курсов, терабайтов бесплатных видео? Мне кажется, что вы просто не понимали, что в них написано. Теперь же вам дали универсальный шаблонизатор по временной цене 20 долларов в месяц - и вы считаете, что достаточно ему сказать "ты программист", чтобы он стал программистом. То есть понимания так и не появилось.
Знания стоят времени. А время дорогое. Все знать нельзя, а модель "знает" намного больше. Пользоваться инструментами которое даёт прогресс и избавляет от рутины - это норма. Если Вы вдруг решили, что можно не пользоваться калькулятором, который знает и умеет быстрее Вас - ну каждый делает свой выбор. Кто-то будет двигаться вперёд в ногу со временем, а кто-то будет сидеть на всех своих книгах и знаниях и выдавать тот же результат, только более медленно. Вопрос понимания - стоит совсем на другом уровне, да как развивается мир не все поняли.

Вайбкодинг, конечно, всё ещё зло, но к чести современных флагманских LLM-ок (наверное даже китайских), они уже довольно давно такую фигню как блокировка event loop или N+1 не делают. Даже без специальных требований. Бесспорно, в их коде может быть много краевых случаев и спрятанных ошибок, но вот такие грубые ошибки проектирования как описаны в статье уже в прошлом, они вам скорее по рукам надают за такой код чем сами его сгенерируют. Но, повторюсь, это не значит, что их код можно не смотреть глазами.

Странно видеть в статье постоянные упоминания "Вайбкодер пишет сетевой вызов так, будто сеть надежна" и т.д. Хочется сразу внести ясность - вайбкодер код не пишет. Более того - он даже в этот самый код не заглядывает.

Давно уже нейронка не делает такие ошибки
У нейронок ещё есть проблемы в закрытом контуре, что их знания могут на год отставать, т.е. вот qwen4 еще учат, а технологии вокруг так быстро меняются, т.е. живые кодеры непрерывно учатся, чуть упустишь и ты уже отстал от рынка, мониторишь какие где уязвимости. И я часто ловил ситуации что просто не может последнюю версию библиотеки прикрутить к проекту, то методы устарели, то конфиг иначе надо писать, то несовместимы версии... Иногда иду к облачному дипсик, кидаю ссылку на документацию, говорю слепи мне md с примерами, подкладываю в локальный проект и о чудо, он справился.

Какая хорошая статья!
Попрошу своего агента зделать из неё скил.

Вы описали лишь одну парадигму работы с агентами: кодогенерация под чутким контролем специалиста. Да, она имеет место быть, но требует всё тех же глубоких познаний в низкоуровневой части. Но есть и другой подход: кодогенрация в условиях ограничений. Вы настраиваете (или просите ИИ) окружение таким образом, что все нужные вам метрики и проверки выполняются. Хотите, чтобы файл на 500ГБ не вешал ваш сервис? - Добавьте соответствующий тест. Хотите, чтобы ИИ сгенерировала асинхронный код? - Добавьте тест производительности.

Хорошая статья, рассказывает базу без привязки к конкретным языкам. Но я вот что подумал. Все эти листинги кода смотрятся уже как легаси, типа как листинги на бейсике в старых компьютерных книжках, даже хуже. Мне кажется в будущем оставят только один ЯП высокого уровня, и LLM будут писать либо на нем, либо сразу машинные коды. Этот ЯП будет нужен чисто для проверки человеком писанины LLM (что будет требоваться крайне редко), он будет максимально простой и заточен на чтение человеком, а не на запись, поэтому там не будет всего сахара современных языков, нужных для ускорения записи. Соответственно все нынешнее разделение на ООП vs функциональщину, сотни разных языков, все эти SOLID и прочий чистый код не будут нужны, и уйдут в историю. Что и хорошо, потому что это огромный слой гуманитарщины-вкусовщины с размытыми границами посреди технического айсберга технологий (как только теперь работу искать, вот вопрос).
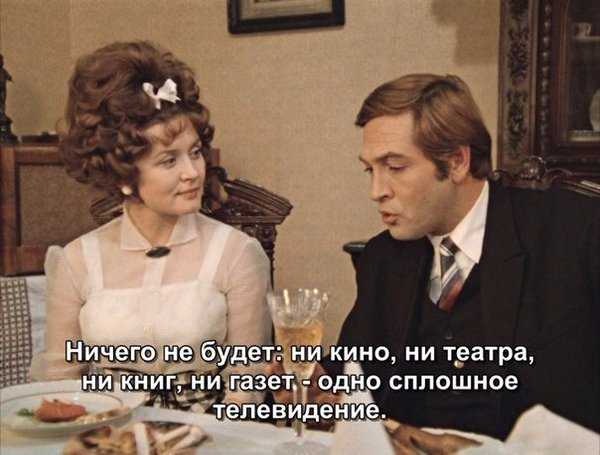
Через пару-тройку-пятерку лет посмотрим, насколько ваша ирония была уместна)
«К тому времени кто‑нибудь да сдохнет: либо ИИшак, либо падишах мы все, либо я» почти ©
Так постойте - в 90-е именно так и было))
в 90-е именно так и было))
Вот не надо мне ля‑ля! А кто, по‑Вашему, на «Враг мой» восемь раз ходил?
Вот не надо мне ля‑ля! А кто, по‑Вашему, на «Враг мой» восемь раз ходил?
Запоздали, значит. "Враг мой" я в конце 80-х смотрел.
А как раз в 90-х кинотеатры стали массово закрываться или "перепрофилироваться".

Я думаю тут интереснее. Сейчас условно 2 поколение ллм идет от трансформеров обычных к мое и спар атеншен. Плюс косяки первого поколения правятся. Но суть даже не в этом. Скинув рутину на ллм и агентов. Кучу вайп кодеров со временем перейдут на тот уровень о, котором изначально пишет автор. И когда датасет достаточный наберётся. Инженерные паттерны лягут в, основу обучения следующих итераций ллм. И так как у нас предсказктельная модель то это просто станет таким же мейнстримом как и hello world..... Тут прямая связь. Собрали датасет-создали инструмент - столкнулись с проблемами - решили - получили новый датасет......

Мне кажется, автор описывает вайбкодинг на уровне моделей прошлого года. Современные фронтирные модели значительно реже допускают ошибки из статьи, а то, что все же проскакивает, хорошо ловится циклом ревью. Часть пунктов вообще не требует внимания модели и закрывается гейтами: semgrep-правила, govulncheck, pip-audit, проверка возраста и популярности нового пакета в реестре.
Зато в статье нет провалов, которые я у агентов вижу чаще всего:
тесты, подогнанные под код, или тесты, где замокано все, включая проверяемое;
проглоченные ошибки и тихие фолбэки;
удаленные или ослабленные проверки и валидации, лишь бы прошел тест;
рост связности: SQL в хендлерах, логика в UI.
Зарегистрируйтесь на Хабре, чтобы оставить комментарий
За пределами вайбкодинга: фундаментальная база программной инженерии