Статья — конспект архитектурных решений, принятых при разработке внутренней системы для госорганизации: таблицы до нескольких миллионов строк, Excel как основной источник данных.
Интерес могут представлять организационно‑технические решения, продиктованные ограничениями госслужбы. Основная цель — зафиксировать эти решения, пока они свежи в памяти. В завершение — разбор подсистемы ленивой загрузки данных.
Это просто одна из возможных реализаций. Реализация работоспособная и крутится на ПК пользователей более полугода. Если материал зайдёт — будет продолжение.
Часть 1. Для чего это делали? Постановка проблемы
Вводные данные: несколько отделов ведут свои рабочие таблицы в Excel. Данные собираются из разных источников: подотчётные организации, централизованная система и так далее. Отдельные таблицы содержат под 100 столбцов и заполняются сотрудниками подведомственных организаций — человеческий фактор в такой среде проявляется в полной мере: при сборе данных часто случается, что «столбцы» данных меняются местами, заголовки меняются, в полях где должна быть дата или сумма написан текст пр. Борьба за чистоту данных в Excel — та ещё задача.
Коме того, на каждое направление работы в ответственном отделе ведётся своя таблица, а к ней ещё может быть дополнительная таблица.
В общем, когда нужно получить цельную картину по одной позиции информация собирается из разных отделов и разных табличек в этих отделах. В такой среде возникают проблемы как со скоростью, так и с достоверностью получения информации. Любой сбор информации к сроку (а в госсекторе сроки жёсткие) неизбежно приводит к задержкам сотрудников на работе на несколько часов (и это для отдельных сотрудников стало нормой).
В целом, это типовая ситуация для больших организаций.
Выход увидели в разработке системы, которая бы позволила свести всё это в одном месте и разгрузить сотрудников. Разумеется, разработка велась после изучения процессов.
Новый инструмент позволил сделать те же предметные задачи, но технически и организационно по‑другому: быстрее, часть операций была автоматизирована, по другой был автоматизирован подсчёт контрольных соотношений (проверка) и пр.
В результате получилось так, что часть процессов была перестроена.
Чёткое ТЗ отсутствовало в принципе (для такой задачи на него нужно полгода — минимум). Бизнес‑логика формулировалась совместно с сотрудниками отделов.
Для достижения цели было сделано meta‑driven database‑centric приложение (то есть интерфейс и логика форм описываются строками в таблицах БД, бизнес‑логика — в хранимых процедурах БД), которое «настраивается» под нужды конкретных пользователей. При открытии каждой формы приложение читает эти метаданные и «собирает» форму на лету.
На сегодня мы внедрили это приложение в двух отделах (с изменением техпроцессов и подходов к работе), разработали более 100 форм.
Сроки: 8 месяцев на разработку базового функционала приложения, 2–3 месяца на внедрение в одном отделе.
Статья раскрывает как организационный, так и технический аспект. Начнём с того, как мы подходили к задаче и почему приняли те или иные решения.
Часть 2. Организационный аспект
В начале пути было только общее представление о проблеме. После общения со всеми заинтересованными отделами это понимание было несколько уточнено, но всё равно очень далеко от конкретики. Однако такое понимание позволило сформулировать базовые (фундаментальные) требования к системе.
Что должна уметь система?
Пользователи преимущественно работают с табличной информацией — нужны типовые формы таблиц. Информация требует анализа — в одной строке и чтобы было удобно для восприятия её не уместишь, необходимо размещение расшифровок к строкам. Визуально это можно представить так: пользователь в основной таблице выбирает строку, а в таблице с детализацией отражается поясняющая информация.
Форм в такой системе много: они должны быстро разрабатываться. Идеальный вариант: скопировать готовую похожую формочку и поменять источники данных. Поэтому в нашей системе формы «собираются» из метаданных, занесённых в нескольких таблицах базы данных. При открытии формы загружается её описание: вкладки, объекты на них (таблицы, графики, подписи, выпадающие списки), координаты и размеры, источники данных, подписи и типы полей, способы редактирования, настройки чекбоксов... Это позволяет пользователю видеть данные в удобном виде, редактировать то, что разрешено и фильтровать записи. Разработчику такой подход позволяет быстро собирать новые формы из ранее созданных (многие формы похожи по логике работы с данными и отличаются только источником).
Отдельный блок — права доступа. Пользователь видит только то, что ему положено: только нужные формы, а в формах нужные вкладки, редактировать может только то, что доступно. То есть сама форма и её отдельные элементы (+ поведение формы), доступные пользователю команды настраиваются в соответствии с теми правами, которые есть у пользователя в БД. Элементы формы при её создании настраиваются исходя из прав доступа (а не собирается и потом блокируется). Для разработчика это тоже удобно: выбрал пользователя, предоставил ему права на роли (к каждой форме есть список ролей в зависимости от функционала) и на этом настройка пользователя завершена (всё остальное система «считает» из базы).
Помимо простой выгрузки данных из каждой формы в Excel (MS Excel — основная программа, в которой работают пользователи) предусмотрена возможность формирования отчётов. Отчёт нужен, когда форма сложная и просто выгрузить табличку с данными недостаточно (таких большинство). Для составления отчёта нужно подготовить таблицу в Excel (как правило, из нескольких листов с правильной «шапкой» и форматированием столбцов) и скрипт SQL для её наполнения (такой подход позволяет быстро формировать «приятные глазу» отчёты, готовые к выводу на печать). Включение нескольких листов в один отчёт позволяет «отобразить» данные в разных «разрезах» (обеспечивает необходимую гибкость).
Помимо таблиц в системе предусмотрены графики. Интерактивные (например, пользователь щёлкает мышкой по столбцу гистограммы и видит детализацию данных по этому столбику). В рамках нашей системы графики могут выступать как «сводной» информацией, так и детализацией.
Организация государственная — аудит действий пользователя и сохранение изменений обязательны (то есть в какие формы заходил, какие данные отбирал, что изменял, какие отчёты формировал).
Пользователи работают с Excel. Соответственно, особое внимание уделено процессам загрузки данных. В частности, предусмотрено «распознавание» таблицы по её шапке, контроль загрузки данных, предобработка, тестирование, нормализация, бизнес‑логика. Это отдельный блок, выходящий за рамки данной статьи. Основная его задача не просто загрузить данные, но и сделать так, чтобы пользователю было удобно с ними работать. Такая система позволяет довольно гибко и оперативно настроить загрузку новых данных в систему и «обогащение» ранее внесённой информации.
Отдельное требование — объёмы. Большинство рабочих таблиц — до 100 тыс. строк. Но есть отдельные «экземпляры» объём которых может превышать 20 млн. строк. Открывать их полностью через select * и держать в памяти нецелесообразно. Именно это требование определило устройство подсистемы отображения таблиц, которой посвящена отдельная часть статьи.
Здесь может возникнуть вопрос: почему не взяли что‑то готовое? На то есть несколько причин. Во‑первых, технические ограничения в любом случае будут. Было гораздо интереснее работать без ограничений вендора. Во‑вторых, не хочется ни от кого зависеть и полностью контролировать все процессы (если приложение написано нами, мы можем оперативно внести любые изменения, если бизнесу это понадобится: не ждём, пока вендор выпустит патч, и не ищем обходные пути через «костыли»). И, что немаловажно, лицензионная чистота.
Почему Python — мы госструктура (у нас нет возможности сформировать команду разработки индивидуально под каждую задачу), нам так было проще и быстрее реализовать всё задуманное выше. Получается, что специалист по Python может поддерживать всё что написано в рамках работы группы.
Python медленнее классических альтернатив? Да, но на практике приложение без видимых «задержек» работает не на самых лучших компьютерах в нашей организации.
Почему десктопное приложение? Все привыкли к такой форме, пользователям нужно грузить таблички в Excel — для нас это было просто удобнее и привычнее.
Почему low‑code meta‑driven? По итогам работы с первым подразделением у нас было сформировано более 100 форм (разных: с общей информацией и с информацией подразделения …). Собрать это «классическим» методом силами одного сотрудника за 8 месяцев не представляется возможным. Немаловажным является тот факт, что процессы в нашей организации динамичны и методология работы периодически требует корректировки. Это значит, что оперативной корректировки требует и бизнес‑логика, описанная в нашей программе. В такой среде скорость внесения изменений приобретает особое значение.
Зачем database‑centric (бизнес‑логика в базе)? Система многопользовательская: при внесении изменений в хранимую процедуру нам не нужно обновлять приложение у пользователей, мы просто правим данные в БД. Формы отображаются у пользователей с нужными правами без каких‑либо дополнительных действий.
Кроме того, такой подход позволяет существенно снизить порог входа в работу с системой. Отдельные сотрудники при наличии желания, квалификации и времени сами могут вносить какие‑то изменения, дорабатывать формы и так далее (для этого не нужно быть программистом). Такое окно возможностей облегчает всем жизнь.
После разработки фундаментальной части пошло внедрение в отделах.
Порядок:
Изучение процессов (как правило, сначала в общем, а затем детализация).
Обсуждение предложений по изменению, автоматизации (совместно с сотрудниками подразделений). Банально, но участие и заинтересованность сотрудников обязательны (без этого даже очень сильные изменения внедрены не будут).
Изготовление тестового варианта автоматизации. Совместное изучение и тестирование.
Доработка (и так до тех пор, пока вариант автоматизации не устроит всех).
На сегодня разработка внедрена в нескольких подразделениях:
переработаны процессы;
100+ экранных форм;
данные из Excel сведены в единую базу данных;
существенно сократилось время как на работу с таблицами, так и на ответы на вопросы.
Что дальше:
в системе накапливаются данные различных отделов;
поскольку многие отделы работают с одной и той же информацией, «подключение» означает, что отдел «видит» нужные данные других отделов. Это автоматически означает сокращение объёма служебных записок, если данные уже в системе, готовить запросы для их передачи не нужно.
Организационная часть отвечает на вопрос «зачем и как подходили». Следующая часть — «что под капотом».
Часть 3. Техническая (как это работает)
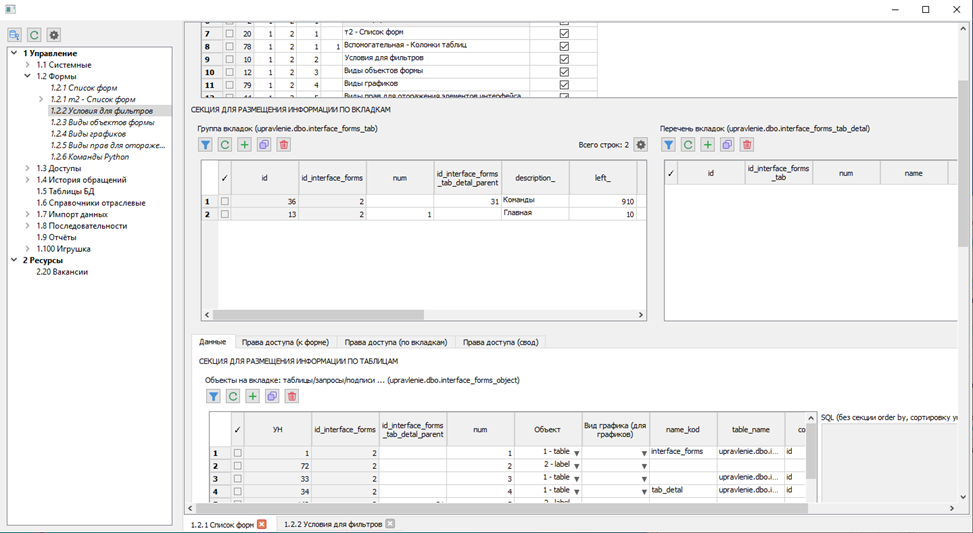
Data‑Driven UI: Таблицы как мета‑данные
В приложении нет захардкоженных файлов с формами. Интерфейс полностью мета‑управляемый. При открытии формы система читает из БД структуру (координаты x, y, width, height, базовый SQL‑запрос, настройки шрифтов и колонок) с учётом прав доступа конкретного пользователя и динамически строит экранную форму.
LazyTableModel — это универсальный движок, работы с таблицами базы данных. Если бизнесу нужно завтра вывести на экран новый справочник на 5 миллионов строк, мы просто делаем новую форму средствами этого же интерфейса.
Excel ETL: Как данные попадают в таблицы
Основной источник — Excel таблицы пользователей (выгружаются из внешних систем или заполняются вручную).
Система умеет «распознавать» таблицу в файле «на лету» (путём сопоставления содержимого «шапки таблицы» с данными в базе — вносим при настройке). При этом:
проверяются типы данных (сопоставляются с таблицей в БД, в которую заносится информация);
«распознавание» таблицы позволяет внести данные в нужную таблицу а после её запуска выполнить тесты и скрипты обработки вновь поступивших данных.
Это позволяет машинным способом проверить правильность размещения столбцов и корректность разнесения данных по этим столбцам по типам (в столбике где предполагаются числа должны быть числа, где даты — даты …).
Часть 4. Ленивая загрузка миллионов строк в PyQt5
Для больших объёмов грузить все данные из таблиц БД (или результата запроса) в память неприемлемо.
Нам нужно было решение, которое:
Не грузит все данные в RAM.
Работает с любой сортировкой (пользователь может задавать сортировки по своему усмотрению).
Не нагружает SQL Server тысячами запросов, когда пользователь интенсивно крутит колесико мыши.
Мы принимаем eventual‑консистентность отображения. Страницы могут быть из разных временных срезов, при обновлении/сбросе фильтра кэш инвалидируется. Целостность гарантируется только на уровне записи через оптимистичную блокировку по timestamp.
Стандартное решение для пагинации в SQL Server — OFFSET... FETCH NEXT. Проблема: На глубоких страницах СУБД сканирует и отбрасывает миллионы строк, что делает запрос медленным. Но у нас предусмотрена возможность сортировки данных по любым полям в запросе. А значит пришлось пожертвовать скоростью ради гибкости. Для пользователей это не столь заметно, ведь на «глубокие» страницы по индивидуальной сортировке они не часто заходят.
Если запрос сам по себе тяжёлый, мы можем в настройках ограничить глубину пагинации.
Остановимся на загрузке данных: Модель + LRU‑кэш + Троттлер
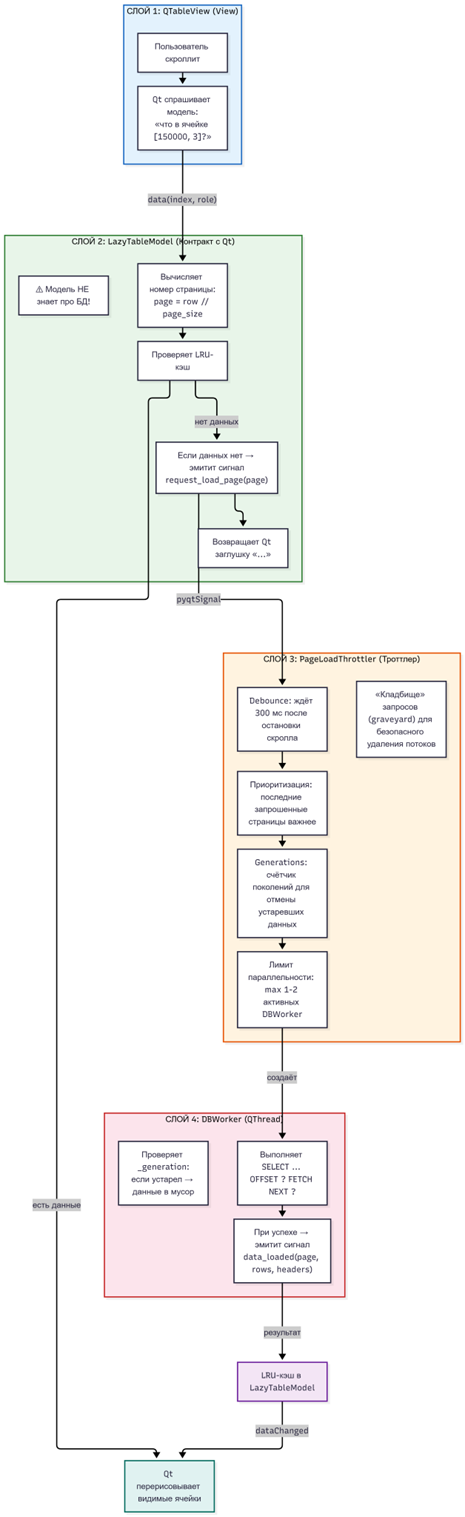
Слой 1 — 2: Модель
Главный архитектурный принцип: модель не знает про базу данных. Она знает только про данные и кэш. Когда Qt запрашивает ячейку, модель вычисляет, на какой странице она находится, и либо отдаёт данные из кэша, либо испускает сигнал‑заявку «загрузите мне страницу N».
Это позволяет изменить источник данных без изменения модели.
LRU‑кэш: почему именно он?
В памяти хранится только то, что пользователь смотрит прямо сейчас, плюс несколько загруженных ранее страниц (задаётся в настройках). Если пользователь вернулся — первые станицы всё ещё в кэше и отрисуются без обращения к базе.
При собственных INSERT/DELETE все последующие страницы сдвигаются на 1 строку.
Слой 3: Троттлер — защита от большого числа запросов к базе
Троттлер необходим для того, чтобы при быстрой прокрутке пользователем колёсика мыши к базе данных не «направлялась» лавина запросов.
Временной интервал (пауза с момента остановки прокрутки) по истечении которого направляется запрос к базе подобрали опытным путём — 300 мс.
Но при прокрутке всё равно все запросы могут не успевать отрабатывать. В результате копится «очередь». Последние запрошенные страницы считаются самыми нужными. Если пользователь быстро проскроллил 10 страниц, грузиться будет только последняя (та, на которой остановилась прокрутка). При этом длин «очереди» ограничена — наиболее ранние не выполненные запросы «удаляются».
Поколения. Смена фильтра приводит к ому, что ранее направленные к базе данных запросы (но не выполненные на момент смены фильтра) становятся не актуальны. За это отвечает счётчик поколений (_generation) который увеличивается на 1 при каждом изменении фильтра (сортировки). Все QThread, которые ещё не успели вернуть данные, при попытке возврата данных проверяют этот счётчик. Если он не совпадает — данные «выбрасываются». UI никогда не получит «устаревшие» данные от старого запроса.
«Кладбище воркеров». QThread нельзя просто удалить — C++ объект может ещё выполняться. Переносим завершённые потоки в отдельный список (_graveyard), и таймер раз в секунду безопасно вызывает удаление тех, чьи потоки действительно завершились.
Слой 4: Воркер как изолированная единица работы
Каждый DBWorker — это один QThread с одной задачей: выполнить запрос и вернуть данные через сигнал. Это его единственная задача.
DBWorker берёт соединения из пула (общего на всё приложение — держит 5 постоянных соединений + 5 при высокой потребности), одновременно работает не более 2 DBWorker на загрузку данных для одной таблицы.
Рассмотрим алгоритм работы LazyTableModel.
Шаг 1. Qt спрашивает модель: «что в ячейке?»
Когда строка (например, 150 000) попадает в видимую область, Qt (self.table) вызывает метод data() self.model для каждой видимой ячейки. Модель вычисляет, на какой странице находится эта строка, и ищет данные в кэше.
class LazyTableModel(QAbstractTableModel):
    request_load_page = pyqtSignal(int)
    …
    def data(self, index, role=Qt.DisplayRole):
        if role not in [Qt.DisplayRole, Qt.EditRole]:
            return QVariant()
        if not index.isValid():
            return QVariant()

        page_idx = index.row() // self.table_inf.page_size      # 150000 // 100 = 1500
        row_in_page = index.row() % self.table_inf.page_size    # 150000 %  100 = 0

        page_data = self._cache.get(page_idx)
        # ПРОВЕРКА: есть ли данные в кэше и не грузится ли страница
        b_data_available = (
            page_data is not None
            and row_in_page < len(page_data['data'])
        )

        if not b_data_available and page_idx not in self._loading_pages:
            self.request_load_page.emit(int(page_idx)) # сигнал наружу
                                                       #(запрос загрузки страницы)
            return "..." # заглушка

        if b_data_available:
            # колонка 0 на форме служебная (чекбоксы выбора),
            # поэтому данные начинаются с колонки 1 (т.е. смещаются на 1)
            val = page_data['data'][row_in_page][index.column() - 1]
            # … Упускаем дополнительную обработку значения …
            return str(val) if val is not None else ""
        else:
            return QVariant()
Ключевая строка — self.request_load_page.emit(int(page_idx)). Модель не знает про БД, про потоки, про троттлер. Она просто запрашивает недостающую страницу.
Шаг 2. Модуль формы принимает сигнал и вызывает метод троттлера
Объявления в модуле формы:
self.model = LazyTableModel()
self.table = Class_QTableView_modify()
self.table.setModel(self.model)
self.model.request_load_page.connect(self._on_page_requested)

def onpage_requested(self, page_index):
  …
  # Проверки необходимости вызова троттлера (грузится ли страница)
  …
  self.page_throttler.request_page(
      page_index=page_index,
      sql_query=self.request_active__sql_query,
      where_params=self.request_active__where_params,
      select_order_by=self.request_active__order_by,
      b_empty_result=self.request_active__b_empty_result,
      immediate=(page_index == 0 and self._is_refreshing),
  )
Параметры запроса (значения условий фильтрации которые вводит пользователь) передаются отдельно в виде списка (where_params) это стандартный паттерн параметризованных запросов для защиты от инъекций.
Шаг 3. Троттлер принимает заявку и ставит таймер — 300 мс.
В троттлере объявлен таймер — для отложенного запуска flushpending
self._debounce_timer = QTimer(self)
self._debounce_timer.setSingleShot(True)
self._debounce_timer.setInterval(debounce_ms)
self._debounce_timer.timeout.connect(self._flush_pending)

 ...

def request_page(self, page_index, sql_query, where_params,
                 select_order_by, b_empty_result=False, immediate=False):
        """
        Запрос на загрузку страницы.
        Параметры
        ---------
        page_index : int
            Индекс страницы.
        sql_query : str
            SQL-запрос (SELECT ... FROM ...).
        where_params : list (передаётся отдельно для защиты от инъекций)
            Параметры для WHERE-условия.
        select_order_by : str
            ORDER BY выражение.
        b_empty_result : bool
            True = заведомо пустой результат (дочерняя таблица без родителя).
        immediate : bool
            True = загрузить немедленно, без debounce
            (первая страница при select_data).
        """

    self._last_request_time = time.monotonic() # устанавливаем время,
                                               # когда пришла заявка

    request_data = {
        'page_index':      page_index,
        'sql_query':      sql_query,
        'where_params':    where_params,
        'select_order_by': select_order_by,
        'b_empty_result':  b_empty_result,
    }

    # Убираем дубликат этой страницы из очереди (если был)
    self._pending = [r for r in self._pending if r['page_index'] != page_index]
    # Ставим в конец очереди
    self._pending.append(request_data)
    if page_index in self._active:
        return  # уже грузится — не дублируем


    # При немедленной загрузке страницы останавливаем таймер (если запущен)
    # и запускаем загрузку
    if immediate:
        if self._debounce_timer.isActive():
            self._debounce_timer.stop()
        self._flush_pending()
    else:
        self._debounce_timer.start()   # ставим загрузку через 300 мс.
                                       # (запуск flushpending)
Время, когда пришла заявка устанавливаем через time.monotonic(). time.monotonic (в отличие от time.time) — монотонные часы идут только вперёд и не подвержены скачкам при синхронизации времени или ручном переводе часов. В нашем случае это обязательное условие для корректной работы.
Шаг 4. 300 мс прошло … проверяем нужно ли грузить страницу
def flushpending(self):
    """
    Debounce-таймер сработал — скролл остановился.

    Логика:
    1. Не ушёл ли новый запрос за время ожидания
    2. Усекаем pending до maxconcurrent (оставляем самые свежие)
    3. Убиваем активные воркеры, которых нет в _pending
    4. Запускаем то, что есть в pending, но ещё нет в active
    """

    # 1. Проверка: не пришёл ли более свежий запрос за время ожидания
    elapsed = time.monotonic() - self._last_request_time
    if elapsed < self._debounce_ms / 1000.0:
        # За время ожидания таймера пользователь сформировал новый запрос.
        # Таймер для него уже перезапущен в request_page() — просто выходим.
        # Подстраховка: если таймер по какой-то причине не активен — запускаем.
        if not self._debounce_timer.isActive():
            self._debounce_timer.start()

        return
    # проверяем сколько воркеров сейчас грузят данные
    # (активные - len(self._active) + те что отправлены «на кладбище» -
    # len(self._graveyard))

    # если больше чем maxtotal_workers -
    # откладываем загрузку текущей страницы на 300 мс
    # и выходим - чтобы не грузить базу
    if self._max_total_workers <= len(self._active) + len(self._graveyard):
        if not self._debounce_timer.isActive():
            self._debounce_timer.start()
        return

    if self._debounce_timer.isActive():
        self._debounce_timer.stop()

    # нечего грузить - выходим
    if not self._pending:
        return

    # 2. Усекаем очередь: оставляем только max_concurrent самых свежих
    #    Конец списка = самые новые = самые нужные пользователю
    if len(self._pending) > self._max_concurrent:
        discarded = self._pending[:-self._max_concurrent]
        self._pending = self._pending[-self._max_concurrent:]

        # Убиваем воркеры для выброшенных страниц
        discarded_pages = {r['page_index'] for r in discarded}
        for page_index in list(self._active.keys()):
            if page_index in discarded_pages:
                # отправляем на кладбище воркеров (self._graveyard)
                self._kill_worker(page_index)

        for request in discarded:
            if request['page_index'] not in discarded_pages & set(self._active.keys()):
                self.page_cancelled.emit(request['page_index'])

    # 3. Отправляем на кладбище активные воркеры, которых НЕТ в усечённом _pending
    #   (на случай если _pending изменился между flush-ами)
    pending_pages = {r['page_index'] for r in self._pending}
    stale = [p for p in self._active if p not in pending_pages]
    for page_index in stale:
        self._kill_worker(page_index)

    # 4. Запускаем то, что в pending, но ещё не работает в active

    for request in self._pending:

        if request['page_index'] not in self._active:

            self._start_worker(request)
Шаг 5. Создаём воркер, подключаем сигналы
def startworker(self, request: dict):
    """Создаёт DBWorker и запускает его."""
    generation = self._generation

    worker = DBWorker(
        page_index=page_index,
        page_size=self._table_inf.page_size,
        select_order_by=request['select_order_by'],
        sql_query=request['sql_query'],
        where_params=request['where_params'],
        b_empty_result=request['b_empty_result'],
        engine=self._engine,
        arr_columns_description=self._arr_columns_description,
    )

    # Подключаем сигналы воркера к внутренним обработчикам
    worker.data_loaded.connect(
        lambda pi, rows, headers, g=generation: self._on_worker_data(pi, rows, headers, g)
    )
    worker.error_occurred.connect(
        lambda msg, pi=page_index, g=generation: self._on_worker_error(pi, msg, g)
    )
    worker.work_finished.connect(
        lambda pi=page_index, g=generation: self._on_worker_finished(pi,g)
    )

    self._active[page_index] = worker
    worker.start()
Шаг 6. Воркер в отдельном потоке делает запрос SELECT
class DBWorker(QThread):

    data_loaded    = pyqtSignal(int, list, list)
    # Описание параметов сигнала в порядке следования:
    # page_index: номер загруженной страницы (0, 1, 2...)
    # rows: список строк данных (каждая строка — кортеж значений)
    # headers: список имён колонок

    error_occurred = pyqtSignal(str)
    # Текст ошибки (если подключение или запрос не удались)
    work_finished       = pyqtSignal()
    # Поток завершил работу — можно удалить объект (освободить память)

    def run(self):
        headers = [co.column_name for co in self.arr_columns_description] if self.arr_columns_description else []
        # если не нужно возвращать данные - просто даём пустоту и выходим
        if self.b_empty_result:
            self.data_loaded.emit(int(self.page_index), [], headers)
            return

        try:
            # Вычисляем смещение: страница 0 = 0 строк, страница 1 = 100 строк, и т.д.
            offset = self.page_index * self.page_size
            # наращиваем на OFFSET ? ROWS FETCH NEXT ?
            s_sql = f"""
                {self.sql_query}
                ORDER BY {self.select_order_by}
                OFFSET ? ROWS FETCH NEXT ? ROWS ONLY
            """
            params = list(self.where_params) + [offset, self.page_size]
            with self.connect_pool.get_connection() as conn:
                with conn.cursor() as cur:
                    cur.execute(s_sql, params)
                    rows = cur.fetchall()

            if not self._cancelled:
                # успешная загрузка
                self.data_loaded.emit(int(self.page_index), rows, headers)

        except Exception as e:
            # Любая ошибка БД → отправляем текст ошибки в UI для показа пользователю
            # str(e) преобразует исключение в читаемый текст
            self.error_occurred.emit(str(e))
        finally:
            self.work_finished.emit()
Успешная загрузка направляет сигнал data_loaded.
Шаг 7. Троттлер получает сигнал и после проверки Поколения испускает его в окно
def onworker_data(self, page_index: int, rows: list, headers: list, generation : int):
    """Воркер вернул данные — пробрасываем наружу."""
    if generation != self._generation:
        return # устаревшие данные — игнорируем
    self.page_loaded.emit(page_index, rows, headers)
_generation — поколение. При смене фильтров, обновлении данных пользователем счётчик Поколения увеличивается на 1.
Шаг 8. Основное окно (с формой таблицы)
Принимает данные и наполняет ими модель
def ondata_loaded(self, page_index, rows, headers):
    """Обработчик успешной загрузки страницы"""
    self.model.add_page_to_cache(page_index, rows, headers)
    self._update_status()
Шаг 9. Обновляем станицы в модели
def add_page_to_cache(self, page_index, rows, headers):
    """
    Добавляет загруженную страницу в кэш.
    Параметры:
    - page_index: номер страницы
    - rows: список строк данных (из БД)
    - headers: список имён колонок
    Это метод-обработчик: вызывается из главного окна, когда DBWorker завершил загрузку.
    Логика:
    1. Если заголовки ещё не установлены — устанавливаем (из первой страницы)
    2. Разделяем данные и временные метки (для Optimistic Locking)
    3. Добавляем страницу в LRU-кэш
    4. Убираем из множества "загружаемых"
    5. Сообщаем Qt, что данные изменились (перерисовать диапазон ячеек)
    """
    # Если заголовки ещё не установлены — устанавливаем (из первой страницы)
    if headers and not self._headers:
        self.set_headers(headers)
    if not rows:
        return
    data_rows = list(rows)
    # Добавляем страницу в LRU-кэш
    self._cache.put(page_index, {'data': data_rows})
    # Убираем из множества "загружаемых" (можно запрашивать снова при необходимости)
    self._loading_pages.discard(page_index)
    # Сообщаем Qt, что данные в диапазоне строк изменились (перерисовать)
    # dataChanged.emit() заставляет Qt вызвать data() для всех ячеек диапазона
    start_row = page_index * self.table_inf.page_size  # Глобальный индекс
                                                       # на первой строки на странице
    end_row = start_row + len(rows)
    self.dataChanged.emit(
        self.index(start_row, 0), # Начальная ячейка диапазона (строка, колонка 0)
        self.index(end_row - 1, self.columnCount() - 1), # Конечная ячейка
        [Qt.DisplayRole] # Какие роли изменились (только текст)
    )
Что получилось
Таблицы до 20 млн строк открываются и скроллятся без заметных задержек. SQL Server не получает лавину запросов при быстром скролле — троттлер гасит всё до 1-2-х запросов. Модель не знает про БД, потоки не знают про UI — каждый слой можно менять независимо.
Что не идеально
Python для интерфейса сам по себе не идеален — но работает и неплохо. OFFSET на глубоких страницах (миллион+) притормаживает — это известно и принято как компромисс ради универсальной сортировки.
За рамками статьи остались многопоточность и жизненный цикл QThread, оптимистичные блокировки при редактировании, Excel ETL‑пайплайн, Data‑Driven конструктор форм. Если будет интерес — распишу в отдельных заметках.