В игре на пару тысяч NPC самая дорогая по памяти структура данных не меш или скелет, и не физический коллайдер и даже не навигационная сетка, а характеристика вида health = 100. Если писать её по правилам, как учат в книжках по C++, то она займёт 880 байт на персонажа, сделает 14 аллокаций и потратит 27 наносекунд на чтение одного числа, но полезных данных там там так и останется 20 байт.
Расскажу как одной стратегии мы превратили 880 байт в 64, убрали аллокации и подружили структуры с кешем. Вам, вероятно, пригодится понимание, что такое указатель и что такое аллокация, если вы пришли не из мира С/С++ и надо будет вспомнить что кеш-линия на современном процессоре равна 64 байтам и читается целиком, даже если вам нужен был из неё один байт или хуже того бит, ну прочитать что такое AoS и SoA, если вы вдруг с такими понятиями не сталкивались, а остального в тексте хватит.
Итак... нафига козе аккордеон на похоронах? В проекте был компонент, который хранил для сущности небольшой объём произвольных данных (например их задавал дизайнер в редакторе), классический лист персонажа:
name = "The One"
stats = {
    health = 100
    mana = 200
}
status_effects = {
    drunk = true
    delirious = true
}
Кто-то очень торопливый положил эти данные в урезанный JSON (так было удобно на момент выполнения задачи). В таком формате разрешены только булевы значения, числа с плавающей точкой, строки, объекты и массивы чисел, парсер для него тоже очень простой и пишется буквально на коленке за вечер, дело было лет пять назад, так что можно было с уверенность сказать, что никакой Клавдий при создании сего шедевра не пострадал. Произвольные массивы тоже под запретов и если вам нужен список предметов, то вы делаете объект, ключами которого будут GUID-ы.
Запрет выглядит как вредность автора формата, но что выросло, то выросло, и исходя из желания левой пятки автора наша строка и массив чисел считаются монолитными, то есть неделимыми при мерже, и тогда любая операция над данными сводится к «присвоить значение такому-то ключу».
А это значит, что две правки всегда мержатся предсказуемо и если дизайнер в редакторе поменял stats.health, а дизайнер в другой ветке сделал что-то нехорошее с status_effects.drunk, то мерж обеих правок не требует разрешения конфликтов и ожидания ревью. Попробуйте сделать это самое с произвольным вложенным массивом, где один человек вставил элемент в середину, а второй удалил третий с конца, и вы быстро поймёте, почему массивы объектов плохо прижились для таких конфигов.
Сетевому коду от этого ограничения тоже становится хорошо и операция «присвоить ключу значение» будет идемпотентной, т.е. её можно отправлять, терять, пересылать и применять повторно без последствий, в отличие от «вставить в массив». Считаем, что данных у одной сущности мало, сущностей много, и нам важны и память, и скорость, потому что тысяча NPC на уровне, где у каждого отдельный лист или список свойств, или пар ключ-значение, это наш рабочий случай.
Наивный подход
Можно взять STL и описать дерево, в котором будут лежать и строки, и массивы, что дате нам примерно такой вид:
enum class DataType { BOOL, FLOAT, STRING, OBJECT, ARRAY };

struct DataValue
{
    DataType type;
    union {
        bool b;
        float f;
        std::string *s;
        std::vector<float> *array;
        std::map<std::string, DataValue> *object;
    };
};
Но выглядит это хорошо только в теории, потому что внезапно STL хочет под это дело аллокации, как явные вроде (new std::string), так и неявные внутри string, внутри vector и внутри каждого узла std::map, который на каждую пару ключ-значение выделяет отдельный узел с тремя указателями и цветом и получаете вы лист персонажа из пяти ключей, который занимает 880 байт, храня там реально только 20:
naive : allocs=14000 (14.0/сущность) bytes=880000 (880.0/сущность) lookup=27.0 ns/get
При современных объемах это смешные копейки, но даже так проблема все равно проявляется когда у персонажа таких ключей не одна сотня, и хорошо если только сотня, а не под тысячу. И вот уже ваша std::map внури сущности со стандартной раскладкой в памяти начинает реально влиять на время кадр.
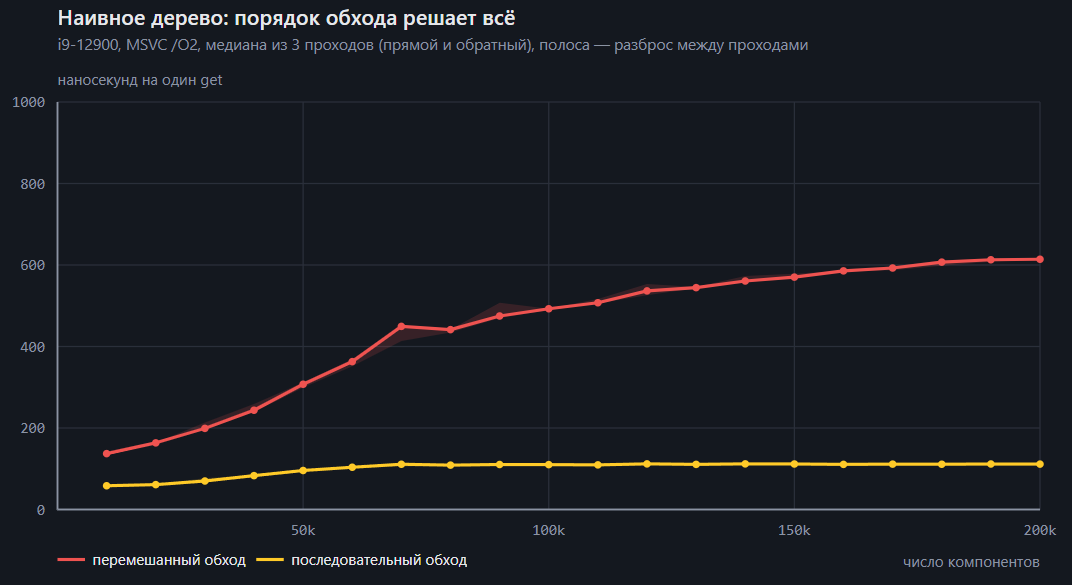
Итак... получаем 880 байт и 14 аллокаций ради health, mana, двух флагов и короткого имени. Причём 27 наносекунд на чтение это ещё очень хороший результат, потому что в бенчмарке у меня вся эта тысяча конфиговых конфигов умещается в кеш целиком и ходить в оперативку по-настоящему не приходится. А чтобы посмотреть, что бывает, когда данные в кеш не лезут, надо сделать тот же наивный вариант уже на ста тысячах компонентов... сто тыщ я тут взял из головы, просто число красивое, и даже так это все равно было быстрее чем в реальном коде игры:
naive tree : allocs=900000  bytes=54400000 (544 B/сущность)
             последовательный обход   =  79..96 ns/get
             перемешанный обход       = 352..429 ns/get
Т.е. нам понадобилось четыреста наносекунд, чтобы узнать, что у одного несчастного бриттона есть на данном кадре сто хитов здоровья. А теперь представим что эти данные обрабатываются в порядке сортировки по дистанции до игрока, или по приоритету LOD, или по тому, в каком порядке их выплюнул бродкаст физики, то есть вы практически никогда не получите их в порядке адресов и перемешанный доступ в такой системе не пессимистичная оценка, а норма жизни, дальше смело умножаем это время на 2-3, потому что ему будут мешать соседние системы нашей же игры периодические вытесняя из кеша, о чем опять же никто не вам не скажет, пока вы сами глазками не полезете смотреть почему фпс упал.
Шаг 1: хешируем ключи
Первое наблюдение в такой системе приходит, когда вы долго смотрите на неё в отладчике или перф профайлере... Приходит осознание, что нам никогда не нужны сами строки ключей и мы всегда либо пишем значение по ключу, либо читаем значение по ключу, но никогда не перечисляем ключи, чтобы показать их пользователю, и значит, вместо строки можно хранить её хеш или что-то другое, и поскольку ключей у одной сущности мало, то и 32 и 16 и даже 8 бит иногда может хватить с запасом:
std::map<unsigned, DataValue> *object;
И легким движением руки... джинсы превращаются в элегантные шорты, т.е. исчезает по аллокации на каждый ключ, а вместе со строкой уходят все строковые сравнения при поиске, а сравнивать unsigned процессор умеет намного лучше и быстрее, чем даже самый короткий std::string.
Но как вы знаете платить приходится за все, и теперь в дампе памяти у нас лежит 0x7a3c91f4, и уже никто не скажет, что это был stats.health. Поэтому мы заводим дополнительную таблицу «хеш → строка», которая в релизной сборке выкидывается, а в дебажной мы пишем немного кода, который раскрывает хеши в строки. Можно это сделать прямо в natvis студии, и обычный программист этого даже не заметит, а коллизии на горстке ключей одной сущности будем чинить пинанием дизайнеров, чтобы они не заводили таких ключей, которые дают колизии.
Шаг 2: расплющиваем дерево
Второе наблюдение приходит, после недели попыток обмануть STL мапу и заставить её работать быстрее, и когда кто-то из команды предлагает хранить не объект, а просто ключи-значения, то оказывается, что дерево можно расплющить целиком и вместо
name = "The One"
stats = { health = 100, mana = 200 }
мы начинаем хранить
name = "The One" <<< это уже unsigned
stats.health = 100
stats.mana = 200
И ключ stats.health тоже делаем через unsigned, просто хешируем мы его не как строку stats.health , а по частям. Сначала отдельно stats, потом отдельно health, потом два хеша смешиваем еще одним хитрым хешом и получаем новый уникальный хеш-ключ, такая вот хитрах хеш-математика.
Теперь иерархия существует только в голове дизайнера и в редакторе и прочитать stats.health можно, но попросить такую мапу а «перечисли всё, что лежит в stats уже нельзя. Но на практике это оказывается работающим вариантом, потому что код всегда знает, какой ключ ему нужен, а перечисление нужно только редактору. Платить как вы помните приходится за всё, поэтому в редакторе у нас появляется новая схема данных для свойств персонажа, зато все дерево свойств превратилось в плоский массив:
struct Entry
{
    unsigned key;
    DataType type;
    union {
        bool b;
        float f;
        std::string *s;
        std::vector<float> *array;
    };
};

std::vector<Entry> data;
Теперь никакой структуры для поиска здесь больше нет, и чтобы найти ключ, нужно линейно проскакать по массиву, что может звучать как шаг назад и выглядит на код-ревью подозрительно, пока вы не померяете цифры перфа. А они говорят, что линейный проход кеш любит, и на разумных размерах (<1000) обгоняет любой самый быстрыйstd::map с её прыжками по памяти. А еще можно отсортировать ключи и делать бинарный поиск, но на ста записях и меньше возня с сортировкой обойдётся дороже, чем сам поиск.
naive      : allocs=14000 (14.0/ent) bytes=880000 (880.0/ent) lookup=27.0 ns/get
flat AoS   : allocs=6000  ( 6.0/ent) bytes=288000 (288.0/ent) lookup= 1.0 ns/get
И вот наши 880 байт превратились в 288, а 14 аллокаций в 6, что дает нам время поиска на горячем кеше и пяти ключах почти 1 нс.
Шаг 3: переписываем в SoA
Теперь мы линейно ищем ключ, но в кеш вместе с ключами подтягиваются type и значение, которые при поиске нам вообще-то не нужны и приходится на каждую 16-байтовую запись Entry таскать лишние байты, то есть три четверти каждой прочитанной кеш-линии будет просто условным мусором, который вам все равно надо грузить. Поэтому мы идем дальше и разбиваем массив структур на структуру массивов.
std::vector<unsigned>  keys;
std::vector<DataType>  types;
std::vector<Value>     values;
Теперь при поиске мы читаем только keys, и в кеш-линию вместо четырёх записей влезает шестнадцать, что теоретисчески позволяет надеяться на четырёхкратное ускорение, но нет:
вариант | время поиска | прочитано | аллокаций |
|---|---|---|---|
AoS, 16 байт на запись | 90…96 нс | 640 байт, 10 кеш-линий | 6 на компонент |
SoA, три | 87…105 нс | 160 байт, 3 кеш-линии | 16 на компонент |
| 150…163 нс | — | — |
Данных в кеш влезает вчетверо больше, но время не изменилось, потому красиво было только в теории из статей про data-oriented design. Мы действительно прочитали 160 байт вместо 640, но лежат эти 160 байт в трёх разных местах памяти и наши три std::vector все равно будут тремя независимыми аллокации. Получается мы обменяли один промах кеша на три и сэкономленную пропускную способность отдали обратно в виде лишних походов в память.
Шаг 4: складываем массивы в один буфер
Красная и синяя линии и есть наш третий шаг, как говорится "найдите между ними разницу"
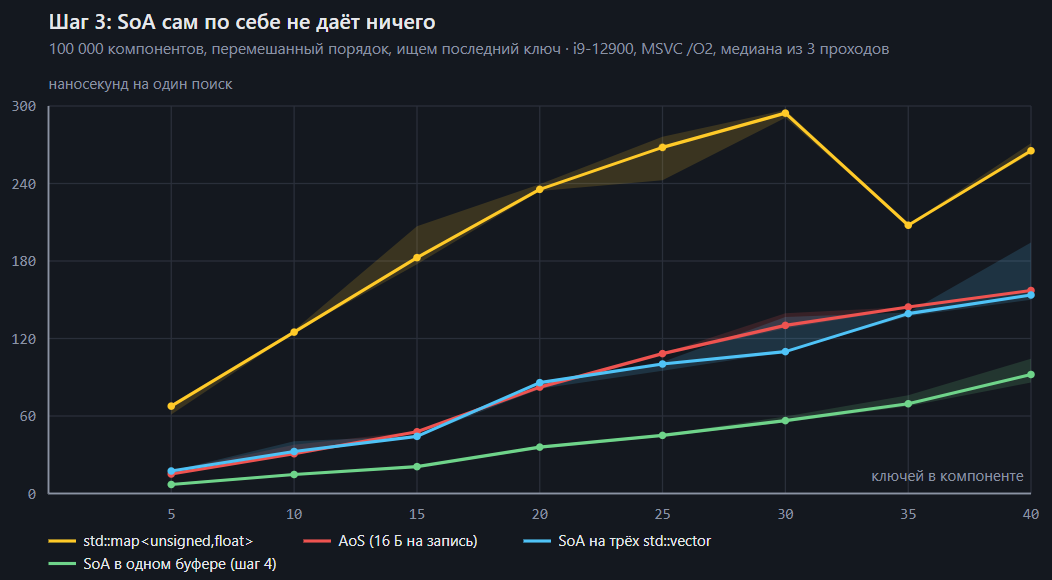
Красная линия (AoS), синяя (SoA на трёх векторах) идут вплотную друг к другу на всей развёртке, то пересекаясь, то расходясь на какие-то проценты. Жёлтая сверху это медленный std::map для ориентира, а зелёная внизу это то, к чему мы придём чуть позже.
Чтобы избавиться от трёх аллокаций, придётся расстаться с нашим любимымstd::vector и сделать свой не менее любимый vector3, с преферансом и дамами. Если вы посмотри как устроен вектор внутри, то это будет что-то вроде такого (упрощенно):
struct {
    int capacity;
    int size;
    unsigned *data;
};
а значит наши три вектора можно записать как
int        capacity;
int        size;
unsigned  *keys;
DataType  *types;
Value     *values;
и заметить что capacity и size у всех трёх массивов всегда одинаковые и меняются одновременно, так что их достаточно по одному на всю структуру. Значит растут и перевыделяются массивы тоже одновременно, а это позволяет нам выделить один буфер и разложить там данные друг за другом:
       -----------------------------------
buffer |   keys   |   types   |  values  |
       -----------------------------------
char *buffer = allocate(capacity * (sizeof(unsigned) + sizeof(DataType) + sizeof(Value)));
keys   = (unsigned *)buffer;
types  = (DataType *)(keys + capacity);
values = (Value *)(types + capacity);
Вот теперь SoA начинает показывать то, что обещает теория и авторы статей по DoD:
вариант | время поиска | прочитано | аллокаций |
|---|---|---|---|
AoS, 16 байт на запись | 90…96 нс | 640 байт | 6 |
SoA, три | 87…105 нс | 160 байт | 16 |
SoA в одном буфере | 55…60 нс | 160 байт | 1 |
Теперь мы получили прирост 1.6х по времени и всего одну аллокация вместо шестнадцати, это и есть наша зелёная линия на графике выше. Шаги 3 и 4 работают исключительно в паре, и если вы внедрите только первый, то потратите день на рефакторинг и получите ноль перфа, причём ноль, который ещё и аллокаций добавил.
Блэкборд ИИ как компонент
Прежде чем идти дальше, стоит сказать, зачем вообще нужна структура, в которой ключи задаёт не программист. Лист персонажа это самый очевидный случай, с которого я начал изменения в движке игры, но, если честно, - он редкий. Скорость мы тут конечно получаем на чтении данных, но это проценты от всего времени кадра.
Гораздо интереснее переделать блэкборд ИИ - это мини таблица, где персонаж (монстр, NPC) хранят свои текущие параметры работы. Это такая же таблица «ключ -> значение» на сущность, в котором живут threat.last_seen_pos, threat.confidence, nav.stuck_timer, squad.role, combat.reload_pending и ещё сотни других ключей, которые по ходу разработки добавляют и выкидывают, не трогая C++. А вот читается такая таблица каждый кадр каждым агентом сотни раз: дерево поведения или автомат состояний на каждом тике опрашивает блэкборд, чтобы решить, стрелять, бежать или стоять.
И тут становится понятно, зачем я выше мучил бенчмарк перемешанным доступом. Просто двести агентов обходятся не в порядке своих адресов в памяти, а в порядке важности, или дистанции до игрока, или по спискам, которые раздал планировщик задач. При наивном дереве каждый опрос блэкборда это все будет ~400 наносекунд, при двадцати обращениях за тик на агента и двухстах агентах это получается уже полторы миллисекунды на кадр, потраченные исключительно на ходьбу по указателям. Не на принятие решений, не на поиск пути, а просто на чтение чисел, которые уже и так лежат в памяти.
В предыдущих статьях про NavMesh и про NPC я показывал, как двести солдат утыкаются в одни ворота и как лишняя тысяча запросов пути убивает кадр... Вот здесь это та же самая история, только про память. Сам алгоритм в порядке, а умирает всё на доставке данных до алгоритма.
Шаг 5: выкидываем STL
В Value у нас всё ещё лежат указатели на STL-типы:
std::string        *s;
std::vector<float> *array;
Польза от них на этом этапе закончилась, потому что весь STL устроен вокруг отдельных аллокаций на каждый объект. Плюс здесь остается две ступени косвенности, когда сначала указатель на std::vector, потом указатель на данные внутри него, значит конструируем собственный велик и заменяем на самодельные эквиваленты:
struct { char *data; } s;
struct { int capacity; int size; float *data; } array;
Складываем все строки и все массивы чисел в один большой буфер:
-------------------------------------------------------------
| "hello" | [0 1 3] | "mana" | [0 2] | ... свободно ....... |
-------------------------------------------------------------
И пишем для него простой аллокатор:
struct ValueBuffer { char *p; unsigned capacity; unsigned size; };

void *allocate_memory(ValueBuffer &vb, unsigned size)
{
    if (vb.size + size > vb.capacity)
        return nullptr;                 // вызывающий перевыделит буфер побольше
    auto res = vb.p + vb.size;
    vb.size += size;
    return res;
}
Это обычный bump-аллокатор, который умеет только выделять и не умеет освобождать, поэтому место в буфере может закончиться, но оказывается с этим можно жить. Есть еще небольшая проблема, если значение может изменить размер, например дизайнер поправил имя с "The One" на "The One (deprecated, не удалять, спросить у Васи)", и в прежнее место оно не влезает, тогда приходится выделять новое место в конце, а на прежнем остаётся дырка:
-------------------------------------------------------------
| ....... | [0 1 3] | "mana" | [0 2] | "The One (depre..." |
-------------------------------------------------------------
Дырки это фрагментация, и в универсальном аллокаторе это было бы проблемой, но теперь нам на неё, в общем-то, наплевать, хотя это и неприятный момент. Просто у нас мало элементов, и все указатели на них контролируем мы сами, поэтому мы в любой момент можем переложить значения и дефрагментировать буфер. Но даже этого делать не нужно, потому фрагментация просто в какой-то момент приведёт к исчерпанию буфера, буфер перевыделится, и при копировании дырки сами исчезнут. Получаем дефрагментацию бесплатно, как побочный эффект роста.
Универсальный аллокатор так не может, потому что он не знает, кто и откуда ссылается на его блоки, а мы знаем. Вообще знать структуру своих данных это главный источник выигрыша во всей этой магии, поэтому и специализированный аллокатор тут появился и умеет, чего не умеет общий. И не потому, что он хитрее написан, там вообще копеечный код, собранный на коленке, а потому, что про свои данные он знает всё.
Шаг 6: сжимаем Value
Теперь все данные значений лежат в одном буфере, а значит ссылаться на них можно не указателем, а смещением от начала буфера и если указатель на x64 это 8 байт, то смещение можно сделать простым интов (4 байта), а на наших объёмах даже меньше и тогда для коротких строк и массивов даже 64 КБ хватит с избытком, то есть смещение и размер вместе укладываются в 32(16) бита:
struct Data {
    uint16_t offset;
    uint16_t size;
};

struct Value {
    union {
        bool  b;
        float f;
        Data  data;   // и для строк, и для массивов чисел
    };
};
Value теперь занимает 4 байта вместо 8 у STL-версии, но главное тут не экономия, потому что теперь у на появились смещения, которые, в отличие от указателей, не нужно патчить при перемещении буфера и буфер можно переложить куда угодно, или скопировать, или сжать, или даже записать на диск и прочитать обратно в другой процесс по другому адресу и всё внутри останется валидным.
sizeof: DataValue=16  Entry=16  Value=8  SlimValue=4
        std::map=16   std::string=32     std::vector=24
Шаг 7: сливаем последние два буфера
Осталось немножко... у нас осталось два буфера: заголовки (ключи и типы) и значения (строки и массивы), а хочется вообще один, чтобы вообще по красоте было. Тогда мы наивно кладём их друг за другом:
--------------------------------------------------------
| Header      | Values     | ....... свободно ........ |
--------------------------------------------------------
Но наивно тут не работает, и заголовки не могут вырасти, не сдвинув значения, тогда даём каждому немного свободного места:
----------------------------------------------------------
| Header      | ..свободно.. | Values     | ..свободно.. |
----------------------------------------------------------
Теперь расти могут оба, но свободное место используется неэффективно и значения упираются в свою границу, когда у заголовков ещё половина резерва пустует, тогда мы делаем аллокатор, который умеет растить данные с двух концов, я про такой уже рассказывал:
----------------------------------------------------------
| Header      | ....... свободно ........ |     Values   |
----------------------------------------------------------
Значения выделяем не снизу вверх, а сверху вниз, навстречу заголовкам и теперь свободное место теперь общее, и перевыделять буфер нужно только когда они встретятся посередине. Эта идея как стек растёт навстречу куче, в больших программах вы это можете увитеть в отладчике, только локальная для конкретной задачи.
Что нам это дало
naive      : allocs=14000 (14.0/ent) bytes=880000 (880.0/ent) live=880000
flat AoS   : allocs=6000  ( 6.0/ent) bytes=288000 (288.0/ent) live=128064
SoA        : allocs=16000 (16.0/ent) bytes=240000 (240.0/ent) live=110032
one buffer : allocs=1000  ( 1.0/ent) bytes=64000  ( 64.0/ent) live=64000
           : клонирование через memcpy = 0.5 ns/компонент
вариант | аллокаций | память | последовательно | перемешанно |
|---|---|---|---|---|
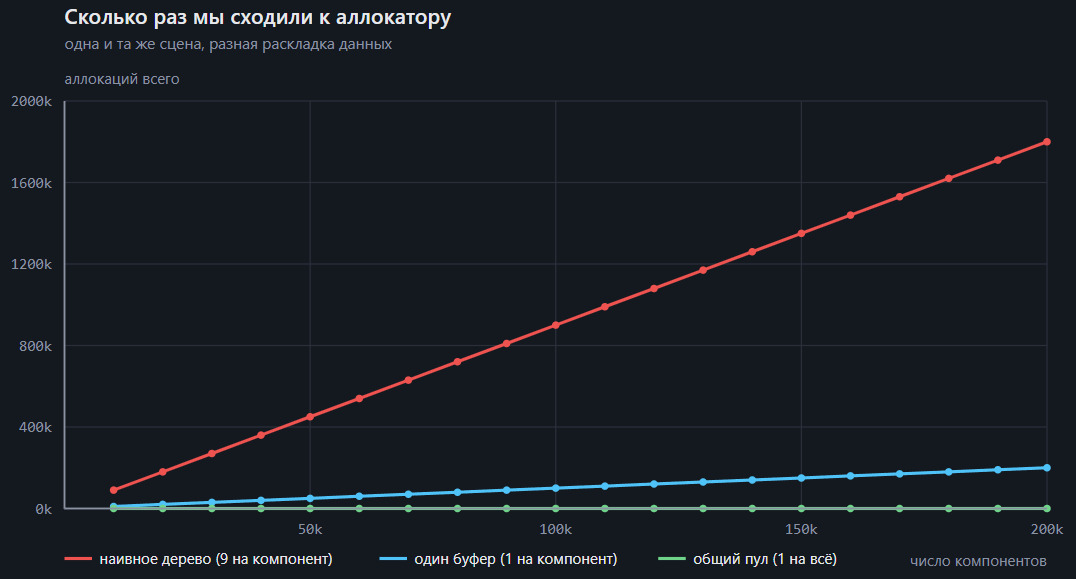
наивное дерево | 900 000 | 544 Б/сущность | 79…96 нс | 352…429 нс |
один буфер | 100 000 | 64 Б/сущность | 4.1…5.9 нс | 9.4…10.1 нс |
544 байта превратились в 64, девять аллокаций в одну, 350–430 наносекунд стали 9,5. Т.е. прирост получился примерно сорок раз на том доступе, который в реальной игре и происходит.
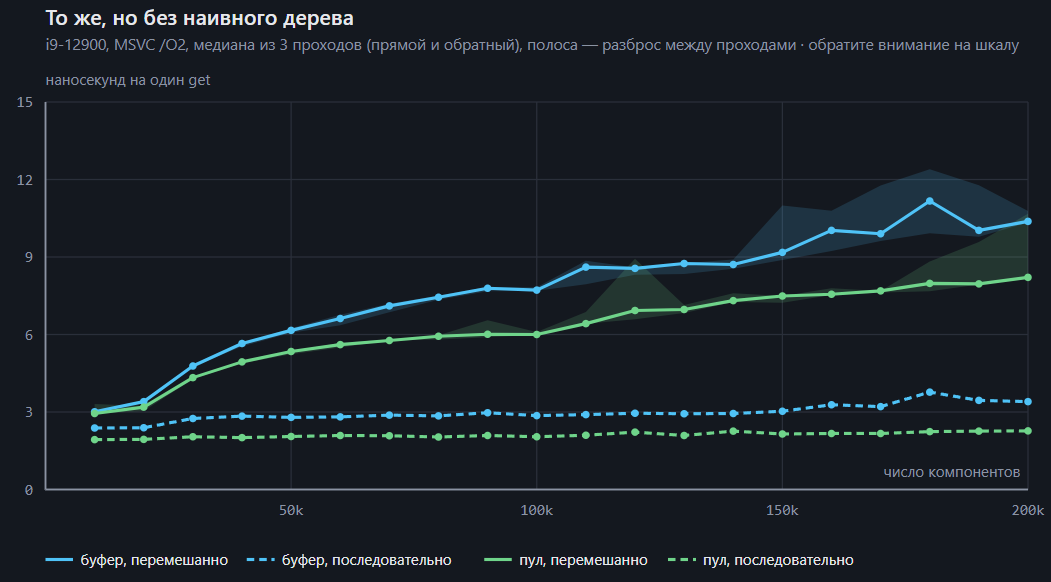
Пунктирные линии (обход в порядке размещения) лежат на двух-трёх наносекундах и не растут вообще, сколько компонентов ни добавляли, потому что читать линейно процессор умеет практически бесплатно. Сплошные растут, но медленно, и на двухстах тысячах упираются в десять наносекунд против шестисот у дерева.
Но интереснее табличек и график то, что мы получили бесплатно в реальной игре уже после внедрения. Теперь компонент не содержит указателей, поэтому он стал полностью релокабельный и теперь лист персонажа можно дублировать обычным memcpy, нафига оно надо мы еще не придумали, но вещь очень инетерсная.
А еще уменьшилось время сохранения сейва, как вы поняли теперь тоже можно просто записать буфер на диск, и время загрузки улучшилось, потому что убрали код сериализации, и Serialize(Archive&) на каждое поле.
Для мультиплеера это тоже оказалось удачным решением, теперь снимок состояния отдельных объектов - это просто буфер, а снимок состояния за прошлый тик теперь ещё один буфер, и держать историю на двадцать тиков для лагкомпенсации, внезапно становится вопросом линейого участка памяти, а не архитектуры и отдельной базы данных. А поскольку все операции над данными свелись к «присвоить ключу значение», дельту между двумя снимками вообще можно посчитать проходом по двум массивам ключей.
Но платить приходится за всё... арифметика по сырой памяти выглядит страшно, к ней не привыкнешь сразу и дизайнера читать не научишь, отвлекся на месяц и приходится учить заново. Поэтому приходится писать дополнительные тулы и вьюверы, которые всё это разбирают, но привыкнув читать неразмеченную память, вы вдруг понимаете, что она проще, чем std::map<std::string, std::vector<std::string>>, в котором непонятно даже, сколько памяти и где вы сейчас держите.
Как это выглядит в больших движках
Если вам кажется, что всё описанное экзотика из самодельного движка, вам кажется... Как говорится все уже украдено до нас и надо было просто почитать исходники анриала. В Unreal FName это шаг 1, когда строка лежит в общей таблице, а в структурах хранится её индекс, и сравнение имён становится сравнением чисел. FInstancedStruct держит произвольную структуру по значению вместе с указателем на её UScriptStruct, то есть без отдельного объекта-обёртки на каждый экземпляр. FArchive c его << это попытка сделать шаг 7 вручную для каждого поля, но универсальная сериализация нужна когда данные набиты указателями и перекладывать их простым memcpy нельзя.
В Unity DOTS всё это тоже есть и IComponentData обязан быть неуправляемой структурой и лежит в чанке фиксированного размера вместе с сотней таких же, т.е. это шаги 2–4 в виде требования компилятора. DynamicBuffer<T> будет массивом переменной длины, живущим в том же чанке, пока он мал будет. А BlobAssetReference внутри использует относительные смещения вместо указателей, что повторяет шаг 7 и с тем же обоснованием, что блоб должен грузиться с диска как есть и работать по любому адресу.
Фундаментальная задача не изменилась
Двадцать лет назад на PS2 программисты вручную раскладывали данные по четырём килобайтам скретчпада, потому что иначе процессор не успевал из забрать из DMA. Сейчас у нас 64 гигабайта и аллокатор, который не надо писать самому, но задача та же и надо сложить данные так, чтобы процессор читал их линейно и как можно реже ходил в память. Поменялись только масштаб и время кадра, и теперь надо уложиться в 16мс, которые никто не замечает, пока кадров не становится десять в секунду.