
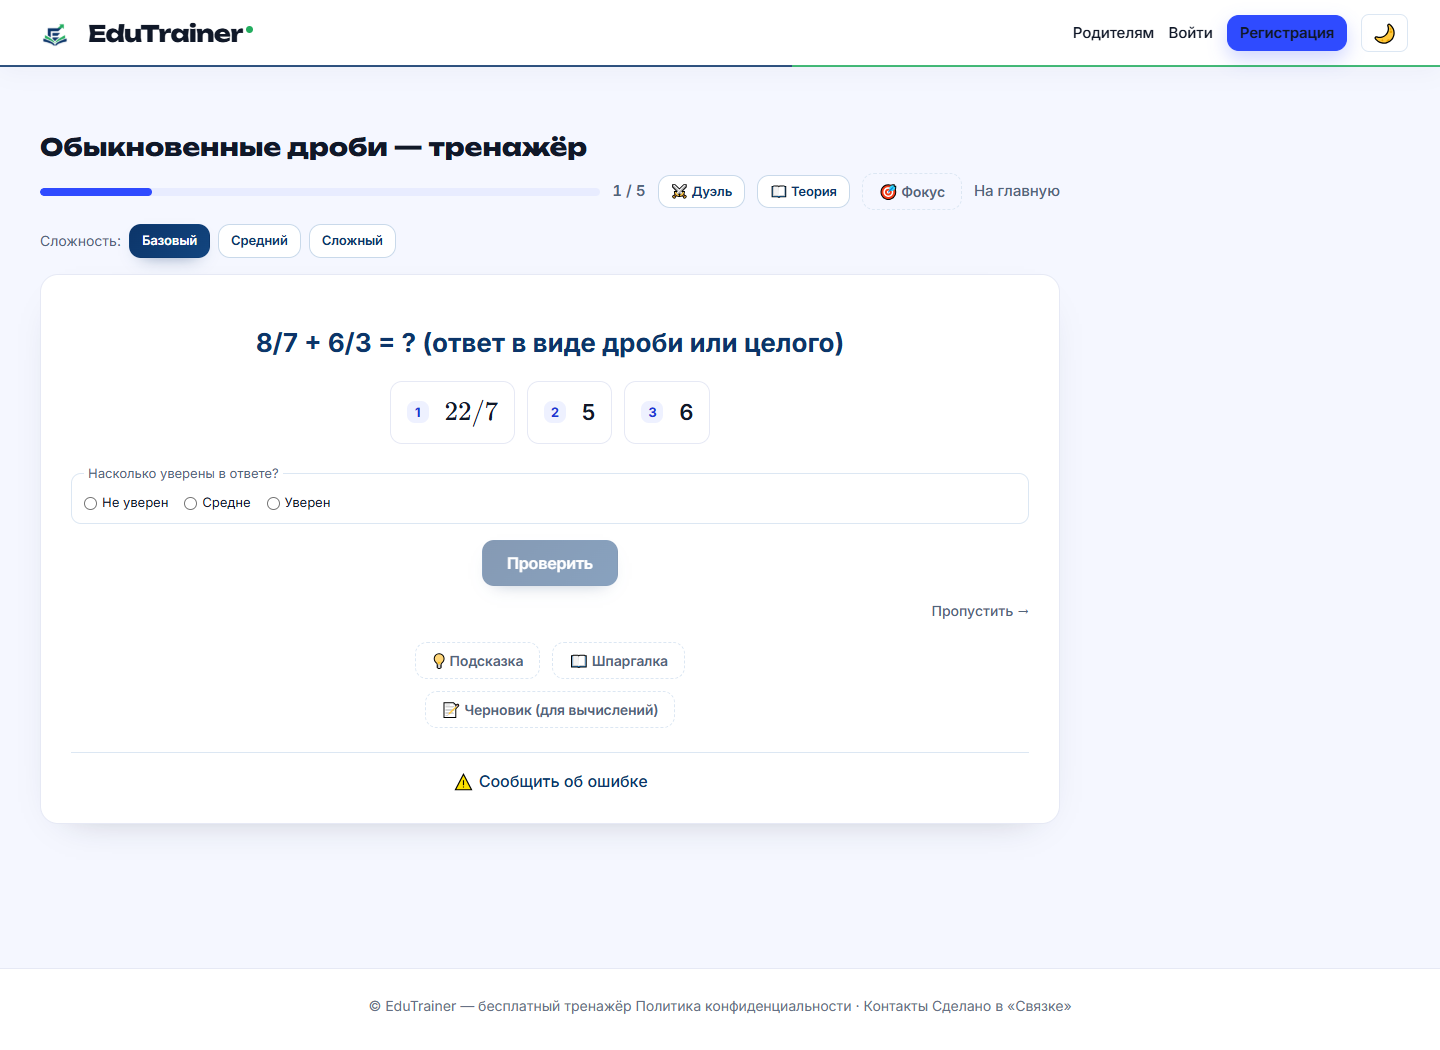
Одна задача, варианты ответа и подсказка. Скриншот рабочей страницы.
Первые сто тем для школьного тренажёра я добавил за вечер. Это была плохая новость: код генераторов писался быстро, а вот проверить, что каждый пример корректен, оказалось намного дольше. Через несколько недель в проекте было 603 темы, 25 страниц заданий ОГЭ и 213 тестов, а я всё ещё находил ошибки в задачах для 5 класса.
Речь пойдёт не о том, как «сделать EdTech». Речь о generator-first подходе: когда контент не лежит в базе, а собирается на лету, и о том, где у этого подхода начинаются проблемы.
С чего начался генератор
Изначально я хотел обычный сайт с задачами: таблица, тема, набор примеров, ответы. Довольно быстро стало понятно, что так я получу сотни почти одинаковых страниц, которые придётся поддерживать вручную. Стоило поменять формулировку или добавить уровень сложности — и переписывать приходилось каждый пример.
Генератор решал эту проблему иначе. Для каждой темы есть функция, которая получает класс, уровень и seed и возвращает готовую задачу: условие, ответ, варианты и шаги решения. Страница не хранит задачу, она собирает её в момент запроса.
Стек получился скучным: Python 3.12, Django 5.2, PostgreSQL, Redis, Nginx и Daphne. Никаких микросервисов. Для текущей нагрузки они добавили бы инфраструктуру, но не пользу ученику. Django отдаёт HTML, JavaScript отвечает только за проверку ответа и подсказки.
Task, seed и попытка воспроизводимости
Базовая модель выглядит так:
python
from dataclasses import dataclass, field


@dataclass
class Step:
    n: int
    text: str
    formula: str = ""


@dataclass
class Solution:
    steps: list[Step]
    hint: str = ""


@dataclass
class Task:
    id: str
    prompt: str
    answer: str
    answer_type: str
    solution: Solution
    options: list[str] = field(default_factory=list)
    topic_id: str = ""
Seed — ключевая вещь. Если пользователь нажал «сообщить об ошибке», я должен получить ровно ту же задачу, а не новую с другими числами. Поэтому ID содержит ключ генератора, класс, уровень и seed:
math_frac2__5__2__12345
По этому ID задача воспроизводится без хранения всех примеров в базе. Это удобно и для отладки, и для жалоб: не нужно просить скриншот, достаточно ID.
Генераторы лежат в реестре тем. У каждой темы есть человеческое название, предмет, классы и ключ генератора. Дальше generate_task находит функцию, нормализует TeX в условии и ответе, при необходимости собирает варианты и возвращает Task.
Упрощённо это выглядит так:
python
def generate_task(generator_key, grade, level, seed):
    fn = GENERATORS[generator_key]
    task = fn(grade, level, seed)

    task.level = level
    task.prompt = normalize_tex(task.prompt)
    task.answer = normalize_tex(task.answer)
    task.options = [normalize_tex(option) for option in task.options]
    task.solution.hint = normalize_tex(task.solution.hint)

    for step in task.solution.steps:
        step.text = normalize_tex(step.text)
        step.formula = normalize_tex(step.formula)

    return _make_choice(task, fn, grade, level, seed)
Здесь же начинается первое ограничение, о котором я жалею: генератор умеет создавать варианты, но не умеет проверять, что они педагогически уместны.
Почему почти всё стало выбором варианта
Изначально часть задач требовала ввести ответ вручную. На практике выяснилось, что проверить текстовый ответ сложнее, чем кажется. Ученик пишет 1/2, а в ответе 0,5. Пишет x = 5, а в ответе 5. В английском I've и I have — один смысл, но разный текст. Мобильная клавиатура добавляет пробелы и неразрывные символы, и проверка начинает ругаться на правильный ответ.
Я сделал автоматический режим выбора варианта. Генератор создаёт правильный ответ и несколько правдоподобных дистракторов. Это снизило число ложных «неверно», но появилась другая проблема: ответ можно угадать. Для тренировки это терпимо, для контроля — нет.
Сейчас почти все задания в проекте — choice. Я считаю это техническим долгом, а не хорошим решением. Для части тем нужен свободный ввод, иначе ученик привыкает не считать, а нажимать.
Как я проверял 1 809 заданий
Сгенерировать 603 темы оказалось легко. Проверить, что в каждой нет ошибки, — намного дороже.
Я прогнал 603 темы на трёх уровнях и получил 1 809 заданий. Проверял наличие ответа, вхождение ответа в варианты, дубли вариантов, наличие шагов решения, отрицательные ответы там, где их ещё не проходят, и сырой LaTeX в условии.
Ошибки нашлись быстро, и почти все они были не про код, а про смысл. Ниже четыре случая, которые лучше всего показывают разницу между «тест прошёл» и «задача работает».
Для 5 класса генератор мог выдать 1/5 − 8/6 = −17/15. Формально это верно. Но отрицательные дроби в 5 классе ещё не проходят. Ребёнок видит непонятное число, теряет уверенность и решает, что дроби — это слишком сложно. Пришлось менять логику вычитания: первая дробь всегда должна быть больше второй.
Второй пример ближе к проверке ответов. Генератор выдал 2x + 4 > 4, а ответ записал как x > (0)/2. Ученик, который написал x > 0, получал «неверно». Формально это ошибка оформления, но для ребёнка — ошибка системы. Теперь ответ сокращается через gcd, а заодно убираются 1x, -1x и конструкции вида + -3.
Третий случай — LaTeX в вариантах. В интерфейсе появлялось \frac{1}{2} и \text{не определён}. Причина была в том, что фильтр обрабатывал только формулы в $...$, а генераторы отдавали TeX без обёртки. Пришлось менять рендер не только условия, но и вариантов, подсказок и шагов.
Четвёртый случай я до сих пор вспоминаю как самый неприятный. В справочнике по физике было написано «условие плавания: F_A > F_тяж». Это условие всплытия. Плавание — когда сила Архимеда равна силе тяжести. Такую ошибку не ловит тест «страница вернула 200»: её видит только человек, который знает предмет.
213 тестов, которые не заменяют предметника
В проекте 213 тестов. Они проверяют контракт генераторов, проверку ответов, доступ к классам и результатам, SEO-маршруты, формулы и контактные формы.
Самые полезные тесты — не на статус 200, а на инварианты. Например, ответ всегда должен входить в варианты, а в 5 классе не должно быть отрицательных ответов. Вот фрагмент такого теста:
python
def test_all_topics_have_choice_options(self):
    failures = []
    for topic_id, topic in TOPICS.items():
        for level in (1, 2, 3):
            task = generate_task(
                topic["generator"], topic["grades"][0], level, 7,
            )
            if task.answer_type != "choice":
                failures.append((topic_id, level, "not choice"))
            elif str(task.answer) not in task.options:
                failures.append((topic_id, level, "answer not in options"))
    self.assertEqual(failures, [])
Но тест не может проверить, что задача методически уместна. Он подтвердит, что ответ входит в варианты, и не заметит, что пример про отрицательные дроби не для 5 класса. Поэтому ручная проверка остаётся обязательной.
Как 1 547 URL превратились в 453
С SEO я сделал классическую ошибку начинающего: решил, что количество страниц равно количеству трафика. Собрал 1 547 URL, добавил их в sitemap и стал ждать.
Поисковики отреагировали предсказуемо. В индекс попала только часть страниц, тонкие страницы начали конкурировать друг с другом, а новому домену не хватило доверия. Через некоторое время я сократил карту до 453 URL, оставил приоритетные темы и 50 практических страниц, а лишнее закрыл от индексации.
Это было неприятно, потому что казалось шагом назад. На самом деле это была первая попытка сделать не «много страниц», а «страницы, которые кто-то ищет». Позже выяснилось, что и это не финальная схема: когда практические страницы получили нормальный теоретический блок, карту снова расширили. Но принцип остался: сначала содержание страницы, потом её место в sitemap.
Сейчас на странице задания ОГЭ можно решить десять задач подряд и сразу увидеть результат. Это не заменяет экзамен, но показывает, как выглядит тренировка.
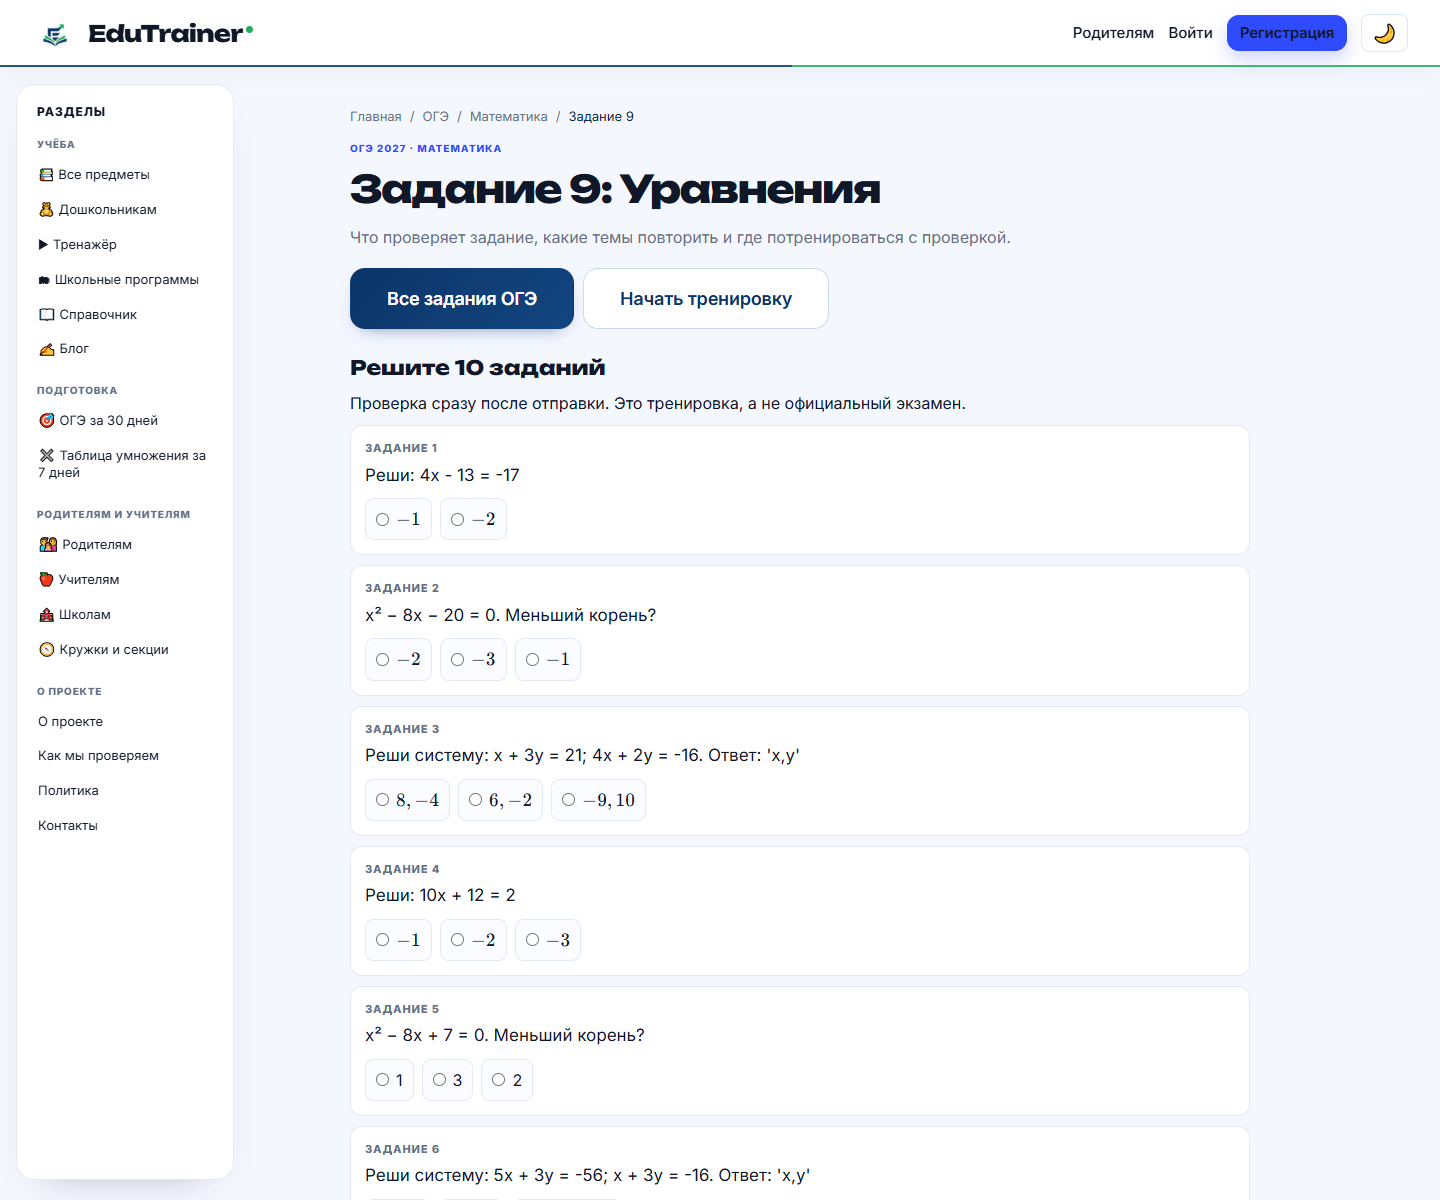
Десять задач с проверкой прямо на странице.
Что бы я сделал иначе
Я бы не генерировал 600 тем до того, как проверил первые двадцать. Сначала — двадцать задач, ручная проверка, учитель или хотя бы человек, который помнит школьную программу. Потом ещё двадцать. Только после этого — масштабирование.
Я бы не делал почти всё на choice. Выбор варианта удобен разработчику, но не всегда учит ребёнка. Для части тем нужен свободный ввод, даже если придётся повозиться с нормализацией ответа.
Я бы не обещал SEO-трафик «в комплекте с сайтом». Сайт может быть технически идеальным и при этом никому не нужным, пока о нём не знают. Это отдельная работа, и она не входит в разработку.
И я бы не считал, что генератор — это только код. Генератор — это код плюс правила, плюс проверка, плюс редактор, который понимает предмет. Без этого получается быстро, но некачественно.
Вместо вывода
Сейчас EduTrainer — это Django-монолит с генераторами, PostgreSQL, Redis и 213 тестами. В нём есть 603 темы, 25 страниц ОГЭ и справочник формул. Он всё ещё не идеален: где-то choice, где-то не хватает ручной проверки, где-то страница выглядит лучше, чем учит.
Но главный урок оказался не про Django. Генерация контента — это способ быстро создать много вариантов. Ценность появляется не в момент, когда вариантов стало много, а в момент, когда кто-то проверил, что среди них нет задачи, которая отбивает у ребёнка желание учиться.
