
Представим экспорт аналитики, в котором осталась одна колонка: визиты за сутки. Даты потерялись, порядок сохранился. Где-то внутри этих 150 чисел люди закрывали рабочие ноутбуки и уходили отдыхать. Можно ли вычислить, где именно?
Первый соблазн: выбрать самые маленькие значения и объявить их воскресеньями. Тогда день падения сервера тоже получит законный выходной. Попробуем обойтись без такого трудового законодательства.
Для опыта возьмем синтетические данные о посещаемости вымышленного рабочего сервиса: по будням им пользуются чаще, по выходным реже. Добавим рост аудитории, шум, два всплеска и один провал. В конце можно будет свериться с календарем, который мы сами спрятали.
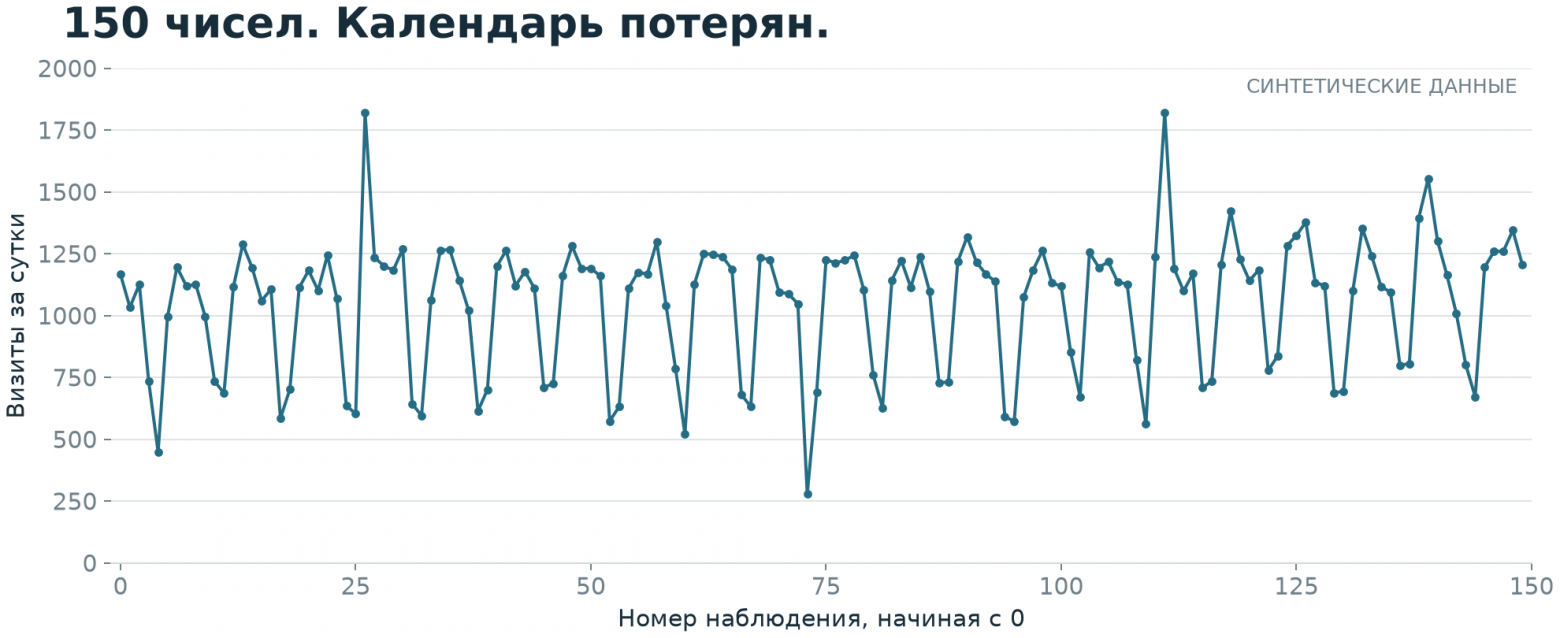
На входе только значения и их порядок. Индексы начинаются с нуля.
Важное условие: между соседними наблюдениями ровно сутки, пропусков нет. Даты мы удалили, а знание о способе сбора сохранили. Без него семь наблюдений могли бы означать семь часов или семь запусков скрипта.
Откуда взялись 150 чисел
Для повторения опыта понадобятся Python 3.12+, NumPy, Pandas и Matplotlib. Начнем с генератора данных.
import numpy as np
import pandas as pd

rng = np.random.default_rng(42)
t = np.arange(150)
dates = pd.date_range("2025-02-05", periods=150, freq="D")
weekly = np.array([1100, 1180, 1140, 1120, 1060, 650, 610])
visits = weekly[dates.dayofweek] + 0.9 * t + rng.normal(0, 85, 150)
visits[[26, 73, 111]] += [650, -480, 520]
truth = pd.DataFrame({"date": dates,
                      "visits": np.maximum(0, np.rint(visits)).astype(int)})
truth[["visits"]].to_csv("values.csv", index=False)

# Анализатор читает только числа. Календарь остается для проверки.
y = pd.read_csv("values.csv")["visits"].to_numpy()
В массиве weekly значения идут от понедельника до воскресенья. Аномалии имитируют рассылку, сбой и удачную внешнюю ссылку. Недельный ритм встроен в генератор, но в CSV остаются только числа. Посмотрим, сохранится ли в них узнаваемый рисунок.
Ряд встречается с самим собой
Сначала уберем линейный рост. Иначе два соседних больших значения могут оказаться похожими просто потому, что оба находятся в конце растущего ряда.
Затем сравним ряд с его сдвинутой копией. Если через семь наблюдений регулярно повторяется похожая ситуация, большие значения будут встречаться с большими, маленькие с маленькими. Это и измеряет автокорреляционная функция, ACF.
def detrend(y):
    t = np.arange(len(y))
    return y - np.polyval(np.polyfit(t, y, 1), t)

def acf(y, max_lag=28):
    z = y - y.mean()
    return np.array([z[:len(z)-k] @ z[k:] / (z @ z)
                     for k in range(max_lag + 1)])

z = detrend(y)
r = acf(z)
lags = np.arange(2, 22)
period = int(lags[np.argmax(r[lags])])
print(period, r[period])  # 7, 0.782197...
Здесь числитель складывает произведения отклонений на расстоянии k, а знаменатель задает общий масштаб. Это обычная оценка ACF с общим средним. Если вместо этой функции вызвать Series.autocorr(), результат немного изменится: Pandas считает корреляцию двух обрезанных частей с отдельными средними.
Лаг ноль пропускаем: ряд и без нашей помощи идеально похож на себя. Посмотрим на сдвиги от 2 до 21 наблюдения. В опыте с перемешиванием будем использовать тот же диапазон.
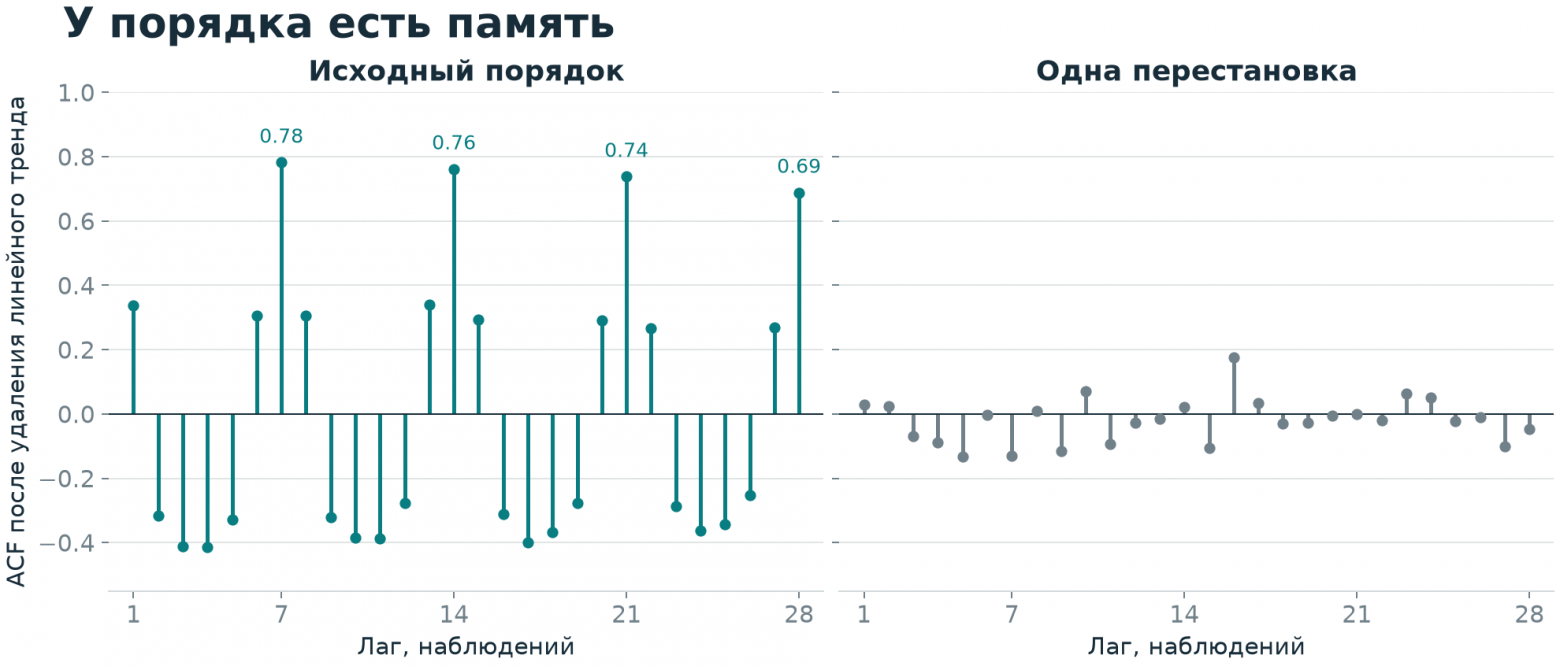
Слева пики через 7, 14, 21 и 28 наблюдений. Справа те же значения после перемешивания. Лаг 28 показан для наглядности, в поиск он не входит.
Получили ACF(7) = 0,782, ACF(14) = 0,762, ACF(21) = 0,738. Повторение хорошо видно. Пики на кратных лагах ожидаемы: через две недели рабочий сайт снова занят примерно тем же. Такой способ поиска сезонности описан, например, в руководстве NIST.
В каких местах никто не работает
Разрежем ряд на блоки по семь и положим друг под другом. У первой точки будет фаза 0, у следующей 1, затем 2 и так до 6. Следующий блок опять начинается с нуля.
Это еще не дни недели. Пока перед нами семь безымянных ящиков.
profile = pd.Series(z).groupby(np.arange(len(y)) % period).median()
m = profile.to_numpy()
pair_score = (m + np.roll(m, -1)) / 2
first = int(np.argmin(pair_score))
pair = [first, (first + 1) % period]
print(pair)  # [3, 4]
Медиана не дает одной рассылке назначить всю фазу днем рекордного трафика. У каждой фазы здесь 21 или 22 наблюдения. Ищем именно соседнюю пару с наименьшим средним двух медиан, пара 6, 0 тоже участвует. np.roll сдвигает короткий профиль, а не исходные 150 значений.
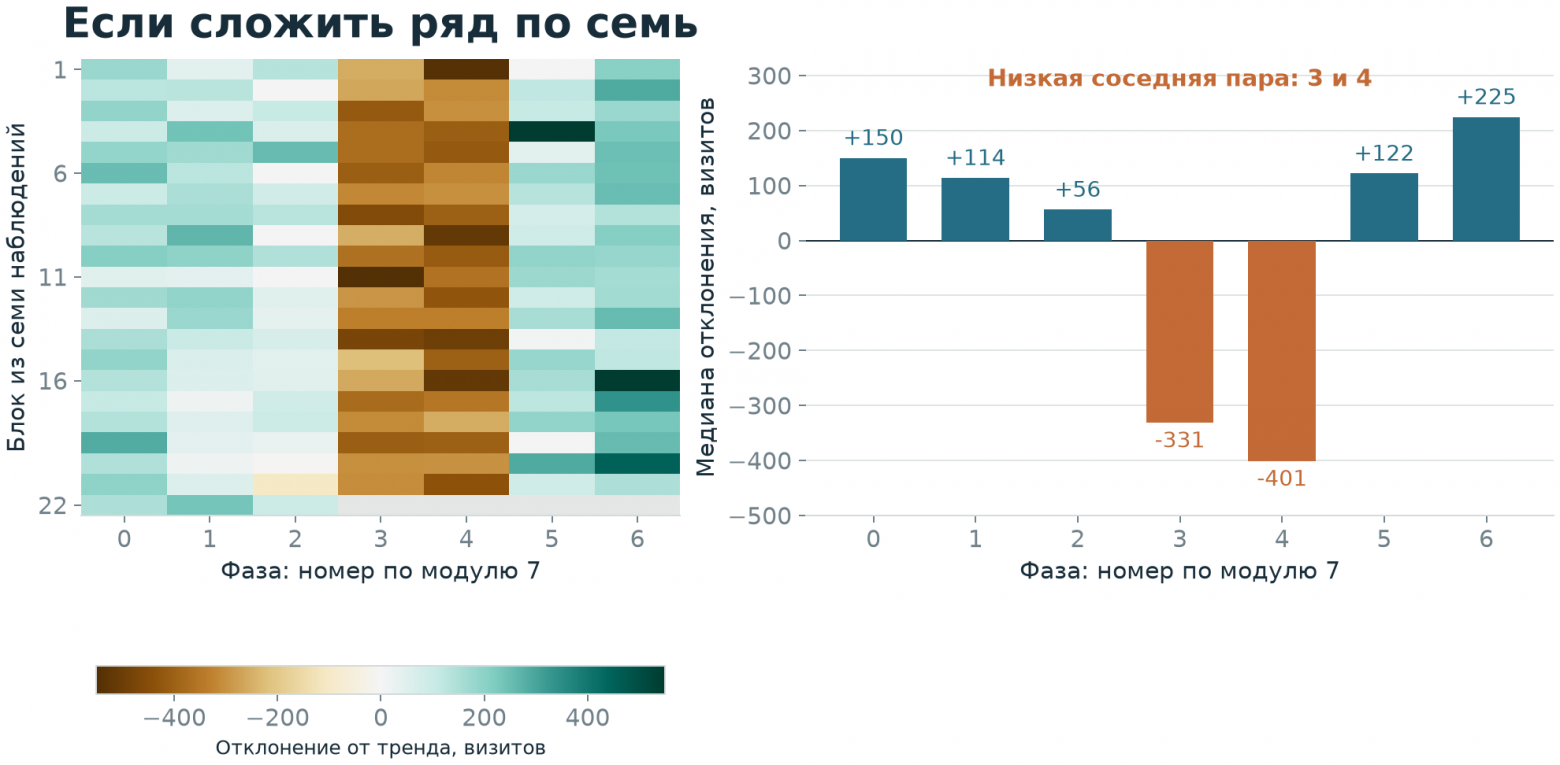
Два темных столбца на тепловой карте превратились в два низких столбика справа. Серые клетки в последней строке пустые: 150 не делится на 7.
Медианные отклонения от тренда для фаз 3 и 4 равны примерно -331 и -401 визиту. В остальных фазах они положительные. Уберем три выброса, и низкая пара останется той же. Разделим запись пополам, сохранив исходные номера наблюдений, и в каждой половине снова получим фазы 3 и 4.
Теперь заглянем в календарь генератора. Он начинался со среды, поэтому фазы 3 и 4 действительно соответствуют субботе и воскресенью. На этом примере процедура попала в ответ.
Числа те же, неделя исчезла
В случайной перестановке сохранятся все значения, среднее, медиана и гистограмма. Разрушится соседство: бывшая суббота может оказаться между двумя вторниками. По крайней мере, хороший повод не сортировать временной ряд «для удобства».
Но одна перестановка на правой половине графика ничего не гарантирует. Сделаем 4 999. Каждый раз заново уберем тренд, посчитаем ACF и возьмем максимум по всем лагам от 2 до 21. Мы ведь и для исходного ряда выбрали самый убедительный лаг. Контроль должен иметь такую же привилегию.
Код проверки случайным порядком
def score(y):
    return acf(detrend(y))[lags].max()

shuffle_rng = np.random.default_rng(2026)
shuffled = shuffle_rng.permutation(y)  # Для картинки с одной перестановкой
null = np.array([score(shuffle_rng.permutation(y)) for _ in range(4999)])
observed = score(y)
p = (1 + np.count_nonzero(null >= observed)) / (len(null) + 1)
print(p, null.max())  # 0.0002, 0.364832...
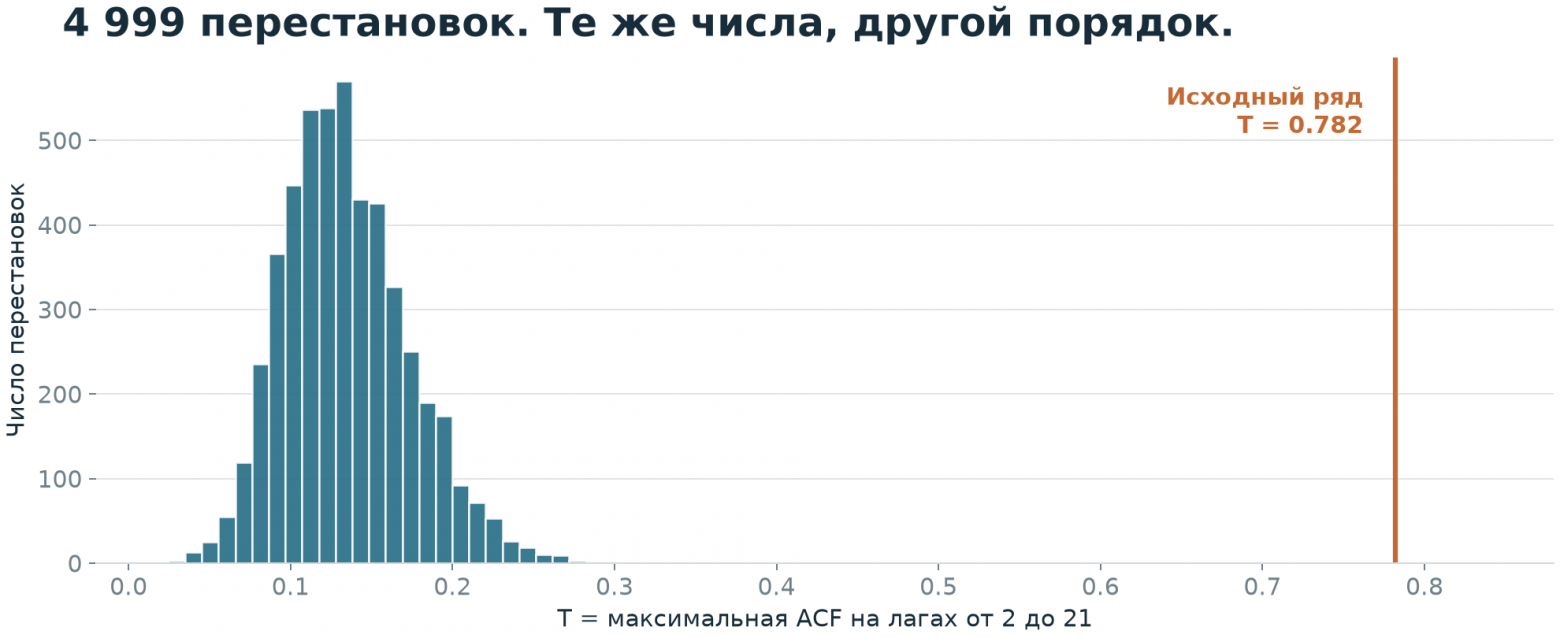
Столбцы показывают максимумы ACF у перестановок. Оранжевая линия показывает максимум исходного ряда.
Ни одна перестановка не добралась до 0,782: самый высокий результат оказался 0,365. Оценка с поправкой «плюс один» равна 1 / 5000 = 0,0002. Ноль превышений не означает нулевую вероятность.
Это аргумент против случайного порядка этих чисел. Это не вероятность того, что мы нашли выходные. Инерционный процесс тоже отличается от случайной перестановки, хотя календарь ему никто не выдавал.
Попробуем испортить удачный результат
Один seed умеет быть очень убедительным. Повторим опыт по 300 раз для каждого сценария, меняя случайный шум. Возьмем seed от 1000 до 1299, положения и амплитуды аномалий, рост аудитории и начальную фазу сохраним.
Сценарий | Самый высокий пик оказался на лаге 7 |
|---|---|
Исходный недельный профиль, шум 85 | 284 из 300 |
Тот же профиль, шум 170 | 192 из 300 |
Недельный контраст уменьшен в 4 раза, шум 170 | 70 из 300 |
Недельного профиля нет, шум 85 | 11 из 300 |
В первом сценарии остальные 16 максимумов оказались на лаге 14. При удвоенном шуме ошибки выбора тоже пришлись на 14 и 21: недельное семейство пиков сохранилось, а правило максимума спутало основной период с его кратными. Зато если заранее задать период 7, низкая пара находится во всех 300 повторах обоих первых сценариев. Найти провал внутри известного цикла оказалось проще, чем выбрать сам цикл.
На шуме argmax тоже исправно возвращает число. У него такая работа, кнопки «здесь ничего нет» мы ему не дали. Это правило выбора кандидата, не готовый детектор сезонности.
Есть сбой неприятнее. Удалим всего одно наблюдение, с индексом 74, и сожмем нумерацию. ACF(7) останется высокой, около 0,765, но выбранная низкая пара сменится с 3, 4 на 2, 3. После пропуска хвост попал в другие фазовые ящики. Красивая ACF не проверяет целостность экспорта.
Календарь все-таки придется спросить
Мы нашли повторение через семь суточных шагов и две низкие соседние фазы. Почему нельзя просто подписать их названиями дней?
Потому что числа одинаково совместимы с рабочим сервисом, который затихает в субботу и воскресенье, и с небольшим заведением, закрытым по понедельникам и вторникам. Переименуем все семь фаз согласованно, и ни одно значение, ни одна ACF не изменятся. Выбор между этими историями требует информации снаружи.
Если нам отдельно сообщили, что два минимума соответствуют именно субботе и воскресенью, названия можно расставить: первый минимум будет субботой, следующий воскресеньем. Это полезная внешняя подсказка. Сами числа ее не содержат. А у развлекательного сайта выходные вообще могут быть самыми оживленными днями.
Даже с такой подсказкой абсолютная дата не появится. Начать ту же последовательность на неделю раньше или позже можно с тем же результатом. Откуда взять месяц и год, у 150 счетчиков спросить не получится.
Поэтому ответ на вопрос из заголовка условный. Недельный рисунок и вероятных кандидатов на выходные найти можно. Установить по ним реальные даты нельзя. Python вычислил, когда сайт регулярно отдыхает. Узнать, кто разрешил ему отдыхать именно в эти дни, придется другим способом - уже в другой моей статье.
Повторить эксперимент целиком
Сохраните код в weekends.py. Установите зависимости и запустите его:
python -m pip install numpy==2.5.4 pandas==3.0.6 matplotlib==3.11.2
python weekends.py
Скрипт создаст CSV, четыре графика в PNG и SVG, результаты перестановок и проверок. В data/generator_truth.csv останется календарь для сверки, анализатор его не читает.
#!/usr/bin/env python3
"""Find a repeating low pair without giving the analyzer any calendar fields.

Python 3.12+. Run: python weekends.py --out .
All observations are synthetic. The calendar is used only by the generator
and the final audit, never by analyze(). No network access is needed.
"""

from __future__ import annotations

import argparse
import hashlib
import json
from pathlib import Path
import platform

import matplotlib

matplotlib.use("Agg")
import matplotlib.pyplot as plt
from matplotlib.ticker import MultipleLocator
import numpy as np
import pandas as pd

N = 150
SEED = 42
SEARCH_LAGS = np.arange(2, 22)
PERMUTATIONS = 4_999
BACKGROUND = "#ffffff"
INK = "#182d3a"
BLUE = "#256d85"
TEAL = "#087e82"
ORANGE = "#c36a36"
MUTED = "#71818a"


def generate(seed: int = SEED, noise: float = 85, strength: float = 1) -> pd.DataFrame:
    """A hypothetical site used mostly for work, not measured web analytics."""
    rng = np.random.default_rng(seed)
    t = np.arange(N)
    dates = pd.date_range("2025-02-05", periods=N, freq="D")
    shape = np.array([1100, 1180, 1140, 1120, 1060, 650, 610])
    profile = shape.mean() + strength * (shape - shape.mean())
    level = profile[dates.dayofweek] + 0.9 * t
    y = level + rng.normal(0, noise, N)
    anomalies = np.array([26, 73, 111])
    y[anomalies] += [650, -480, 520]
    return pd.DataFrame({
        "date": dates,
        "weekday": dates.dayofweek,
        "visits": np.maximum(0, np.rint(y)).astype(int),
        "anomaly": np.isin(t, anomalies),
    })


def detrend(y: np.ndarray) -> np.ndarray:
    t = np.arange(len(y))
    return y - np.polyval(np.polyfit(t, y, 1), t)


def acf(y: np.ndarray, max_lag: int = 28) -> np.ndarray:
    """Global-mean ACF, denominator sum of squares (NIST convention)."""
    y = np.asarray(y, dtype=float)
    if y.ndim != 1 or not np.isfinite(y).all():
        raise ValueError("Expected one finite numeric series")
    if not 0 <= max_lag < len(y):
        raise ValueError("Lag must be smaller than the series length")
    z = y - y.mean()
    denominator = z @ z
    if denominator <= np.finfo(float).eps * max(1, y @ y):
        raise ValueError("ACF is undefined for an effectively constant series")
    return np.correlate(z, z, mode="full")[len(z) - 1:len(z) + max_lag] / denominator


def score(y: np.ndarray) -> float:
    """Repeat the entire selected-lag procedure on each new ordering."""
    return float(acf(detrend(y), int(SEARCH_LAGS[-1]))[SEARCH_LAGS].max())


def low_pair(z: np.ndarray, period: int, positions: np.ndarray | None = None):
    if positions is None:
        positions = np.arange(len(z))
    profile = pd.Series(z).groupby(positions % period).median().reindex(range(period))
    values = profile.to_numpy()
    # roll is applied to the periodic PROFILE, not to the finite input series.
    pair_scores = (values + np.roll(values, -1)) / 2
    first = int(np.argmin(pair_scores))
    return profile, [first, (first + 1) % period], pair_scores


def analyze(y: np.ndarray) -> dict:
    """No dates, weekdays, start offset, or anomaly positions enter this code."""
    y = np.asarray(y, dtype=float)
    z = detrend(y)
    correlations = acf(z)
    period = int(SEARCH_LAGS[np.argmax(correlations[SEARCH_LAGS])])
    profile, pair, pair_scores = low_pair(z, period)
    return {"residuals": z, "acf": correlations, "period": period,
            "profile": profile, "pair": pair, "pair_scores": pair_scores}


def permutation_control(y: np.ndarray, count: int = PERMUTATIONS):
    rng = np.random.default_rng(2026)
    shuffled = rng.permutation(y)
    null = np.array([score(rng.permutation(y)) for _ in range(count)])
    observed = score(y)
    exceedances = int(np.count_nonzero(null >= observed))
    return shuffled, null, (1 + exceedances) / (count + 1), exceedances


def inertia_control(count: int = PERMUTATIONS) -> dict:
    """An aperiodic AR(1) can also reject the random-order reference."""
    rng = np.random.default_rng(2027)
    innovations = rng.normal(0, 85, N + 200)
    process = np.zeros(N + 200)
    for i in range(1, len(process)):
        process[i] = 0.9 * process[i-1] + innovations[i]
    y = process[200:]
    a = analyze(y)
    _, null, p_value, exceedances = permutation_control(y, count)
    return {"model": "AR(1)", "phi": 0.9, "seed": 2027, "burn_in": 200,
            "selected_lag": a["period"], "acf_7": float(a["acf"][7]),
            "T": score(y), "permutations": count, "null_exceedances": exceedances,
            "p_random_order": p_value, "null_max": float(null.max())}


def stress_test(repeats: int = 300) -> list[dict]:
    """Sensitivity inside explicitly synthetic models, not field accuracy."""
    results = []
    scenarios = [("base", 85, 1), ("double_noise", 170, 1),
                 ("weak_week", 170, 0.25), ("no_week", 85, 0)]
    for name, noise, strength in scenarios:
        periods = []
        pair_given_seven = 0
        joint = 0
        for seed in range(1000, 1000 + repeats):
            y = generate(seed=seed, noise=noise, strength=strength)["visits"].to_numpy()
            a = analyze(y)
            periods.append(a["period"])
            _, pair, _ = low_pair(detrend(y), 7)
            pair_given_seven += pair == [3, 4]
            joint += a["period"] == 7 and a["pair"] == [3, 4]
        results.append({
            "scenario": name, "repeats": repeats, "noise_sd": noise,
            "seasonal_strength": strength,
            "selected_7": periods.count(7), "matches_pair_when_period_fixed_to_7": pair_given_seven,
            "selected_7_and_pair_3_4": joint,
            "selected_lag_counts": {str(p): periods.count(p) for p in sorted(set(periods))},
        })
    return results


def verify(y: np.ndarray, answer: dict) -> dict:
    """Independent identities and destructive controls for the reported sample."""
    z = detrend(y)
    reference = np.array([np.dot(z[:len(z)-k] - z.mean(), z[k:] - z.mean())
                          / np.sum((z-z.mean())**2) for k in range(29)])
    np.testing.assert_allclose(answer["acf"], reference, atol=1e-12)
    np.testing.assert_allclose(answer["acf"][0], 1, atol=1e-12)
    np.testing.assert_allclose(analyze(y + 800)["acf"], answer["acf"], atol=1e-12)
    np.testing.assert_allclose(analyze(y * 3)["acf"], answer["acf"], atol=1e-12)
    half_pairs = []
    for start, stop in [(0, 75), (75, 150)]:
        _, pair, _ = low_pair(detrend(y[start:stop]), 7, np.arange(start, stop))
        half_pairs.append(pair)
    # Translation ambiguity: change the external date labels, not the values.
    starts = [pd.Timestamp("2025-02-05") + pd.Timedelta(days=k) for k in range(7)]
    labelings = [[(start.dayofweek + phase) % 7 for phase in answer["pair"]]
                 for start in starts]
    no_anomalies = generate()
    original = no_anomalies["visits"].to_numpy().copy()
    original[[26, 73, 111]] -= [650, -480, 520]
    _, no_outlier_pair, _ = low_pair(detrend(original), 7)
    dropped = np.delete(y, 74)
    gap_result = analyze(dropped)
    return {"direct_acf_matches": True, "offset_and_scale_invariant": True,
            "half_pairs_global_phases": half_pairs,
            "pair_without_anomaly_offsets": no_outlier_pair,
            "seven_external_weekday_labelings": labelings,
            "dropped_observation_74": {"selected_lag": gap_result["period"],
                                       "low_pair": gap_result["pair"],
                                       "acf_7": float(gap_result["acf"][7])}}


def style():
    plt.rcParams.update({
        "font.family": "DejaVu Sans", "font.size": 12, "text.color": INK,
        "axes.labelcolor": INK, "axes.edgecolor": "#d4dbdc",
        "axes.spines.top": False, "axes.spines.right": False,
        "axes.spines.left": False, "axes.titleweight": "bold",
        "figure.facecolor": BACKGROUND, "axes.facecolor": BACKGROUND,
        "xtick.color": MUTED, "ytick.color": MUTED,
        "grid.color": "#dce2e1", "grid.linewidth": 0.7,
        "savefig.facecolor": BACKGROUND, "svg.fonttype": "none", "svg.hashsalt": "weekends-150",
    })


def save(fig, directory: Path, name: str):
    title = {
        "01_series": "150 чисел. Календарь потерян.",
        "02_acf": "У порядка есть память",
        "03_phases": "Если сложить ряд по семь",
        "04_permutations": "4 999 перестановок. Те же числа, другой порядок.",
    }[name]
    description = ("Эксперимент со 150 синтетическими суточными наблюдениями посещаемости. "
                   f"Построено с помощью Matplotlib {matplotlib.__version__}.")
    for extension in ["png", "svg"]:
        if extension == "svg":
            metadata = {"Creator": None, "Title": title, "Source": Path(__file__).name,
                        "Description": description, "Date": None}
        else:
            metadata = {"Title": title, "Description": description,
                        "Software": f"Matplotlib {matplotlib.__version__}",
                        "Source": Path(__file__).name}
        fig.savefig(directory / f"{name}.{extension}", dpi=180, metadata=metadata)
    plt.close(fig)


def figures(y, answer, shuffled, null, directory: Path):
    style()
    t = np.arange(len(y))
    # Figure 1: the anonymous input, with no labels obtained from the generator.
    fig, ax = plt.subplots(figsize=(11, 4.5), layout="constrained")
    fig.suptitle("150 чисел. Календарь потерян.", x=.04, ha="left", fontsize=21, weight="bold")
    ax.plot(t, y, color=BLUE, lw=1.6)
    ax.scatter(t, y, s=11, color=BLUE, zorder=3)
    ax.set(xlim=(-1, 150), ylim=(0, 2000), xlabel="Номер наблюдения, начиная с 0", ylabel="Визиты за сутки")
    ax.grid(axis="y"); ax.xaxis.set_major_locator(MultipleLocator(25))
    ax.text(.99, .95, "СИНТЕТИЧЕСКИЕ ДАННЫЕ", transform=ax.transAxes, ha="right", color=MUTED, fontsize=10)
    save(fig, directory, "01_series")

    # Figure 2: observed vs shuffled ACF; no unjustified pointwise confidence band.
    fig, axes = plt.subplots(1, 2, figsize=(11, 4.7), layout="constrained", sharey=True)
    fig.suptitle("У порядка есть память", x=.04, ha="left", fontsize=21, weight="bold")
    for ax, values, title, color in zip(axes, [answer["acf"], acf(detrend(shuffled))],
                                       ["Исходный порядок", "Одна перестановка"], [TEAL, MUTED]):
        lags = np.arange(1, 29)
        ax.vlines(lags, 0, values[1:], color=color, lw=2)
        ax.scatter(lags, values[1:], color=color, s=22, zorder=3)
        ax.axhline(0, color=INK, lw=.8)
        ax.set(title=title, xlabel="Лаг, наблюдений", xlim=(0, 29), ylim=(-.55, 1))
        ax.set_xticks([1, 7, 14, 21, 28]); ax.grid(axis="y")
    axes[0].set_ylabel("ACF после удаления линейного тренда")
    for k in [7, 14, 21, 28]:
        axes[0].annotate(f"{answer['acf'][k]:.2f}", (k, answer["acf"][k]),
                         xytext=(0, 10), textcoords="offset points", ha="center", fontsize=10, color=TEAL)
    save(fig, directory, "02_acf")

    # Figure 3: fold by the recovered period. Missing cells stay missing.
    z = answer["residuals"]
    period = answer["period"]
    padded = np.full(((len(z) + period - 1) // period) * period, np.nan)
    padded[:len(z)] = z
    matrix = padded.reshape(-1, period)
    fig, axes = plt.subplots(1, 2, figsize=(11, 5.4), layout="constrained", width_ratios=[1, 1.25])
    fig.suptitle("Если сложить ряд по семь", x=.04, ha="left", fontsize=21, weight="bold")
    cmap = plt.get_cmap("BrBG").copy(); cmap.set_bad("#e4e7e5")
    im = axes[0].imshow(matrix, aspect="auto", cmap=cmap, vmin=-550, vmax=550)
    axes[0].set(xlabel="Фаза: номер по модулю 7", ylabel="Блок из семи наблюдений")
    axes[0].set_xticks(range(period)); axes[0].set_yticks([0, 5, 10, 15, 21])
    axes[0].set_yticklabels([1, 6, 11, 16, 22])
    cbar = fig.colorbar(im, ax=axes[0], orientation="horizontal", pad=.15, shrink=.95)
    cbar.set_label("Отклонение от тренда, визитов", fontsize=10)
    profile = answer["profile"].to_numpy()
    colors = [ORANGE if i in answer["pair"] else BLUE for i in range(period)]
    axes[1].bar(np.arange(period), profile, color=colors, width=.66, zorder=3)
    axes[1].axhline(0, color=INK, lw=.8)
    axes[1].set(xlabel="Фаза: номер по модулю 7", ylabel="Медиана отклонения, визитов", ylim=(-500, 330))
    axes[1].set_xticks(range(period)); axes[1].grid(axis="y")
    for i, value in enumerate(profile):
        axes[1].text(i, value + (14 if value >= 0 else -15), f"{value:+.0f}",
                     ha="center", va="bottom" if value >= 0 else "top", color=colors[i], fontsize=11)
    axes[1].text(.5, .98, "Низкая соседняя пара: 3 и 4", transform=axes[1].transAxes,
                 ha="center", va="top", color=ORANGE, fontsize=12, weight="bold")
    save(fig, directory, "03_phases")

    # Figure 4: distribution of the SAME selected statistic, not just lag seven.
    fig, ax = plt.subplots(figsize=(11, 4.5), layout="constrained")
    fig.suptitle("4 999 перестановок. Те же числа, другой порядок.", x=.04, ha="left", fontsize=20, weight="bold")
    ax.hist(null, bins=35, color=BLUE, alpha=.9, edgecolor=BACKGROUND)
    observed = score(y)
    ax.axvline(observed, color=ORANGE, lw=2.5)
    ax.text(observed-.02, ax.get_ylim()[1]*.85, f"Исходный ряд\nT = {observed:.3f}", ha="right", color=ORANGE, weight="bold")
    ax.set(xlabel="T = максимальная ACF на лагах от 2 до 21", ylabel="Число перестановок", xlim=(-.02, .88))
    ax.grid(axis="y"); ax.set_axisbelow(True)
    save(fig, directory, "04_permutations")


def main():
    parser = argparse.ArgumentParser(description=__doc__)
    parser.add_argument("--out", type=Path, default=Path(__file__).resolve().parent)
    parser.add_argument("--permutations", type=int, default=PERMUTATIONS)
    parser.add_argument("--repeats", type=int, default=300)
    args = parser.parse_args()
    if args.permutations < 1 or args.repeats < 1:
        parser.error("Counts must be positive")
    for directory in ["data", "figures", "results"]:
        (args.out / directory).mkdir(parents=True, exist_ok=True)
    truth = generate()
    values_path = args.out / "data" / "values.csv"
    truth[["visits"]].to_csv(values_path, index=False)
    truth.to_csv(args.out / "data" / "generator_truth.csv", index=False)
    # Reload only the anonymous column. This is the entire analyzer input.
    y = pd.read_csv(values_path)["visits"].to_numpy()
    answer = analyze(y)
    shuffled, null, p_value, exceedances = permutation_control(y, args.permutations)
    stress = stress_test(args.repeats)
    verification = verify(y, answer)
    np.testing.assert_array_equal(np.sort(y), np.sort(shuffled))
    np.testing.assert_allclose(y.mean(), shuffled.mean(), atol=1e-12)
    np.testing.assert_allclose(y.var(), shuffled.var(), atol=1e-12)
    expected = np.flatnonzero(truth.groupby(np.arange(N) % 7)["weekday"].first().to_numpy() >= 5).tolist()
    summary = {
        "data": "synthetic daily site visits", "seed": SEED, "n": len(y),
        "values_sha256": hashlib.sha256(values_path.read_bytes()).hexdigest(),
        "search_lags": SEARCH_LAGS.tolist(), "selected_lag": answer["period"],
        "acf": {str(k): float(answer["acf"][k]) for k in [1, 7, 14, 21, 28]},
        "phase_medians": answer["profile"].to_list(), "phase_counts": np.bincount(np.arange(N) % 7).tolist(),
        "low_pair": answer["pair"], "generator_weekend_phases": expected,
        "matches_generator": answer["pair"] == expected,
        "permutations": args.permutations, "permutation_seed": 2026,
        "null_exceedances": exceedances, "p_random_order": p_value,
        "null_max": float(null.max()), "null_quantiles": np.quantile(null, [.5, .95, .99]).tolist(),
        "single_shuffle_acf_7": float(acf(detrend(shuffled))[7]),
        "shuffle_preserves_values_mean_variance": True,
        "stress": stress, "inertia_control": inertia_control(args.permutations),
        "verification": verification,
        "versions": {"python": platform.python_version(), "numpy": np.__version__,
                     "pandas": pd.__version__, "matplotlib": matplotlib.__version__},
    }
    (args.out / "results" / "summary.json").write_text(json.dumps(summary, ensure_ascii=False, indent=2) + "\n", encoding="utf-8")
    pd.DataFrame({"T": null}).to_csv(args.out / "results" / "permutation_scores.csv", index=False)
    pd.DataFrame(stress).drop(columns="selected_lag_counts").to_csv(args.out / "results" / "stress.csv", index=False)
    figures(y, answer, shuffled, null, args.out / "figures")
    print(json.dumps({k: summary[k] for k in ["selected_lag", "low_pair", "acf", "p_random_order", "matches_generator"]}, ensure_ascii=False, indent=2))
    print(f"Saved data, figures and checks to {args.out.resolve()}")


if __name__ == "__main__":
    main()
