Обновить

«Кама» — компания‑разработчик электромобилей «Атом» — создаст собственную платформу‑агрегатор зарядных станций для электрокаров. Запуск платформы запланирован на 2025 год.

«Облачная платформа представляет собой так называемый провайдер электромобильности (eMobility Service Provider, eMSP), который в едином интерфейсе обеспечивает удобный доступ к зарядным станциям в рамках цифровой экосистемы „Атома“. Функционал предусматривает унифицированный метод авторизации для зарядки на любых подключённых к платформе зарядных станциях, а также единый платёжный шлюз», — отмечается в сообщении.

Пользователи платформы смогут просматривать статус зарядных станций, осуществлять их поиск по бренду или адресу и сортировать по различным параметрам, включая тип коннектора, мощность и тариф. У пользователей будет возможность бронировать зарядные порты, настраивать параметры зарядной сессии, запускать зарядку и получать уведомления о ее статусе, оплачивать зарядные сессии. Вся информация будет отображаться на планшете на руле, лобовом стекле электромобиля и в приложении.

Теги:
Всего голосов 3: ↑3 и ↓0+9
Комментарии0

125 токенов в секунду на RTX 4070 Ti SUPER: как я заставил локальную LLM работать полноценным кодинг-агентом

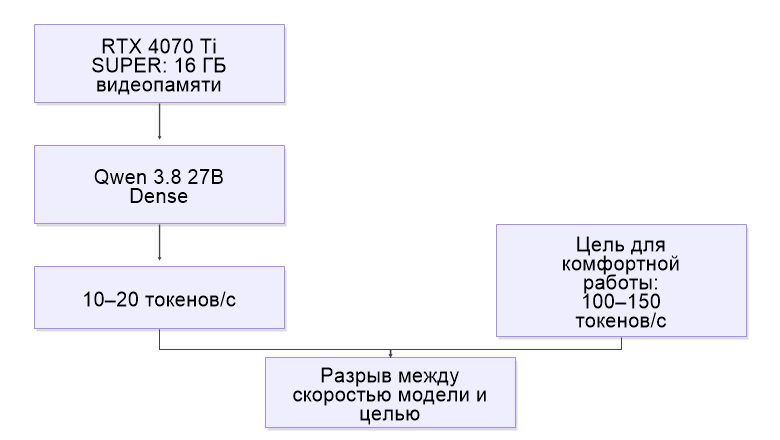
По статистике, среди рядовых пользователей настольных компов самая распространенная видеокарта имеет 16 ГБ видеопамяти. По опросам GaugeDB, такие карты занимают 27,21% рынка. У меня как раз видеокарта NVIDIA GeForce RTX 4070 Ti SUPER с 16 ГБ видеопамяти GDDR6X, которая на текущий момент стоит 900$. До сего момента главной проблемой было то, что на видеокарте такого класса невозможно было запустить LLM-агента, который будет достаточно умным и достаточно быстрым. Если запускаешь умную модель типа Qwen 3.8 27B (Dense архитектура), то на выходе получаешь 10-20 токенов в секунду. А для комфортной работы кодинг-агента надо 100-150 токенов в секунду.
125 токенов в секунду на RTX 4070 Ti SUPER: как я заставил локальную LLM работать полноценным кодинг-агентом

Публикации