Обновить
8K+
19
Петр@ChePeter

Пользователь

2,2
Рейтинг
31
Подписчики
Хабр КарьераХабр Карьера
Отправить сообщение

Искусственный интеллект против лжи и коварства

Время на прочтение11 мин
Охват и читатели3.7K
Во всех задачах обучения искусственного интеллекта присутствует одно пренеприятнейшее явление — ошибки в разметке обучающей последовательности. Ошибки эти неизбежны, так как вся разметка производится вручную, ибо если есть способ разметить реальные данные программно, то зачем нам ещё кого-то учить их размечать и тратить время и деньги на создание абсолютно ненужной конструкции!

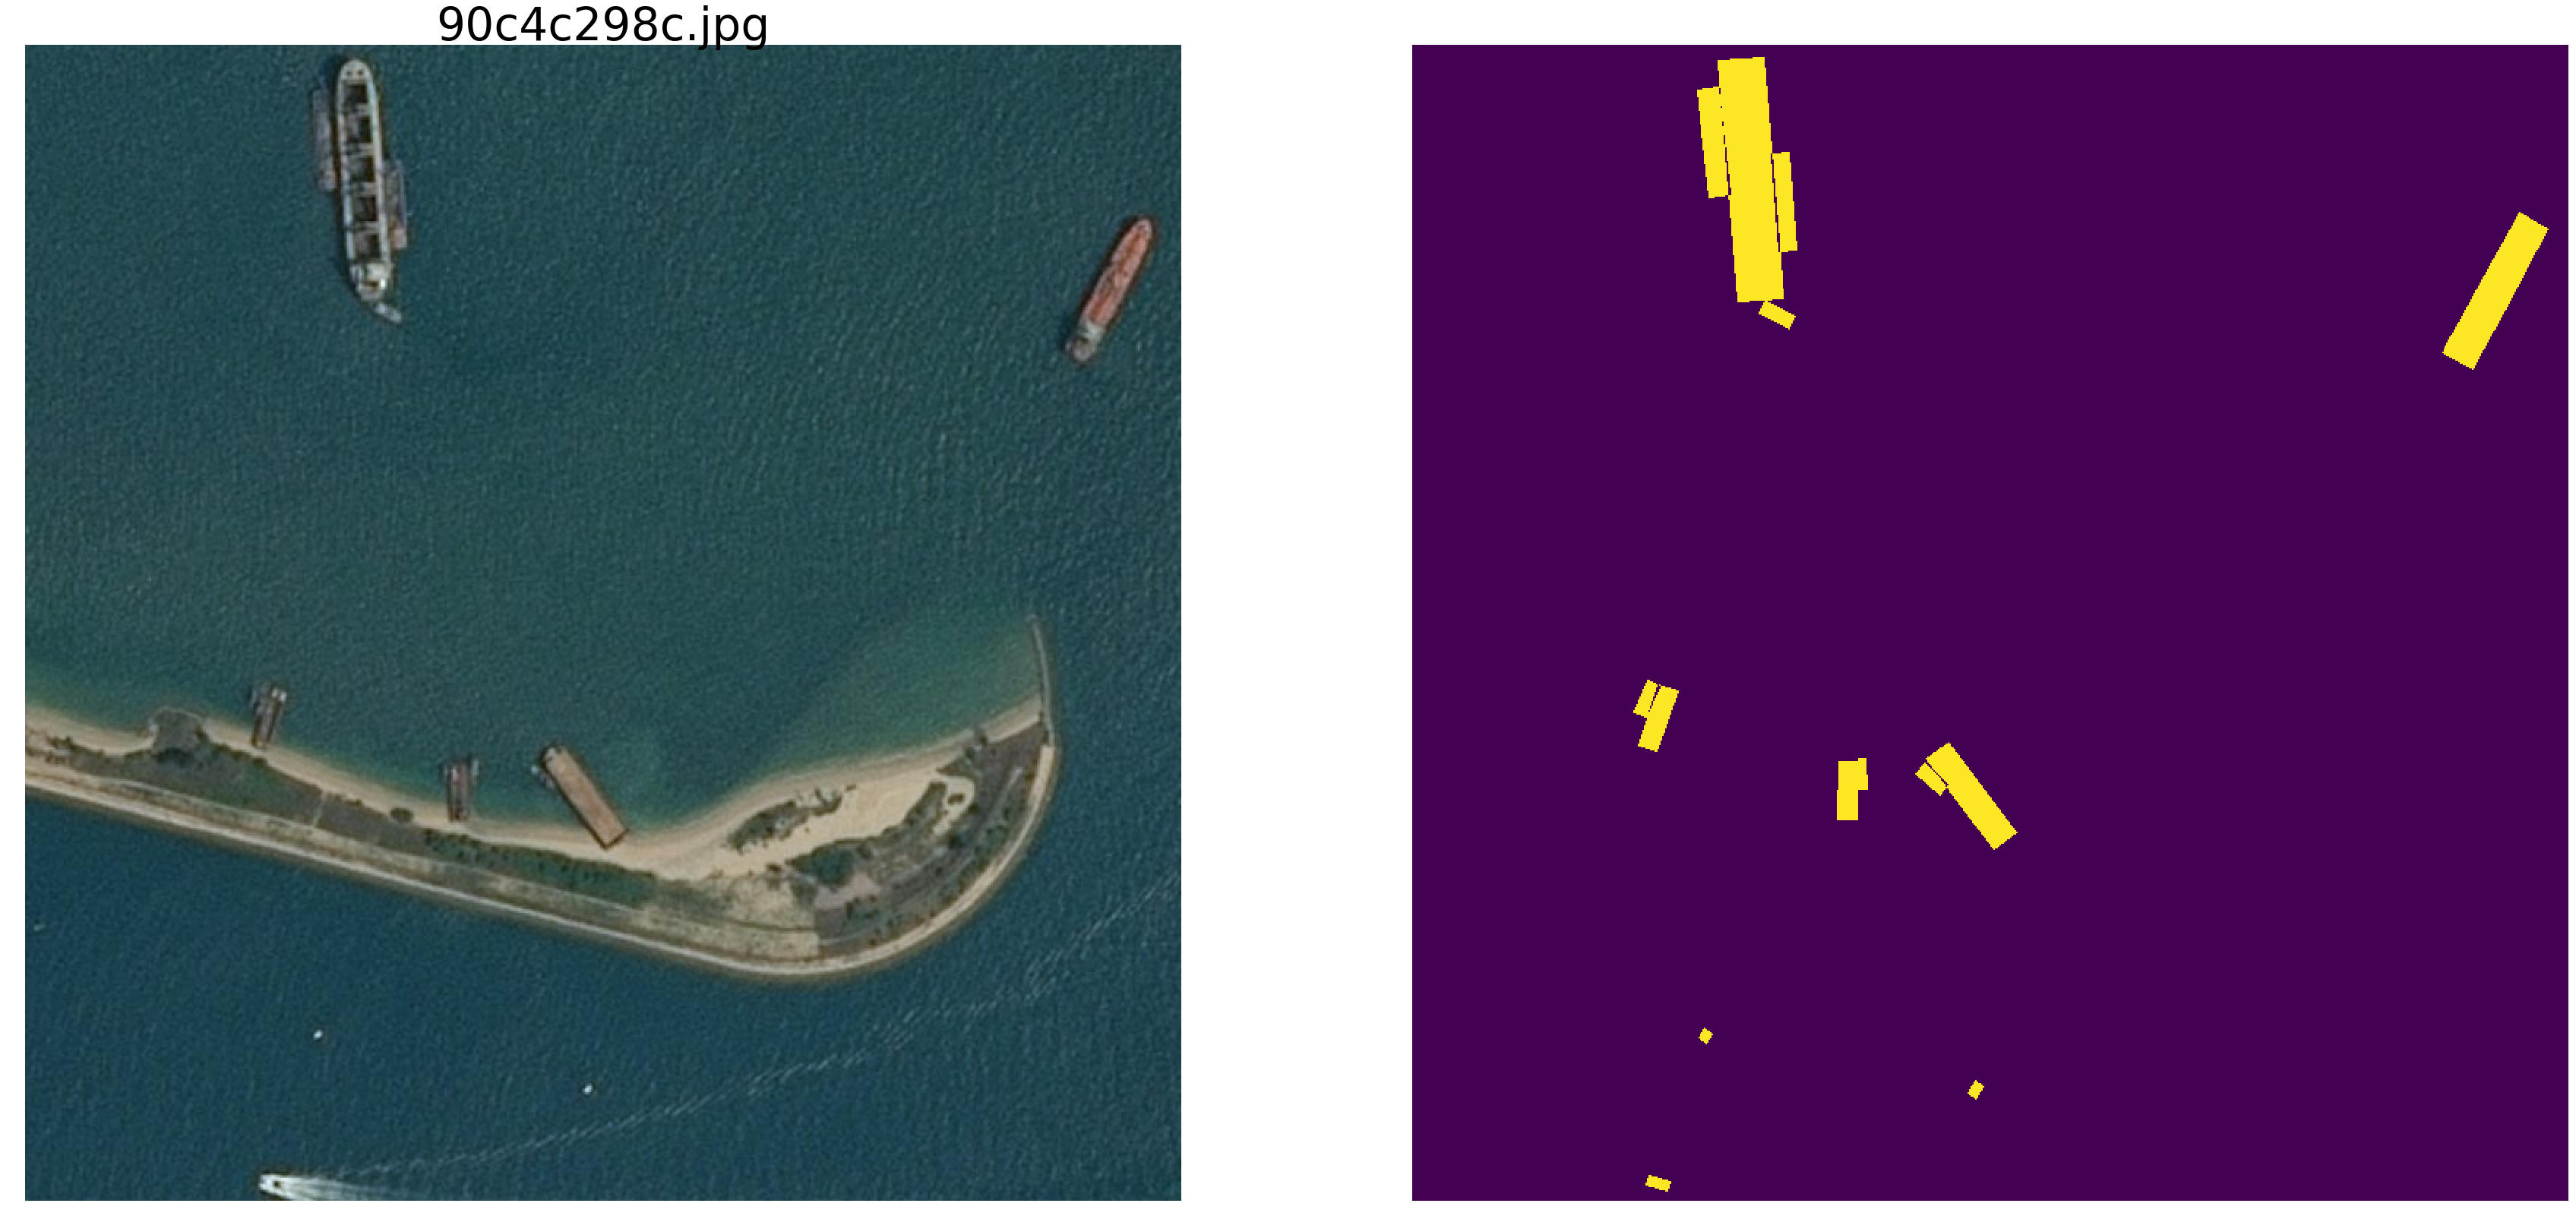
Задача найти и удалить фейковые маски в большой обучающей последовательности достаточно сложна. Можно просмотреть их все вручную, но и это не спасёт от повторных ошибок. Но если внимательно приглядеться к предложенным в предыдущих постах инструментам исследования нейронных сетей, то оказывается есть простой и эффективный способ обнаружить и извлечь все артефакты из обучающей последовательности.

И в этом посте есть конкретный пример, очевидно, что простой, на эллипсах и полигонах, для обычной U-net, опять такое лего в песочнице, но необычайно конкретный, полезный и эффективный. Мы покажем как простой метод выявляет и находит почти все артефакты, всю ложь обучающей последовательности.
Итак, начнём!
Читать дальше →

Простота и cложность примитивов или как определить ненужный препроцессинг для нейронной сети

Время на прочтение11 мин
Охват и читатели2.7K
Это третья статья по анализу и изучению эллипсов, треугольников и других геометрических фигур.
Предыдущие статьи вызвали у читателей несколько очень интересных вопросов, в частности о сложности или простоте тех или иных обучающих последовательностей. Вопросы на самом деле очень интересные, например насколько треугольник сложнее для обучения, чем четырехугольник или другой многоугольник?


Попробуем сравнить, и для сравнения у нас есть отличная, проверенная поколениями студентов, идея — чем короче шпаргалка, тем легче экзамен.

Статья эта тоже есть просто результат любопытства и праздного интереса, ничего из нее в практике не встречается и для практических задач тут есть пара отличных идей, но нет почти ничего для копипастинга. Это небольшое исследование сложности обучающих последовательностей — рассуждения автора и код изложены, можно все проверить/дополнить/изменить самим.

Итак, попробуем выяснить, какая геометрическая фигура сложнее или проще для сегментации, какой курс лекций для ИИ понятней и лучше усваивается.
Читать дальше →

Шпаргалка для искусственного интеллекта — выбрось лишнее, учи главному. Техника обработки обучающих последовательностей

Время на прочтение16 мин
Охват и читатели7.3K
Это вторая статья по анализу и изучению материалов соревнования по поиску корабликов на море. Но сейчас будем изучать свойства обучающих последовательностей. Попробуем найти в исходных данных лишнюю информацию, избыточность и её удалить.


Статья эта тоже есть просто результат любопытства и праздного интереса, ничего из нее в практике не встречается и для практических задач тут нет почти ничего для копипастинга. Это небольшое исследование свойств обучающей последовательности — рассуждения автора и код изложены, можно все проверить/дополнить/изменить самим.

Недавно закончились соревнования на kaggle по поиску судов на море. Компания Airbus предлагала провести анализ космических снимков моря как с судами так и без. Всего 192555 картинок 768х768х3 — это 340 720 680 960 байт если uint8 и это громадный объем информации и возникло смутное подозрение, что не все картинки нужны для обучения сети и в таком количестве информации очевидны повторы и избыточность. При обучении сети принято некоторую часть данных отделять и не использовать в обучении, а использовать для проверки качества обучения. И если один и тот же участок моря попал на два разных снимка и при этом один снимок попал в тренировочную последовательность, а другой в проверочную, то проверка смысл потеряет и сеть переобучится, мы не проверим свойство сети обобщать информацию, ведь данные те же самые. Борьба с эти явлением отняла много сил и времени GPU участников. Как обычно, победители и призеры не торопятся показать своим поклонникам секреты мастерства и выложить код и нет возможности его изучить и поучиться, поэтому займемся теорией.
Читать дальше →

Небольшое исследование свойств простой U-net, классической сверточной сети для сегментации

Время на прочтение18 мин
Охват и читатели24K
Cтатья написана по анализу и изучению материалов соревнования по поиску корабликов на море.

image

Попробуем понять, как и что ищет сеть и что находит. Статья эта есть просто результат любопытства и праздного интереса, ничего из нее в практике не встречается и для практических задач тут нет ничего для копипастинга. Но результат не совсем ожидаем. В интернете полно описаний работы сетей в которых красиво и с картинками авторы рассказывают, как сети детерминируют примитивы — углы, круги, усы, хвосты и т.п., потом их разыскивают для сегментирования/классификации. Многие соревнования выигрываются с помощью весов с других больших и широких сетей. Интересно понять и посмотреть как и какие примитивы строит сеть.
Читать дальше →

Bitcoin & AI. Победа неизбежна

Время на прочтение5 мин
Охват и читатели9.5K
О некоторых свойствах кривой secp256k1 и попытке предсказать ее поведение.

Как известно, задача дискретного логарифмирования является очень сложной и люди не знают способа вычислять его быстро. Более того, зная точку на кривой P = n*G очень трудно сделать суждение о величине n. Даже о приблизительной величине. Попробуем еще проще: попробуем делать суждения о последовательности $P(i) = i*G$, вернее о значениях $i$ зная значения $P(i)$.
Читать дальше →

Блондинки, монстры и пристрастия искусственного интеллекта

Время на прочтение5 мин
Охват и читатели4.8K
Предыдущая статья оставила ощущение недосказанности и две темы — блондинок и монстров не раскрыты были совсем.

Попробуем исправить и начнем с монстров.

Не секрет, что большинство систем распознавания используют ИИ для определения потенциальных кандидатов и нам тоже интересно проверить, как это у цифр.
Читать дальше →

Некоторые аспекты качества обучающих последовательностей

Время на прочтение8 мин
Охват и читатели2.2K
На Хабре появился ряд статей о качестве образования и как процесса и как результата (уровень выпускников).

Тема заинтересовала и руки зачесались проверить, а как это устроено у пчелок роботов искусственного интеллекта, влияет ли качество обучающей последовательности на результат.

Была выбрана простая сеть из примеров Keras в которую добавил одну строку. Нас интересует насколько упорядоченность входной обучающей последовательности mnist влияет на результат обучения MLP.

Результат получился неожиданным и странным, пришлось перепроверять многократно, но перейдем к делу и конкретике.
Читать дальше →

Блеск и нищета Искусственного Интеллекта

Время на прочтение5 мин
Охват и читатели19K
На примере простой задачи с простой нейронной сетью. Навеяно вот этой статьей и сеть взята без изменений. Просто выполнить код было неинтересно и пытливый ум решил внести изменения в предмет распознавания. А именно, нужно взять и перемешать точки в 28х28 и посмотреть.
Читать дальше →
2

Информация

В рейтинге
1 678-й
Дата рождения
Зарегистрирован
Активность

Специализация

Бизнес-аналитик, Аналитик по данным
Ведущий