Как на самом деле работает mod_rewrite. Пособие для продолжающих
17 мин
Эта статья выросла из идеи продвинутого обучения наших сотрудников технической поддержки работе с mod_rewrite. Практика показала, что после изучения имеющихся в большом количестве учебников на русском языке саппортам хорошо дается решение шаблонных задач, но вот самостоятельное составление правил происходит методом проб и большого количества ошибок. Проблема заключается в том, что для хорошего понимания работы mod_rewrite требуется изучение оригинальной англоязычной документации, после чего — либо дополнительные разъяснения, либо часы экспериментов с RewriteLog.
В статье изложен механизм работы mod_rewrite. Понимание принципов его работы позволяет четко осознавать действие каждой директивы и ясно представлять себе, что происходит в тот или иной момент внутри mod_rewrite при обработке директив.
Я предполагаю, что читатель уже знаком с тем, что такое mod_rewrite, и не буду описывать его основы, которые легко найти в интернете. Также нужно отметить, что в статье освещается работа mod_rewrite при использовании его директив в файле .htaccess. Отличия при работе в контексте <VirtualHost> изложены в конце статьи.
Итак, вы изучили mod_rewrite, составили несколько RewriteRule и успели столкнуться с бесконечными перенаправлениями, со случаем, когда правило почему-то не ловит ваш запрос, а также с непредсказуемой работой группы правил, когда последующее правило неожиданно изменяет запрос, кропотливо подготовленный правилами предыдущими.
Почему так происходит?


 Суть сводится к тому, что эту команду в виде «make install» или «sudo make install» использовать в современных дистрибутивах нельзя.

 Судя по всему, неделя исключений на хабре успешно наступила :). Накопив достаточную «подушку» кармы чтобы не бояться уйти в минус, я, пожалуй, тоже выскажу свое мнение по данному вопросу. Сразу оговорюсь, что мнение сугубо личное, основанное на небольшом практическом опыте коммерческой разработки: C++, Objective-C, C#, Java, Python, Ruby.

 Оформим начатое в




 Многие из хабровчан, да и вообще айтишников, смотрят аниме. Еще больше видело его хотя бы краем глаза. Но как его создают?


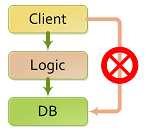 Любому разработчику известен архитектурный шаблон слоев. При всей его незамысловатости он позволяет эффективно прятать реализацию и абстрагировать компоненты разного уровня. Слои нижнего уровня могут изменяться без особого риска испортить работу приложения, облегчен рефакторинг. Единственное очевидное условие, которое вы должны соблюдать – это придерживаться принятой архитектуры. Но иногда бывает, что программист нет-нет да и соблазняется вызвать пару методов «через голову». Например из слоя интерфейса обратиться прямиком в слой базы данных. Не будем здесь искать злого умысла, может этот случай был связан со спешкой при выпуске срочного исправления для заказчика. Но постепенно количество таких небольших «грешков» может свести на нет принятую когда то стройную архитектуру и вы опять окажетесь со «спагетти кодом». Вылавливать такие случаи несоответствия кода архитектуре слоев на большой системе может быть очень затруднительно. К счастью в Visual Studio 2010 (редакций Premium и Ultimate) есть инструменты, которые могут значительно облегчить эту задачу.