
Всем привет! Семантический поиск находит похожие заметки, и это работает. Но из десяти найденных пар я уверенно создал бы ссылку только в четырёх, хотя девять совпадений оценил как полезные. Разбираюсь, почему «похоже» не значит «нужна ссылка», на примере своего плагина Veynrel для Obsidian.
Я попросил Codex сгенерировать 40 синтетических русскоязычных заметок об архитектуре программ, обучении моделей и работе с данными. Это не моё личное хранилище. Для поиска использовал локальную multilingual MiniLM. Я взял первые десять пар, где каждая заметка входит в тройку ближайших для другой, порядок не менял и неудобные примеры не заменял. Пары я разбирал в диалоге с ассистентом: получал краткие пояснения и ссылки на полные тексты, затем отдельно оценивал полезность совпадения и необходимость ссылки.
Первая пара: «Что сохранять между эпохами» и «Кеш признаков — сохранять или пересчитывать?».
Одна заметка о сохранении состояния долгого обучения, чтобы после сбоя не начинать сначала. Другая о противоположном случае: промежуточные данные дёшево пересчитать, поэтому сложное восстановление может не окупаться.
Здесь я создал бы ссылку. Заметки дополняют друг друга: рядом удобно сравнить условия, при которых стоит сохранять состояние или пересчитывать результат.
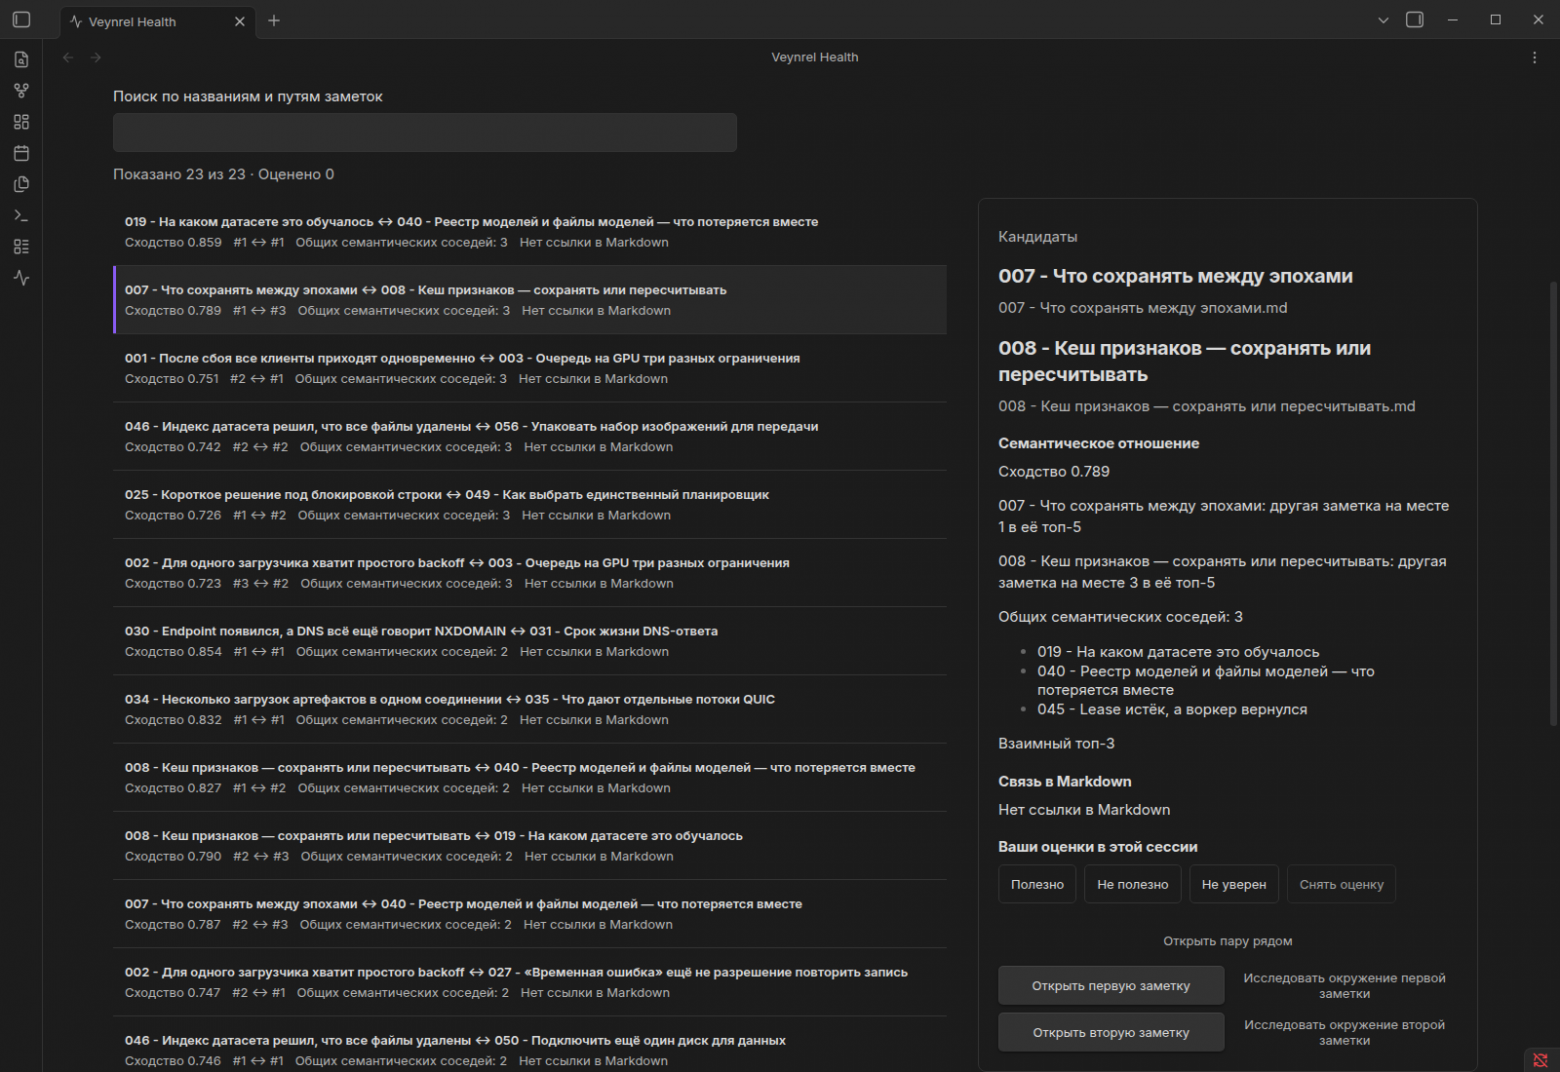
Одна из разобранных пар. Счётчик оценок на снимке относится к интерфейсу: мои ответы собирались отдельно.
Другая пара: «Индекс датасета решил, что все файлы удалены» и «Упаковать набор изображений для передачи».
Первая заметка о сканере, который может принять отключённый диск за пустую папку и ошибочно удалить записи индекса. Вторая о передаче архива: проверить контрольную сумму, распаковку и не торопиться удалять оригиналы.
Обе касаются изображений и сохранности данных. Совпадение я отметил как полезное, но ссылку создавать не стал бы: задачи разные, и польза одной заметки для другой неочевидна.
Для меня здесь важен вопрос: зачем при чтении одной заметки понадобится переходить к другой?
Девять полезных совпадений из десяти не означают 90% точности алгоритма. Корпус синтетический, оценщик один, пары выбраны по рангу, а не случайно. До ответов я видел пояснения ассистента, так что это не слепая оценка. Экономию времени и пользу в реальных хранилищах я не измерял.
Главное, что дал опыт, не подтверждение работы поиска, а идеи, куда развивать плагин. Пара про диск и архив показала: «похоже» не равно «нужна ссылка». Одной паре достаточно показать заметки рядом, другой нужна проверка на повторы, третьей заметка-оглавление. Поэтому вместо кнопки «создать ссылку» я хочу сделать разные действия для разных пар и не считать количество новых рёбер успехом.
Полный разбор с методикой, исходными заметками и результатами.
А что вы обычно делаете с двумя похожими заметками: связываете, объединяете или оставляете отдельно?