Обновить
32K+
1
Верин Игорь@verin_is

Пользователь

52
Рейтинг
4
Подписчики
Отправить сообщение

CPU простаивает, а Linux показывает 80% давления. Как я нашёл причину в одном контейнере

Уровень сложностиСредний
Время на прочтение4 мин
Охват и читатели6.9K

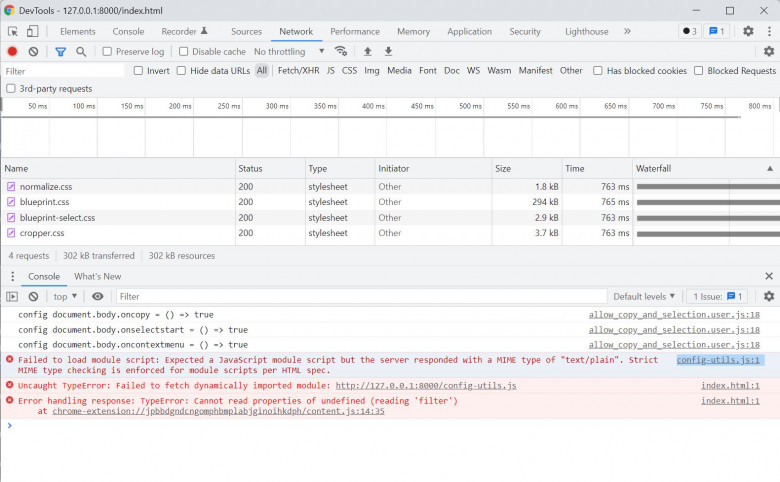
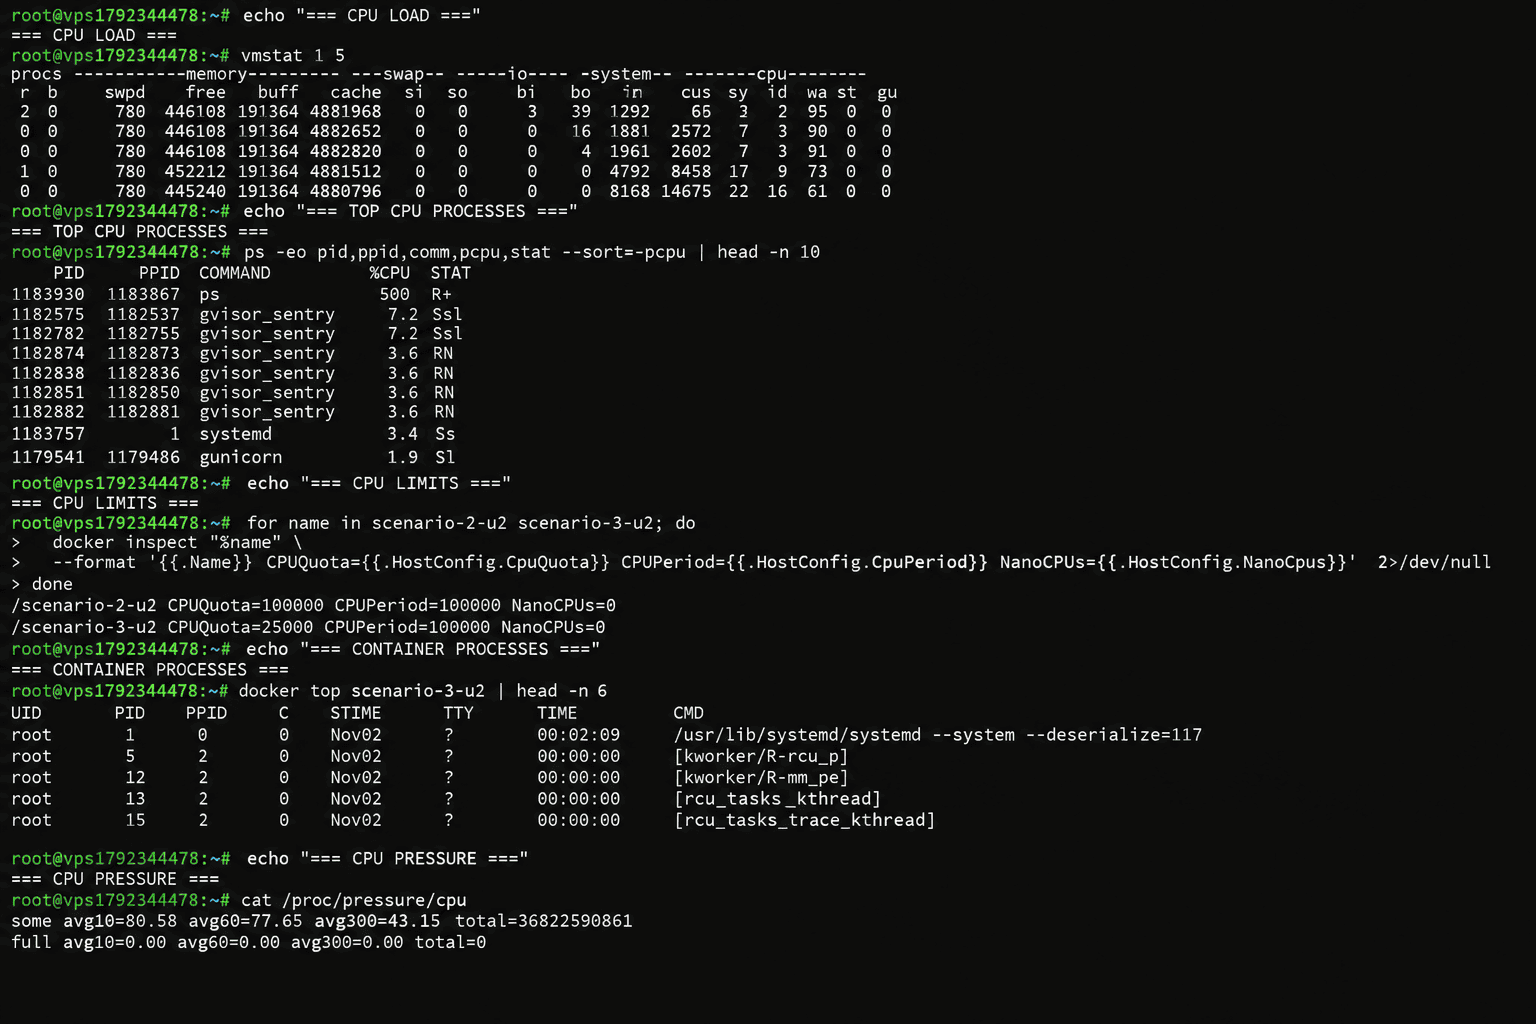
Недавно решил проверить, сколько изолированных Linux-окружений сможет одновременно обслуживать мой VPS.

Конфигурация довольно скромная: 3 vCPU, 6 ГБ RAM и Docker. На сервере работает учебный проект, который создаёт отдельные Linux-окружения с заранее подготовленными неисправностями. Изоляция реализована через gVisor.

Изначально хотел выяснить, выдержит ли сервер девять одновременно работающих стендов.

Но в процессе обнаружил кое-что интереснее.

CPU на сервере большую часть времени простаивал, а Linux показывал почти 80% процессорного давления.

Пришлось разбираться, как такое вообще возможно.

Читать далее

Сервер отвечает 200 OK. Сайт не работает. Почему мониторинг ничего не заметил?

Уровень сложностиПростой
Время на прочтение6 мин
Охват и читатели5.1K

Вчера я разработал новый интересный кейс для моего тренажера и с интересом вам расскажу о нем:

Представим довольно неприятную ситуацию.

После очередного деплоя пользователи начинают жаловаться, что сайт перестал работать. Открывают страницу — белый экран. Никаких сообщений, ошибок или признаков жизни.

Проверяем сервер:

Читать далее

Сертификат обновили, а браузер всё ещё ругается: ищем старый TLS в Nginx

Уровень сложностиПростой
Время на прочтение3 мин
Охват и читатели6.3K

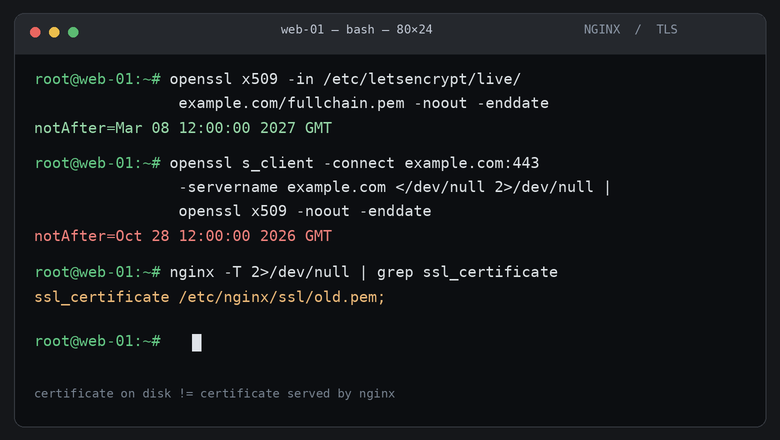
При подготовке одного из учебных инцидентов для Linux-тренажёра я задумался над довольно неприятной ситуацией: сертификат на сервере уже обновлён, но пользователи по-прежнему получают ошибку о его истечении.

На первый взгляд кажется, что проблема в Certbot. Но сертификат может быть совершенно нормальным. Вопрос в другом: какой именно сертификат сервер отдаёт клиенту?

Разберём такую ситуацию на примере Nginx.

Читать далее

366 попыток восстановить Linux‑сервер: что показала статистика за месяц

Уровень сложностиСредний
Время на прочтение5 мин
Охват и читатели8.2K

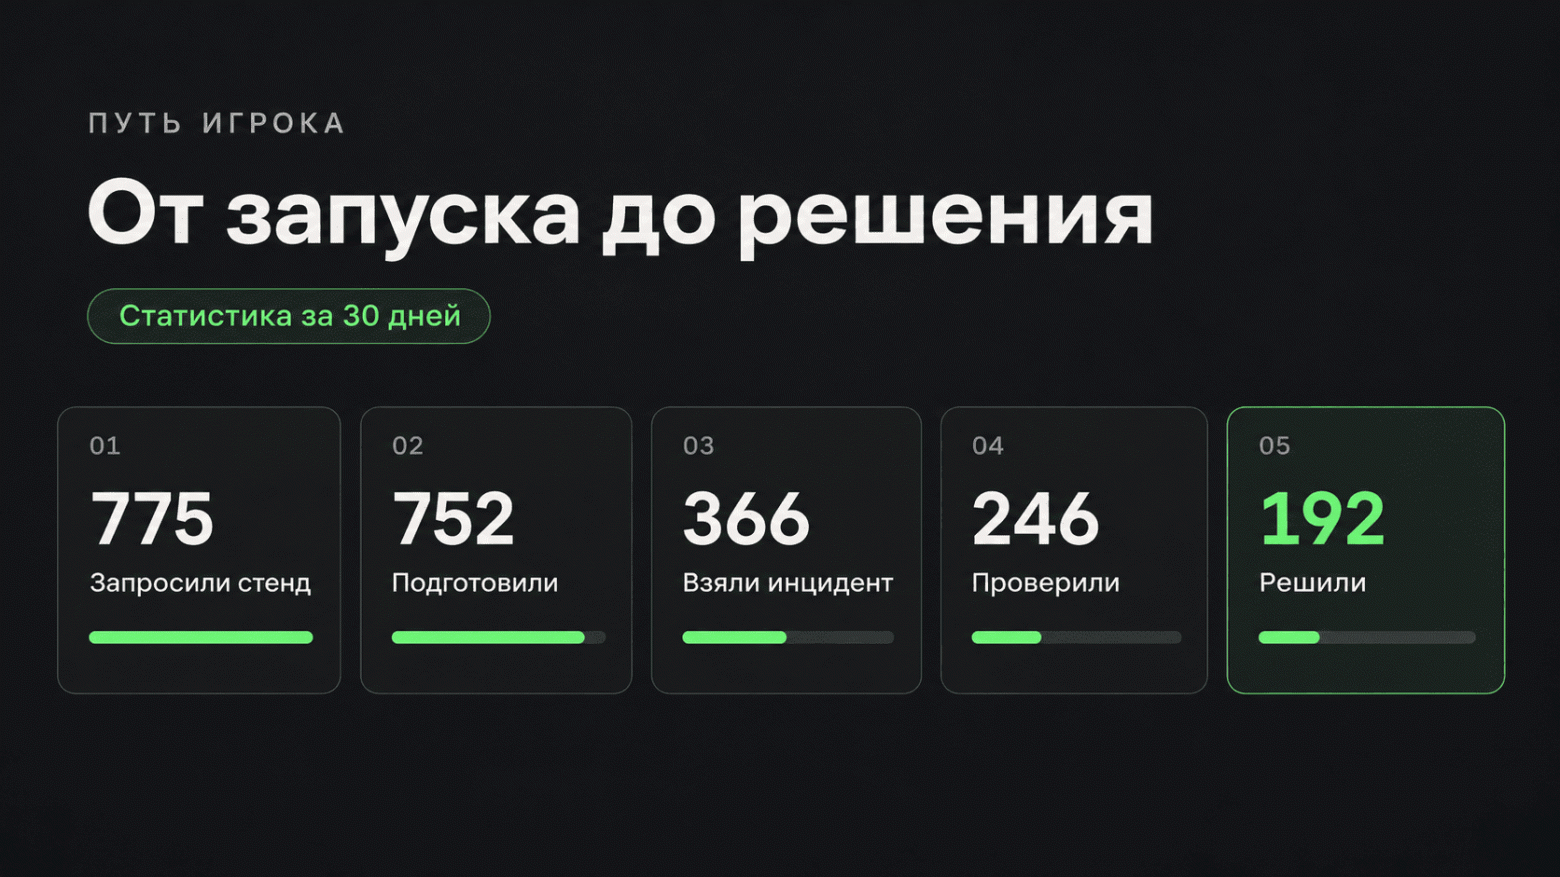
Последний месяц я собирал статистику прохождения инцидентов в учебном Linux-окружении. Идея простая: пользователь получает сервер со сломанным сервисом, открывает терминал в браузере и пытается самостоятельно найти и устранить неисправность.

Никакой заранее заданной последовательности команд нет. Можно смотреть журналы, изучать процессы, проверять сетевые соединения и конфигурацию. Главное - восстановить работоспособность сервиса.

За месяц набралось 366 взятых в работу инцидентов. Из них 192 завершились успешно.

Мне стало интересно, какие проблемы вызывают наибольшие трудности, насколько часто пользователи доходят до проверки результата и что вообще можно понять по такой статистике.

Читать далее

Too many open files без открытых документов: как сокеты съедают лимит процесса

Уровень сложностиПростой
Время на прочтение4 мин
Охват и читатели7.3K

Сервис перестал принимать клиентов. В журнале - Too many open files. Больших логов нет, каталоги с данными выглядят нормально, а ulimit -n в вашей консоли показывает огромный запас. Откуда взялись «слишком многие файлы»?

У этой ошибки есть языковая ловушка: слово files заставляет искать обычные файлы на диске. Но сокет тоже занимает файловый дескриптор. Сервис может упереться в лимит, создавая только сокеты - даже без подключения к удалённому серверу. Ниже я воспроизведу именно это, затем подниму лимит и получу ту же ошибку повторно.

Читать далее

dig находит адрес, а приложение — нет: как одна строка ломает разрешение имён в Linux

Уровень сложностиПростой
Время на прочтение4 мин
Охват и читатели6.9K

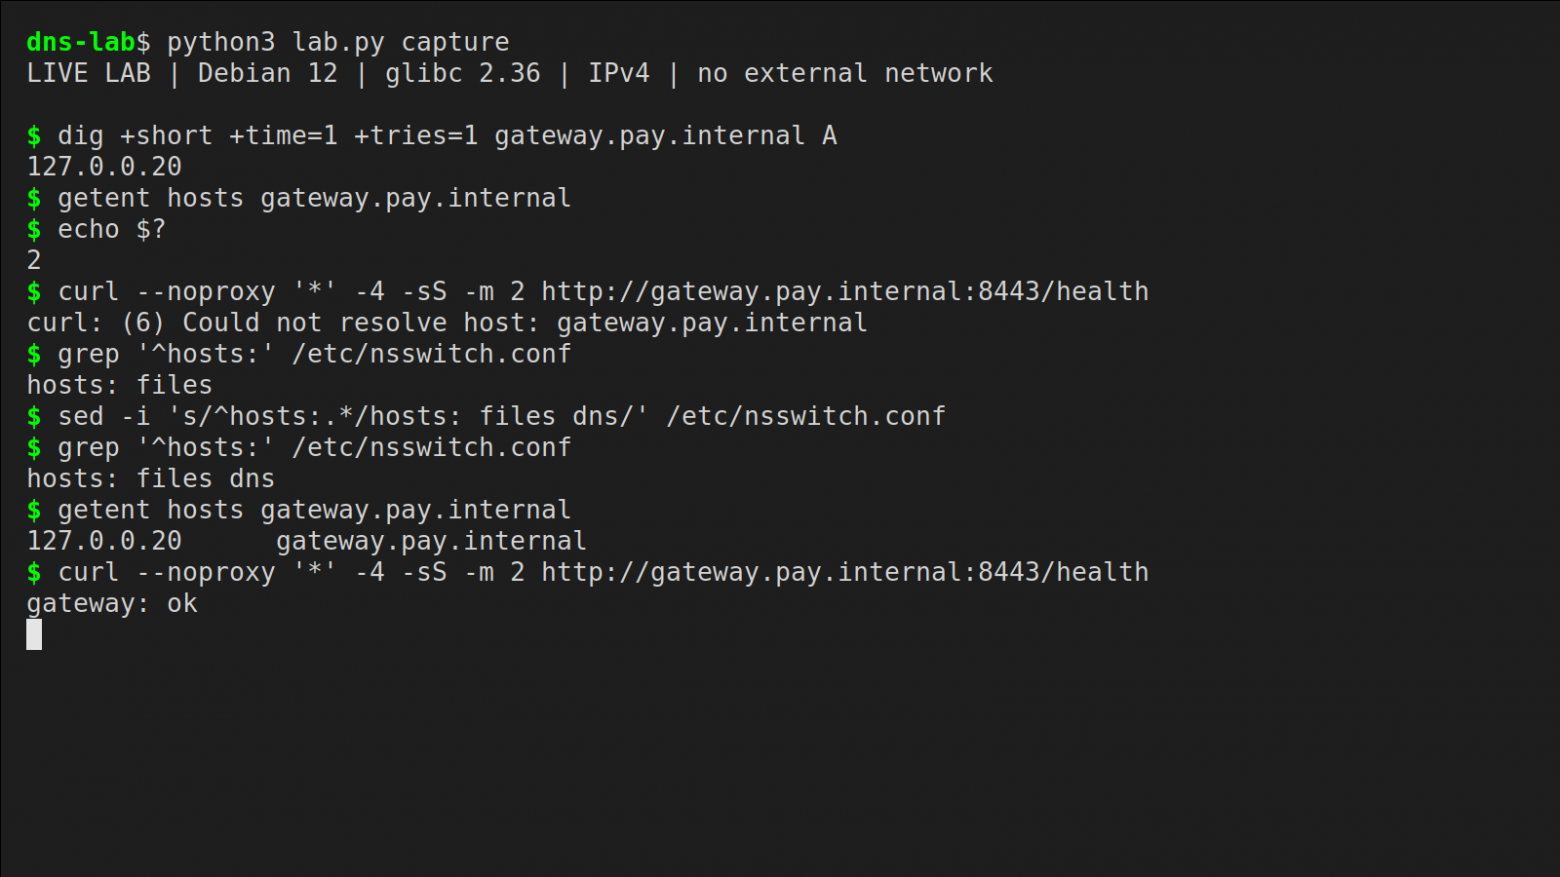
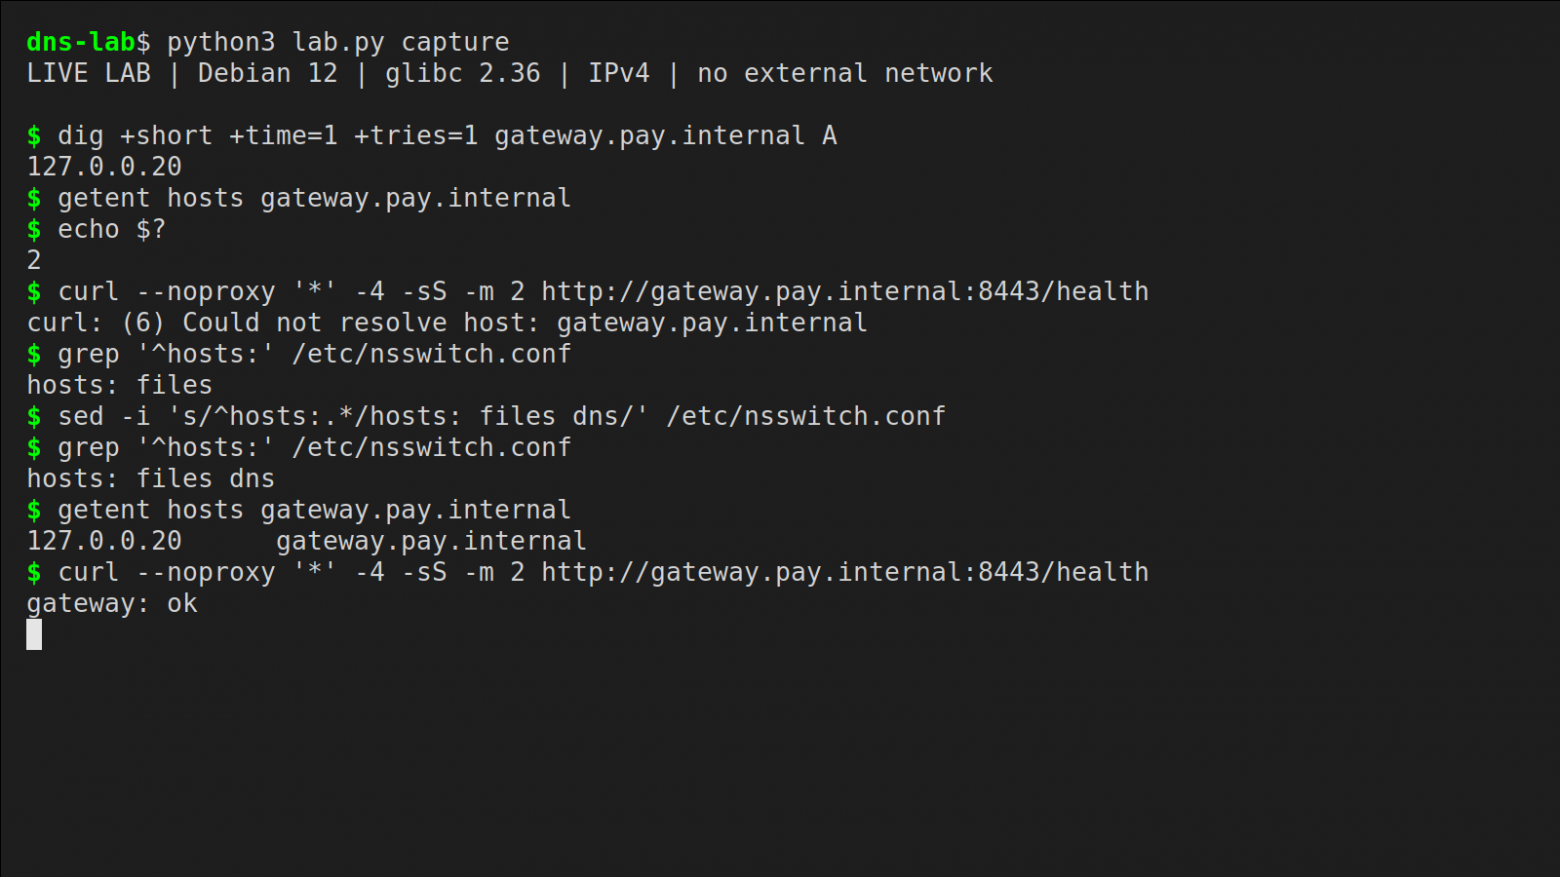
Платёжный шлюз отвечает по IP. DNS возвращает правильный адрес. Но приложение пишет Could not resolve host, и платежи не проходят. Если после успешного dig вычеркнуть разрешение имён из списка подозреваемых, расследование уйдёт в сторону.

В моём тренажёре Prod is Down есть кейс «Платёжный шлюз недоступен». Один из его вариантов построен именно на таком расхождении. Ниже - отдельный воспроизводимый эксперимент с настоящими dig, getent, curl и glibc. Это учебный стенд в изолированном контейнере.

Читать далее

Миграция ещё не выполнилась, а SELECT уже ждёт: очередь блокировок PostgreSQL

Уровень сложностиПростой
Время на прочтение2 мин
Охват и читатели5.5K

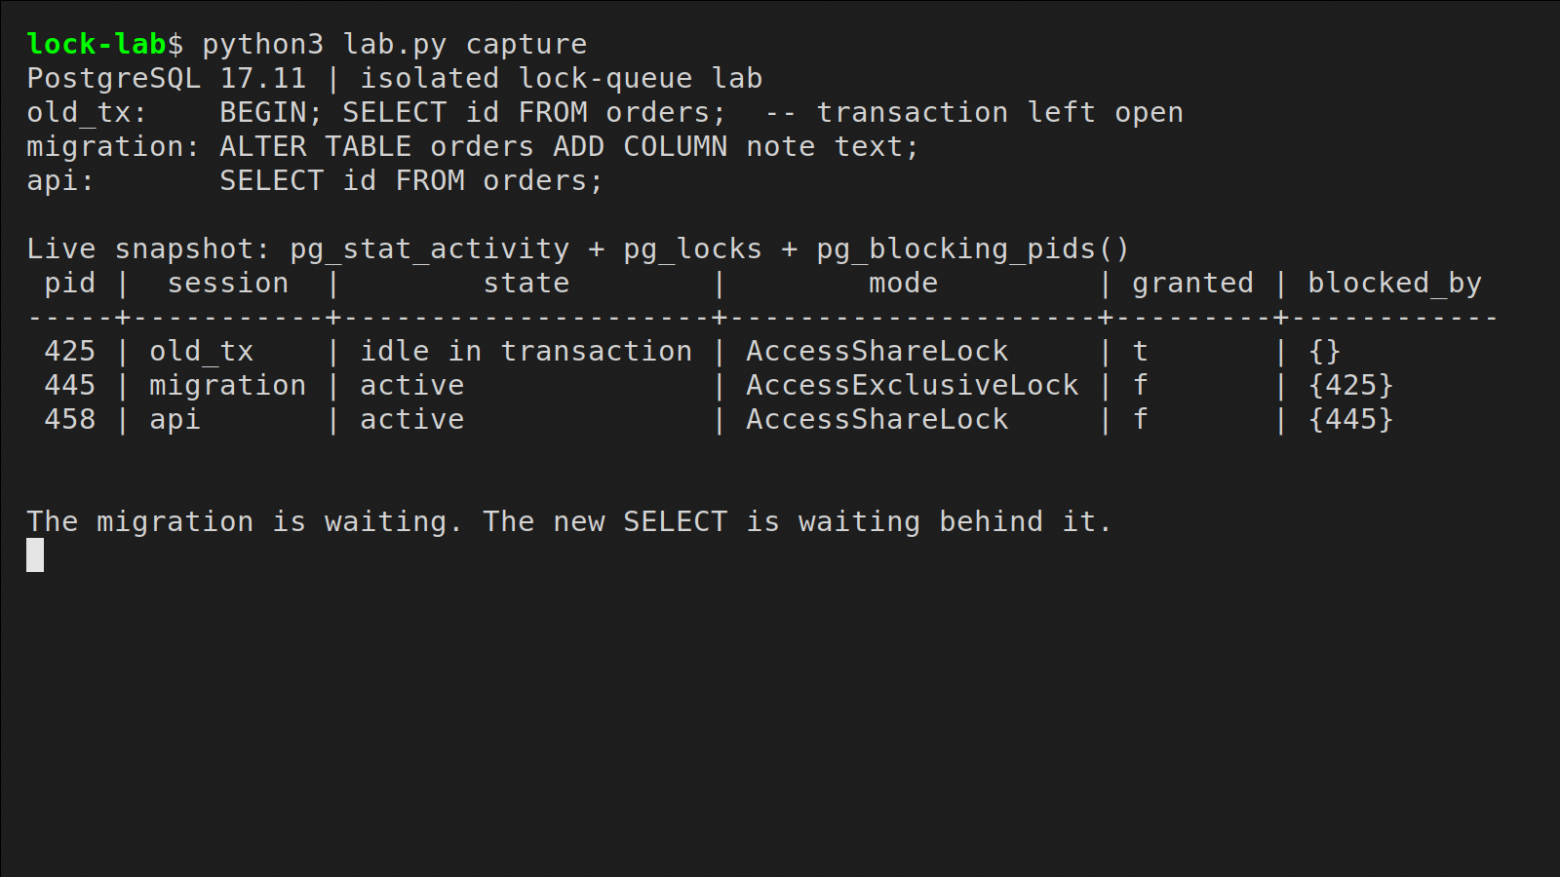
При создании кейса на в моем тренажере, который я рассказывал ранее, возникло следующее: добавление пустой колонки выглядит безобидной миграцией: переписывать данные не нужно. Но такой ALTER TABLE может остановить новые чтения таблицы ещё до изменения её структуры. Достаточно старой транзакции, которую забыли завершить. Поясню эту цепочку на отдельном PostgreSQL 17.11 с таблицей orders из одной строки.

Сначала первая сессия выполняет BEGIN и SELECT id FROM orders, после чего остаётся открытой. Сам запрос уже завершён, но транзакция продолжает держать AccessShareLock. Это не мешает другому обычному SELECT: такие блокировки совместимы. Проверка до запуска миграции возвращает строку без ожидания старой транзакции.

Затем вторая сессия запускает ALTER TABLE orders ADD COLUMN note text. Для этого изменения нужна AccessExclusiveLock, несовместимая с блокировкой первой сессии. Миграция встаёт в очередь. Если теперь третья сессия выполнит SELECT id FROM orders, она тоже будет ждать. Её AccessShareLock совместима с уже выданной блокировкой первой сессии, однако впереди стоит запрос миграции на исключительный доступ.

На снимке консоли видна вся цепочка. Сессия old_tx находится в состоянии idle in transaction и держит выданную блокировку: granted = t. У migration блокировка ещё не выдана, а blocked_by указывает на old_tx. Новый запрос api также имеет granted = f, но его blocked_by указывает уже на migration. Таким образом, источник ожидания и непосредственный блокировщик запроса — разные сессии. После ROLLBACK в old_tx миграция завершается, а новый SELECT получает результат.

Читать далее

Сервис тормозил. Уменьшили таймаут — стало хуже

Уровень сложностиПростой
Время на прочтение3 мин
Охват и читатели5.4K

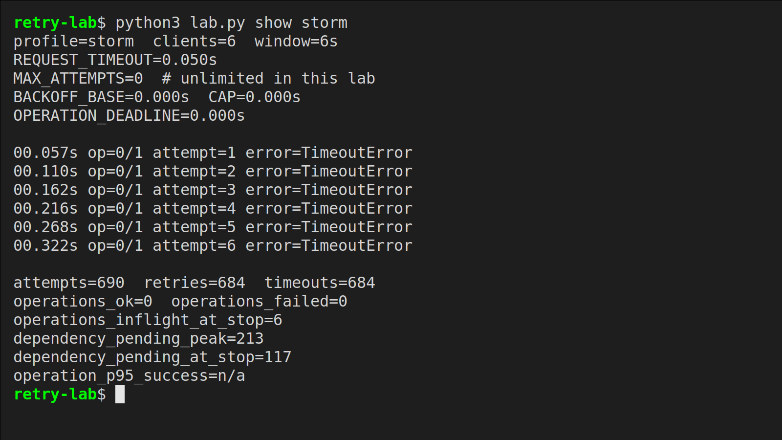
Когда API долго ждёт зависимость, хочется сократить таймаут. Запрос быстрее получит ошибку, освободит ресурсы и перестанет висеть. Но сразу возникает следующий вопрос: что приложение сделает после этой ошибки? Если оно без паузы повторит тот же вызов, короткое ожидание может превратиться в большую очередь на другой стороне.

В моём проекте Prod is Down есть учебный кейс с такой цепочкой: первое исправление вскрывает проблему с повторами. Для этого разбора я собрал отдельный локальный стенд и сравнил четыре варианта настроек.

Условия простые: шесть клиентов обращаются к небольшому TCP-сервису на 127.0.0.1. Одновременно сервис обрабатывает три задания. Первые две секунды обработка занимает 250 мс, затем возвращается к 20 мс. Каждый клиент начинает следующую операцию после завершения предыдущей и небольшой паузы. Каждый вариант запускается на шесть секунд с пустой очередью.

Важное условие: принятое задание продолжает выполняться, даже если клиент уже закрыл соединение. Так устроена наша тестовая зависимость - отмену принятой работы мы здесь не реализуем. В конкретном приложении это поведение нужно проверять отдельно.

Сначала оставляем таймаут в одну секунду. Медленный вызов успевает завершиться: первая операция получает ответ примерно через 256 мс. За весь прогон клиенты выполнили 513 успешных операций. Таймаутов не было, а максимум одновременно обрабатываемых и ожидающих заданий составил шесть.

Теперь меняем только время ожидания: вместо 1000 мс ставим 50 мс. Повторы по-прежнему бесконечные, паузы между ними нет. В настройках нашего стенда это MAX_ATTEMPTS=0 и BACKOFF_BASE=0. Ноль здесь означает отсутствие ограничения, у других библиотек такое значение может иметь другой смысл.

Читать далее

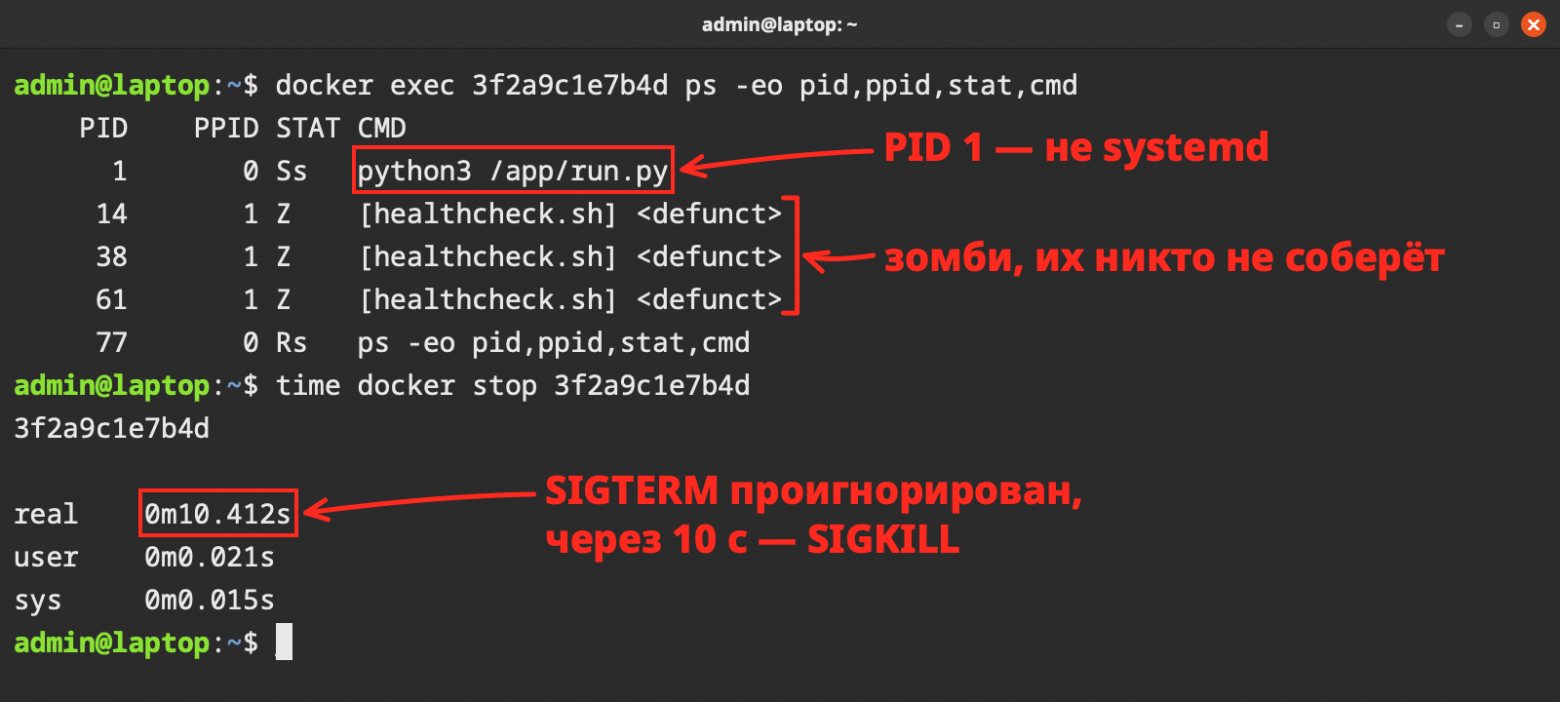
Контейнер притворяется сервером: четыре места, где выдаёт себя

Уровень сложностиПростой
Время на прочтение4 мин
Охват и читатели7.7K

Почему free в Docker врёт и ещё три сюрприза PID 1: systemctl, journalctl, free: что ломается, когда сервер - это контейнер?

Читать далее

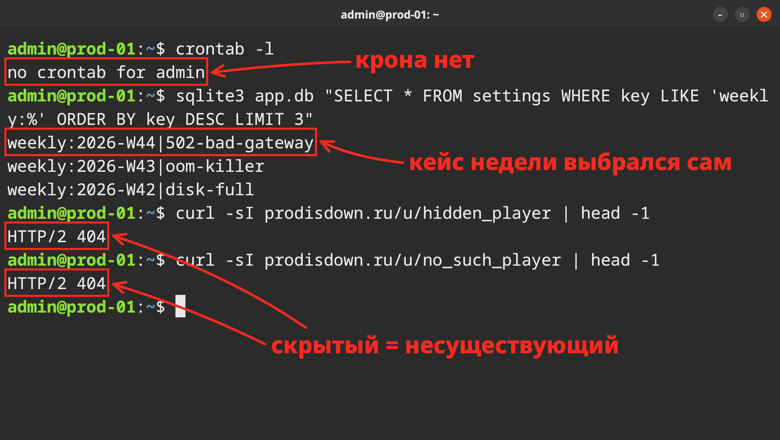
Дежурство недели: еженедельный рейтинг на Flask и SQLite без крона

Уровень сложностиПростой
Время на прочтение3 мин
Охват и читатели8.4K

В прошлых статьях я рассказывал, как устроен мой тренажёр инцидентов, и разбирал кейс с 502 Bad Gateway. Сегодня утром я релизнул два новых режима: «дежурство недели» и публичный профиль игрока. Покажу, как они устроены: там нет ни крона, ни новых таблиц, и всё равно есть пара мест, где легко ошибиться.

Читать далее

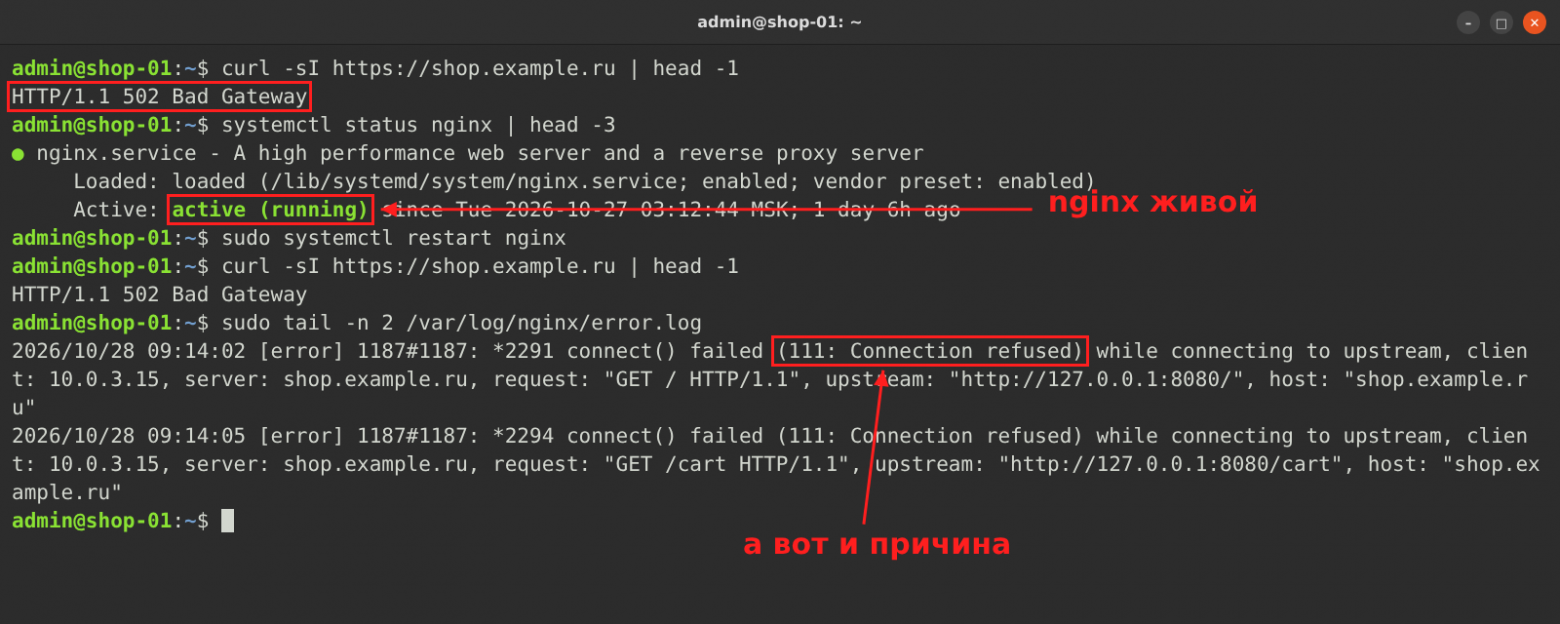
502 Bad Gateway: три причины и куда смотреть

Уровень сложностиПростой
Время на прочтение2 мин
Охват и читатели5.9K

В прошлой статье я рассказывал, как устроен мой тренажёр инцидентов изнутри. Сегодня покажу один кейс, седьмой, про 502 Bad Gateway. Он небольшой, но на нём хорошо видно, почему рестарт nginx почти никогда не помогает.

Вводная такая: ночью выкатили релиз, утром магазин отдаёт 502. При этом systemctl status nginx показывает active (running).

502 значит, что nginx запрос принял, передал дальше и нормального ответа не получил. То есть nginx тут свидетель, и начинать надо с его лога:

Читать далее

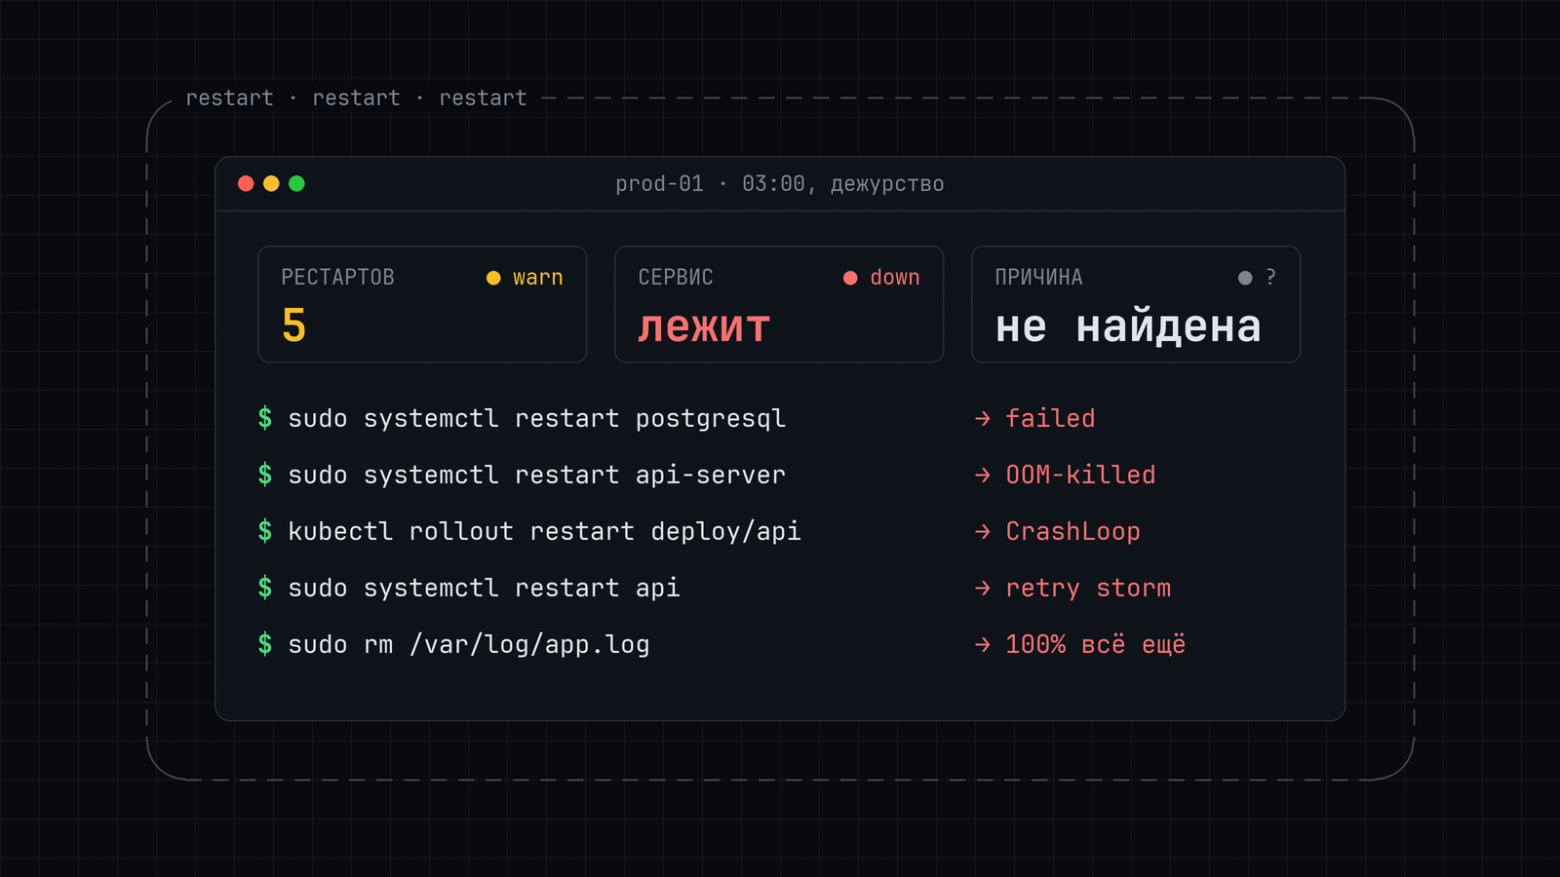
Перезапустил — и стало хуже: 5 инцидентов, которые не лечатся рестартом

Уровень сложностиСредний
Время на прочтение9 мин
Охват и читатели8.6K

Три часа ночи, API отвечает 500, и рука сама набирает systemctl restart. Иногда это помогает, но есть инциденты, где рестарт добивает то, что ещё работало, и стирает улики. Пять таких: битый конфиг, OOM killer, retry storm, CrashLoopBackOff и диск, забитый логом, — с командами, которые находят настоящую причину, и шпаргалкой на одну таблицу.

Читать далее

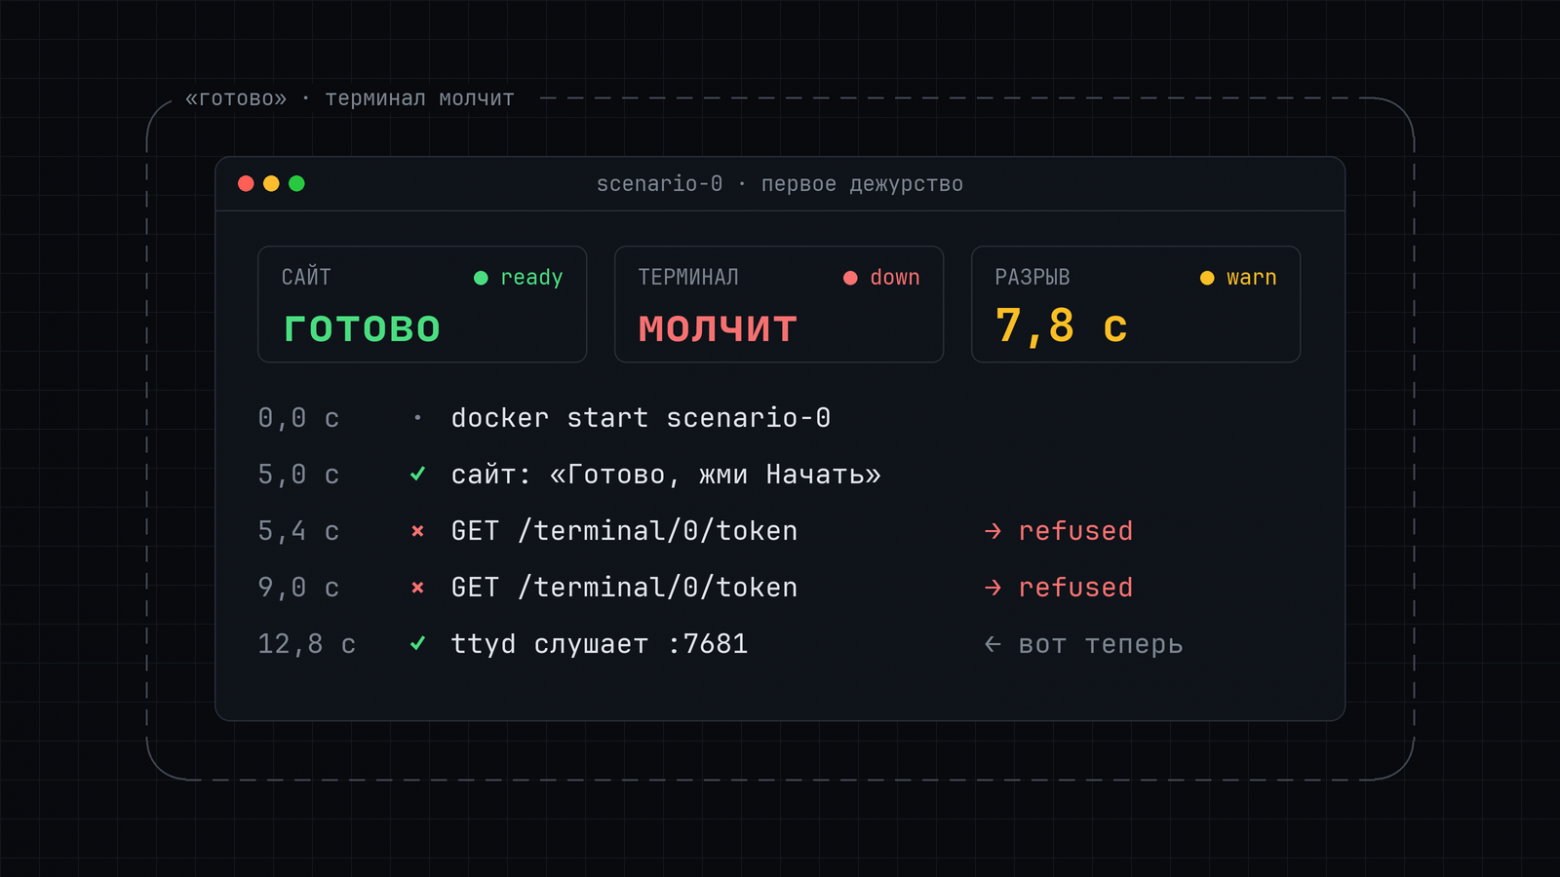
Мой сервер врал «готово» каждому новичку

Уровень сложностиСредний
Время на прочтение7 мин
Охват и читатели6.1K

Новичок открывает первый кейс, о котором я рассказывал в первой статье., читает брифинг, и через пять секунд сайт пишет: «Готово, жми „Начать“». Он жмёт и смотрит на пустое окно терминала. Секунд через десять там ошибка, страница сама перезагружает терминал, и только потом появляется консоль.

Сервер при этом не падал, CPU и память в норме, алерты молчат. Были только строчки в журнале, которые я чуть не записал в «обычный шум».

Читать далее

Я раздаю root на своём сервере всем подряд — и он до сих пор жив

Время на прочтение10 мин
Охват и читатели5.3K

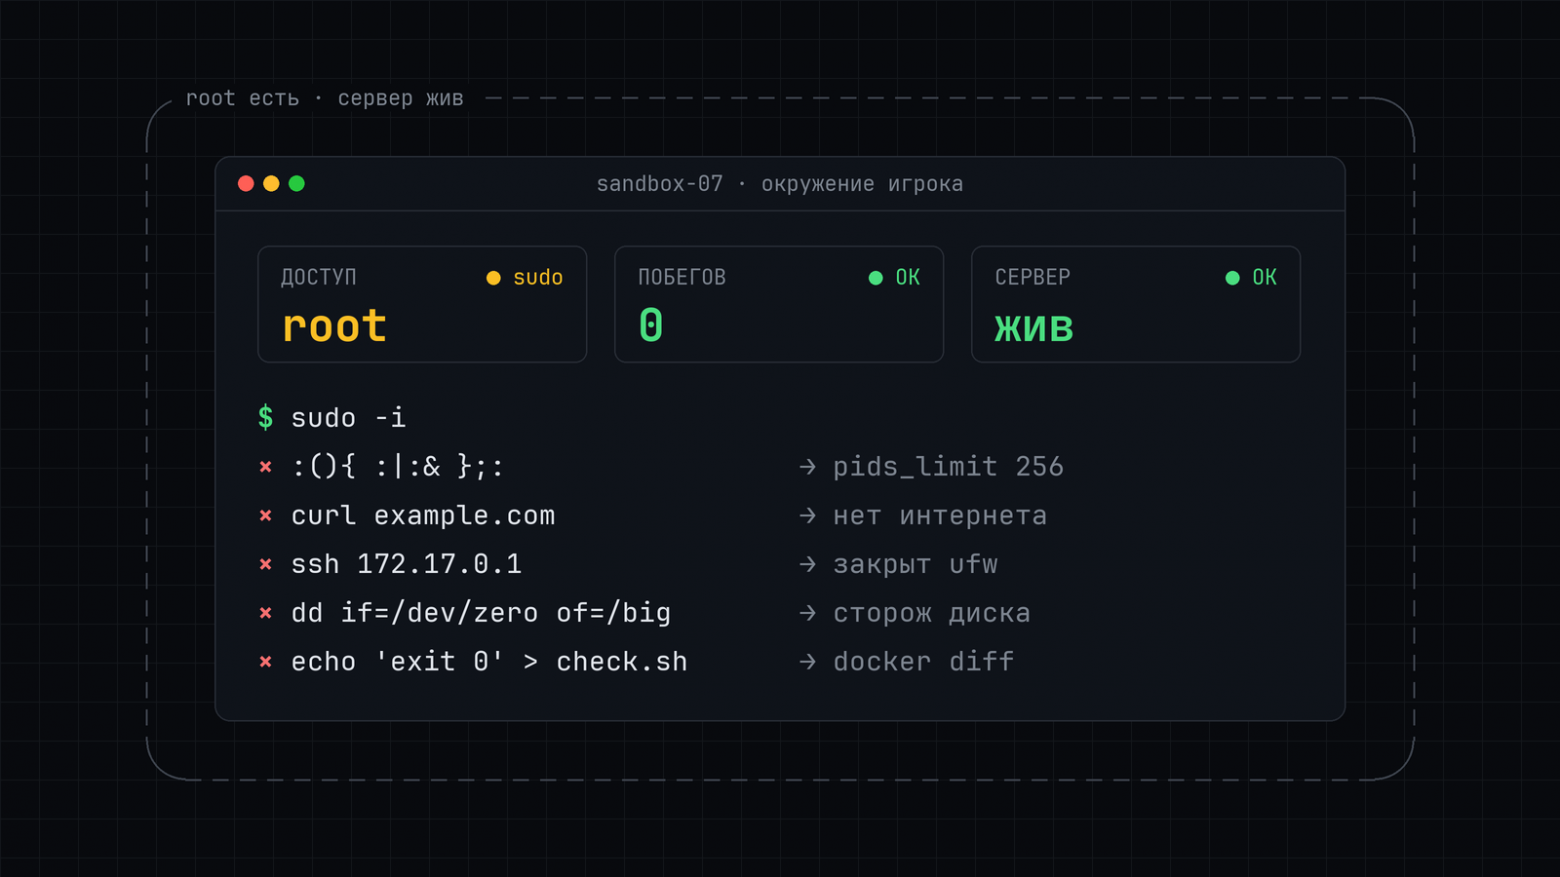
Рассказываю, что может натворить человек с root в контейнере и как я это закрыл: gVisor вместо runc, отдельная сеть на каждый запуск, лимиты, сторож диска и проверка, которую не обмануть через sudo. Плюс три дыры в «идеальной» сетевой изоляции и замеры: почему load average врёт и как 3 места на сервере превратились в 9.

Читать далее

Прод лежит, а CPU, память и диск в порядке: 5 причин, о которых не думаешь

Уровень сложностиПростой
Время на прочтение10 мин
Охват и читатели8.4K

Алерт: сайт лежит, а CPU, память и диск в норме. Разбираю пять причин, которых не видно на стандартном дашборде: inode, лимит файловых дескрипторов, ушедшие часы, DNS и протухший сертификат. Для каждой — как выглядит, чем найти, как починить и что добавить в мониторинг.

Читать далее

Первые 5 минут инцидента: чек‑лист дежурного

Уровень сложностиПростой
Время на прочтение5 мин
Охват и читатели6.1K

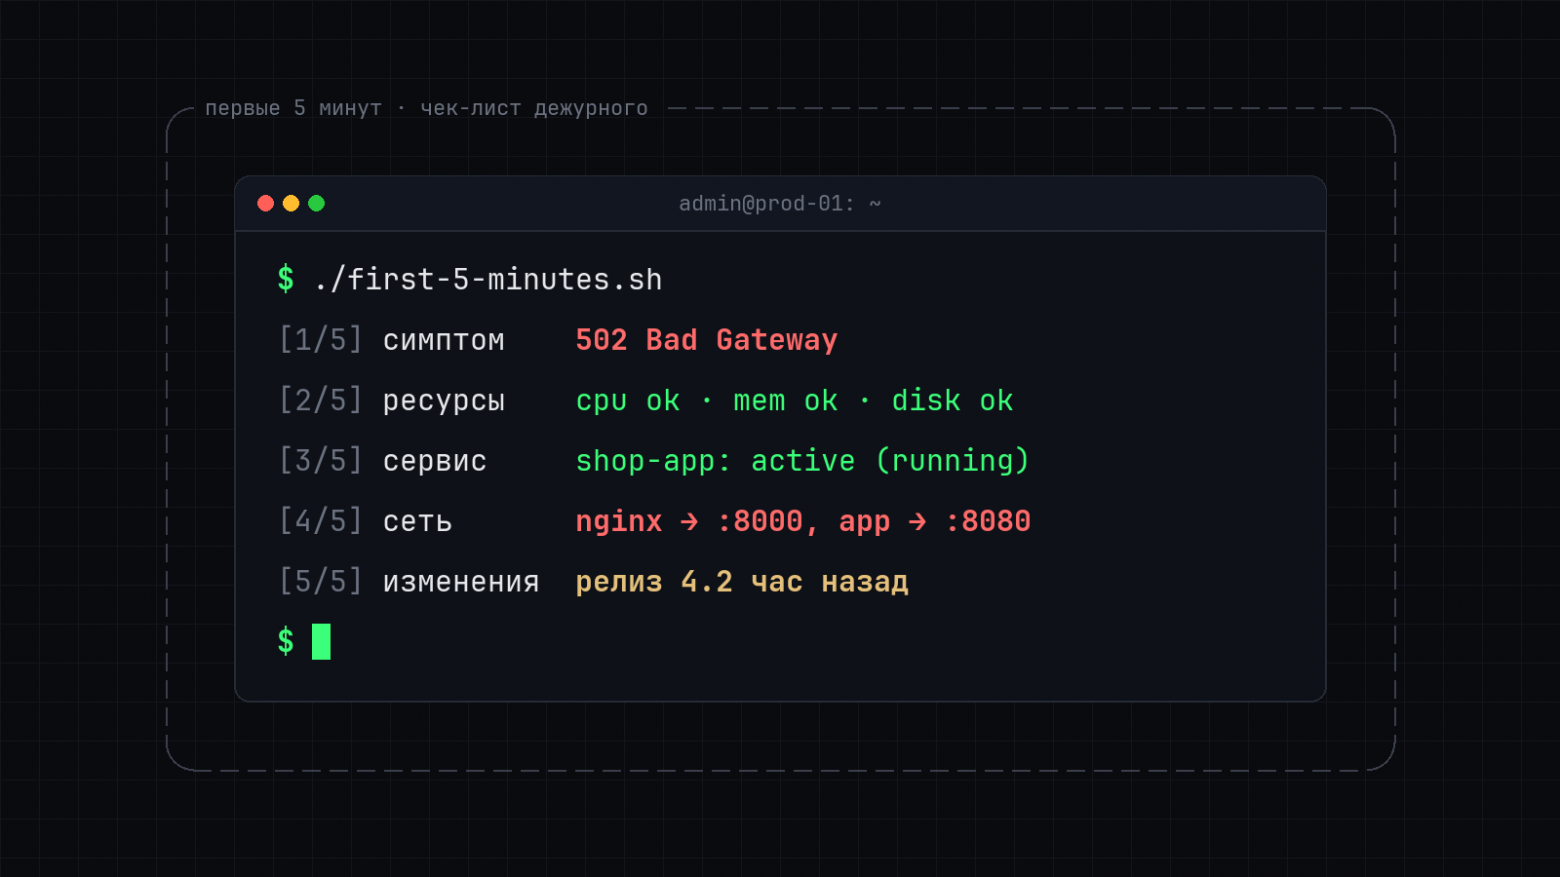
В первые минуты инцидента важнее всего не скорость, а порядок. Когда сыплются алерты, руки сами тянутся перезапустить сервис или что-нибудь удалить. А причину быстрее находит тот, кто проходит одни и те же шаги в одном и том же порядке.

Ниже мой чек-лист для Linux-сервера: пять шагов, по нескольку команд на каждый. Я собрал его, пока делал 13 кейсов для тренажёра дежурств (о нём была первая статья). Поэтому у каждого шага есть пример из кейса, где именно он находит причину.

За пять минут чинить не обязательно. Задача этих минут — понять, в каком слое проблема, и ничего не сделать хуже.

Читать далее

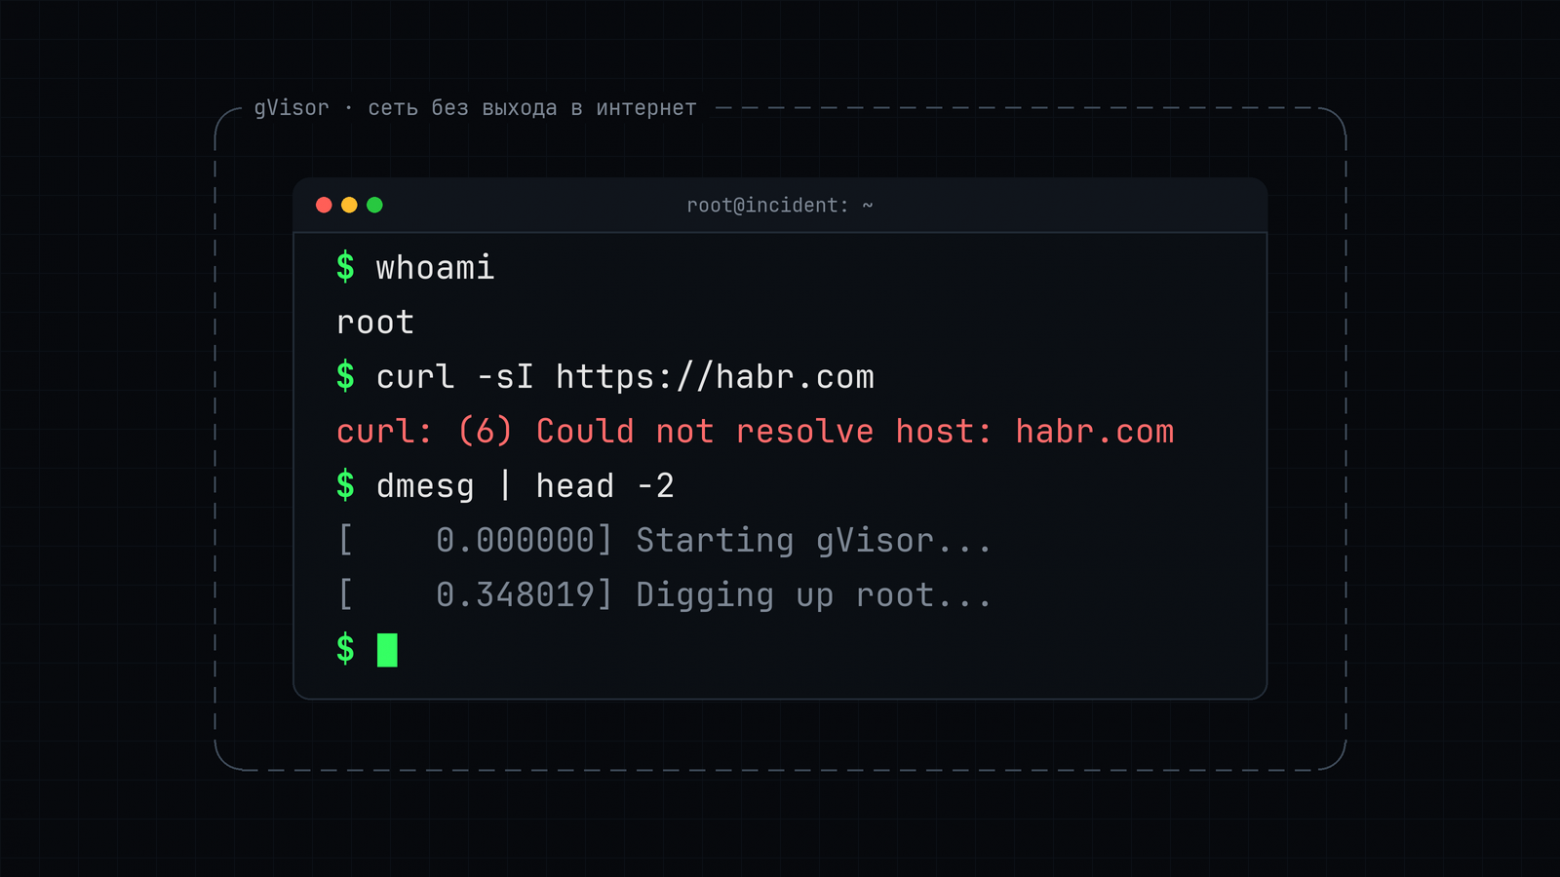
Как я дал незнакомцам root-консоль на своём сервере: тренажёр инцидентов на gVisor

Уровень сложностиСредний
Время на прочтение7 мин
Охват и читатели9K

Я сделал бесплатный тренажёр, где дежурство можно прожить до того, как оно случится на проде: приходит алерт, у вас настоящая консоль Linux со сломанным сервисом, и нужно найти причину и починить. Называется он Prod is Down.

Я 4 года работаю системным администратором. Самое запомнившееся дежурство случилось в первый же месяц: в три часа ночи лёг один из наших сервисов, алерты сыпались один за другим, а я смотрел в консоль и не понимал, с чего начать. Логи? top? Перезапустить всё подряд? Сервис я тогда поднял через час и скорее везением, а настоящую причину — забитый логами диск — нашёл только утром.

Потом я не раз видел то же самое у других: человек знает команды, но под давлением алертов не умеет искать причину. На курсах разбирают команды по одной, а навык расследования появляется только после настоящих инцидентов. Устраивать инциденты на проде ради обучения никто не даст.

Так появилась идея — место, где сервер ломается по-настоящему, но без последствий: можно ошибиться, сбросить всё и попробовать снова.

Сейчас в тренажёре 13 кейсов: обучающий кейс 0 и 12 инцидентов — упавший PostgreSQL, OOM Killer, забитый диск, истёкший сертификат, 502 от nginx, кончившиеся inode, DNS, лимит открытых файлов, сбитое время и другие. Ничего устанавливать не нужно, консоль открывается в браузере; кейс 0 проходится без регистрации.

В статье расскажу не столько про тренажёр, сколько про инженерные задачи внутри: как дать незнакомым людям root-консоль на своём сервере и не пожалеть, как проверить, что игрок действительно починил сервис, и на что я наступил с gVisor.

Читать далее

Информация

В рейтинге
151-й
Зарегистрирован
Активность

Специализация

Системный администратор, DevOps-инженер
Средний
Git
Docker
Linux
Bash