
1. Введение
Инфраструктура вывода больших языковых моделей традиционно оптимизируется по пропускной способности и задержке: KV‑кэш, CUDA‑графы, батчинг, квантизация, параллелизм. Эти компоненты формируют «скелет» системы и задают её предельные характеристики. Однако за пределами этого фокуса нередко остаётся слой, определяющий не скорость, а качество. Это параметры семплирования — правила выбора следующего токена из распределения логитов на каждом шаге декодирования.
Смещение приоритетов объяснимо: эти параметры не влияют на ядро инференса, память или число обслуживаемых запросов. Но их недооценка обходится дорого: система, безупречная по throughput и latency, с неоткалиброванным декодированием уходит в повторы, обрывает рассуждение, теряет формат ответа или в RAG‑сценариях порождает правдоподобные, но не подкреплённые источниками утверждения. Формально она «работает», но не находится в боевом состоянии.
Статья разбирает параметры семплирования на понятном и простом языке — их математическую природу, взаимодействие и роль в разных режимах (чат, reasoning, RAG) — на примере OpenWebUI + vLLM, где параметры управляются динамически в зависимости от включённого поиска или режима рассуждения.
2. Базовые понятия: логиты, распределение и акт выбора
2.1. Логиты
Языковая модель не выдаёт готовое слово. На каждом шаге она получает уже написанный текст x1:t («Я люблю пить по утрам горячий...») и возвращает вектор логитов — по одному числу на каждый токен из словаря. Словарь (V - vocabulary) современных моделей — это обычно от десятков тысяч до двухсот тысяч токенов, так что логитов на каждом шаге тоже столько же. Логит zi — это просто число, которое показывает, насколько модель «склоняется» к токену i (например, слово «чай» — 10 баллов, «кофе» — 9 баллов и тд). Это ещё не вероятность: логиты могут быть отрицательными, большими, маленькими, и их сумма ни к чему не привязана. Их абсолютные значения зависят от внутренней нормировки модели, поэтому сравнивать логиты между разными запросами напрямую нельзя.
2.2. Вероятность
Чтобы получить распределение вероятностей над словарём, к логитам применяется операция softmax:
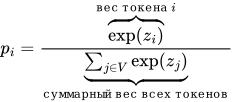
Про распределение вероятностей
Почему вес токена i это exp(zi). Потому что логиты бывают отрицательные, а веса нет (доля не может быть отрицательной). Сохраняет порядок и подчёркивает разницу. Если z1 > z2, то и exp(z1) > exp(z2). При этом разница в логитах превращается в разницу в разы: логит, который больше на 1, даёт вес в e раз больше. Модель как бы «усиливает» своего лидера.
Соответсвенно суммарный вес всех токенов это сумма exp(zi).
Теперь каждое pi — это вероятность того, что следующим токеном будет токен i, и все pi вместе дают единицу. Важно помнить: это оценка модели, а не «истина». Если модель уверена (например, после «Столица Франции — „), распределение имеет ярко выраженный пик на слове „Париж“. Если контекст допускает много равноправных продолжений, распределение становится плоским, и вероятности распределяются между десятками кандидатов.“»
2.3. Декодирование
Генерация — это цикл (упрощенно):
модель выдаёт распределение вероятностей над словарём →
из него выбирается один следующий токен →
токен добавляется к контексту →
модель прогоняется снова →
выбирается следующий токен →
и так до стоп‑условия (специальный токен конца, лимит длины, стоп‑строка).
Ключевая операция на каждом шаге — выбор одного токена( x̂ ) из распределения. Существует два принципиально разных способа этот выбор сделать:
Детерминированный (greedy / argmax): всегда берётся токен с максимальной вероятностью. Один и тот же контекст всегда даёт один и тот же ответ.
Стохастический (сэмплирование): токен берётся случайно в соответствии с распределением, x̂ ∼ p (выбран случайно в соответствии с распределением p). Именно этот режим и настраивают параметры семплирования.
2.4. Параметры семплирования
Параметры семплирования — это набор правил, которые преобразуют исходное распределение p перед выбором токена. Каждое правило отвечает на свой вопрос:
Temperature — насколько «острым» или «плоским» сделать распределение в целом.
Top‑k — сколько наиболее вероятных токенов вообще допустить к выбору.
Top‑p (nucleus) — какую долю суммарной вероятностной массы сохранить, отбросив хвост.
Min‑p — насколько вероятным должен быть токен относительно лидера, чтобы остаться в рассмотрении.
Typical sampling — насколько «типичной» по информативности должна быть вероятность токена.
Штрафы за повторения (repetition / frequency / presence penalty) и DRY — как скорректировать логиты уже встречавшихся токенов или фрагментов.
Mirostat — как поддерживать целевую «сюрпризность» генерации на длинной дистанции.
Факт, которое часто упускается: эти правила независимы как понятия, но не независимы как операции. Раскроем его ниже.
Здесь есть тонкость, которую часто упускают. Каждый параметр можно определить сам по себе: чтобы объяснить temperature, не нужно знать, что такое top‑p, и наоборот. В этом смысле они независимы как понятия — каждый представляет собой отдельный, замкнутый рецепт преобразования распределения.
Но в реальном пайплайне они применяются последовательно, и результат каждого шага становится входом для следующего. Это и означает «не независимы как операции»: top-p работает не с исходным распределением модели, а с тем, которое уже получилось после temperature. Поэтому смысл top‑p меняется в зависимости от Temperature хотя само определение top-p никак не упоминает температуру.
В vLLM (V1 sampler) порядок применения зафиксирован и описан в официальной документации модуля
vllm.v1.sample.sampler: сначала применяются штрафы (penalties), затем внутри методаsample—temperature, затемmin-p, затемtop-kи/илиtop-p, и в конце — собственно сэмплирование. Источник: https://docs.vllm.ai/en/v0.14.0/api/vllm/v1/sample/sampler/
2.5. Почему значения «по умолчанию» в vLLM — это на самом деле «выключено»
Довольно часто приходится видеть такую логику: «В документации написано top_k = -1, top_p = 1.0, min_p = 0.0 — значит, это нейтральные значения, пусть так и стоят». На первый взгляд это разумно: значения по умолчанию обычно воспринимаются как «средние настройки», которые разработчики VLLM выбрали как безопасный компромисс. Но в случае параметров семплирования это не так — и именно здесь кроется одна из самых распространённых ошибок в проде.
2.6. Что на самом деле означают эти значения
Значения по умолчанию в vLLM — это не «средние настройки», а флаги отключения соответствующего фильтра:
top_k = -1означает «учитывать все токены», то есть не отсекать по количеству.top_p = 1.0означает «учитывать все токены», то есть не отсекать по вероятностной массе.min_p = 0.0означает «отключить относительный порог», то есть не отсекать по сравнению с лидером.
Рассмотрим конкретный кейс с отключением всех параметров семплирования (предлагаю вам самостоятельно догадаться, что в конечном итоге проихойдет).
В vLLM температура, равная единице — это нейтральное значение: она не сжимает и не растягивает распределение, вы просто сэмплируете из того распределения, которое выдала модель, без модификаций. Осмысляем:
Температура нейтральна — распределение не меняется.
Top‑k выключен — никакие токены не отбрасываются по количеству.
Top‑p выключен — никакой хвост не отрезается по массе.
Min‑p выключен — никакой относительный порог не применяется.
Результат: вы сэмплируете из полного, неизменённого распределения по всему словарю. Каждый токен — включая те, у которых вероятность 0.0001 — имеет ненулевой шанс быть выбранным. Это и есть «чистое сэмплирование»: никаких фильтров, кроме, возможно, штрафов (которые применяются раньше и к логитам, а не к отсечению).
Дальше мы поговорим о четырех параметрах семплирования и разберем пример с конфликтом параметров.
3. Параметры семплирования: четыре основных
Разберём по отдельности четыре параметра, которые встречаются в конфигах чаще всего: temperature, top‑k, top‑p и min‑p.
3.1. Temperature
Temperature делит все логиты на T перед softmax:
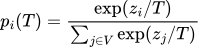
Логиты — это «баллы», которые модель даёт каждому токену. Разница в баллах определяет, насколько один токен вероятнее другого. Temperature — это регулятор, который растягивает или сжимает эту разницу. Делите на T < 1 — разница растягивается, лидер становится ещё более доминирующим. Делите на T > 1 разница сжимается, все токены становятся более «равными».
Следовательно, чем выше температура, тем более стохастическим становится выбор токенов и тем разнообразнее — но менее предсказуем — получается ответ. Чем ниже температура, тем ближе генерация к детерминированной и тем выше воспроизводимость. Для задач, где важна точность и опора на источники (например, RAG), предпочтительна низкая температура; для креативных задач — высокая.
3.2. Top‑k
Top‑k оставляет только k токенов с наибольшими логитами, остальным присваивает нулевую вероятность:
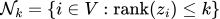
Top‑k — это жёсткий счётчик: «возьми ровно k лучших кандидатов и отрежь всех остальных, независимо от того, насколько модель уверена». Если k=50, то в выборке всегда будут участвовать ровно 50 токенов — хоть при остром распределении (где реально конкурируют 2–3 лидера), хоть при плоском (где шансы есть у десятков). Порог здесь — не вероятность, а позиция в отсортированном списке.
3.3. Top‑p
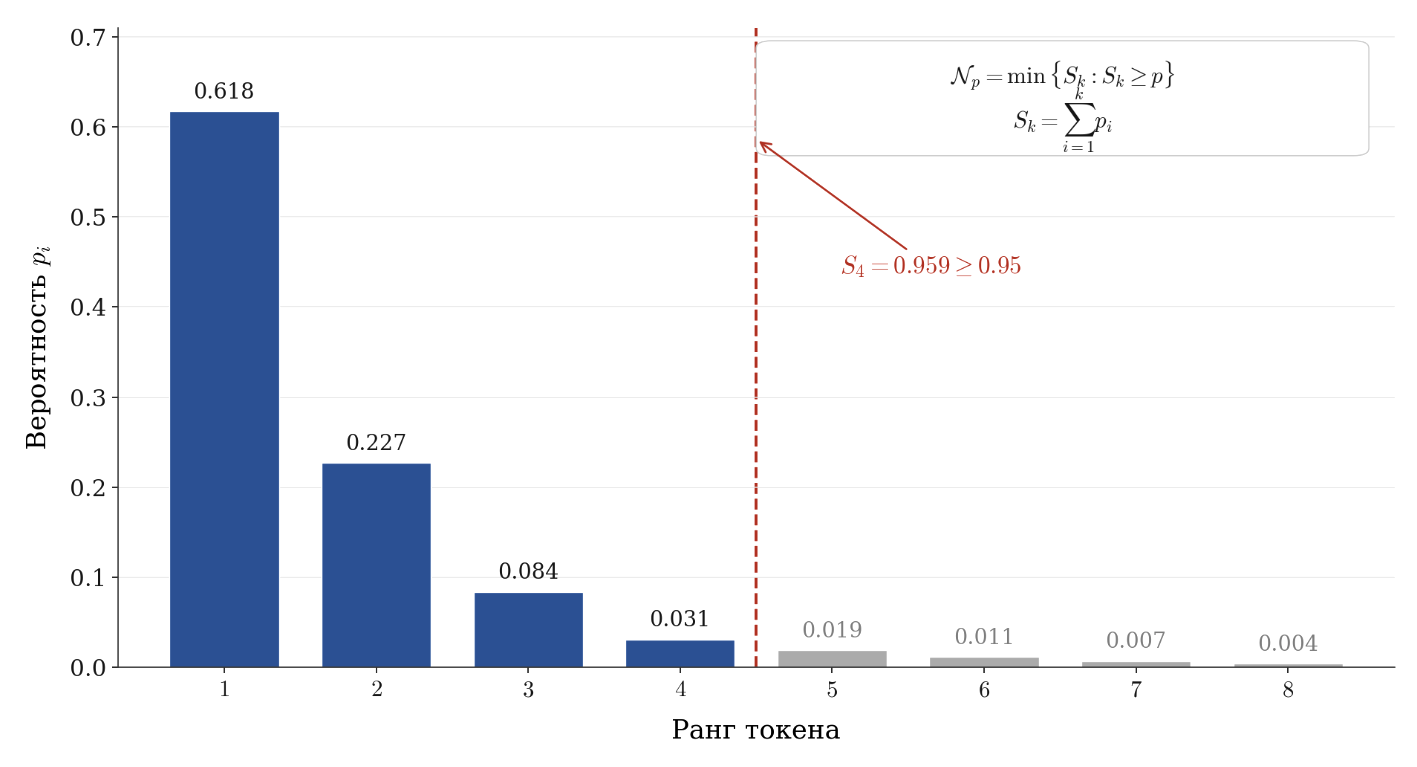
Top‑p сортирует токены по убыванию вероятности, накапливает вероятности сверху вниз и останавливается на первом токене, где накопленная сумма достигает p:
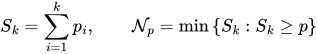
Top‑p — это уже не счётчик, а «бюджет вероятностной массы»: «оставь столько токенов, сколько нужно, чтобы вместе они набрали pp процентов уверенности модели». При остром распределении (модель уверена) 95% массы набирается на 2–3 токенах — и top‑p оставляет 2 — 3. При плоском (модель в замешательстве) те же 95% набираются на десятках токенов — и top‑p оставляет десятки.
Пример top_p = 0.95
Логиты восьми токенов: z=[3, 2, 1, 0, −0.5, −1, −1.5, −2].
После softmax:
Ранг | Логит | pi | Sk |
1 | 3.0 | 0.6175 | 0.6175 |
2 | 2.0 | 0.2272 | 0.8447 |
3 | 1.0 | 0.0836 | 0.9283 |
4 | 0.0 | 0.0307 | 0.9590←порог 0.95 |
5 | -0.5 | 0.0187 | 0.9777 |
6 | -1.0 | 0.0113 | 0.9890 |
7 | -1.5 | 0.0069 | 0.9959 |
8 | -2.0 | 0.0042 | 1.0000 |
top_p = 0.95: идём сверху вниз, накапливаем. На ранге 3 сумма 0.9283 — меньше 0.95. На ранге 4 — 0.9590, порог впервые достигнут. Стоп. Выживают токены с рангами 1–4, остальные четыре отрезаются.
Перенормировка
Выжившие вероятности уже не дают единицу (0.9590), поэтому делим каждую на эту сумму:
Ранг | pi | pi/0.9590 |
1 | 0.6175 | 0.644 |
2 | 0.2272 | 0.237 |
3 | 0.0836 | 0.087 |
4 | 0.0307 | 0.032 |
Сумма — снова 1.0. Из этого распределения и сэмплируется следующий токен.
3.4. Min‑p
Min‑p оставляет токены, чья вероятность не меньше относительного порога, привязанного к вероятности лидера:
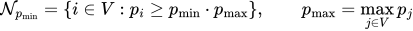
Min‑p — это «порог относительно лидера»: «оставь токены, которые не слишком сильно отстают от самого вероятного». Если модель уверена (p max большой), порог p min * p max получается высоким — и min‑p отсекает агрессивно, оставляя только близких конкурентов лидера. Если модель в замешательстве (p max маленький), порог падает вместе с ним — и ядро расширяется, допуская больше альтернатив. Здесь, в отличие от top‑p, порог не абсолютный, а относительный: он масштабируется уверенностью модели.
min‑p — это попытка решить главную слабость top‑p: чувствительность к температуре.
4. Пример: конфликт параметров (top‑p при двух температурах)
Хочу продемонстрировать небольшой пример вы включили два фильтра, оба формально работают, но вместе они дают не тот результат, который вы ожидали. Не потому, что вы ошиблись в настройках, и не потому, что vLLM глючит. А потому, что параметры применяются по очереди, и каждый следующий «видит» то, что оставил предыдущий.
Случай 1: T=1.0, top_p = 0.95
Ранг | Логит | pi | Sk |
1 | 3.0 | 0.6175 | 0.6175 |
2 | 2.0 | 0.2272 | 0.8447 |
3 | 1.0 | 0.0836 | 0.9283 |
4 | 0.0 | 0.0307 | 0.9590 ← стоп |
5 | -0.5 | 0.0187 | - |
6 | -1.0 | 0.0113 | - |
7 | -1.5 | 0.0069 | - |
8 | -2.0 | 0.0042 | - |
Порог 0.95 впервые достигнут на ранге 4. Выживают 4 токена. Хвост из четырёх отрезан.
Случай 2: T=1.5, top_p = 0.95
Логиты делятся на 1.5 — распределение становится площе. После softmax:
Ранг | Логит / 1.5 | pi | Sk |
1 | 2.0 | 0.4621 | 0.4621 |
2 | 1.33 | 0.2372 | 0.6993 |
3 | 0.67 | 0.1218 | 0.8211 |
4 | 0.0 | 0.0625 | 0.8836 |
5 | -0.33 | 0.0448 | 0.9284 |
6 | -0.67 | 0.0321 | 0.9605 ← стоп |
7 | -1.0 | 0.0230 | - |
8 | -1.33 | 0.0165 | - |
Температура сделала распределение площе, вероятность лидера упала (0.62 → 0.46), хвост подрос. Чтобы набрать те же 95%, top‑p вынужден захватить больше токенов.
T = 1.0,  top_p = 0.95            T = 1.5,  top_p = 0.95
──────────────────────────        ──────────────────────────
[1] ████████████████ 0.62         [1] ████████████ 0.46
[2] ██████ 0.23                   [2] ██████ 0.24
[3] ██ 0.08                       [3] ███ 0.12
[4] █ 0.03   ← граница            [4] ██ 0.06
──────────────────────────        [5] █ 0.04
[5] ░ 0.02   (отрезано)           [6] █ 0.03   ← граница
[6] ░ 0.01   (отрезано)           ──────────────────────────
[7] ░ 0.01   (отрезано)           [7] ░ 0.02   (отрезано)
[8] ░ 0.00   (отрезано)           [8] ░ 0.02   (отрезано)
5. Динамическое изменение параметров семплирования
Движок инференса задаёт безопасную базовую линию и границы, а прикладной слой (в нашем случае — фильтры OpenWebUI) получает право динамически переопределять параметры в зависимости от контекста запроса, который движку недоступен.
5.1. Почему статической конфигурации недостаточно
Иерархия приоритетов в vLLM (запрос → параметры запуска сервера → generation_config.json модели → умолчания) и в OpenWebUI (модель → аккаунт → чат) позволяет гибко управлять параметрами, но не знает о режиме запроса. Один и тот же движок обслуживает и RAG, где модель должна следовать извлечённым документам, и reasoning, где она должна исследовать пространство решений, и креативные задачи. Зафиксировать параметры на уровне движка — значит лишить приложение возможности переключать режимы; отдать всё пользователю — получить невоспроизводимые конфигурации. Динамическое переопределение на уровне приложения закрывает этот разрыв: фильтр inlet() видит tool_ids и флаги режима до отправки запроса и может согласованно выставить параметры, которые уйдут в движок как параметры конкретного запроса.
5.2. Политика для режимов
Ключевая идея — таблица политик, где каждому режиму сопоставлен согласованный набор параметров, а не отдельные «ручки». Для трёх режимов политика может выглядеть так:
RAG включён: низкая температура (≈0.15), умеренный
top_p(≈0.9),top_k = 20— модель должна опираться на документы, а не «фантазировать». Reasoning, если он тоже активен, не меняет эти значения: рассуждение не должно уводить в сторону от источников.Reasoning без RAG: чуть выше температура (≈0.3),
top_p ≈ 0.8,top_k = 20— можно позволить вариативность, но не терять связность.Ни RAG, ни reasoning: параметры не переопределяются, используются значения по умолчанию уровня модели или движка.
И так далее ( Все ограничено лишь вашей фантазией)
Важно отметить, что это ориентировочные данные, а реальные цифры будут различаться в зависимости от выбранной модели. Код ниже также является демонстративным.
5.3. Реализация
Переходим в Open WebUI → Панель администратора → Функции → Создать:
"""
title: Dynamic Sampling Policy
author: tnv
description: >
    Динамически подбирает параметры семплирования под режим запроса:
    определяет наличие RAG (по tool_ids) и reasoning (по флагу в
    chat_template_kwargs) и переопределяет temperature, top_p, top_k
    и штрафы согласованным набором. Логирует решение, идемпотентен,
    при ошибке пропускает запрос без изменений.
version: 1.0.0
icon: *
"""

import logging
from typing import Optional

from pydantic import BaseModel, Field

logger = logging.getLogger(__name__)

# Режим -> согласованный набор параметров.
POLICY = {
    (True, False): {"temperature": 0.15, "top_p": 0.9, "top_k": 20,
                    "presence_penalty": 0.0, "frequency_penalty": 0.0},
    (True, True):  {"temperature": 0.15, "top_p": 0.9, "top_k": 20,
                    "presence_penalty": 0.0, "frequency_penalty": 0.0},
    (False, True): {"temperature": 0.3,  "top_p": 0.8, "top_k": 20,
                    "presence_penalty": 0.0, "frequency_penalty": 0.0},
    (False, False): None,  # ничего не переопределяем
}


class Filter:
    class Valves(BaseModel):
        priority: int = Field(default=0, description="Порядок выполнения")
        log_decisions: bool = Field(default=True, description="Логировать выбор")

    def __init__(self):
        self.valves = self.Valves()

    def _rag_is_active(self, body: dict) -> bool:
        tool_ids = body.get("tool_ids") or []
        return any("rag-search" in str(t) for t in tool_ids)

    def _reasoning_is_active(self, body: dict) -> bool:
        kwargs = body.get("chat_template_kwargs") or {}
        if kwargs.get("enable_thinking") is False:
            return False
        if kwargs.get("enable_thinking") is True:
            return True
        if kwargs.get("reasoning_effort"):
            return True
        return bool(body.get("reasoning"))

    async def inlet(self, body: dict, __user__: Optional[dict] = None) -> dict:
        try:
            rag = self._rag_is_active(body)
            reasoning = self._reasoning_is_active(body)
            policy = POLICY.get((rag, reasoning))

            if policy is None:
                if self.valves.log_decisions:
                    logger.info("sampling policy: rag=%s reasoning=%s -> default",
                                rag, reasoning)
                return body

            body.update(policy)

            if self.valves.log_decisions:
                logger.info("sampling policy: rag=%s reasoning=%s -> %s",
                            rag, reasoning, policy)
            return body
        except Exception:
            logger.exception("sampling policy filter failed; passing through")
            return body
Приведённый фильтр — это не «ещё одна настройка сверху», а минимальный каркас для динамической политики семплирования. Его ценность не в конкретных числах, а в архитектурных решениях, которые легко переносятся и масштабируются на любой стек.
6. Вывод
Статья — попытка собрать практический опыт в связный материал, и она не претендует на истину в последней инстанции. Если вы нашли ошибку, неточность или не согласны с аргументацией — напишите об этом в комментариях, чтобы мы совместно могли довести работу до идеала.
