Pull to refresh
3
Евгений Аблесов@Codebaker

User

Send message

19 советов по повседневной работе с Git

Reading time14 min
Reach and readers293K


Если вы регулярно используете Git, то вам могут быть полезны практические советы из этой статьи. Если вы в этом пока новичок, то для начала вам лучше ознакомиться с Git Cheat Sheet. Скажем так, данная статья предназначена для тех, у кого есть опыт использования Git от трёх месяцев. Осторожно: траффик, большие картинки!

Содержание:
  1. Параметры для удобного просмотра лога
  2. Вывод актуальных изменений в файл
  3. Просмотр изменений в определённых строках файла
  4. Просмотр ещё не влитых в родительскую ветку изменений
  5. Извлечение файла из другой ветки
  6. Пара слов о ребейзе
  7. Сохранение структуры ветки после локального мержа
  8. Исправление последнего коммита вместо создания нового
  9. Три состояния в Git и переключение между ними
  10. Мягкая отмена коммитов
  11. Просмотр диффов для всего проекта (а не по одному файлу за раз) с помощью сторонних инструментов
  12. Игнорирование пробелов
  13. Добавление определённых изменений из файла
  14. Поиск и удаление старых веток
  15. Откладывание изменений определённых файлов
  16. Хорошие примечания к коммиту
  17. Автодополнения команд Git
  18. Создание алиасов для часто используемых команд
  19. Быстрый поиск плохого коммита
Читать дальше →

Нестандартная кластеризация, часть 3: приёмы и метрики для кластеризации временных рядов

Reading time16 min
Reach and readers55K
Часть первая — Affinity Propagation
Часть вторая — DBSCAN
Часть третья — кластеризация временных рядов
Часть четвёртая — Self-Organizing Maps (SOM)
Часть пятая — Growing Neural Gas (GNG)

Пока другие специалисты по машинному обучению и анализу данных выясняют, как прикрутить побольше слоёв к нейронной сети, чтобы она ещё лучше играла в Марио, давайте обратимся к чему-нибудь более приземлённому и применимому на практике.

Кластеризация временных рядов — неблагодарное дело. Даже при группировке статических данных часто получаются сомнительные результаты, что уж говорить про информацию, рассеянную во времени. Однако нельзя игнорировать задачу, только потому что она сложна. Попробуем разобраться, как выжать из рядов без меток немного смысла. В этой статье рассматриваются подтипы кластеризации временных рядов, общие приёмы и популярные меры расстояния между рядами. Статья рассчитана на читателя, уже имевшего дело с последовательностями в data science: о базовых вещах (тренд, ARMA/ARIMA, спектральный анализ) рассказываться не будет.

Читать дальше →

Точное вычисление средних и ковариаций методом Уэлфорда

Reading time7 min
Reach and readers26K

Метод Уэлфорда — простой и эффективный способ для вычисления средних, дисперсий, ковариаций и других статистик. Этот метод обладает целым рядом прекрасных свойств:


  • достигает отличных показателей по точности решений;
  • его чрезвычайно просто запомнить и реализовать;
  • это однопроходный онлайн-алгоритм, что крайне полезно в некоторых ситуациях.

Оригинальная статья Уэлфорда была опубликована в 1962 году. Тем не менее, нельзя сказать, что алгоритм сколь-нибудь широко известен в настоящее время. А уж найти математическое доказательство его корректности или экспериментальные сравнения с другими методами и вовсе нетривиально.


Настоящая статья пытается заполнить эти пробелы.


Читать дальше →

Уменьшение операций чтения/записи на Raspberry Pi

Reading time4 min
Reach and readers35K
Введение

Итак, в интернете можно найти статьи о том что в Raspberry флешки «живут» 2-3 месяца, после чего приходят в негодность. Предложенные решения — заменить стандартную microSD карточку на USB HDD. Решение простое, надёжное, плюс повышается скорость чтения/записи. Но почему флешки так быстро «умирают»? Могут ли те же факторы навредить жёсткому диску? И так приступим!
Читать дальше →

Типичные распределения вероятности: шпаргалка data scientist-а

Reading time11 min
Reach and readers161K

У data scientist-ов сотни распределений вероятности на любой вкус. С чего начать?


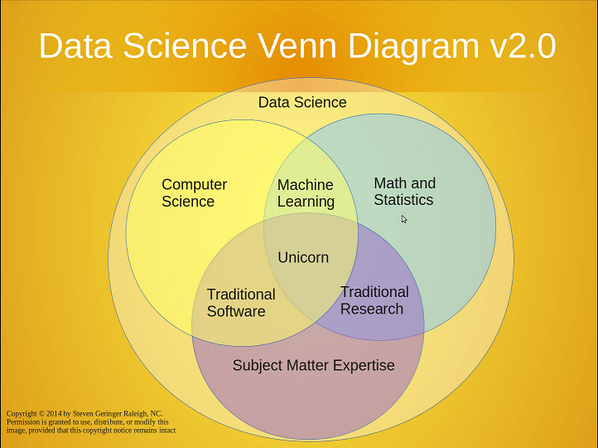
Data science, чем бы она там не была – та ещё штука. От какого-нибудь гуру на ваших сходках или хакатонах можно услышать:«Data scientist разбирается в статистике лучше, чем любой программист». Прикладные математики так мстят за то, что статистика уже не так на слуху, как в золотые 20е. У них даже по этому поводу есть своя несмешная диаграмма Венна. И вот, значит, внезапно вы, программист, оказываетесь совершенно не у дел в беседе о доверительных интервалах, вместо того, чтобы привычно ворчать на аналитиков, которые никогда не слышали о проекте Apache Bikeshed, чтобы распределённо форматировать комментарии. Для такой ситуации, чтобы быть в струе и снова стать душой компании – вам нужен экспресс-курс по статистике. Может, не достаточно глубокий, чтобы вы всё понимали, но вполне достаточный, чтобы так могло показаться на первый взгляд.
Читать дальше →

Как я настраивал новые утилиты по работе с электронной подписью в Linux

Reading time8 min
Reach and readers106K


Поговорим немного про средства электронной подписи (ЭП) с использованием отечественных ГОСТ-алгоритмов в Linux. Несмотря на то, что различные средства и интерфейсы по работе с ЭП в Linux развиты даже лучше, чем в Windows, использовать их не так просто.

Такое положение вещей сохранялось последние несколько лет. Но с конца 2016 года ситуация изменилась в лучшую сторону. Появилось сразу два продукта, которые позволяют работать с электронной подписью по стандарту ГОСТ и шифрованием без использования консоли – это Rosa Crypto Tool и Trusted eSign. Оба эти продукта для работы с криптографией используют «КриптоПро CSP» для Linux. Поэтому, перед тем как обратиться к описанию самих продуктов, поговорим немного про «КриптоПро CSP».
Читать дальше →

Настройка окружения SELinux на примере LAMP-сервера

Reading time8 min
Reach and readers25K

Это третья статья из цикла


И сегодня она попала в поток «Администрирование». Сегодня мы не будем писать модули или настраивать RBAC, а пойдем по пути наименьшего сопротивления и просто захарденим обычный LAMP-сервер при помощи готовой политики, включив необходимые настройки.

Если кто забыл, за аббривиатурой LAMP скрывается Linux, Apache, Mysql, PHP, т.е. это большая часть всех VDS, которые покупают люди для хранения своих личных блогов. Надеюсь, что этот поможет всем им стать немного безопаснее :)
Читать дальше →

Нейронные сети в картинках: от одного нейрона до глубоких архитектур

Reading time7 min
Reach and readers99K
Многие материалы по нейронным сетям сразу начинаются с демонстрации довольно сложных архитектур. При этом самые базовые вещи, касающиеся функций активаций, инициализации весов, выбора количества слоёв в сети и т.д. если и рассматриваются, то вскользь. Получается начинающему практику нейронных сетей приходится брать типовые конфигурации и работать с ними фактически вслепую.

В статье мы пойдём по другому пути. Начнём с самой простой конфигурации — одного нейрона с одним входом и одним выходом, без активации. Далее будем маленькими итерациями усложнять конфигурацию сети и попробуем выжать из каждой из них разумный максимум. Это позволит подёргать сети за ниточки и наработать практическую интуицию в построении архитектур нейросетей, которая на практике оказывается очень ценным активом.
Читать дальше →

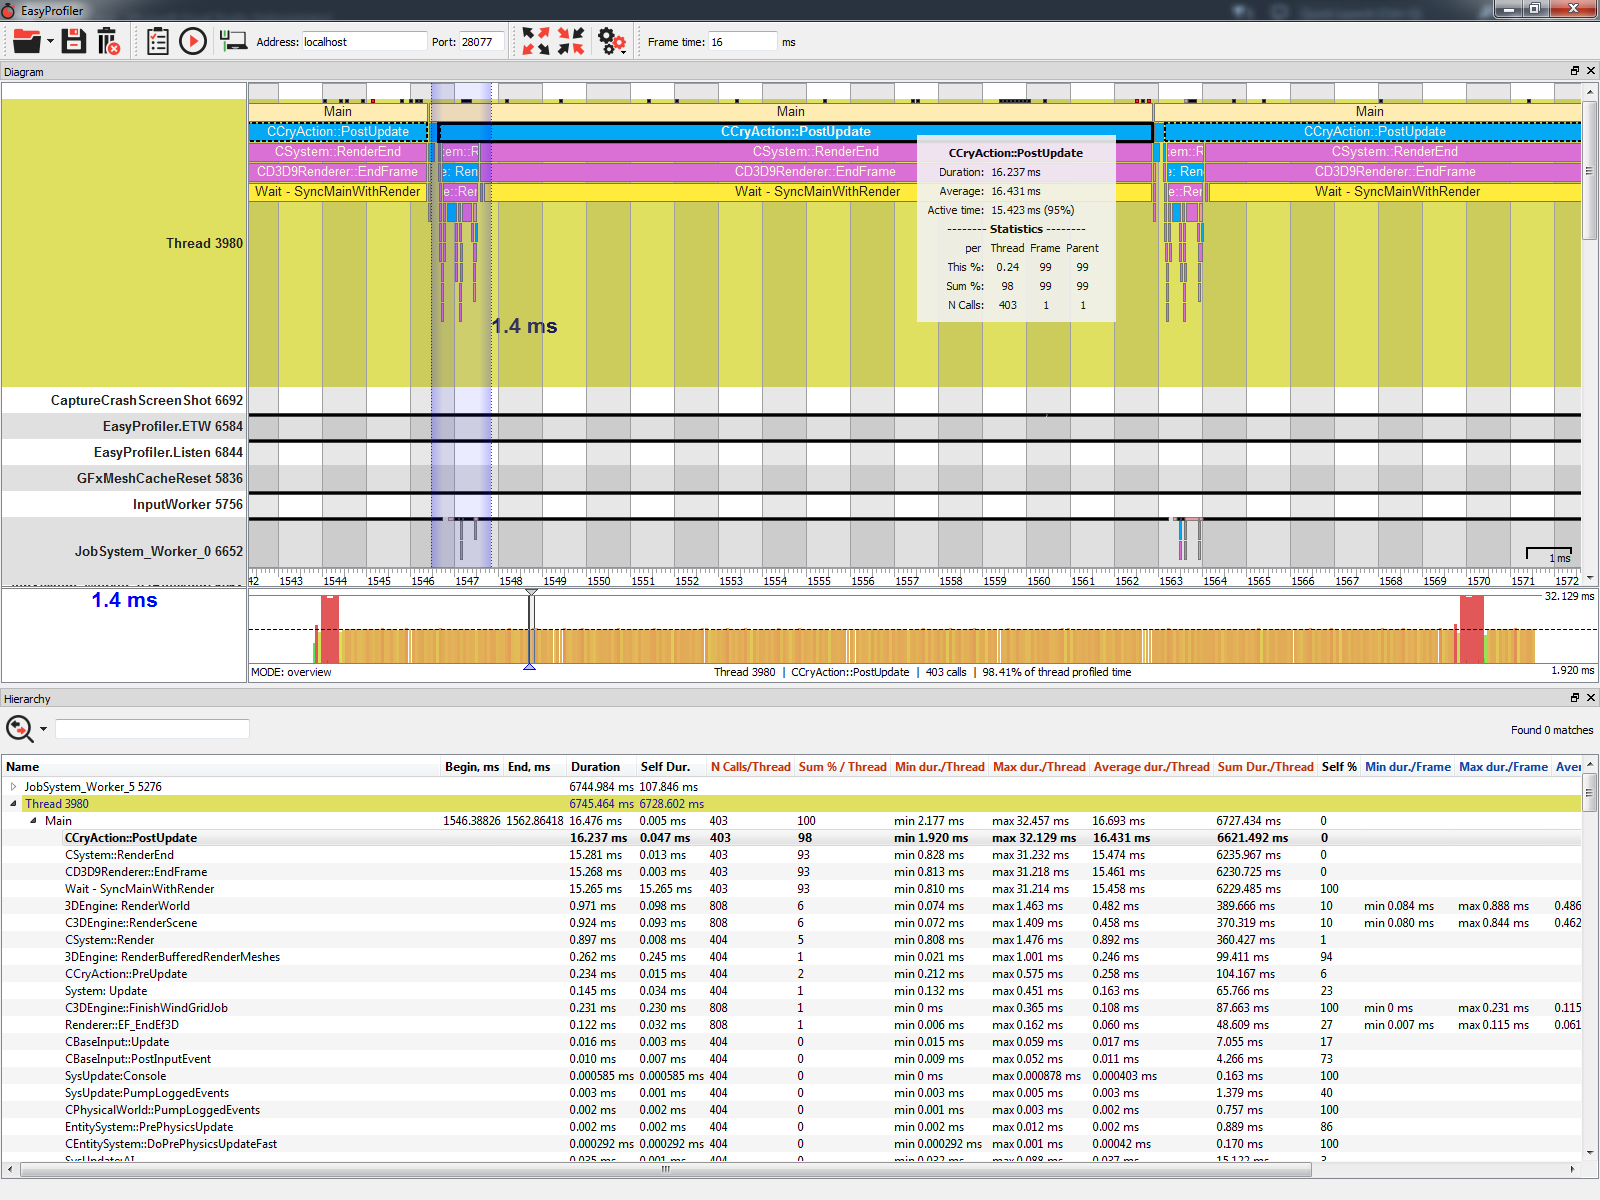
Шустрый, удобный и кроссплатформенный профилировщик C++ кода

Reading time6 min
Reach and readers34K
Всем привет. Несколько месяцев назад мы вместе с victorzs решили сделать простой и удобный профилировщик c++ кода (подразумевается профилирование времени исполнения участков кода, функций).


Скриншот профилирования примера из SDK CryEngine

Существующие решения нам не подходили по ряду причин. Нам нужен был качественный профайлер, умеющий делать следующее:

  • Профилировать выбранные участки кода
  • Работать на нескольких платформах
  • Учитывать переключение контекста
  • Требовать минимальных дополнительных затрат памяти во время профилирования
  • Не накладывать дополнительных временных ограничений во время выполнения приложения. Согласитесь, если профилировщик будет работать дольше, чем профилиуремый кусочек кода, то можно сделать некорректные выводы.

В результате тщательной проработки появился на свет профайлер, умеющий делать всё вышеперечисленное, и даже больше!

Если вы хотите знать, сколько времени работает ваш код, и иметь при этом объективные доказательства — прошу под кат, где я покажу, как использовать профилировщик.
Читать дальше →

Есть две функции

Reading time16 min
Reach and readers55K
Привет

Есть две булевы функции n аргументов, одна — константная, другая — сбалансированная. На какую сам сядешь, на какую фронтендера посадишь? Вот только функции неизвестны, а вызвать их разрешается лишь один раз.

Если не знаешь, как решить подобную задачу, добро пожаловать под кат. Там я расскажу про квантовые алгоритмы и покажу как их эмулировать на самом народном языке — на Python.
Hello darkness, my old friend

Ищем и скачиваем непопулярные и старые файлы в интернете

Reading time14 min
Reach and readers231K
Преимущественно медиафайлы. На полном серьезе, без шуток.

Введение

Бывает, случается так, что вы хотите скачать альбом 2007 года исполнителя, который кроме вас известен 3.5 людям, какой-нибудь испанский ска-панк или малопопулярный спидкор европейского происхождения. Находите BitTorrent-раздачу, ставите на закачку, быстро скачиваете 14.7%, и… все. Проходит день, неделя, месяц, а процент скачанного не увеличивается. Вы ищете этот альбом в поисковике, натыкаетесь на форумы, показывающие ссылки только после регистрации и 5 написанных сообщений, регистрируетесь, флудите в мертвых темах, вам открываются ссылки на файлообменники вроде rapidshare и megaupload, которые уже сто лет как умерли.

Попытка скачать хотя бы один файл
Увы, частая ситуация в попытке хоть что-то скачать

Такое случается. В последнее время, к сожалению, случается чаще: правообладатели и правоохранительные органы всерьез взялись за файлообмен; в прошлом году закрылись или были закрыты KickassTorrents, BlackCat Games, what.cd, btdigg, torrentz.eu, EX.ua, fs.to, torrents.net.ua, и еще куча других сайтов. И если поиск свежих рипов фильмов, сериалов, музыки, мультиков все еще не представляет большой проблемы, несмотря на многократно участившееся удаления со стороны правообладателей контента из поисковых систем, торрент-трекеров и файлообменников, то поиск и скачивание оригинала (DVD или Blu-Ray) фильмов и сериалов или просто ТВ-рипов 7-летней давности на не-английском и не-русском языке — не такая уж простая задача.
Читать дальше →

Малоизвестные Git-команды

Reading time4 min
Reach and readers76K


У Git есть строгие обязательства по обратной совместимости: многие продвинутые возможности скрыты за разнообразными опциями, а не применяются как поведение по умолчанию. К счастью, Git также поддерживает и алиасы, так что вы можете создавать свои собственные команды, которые делают всю характерную для Git магию. Под катом — подборка полезных (или как минимум забавных) алиасов, определённых в моём .gitconfig.
Читать дальше →

Создание сеток шестиугольников

Reading time25 min
Reach and readers112K
image

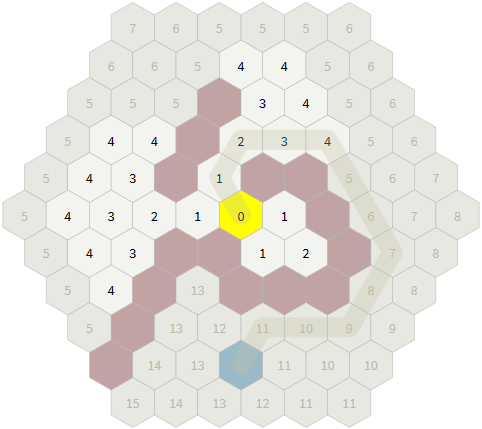
Сетки из шестиугольников (гексагональные сетки) используются в некоторых играх, но они не так просты и распространены, как сетки прямоугольников. Я коллекционирую ресурсы о сетках шестиугольников уже почти 20 лет, и написал это руководство по самым элегантным подходам, реализуемым в простейшем коде. В статье часто используются руководства Чарльза Фу (Charles Fu) и Кларка Вербрюгге (Clark Verbrugge). Я опишу различные способы создания сеток шестиугольников, их взаимосвязь, а также самые общие алгоритмы. Многие части этой статьи интерактивны: выбор типа сетки изменяет соответствующие схемы, код и тексты. (Прим. пер.: это относится только к оригиналу, советую его изучить. В переводе вся информация оригинала сохранена, но без интерактивности.).
Читать дальше →

Эффективный расчёт области видимости и линии взгляда в играх

Reading time16 min
Reach and readers39K
image

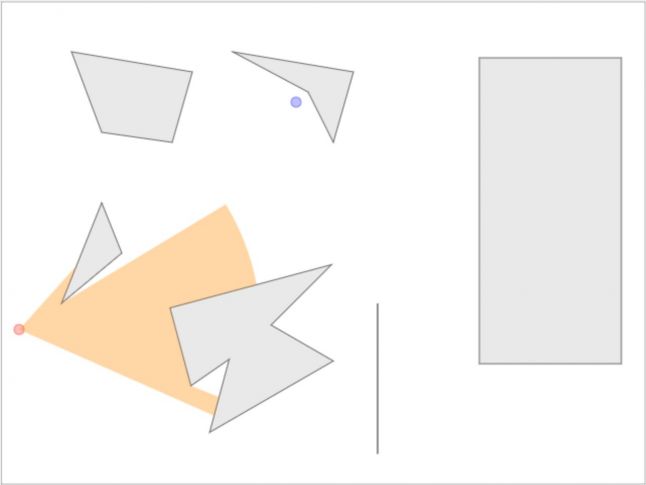
В стратегических играх обычно требуется знать область видимости NPC, чтобы игрок мог продумывать стратегию и делать следующий ход. Мы рассмотрим математику и реализацию рациональной модели, не просаживающей скорость игры при большом количестве NPC на карте. Если вы хотите увидеть готовое интерактивное демо модели, перейдите сюда и играйте прямо в браузере! Вот скриншот демонстрации:

image

Имея параметры видимости наблюдателя (направление взгляда, расстояние видимости и угол поля зрения), нам нужно найти видимую для него область, т.е. определить область видимости (field of view, FoV). Если препятствия отсутствуют, это будет сектор круга, состоящий из двух граней (радиусов) и соединяющей их дуги (см. Рис. 1). Кроме того, имея заданную точку мира, мы должны быстро определить, видима ли она для наблюдателя, т.е. необходимо обрабатывать запросы линии взгляда (line of sight, LOS) для заданной точки. Обе эти операции можно выполнить достаточно эффективно для использования при рендеринге в реальном времени.
Читать дальше →

10 вещей, которые обязательно нужно сделать после регистрации ООО

Reading time9 min
Reach and readers86K

После регистрации общество с ограниченной ответственностью ставят на налоговый учёт, и компания, вместе с правом вести бизнес, получает определённые обязанности. Не все эти обязанности очевидны и известны новичкам в бизнесе. Чтобы не было мучительно жалко в первые же месяцы платить штрафы из своего кармана, советуем учредителям ООО убедиться, что вы знаете, как избежать ненужных потерь.

А для тех, кто зарегистрировался в качестве ИП, мы подготовили: 7 советов начинающему ИП, чтобы избежать проблем (что-то вы точно из этого не знаете)
Читать дальше →

Квантизация изображений

Reading time5 min
Reach and readers26K
Квантизация — уменьшение цветов изображения (wiki). Конечно, сейчас мало кому это необходимо, но задача сама по себе интересная.


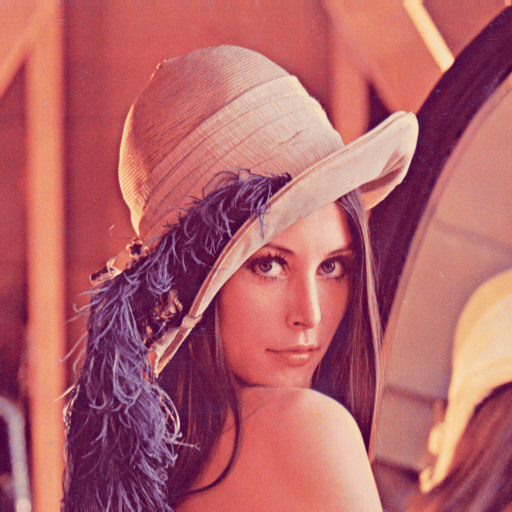
Квантизированная Лена привлекает внимание

Например, старый добрый формат GIF использует палитру, максимум на 256 цветов. Если вы захотите сохранить серию своих селфи как gif-анимацию (кому бы это надо было), то первое, что вам, а точнее программе, которую вы будете для этого использовать, надо будет сделать – создать палитру. Можно использовать статическую палитру, например web-safe colors, алгоритм квантизации получиться очень простым и быстрым, но результат будет «не очень». Можно создать оптимальную палитру на основе цветов изображения, что даст результат наиболее визуально похожий на оригинал.

Алгоритмов создания оптимальной палитры несколько, каждый имеет свои плюсы и минусы. Я не стану утруждать читателя нудной теорией и формулами, во первых мне лень, во вторых большинству это не интересно – статью просто пролистают, рассматривая картинки.

Далее вас ждёт скучное и непонятное повествование о методе медианного сечения, алгоритму рассеивания ошибок (шума квантизации) по Флойду-Стейнбергу (и не только), особенностях цветового восприятия человеческого глаза, а так же немного говнокода.
Читать дальше →

Как решать простые задачи оптимизации на питоне с помощью cvxpy

Reading time3 min
Reach and readers18K
Всем доброго времени суток! Простым поиском я не сумел обнаружить упоминание модуля cvxpy и потому решил написать обучающий материал по нему – просто примеры кода, по которым в дальнейшем новичку будет проще использовать этот модуль для своих задач. cvxpy предназначен для решения задач оптимизации – нахождения минимумов/максимумов функций при определённых ограничениях. Если вам интересна эта тема – прошу под кат.
Читать дальше →

Подводные камни Bash

Reading time32 min
Reach and readers105K


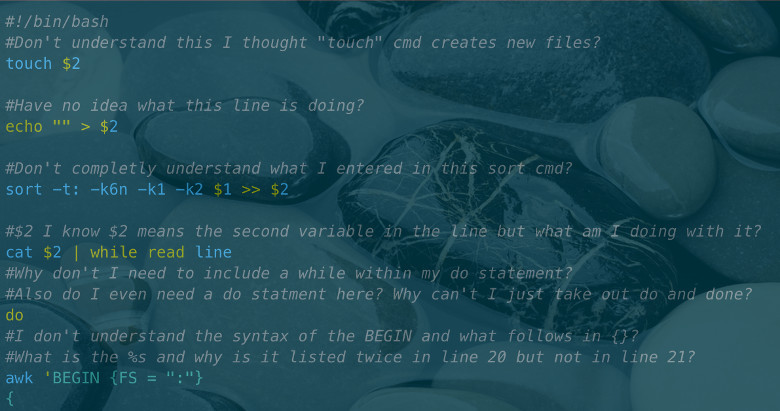
В этой статье мы поговорим об ошибках, совершаемых программистами на Bash. Во всех приведённых примерах есть какие-то изъяны. Вам удастся избежать многих из нижеописанных ошибок, если вы всегда будете использовать кавычки и никогда не будете использовать разбиение на слова (wordsplitting)! Разбиение на слова — это ущербная легаси-практика, унаследованная из оболочки Bourne. Она применяется по умолчанию, если вы не заключаете подстановки (expansions) в кавычки. В общем, подавляющее большинство подводных камней так или иначе связаны с подстановкой без кавычек, что приводит к разбиению на слова и глоббингу (globbing) получившегося результата.


Читать дальше →

Элементы функционального программирования в C++: частичное применение

Reading time8 min
Reach and readers15K

Не буду сильно углубляться в теорию. Что такое частичное применение легко найти в интернете. В том числе на Википедии.


Если кратко, то это механизм, позволяющий зафиксировать k аргументов функции от n аргументов, сделав из неё функцию от (n - k) аргументов.


// Пусть имеется функция f от четырёх аргументов:
int f (int a, int b, int c, int d)
{
    return a + b + c + d;
}

// Фиксируем первые два аргумента:
auto g = part(f, 1, 2); // 1 + 2 + ...

// Добрасываем оставшиеся два:
assert(g(3, 4) == 10); // ... + 3 + 4 = 10

На эту тему уже существует масса публикаций, в том числе и на Хабре:


  1. C++ Variadic templates. Каррирование и частичное применение
  2. Частичное применение и каррирование в C++
  3. Каррируем на C++

А ветка "How should I make function curry?" на stackoverflow — просто кладезь для тех, кто впервые сталкивается с этой темой.


К сожалению, количество пока не переросло в качество, и хорошего, пригодного к использованию варианта я так и не увидел. При этом любопытно вот что.


Замечательный факт №1. В упомянутых статьях присутствуют все техники, которые нужны для реализации правильного (по моему мнению) частичного применения.


Надо только всё внимательно проанализировать и сложить кубики в правильном порядке. Именно этим я и собираюсь заняться в данной статье.

Читать дальше →

42 строки кода для выхода из лимба

Reading time4 min
Reach and readers19K
Вы ведь знаете, как это бывает: большой проект долго проектируется, долго пишется, порой вымучивается и в конце концов сдается. Проходит месяц другой «горячей отладки», и после наступает благоговейная тишина. От заказчика ничего не слышно. И не потому что он разорился благодаря вашим трудам; счета за телефон у него не оплачены, а интернет давно отключен, нет) Просто у него все работает в штатном режиме.

Но в один прекрасный день…
Читать дальше →

Information

Rating
Does not participate
Location
Москва, Москва и Московская обл., Россия
Works in
Date of birth
Registered
Activity