Pull to refresh
-6
Алексей@java3000

Администратор windows умеющий в программирование

Send message

Заметки о реализации hashCode() в Java

Reading time4 min
Reach and readers50K
Часто на собеседованиях приходится спрашивать про функцию hashCode().
Я не буду здесь перечислять все свойства этой функции и ее связь с другой, не менее важной функцией equals(). Данная информация есть во всех учебниках по Java и я не вижу смысла ее здесь повторять. Мне бы хотелось остановиться лишь на одном свойстве: hashCode должен быть равномерно распределен на области значений функции. Я задумался: “А чем гарантировано равномерное распределение?”

Забегая вперед, скажу, что я пришел к довольно интересным выводам. Мне бы хотелось, чтобы меня поправили, если я где-то ошибся в рассуждениях.
Начнём...

Проектирование высокопроизводительных систем: о чем не расскажут в книгах

Reading time5 min
Reach and readers40K


Не секрет, что разработчикам программных систем часто приходится решать проблемы производительности, высокой нагрузки, обработки больших объемов данных и отказоустойчивости. В идеале, все эти вопросы учитываются при проектировании системы. Но на практике их часто пытаются решить запоздалыми «оптимизациями» после запуска.

Почему так происходит? Обеспечение высокой производительности и надежности ошибочно почитается многими за «черную магию». И неспроста — чуть ли не в каждой книге или статье на эту тему вы первым делом наткнетесь на утверждение типа «нельзя просто так взять и повысить производительность».

Читать дальше →

Построение HA систем на базе Jboss AS 6

Reading time3 min
Reach and readers7.6K
Доброго времени суток, уважаемые хабровчане!
Прочитав этот топик, решил написать свой, так как по моему мнению автор не до конца раскрыл потенциал построение HA систем на Jboss(Tomcat), к тому же в статье есть много ошибок (не грамматических).
В этом топике я не буду приводить step-by-step по конфигурации узлов, лишь выборочно, где есть нюансы.
Читать дальше →

Как создать кластер в JBoss AS 7.1 в автономном (standalone) режиме?

Reading time6 min
Reach and readers11K
Статья переведена и опубликована здесь с целью дополнить ее рецептом от себя, добытом на основе личного опыта. Есть надежда, что кто-то сэкономит полдня-день гугления и массу проб и ошибок, с которыми пришлось столкнуться мне. Далее следует вольный перевод и дополнение лично от меня. Основная решаемая задача: репликация сессий пользователей на все узлы кластера. За счет репликации сессий, в случае потери одного из узлов кластера балансировщик прозрачно для пользователя может переключить его на другой узел. Работа балансировщика выходит за рамки данного перевода и будет описана в следующей статье.

JBoss AS 7 кардинально отличается от предыдущих версий JBoss, следовательно, если вы хотите создать кластер в JBoss AS 7, вам следует знать несколько вещей, чтобы не столкнуться с проблемами.
Читать дальше →

Кластер JBoss 7 — балансировка нагрузки с помощью Apache

Reading time9 min
Reach and readers14K
В прошлой статье мы настроили репликацию сессий пользователей на все узлы кластера JBoss. Само по себе такое действие никак не улучшает отказоустойчивость, и для того, чтобы использовать полученную функциональность, требуется балансировщик нагрузки, который будет распределять внешние обращения между узлами кластера. Распределять нагрузку между узлами будет веб-сервер Apache, в соответствии с рекомендациями в документации по JBoss. Вся информация в статье доступна в различных источниках, но она разрознена, и мне не попалось ни одного ресурса, где все было бы собрано в одном месте, с описанием решения проблем, которые могут возникнуть на практике (лично у меня возникли, поэтому делюсь рецептами). Статья не претендует на полноту информации, скорее наоборот — описана минимальная конфигурация. Предназначена как для специалистов, которых интересуют конкретные конфигурации и настройки, так и для людей далеких от данной темы, но которым интересно, что такое кластеризация.
Читать дальше →

Производительность log4j 1.x в синхронном и асинхронном режиме

Reading time7 min
Reach and readers8.7K
Доброго времени суток, хабражители!

На данный момент я занимаюсь улучшением производительности большого корпоративного решения. Его специфика позволяет множеству пользователей выполнять схожие действия, а соответственно за кулисами, сервер приложений работает с одним и тем же кодом. И вот в один из моментов длинного пути ускорения приложения, было замечено что в топе самых низкопроизводительных участков верхние места занимает log4j. Первой мыслью было — излишнее логирование, но последующий анализ ее опроверг. Тем более что это крайне важные данные для инженеров поддержки, и если убрать это сейчас — то либо код вернут обратно либо анализ проблем продакшен сервера будет существенно затруднен.

Это и натолкнуло меня на данное исследование — есть ли способ оптимизировать процесс логирования?

Disclaimer: в силу обилия в данной статье диаграмм вызывающих психоделические ассоциации (вроде этой: это не сравнение синхронного и асинхронного режимов логирования, тут дракон убивает змею!), не рекомендуется к просмотру несовершеннолетним, людям с неустойчивой психикой и беременным женщинам, чей код уже в продакшене а выдача ближайшего патча не в этом году.

Осторожно, под катом трафик.
Я готов узнать детали

Сравниваем производительность reflection в JDK8 и JDK7

Reading time6 min
Reach and readers23K
Привет, Хабр!

Недавно, путешествуя по коду своего рабочего проекта набрел на довольно высоконагруженный spring бин, который производил обращения к методам объектов (иногда и объектов сгенерированных на лету классов) вызывая геттеры и сеттеры объекта через reflection. В бине уже был реализован кэш геттеров, однако я задался вопросом — насколько быстр reflection и можно ли сделать быстрее.


Читать дальше →

PHP + Java, или In-memory кластер теперь и для PHP разработчиков

Reading time9 min
Reach and readers9.2K

Intro


image
PHP + Java. Картинка взята отсюда

В этом комментарии к статье под названием «Пишите код каждый день» я сказал, что скоро покажу свой проект, на который я выделял ежедневно 1 час (кроме выходных). Так как в последнее время моя работа связана с написанием распределенных Java приложений, которые используют in-memory data grid (IMDG) в качестве хранилища данных, то мой проект связан именно с этим.

Подробнее про IMDG можно почитать в моих предыдущих статьях (1, 2). Но если кратко, то это кластерное распределенное хранилище объектов по ключам, которое держит все данные в памяти, за счет чего достигается высокая скорость доступа к данным. Позволяет не только хранить, но и обрабатывать данные, не извлекая их из кластера.
И если интерфейс для обработки данных у каждого конкретного IMDG свой, то интерфейс доступа к данным обычно идентичен хеш-таблице.

О чем эта статья


Большинство IMDG написано на Java и поддерживают API для Java, C++, C#, при этом API для веб языков программирования (Python, Ruby, PHP) не поддерживается, а протокол для написания клиентов сильно ограничен. Именно этот факт я и считаю основным тормозом для проникновения IMDG в массы — отсутствие поддержки самых массовых языков.

Так как производители IMDG пока не предоставляют поддержку веб языков, то веб программисты не имеют возможностей по такому же легкому масштабированию приложений, какие есть у серверных Java разработчиков. Поэтому я решил сделать нечто подобное самостоятельно и выложить в open source, взяв в качестве движка open source IMDG JBoss Infinispan (компания JBoss, принадлежащая Red Hat, довольно хорошо известна в кругу java разработчиков). Мой проект называется Sproot Grid, пока доступен только для PHP, но если у сообщества будет интерес, то сделаю и интеграцию с Ruby и Python.

В этой статье я еще раз расскажу про in-memory data grid и про то, как конфигурировать, запускать и использовать Sproot Grid.
Читать дальше →

Быстрая морфология или файлы против MySQL

Reading time6 min
Reach and readers21K
image
Входе одного проекта мне пришлось создать сверхбыструю русскую морфологию. Около 50.000 слов в секунду на довольно слабом ноутбуке, что всего в 2-3 раза медленнее чем стемминг (обрезка окончаний по правилам), но значительно его точнее. Это данные по обычному диску, на SSD или виртуальном диске поиск происходит значительно быстрее.

Первоначальная версия была на MySQL, но перевод ее на файлы мне удалось добиться стократного увеличения производительности. О том когда и почему файлы быстрее MySQL я и расскажу в статье.

Читать дальше →

Реактивные акторы на java

Reading time17 min
Reach and readers43K
Существует много технологий для организации параллельных вычислений, одна из наиболее перспективных и простых (да-да) — модель акторов. Она позволяет частично избавится от насущных проблем параллелизма, вроде состояния гонки, блокирующих ожиданий окончания операций, бесконечных мьютексов и синхронизаций и многого иного. Так же подобный подход существенно облегчает распараллеливание кода.

Знакомится будем на примере фреймворка akka используя язык java (сам akka написан на scala).
Читать дальше →

Параллельная сортировка методом пузырька на CUDA

Reading time5 min
Reach and readers17K
Привет, Хабр. Подумал, кому-нибудь пригодится параллельная сортировка с относительно простой реализацией и высокой производительностью на платформе CUDA. Таковой является сортировка методом пузырька. Под катом приведено объяснение и код, который может пригодиться (а может и нет… ). Сразу скажу, что представленная прога является бенчмарком по сравнению производительности на GPU и CPU. Если тебе не жалко, читатель, то скомпилируй ее, пожалуйста, и положи результаты расчета в комменты этой статьи. Это не для науки. Просто интересно =)

Читать дальше →

Принтеры штрих кодов в автоматизации торговли

Reading time5 min
Reach and readers41K
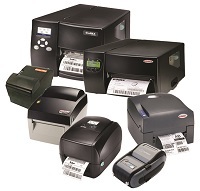
Принтеры штрих кодов и этикеток занимают важное место в процессе автоматизации торгово-складской деятельности. С помощью таких устройств можно организовать процесс этикетирования на малом, крупном или среднем предприятии.

Принтеры различаются по скорости, длине, ширине, разрешению и типу печати, а также поддержке различных интерфейсов, опций и аксессуаров. В этой статье мы расскажем начинающим автоматизаторам о том, какие бывают принтеры этикеток и как эффективнее их использовать, а также, почему стоит выбрать то или иное устройство.
Читать дальше →

Правильная платформа для Java EE приложений: как z/OS + DB2 оказались в 3 раза быстрее Linux + Oracle

Reading time6 min
Reach and readers14K

Введение


В настоящее время все больше и больше корпоративных приложений разрабатываются на основе переносимых кроссплатформенных технологий, таких как Java Enterprise Edition. В состав данной платформы входит набор программных интерфейсов, позволяющих разработчикам абстрагироваться от конкретных СУБД и механизмов очередей сообщений. Это позволяет развернуть приложение практически на любой платформе, в том числе и на мейнфрейме.

В сообществе специалистов по информационным технологиям распространено представление, что мейнфреймы – это очень надежная, но уступающая по производительности привычным решениям на основе процессоров Intel и операционной системе Linux платформа. В данной статье мы хотели бы поделиться результатами тестирования производительности одной и той же банковской платежной системы, работающей на IBM zEnterprise EC12, но в одном случае использующей Linux и СУБД Oracle, а в другом – операционную систему z/OS и СУБД DB2.
Читать дальше →

Лекции Технопарка. 3 семестр. Проектирование высоконагруженных систем

Reading time3 min
Reach and readers75K


И снова в эфире наша постоянная рубрика «Лекции Технопарка». На этот раз предлагаем вам ознакомиться с материалами курса «Проектирование высоконагруженных систем». Цель курса — получение студентами навыков проектирования высокоэффективных программных систем.
Читать дальше →

10 лет «на коленке» и вынужденная эволюция — на заметку молодым

Reading time5 min
Reach and readers15K

Здравствуйте, присаживайтесь


Все мы, здесь собравшиеся, регулярно что-то пробуем, экспериментируем, зачастую в контексте «а дай попробую». На выходе получаем эдакий промежуточный результат в виде чего-то функционирующего, но не пригодного для использования в деле. По крайней мере без доведения до ума, о чем и пойдет речь в статье, в завершении которой речь дойдет до полноценного API и связанные воедино утилит, сопровождающих жизнь автора на более промышленном уровне.

В преддверии 28-летия решил непременно затронуть эту тему с оглядкой уже теперь на 10 лет опыта, вспоминая о всех набитых шишках. Тема удостоена внимания ввиду огромного количества времени, которое мы тратим на свое обучение, результат которого зачастую не используем, а ведь можем!

Делай так, чтобы не краснеть завтра


Однажды, лежащая на полке поделка становится полезной в работе, но когда мы ее делали, не уделили внимание аккуратности, поделка представляет функциональную ценность, но внешний вид не позволяет вынести на публику — вырезая буратино, держите руки чистыми, чтобы не заляпать.
Читать дальше →

Диалоги о Java Performance

Reading time11 min
Reach and readers38K
Каждый год на JPoint эксперты выступают с хардкорными докладами о производительности Java. И ни разу не было скучно — вопрос сохраняет актуальность на протяжении многих лет. О том, откуда растут ноги у мифов, что делает JVM, как измерять производительность, при чём тут бизнес-требования заказчика и как обойти часть граблей мы поговорили с экспертами, для которых Java performance — не проблема, а работа.

Читать дальше →

Эффект кофты на шейдерах для мобильных устройств

Reading time3 min
Reach and readers17K

Пролог


Доброго времени суток! После опубликовании статьи о визуализации квадратичного дерева(Quad-tree), меня попросили написать статью, показывающую работу шейдера, переводящего изображение в «кофту».


Так что, давай рассмотрим данную методику.
Читать дальше →

[Питер] Встреча про OpenOnload: высокопроизводительный сетевой стек для Linux

Reading time1 min
Reach and readers9.1K
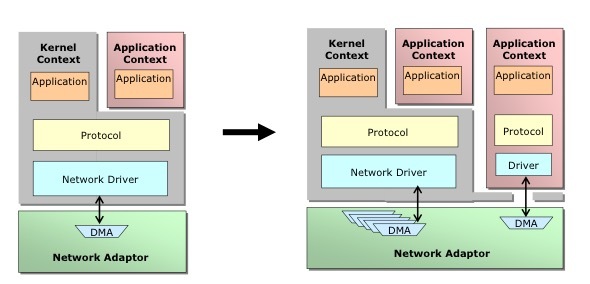
В четверг, 12 мая, в 20:00 в петербургском офисе Одноклассников состоится встреча CodeFreeze с Константином Ушаковым, директором OKTET Labs. Тема встречи — Solarflare OpenOnload, сетевой стек, для Linux, уменьшающий задержки, нагрузку на процессор и увеличивающий скорость передачи пакетов.


Читать дальше →

Принципы и приёмы обработки очередей

Reading time16 min
Reach and readers42K


Принципы и приёмы обработки очередей


Константин Осипов (Mail.ru)


Как вы считаете, какова стоимость очередей с приоритетами? То есть если кто-то лезет вне очереди, то как посчитать стоимость для всей системы в этой ситуации, чему она пропорциональна? Времени обслуживания клиента — например, 5 минут стоит его обслужить? Она пропорциональна количеству ожидающих, потому что время ожидания для каждого из них увеличится.


Для начала о себе — я занимаюсь разработкой СУБД Tarantool в Mail.ru. Этот доклад будет об обработке очередей. У нас много очередей внутри системы, фактически вся база данных построена как система массового обслуживания.


В основном речь будет идти о проблемах балансировки нагрузки, но перед этим я хотел бы поговорить о том, зачем нужны очереди и как они появились именно в компьютерных системах, чего они позволяют добиться.


Призрачная галактика на 99.99% состоит из тёмной материи и почти не содержит звёзд

Reading time2 min
Reach and readers27K

image
Credit: Pieter van Dokkum, Roberto Abraham, Gemini, Sloan Digital Sky Survey


У Млечного Пути нашелся тёмный близнец. Тусклая массивная галактика Dragonfly 44(Стрекоза 44 — прим. переводчика) состоит из тёмной материи на рекордных 99.99% и может помочь переписать наши теории об образования галактик. Dragonfly 44 похожа на Млечный Путь по массе, но отличается по количеству звезд и структуре.


– Если взять Млечный Путь и из каждых 100 звёзд оставить одну, получится примерно то же самое – говорит Питер ван Доккум из Йельского университета. – Придется также взять эти оставшиеся звёзды и перемешать в блендере.
Эта галактика — не спиральная, как Млечный путь, но и не плоский диск.

Читать дальше →

Information

Rating
Does not participate
Location
Москва, Москва и Московская обл., Россия
Date of birth
Registered
Activity

Specialization

Десктоп разработчик, Администратор серверов
Младший
From 110,000 ₽
Java
Java Spring Framework
RESTful WebServices.
PostgreSQL
SQL
Hibernate
Linux
Базы данных
Microsoft SQL Server
Разработка программного обеспечения