Обновить
4K+

PDF

Межплатформенный формат электронных документов

0,53
Рейтинг
Сначала показывать
Порог рейтинга
Уровень сложности
Формат публикации

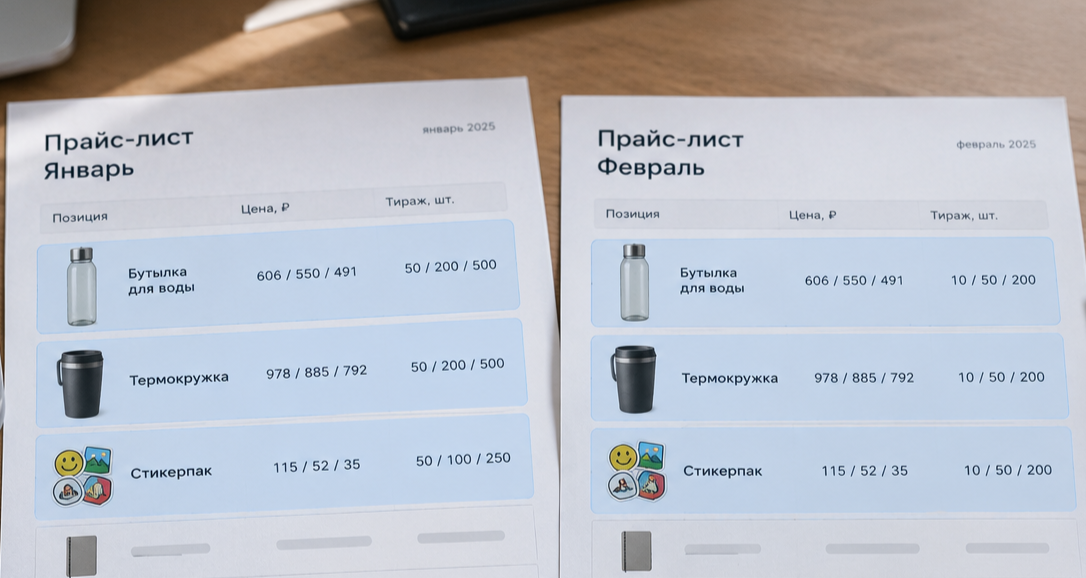
Цена за 50 штук записалась в колонку «200 штук»: разбираю 42 PDF с коммерческими предложениями

Уровень сложностиСредний
Время чтения7 мин
Охват и читатели4.4K

У нас в мастерской за год накопилась папка коммерческих предложений: 42 PDF, 532 страницы, 650 мегабайт. Прайсы, презентации, предложения под конкретных заказчиков. Мне понадобилась из неё одна таблица: позиция, тираж, цена за штуку. Вопрос простой: насколько дешевеет изделие, когда тираж растёт с 10 до 200 штук, и одинаково ли это работает для футболки и для стикеров.

Казалось, что это вечер работы: снять текст, найти числа рядом со словом «шт», сложить. Вышло иначе, и почти все ошибки по дороге были тихими. Скрипт отрабатывал без исключений и выдавал правдоподобные числа, которые не совпадали с тем, что напечатано на странице.

Читать далее

Печатный каталог в HTML — сверстать и не пожалеть

Уровень сложностиПростой
Время чтения10 мин
Охват и читатели6K

Теперь каталог живёт в HTML и CSS: текст, таблицы и схемы лежат в одном проекте и правятся вместе, PDF получается печатью из браузера. CorelDRAW остаётся только на полиграфическую доводку. Насколько это проще, видно по предыдущему каталогу: 35 страниц, текст и таблицы через Word, схемы через Inkscape, макет в CorelDRAW — и каждая правка означала новый экспорт и повторную ручную доводку. Что дал этот странный подход и чем пришлось заплатить.

Читать далее

Как я тестировал российские программы для работы с ПДФ, полжизни проработав в Adobe Acrobat

Уровень сложностиПростой
Время чтения13 мин
Охват и читатели6.2K

Тестировал программы для работы с ПДФ после многих лет в Adobe Acrobat: сравнил российские решения, удобство и возможности.

Читать далее

Dao PDF или Python и автоматизация печати в конструкторском бюро

Уровень сложностиСредний
Время чтения24 мин
Охват и читатели5.4K

Хороший дизайн системы это не про идеальную архитектуру. Это про подходящие именно к твоей ситуации компромиссы и решения. Про путь, который ты должен пройти. Автоматизация обработки PDF решает множество неочевидных задач. А еще при разработке решения может оказаться что в действительности всё не так, как на самом деле.

Let's get started...

Отчёты на DOCX в FARA CRM: шаблоны в Word, редактор в браузере и PDF через LibreOffice

Уровень сложностиСредний
Время чтения7 мин
Охват и читатели10K

Счёт на оплату, договор, акт, отчёт о продажах за месяц — без документов CRM остаётся записной книжкой. В FARA CRM мы закрыли эту задачу отчётами на DOCX. Шаблон — обычный файл Word с тегами Jinja, данные — функция на Python, результат — DOCX или PDF во вложении к записи.

Поверх этого выросли редактор DOCX прямо в браузере, конструктор шаблонов с каталогом полей и превью PDF на живой записи, а также рассылка отчётов по расписанию. PDF по умолчанию собирает LibreOffice в контейнере, а без него работает запасной движок на чистом Python.

Ниже — почему мы выбрали DOCX, как устроены шаблоны и данные, как получаем PDF, какой редактор встроили в браузер и на какие грабли наступили по дороге.

Читать далее

Как сжать PDF без подписок на Adobe

Уровень сложностиПростой
Время чтения3 мин
Охват и читатели6.3K

Как сжать пдф файл на маке?
Чё-то стрёмно в 2026ом скидывать свои файлы на сайты с доменом в .xyz.

А сжатие PDF уже лежит в вашем маке. Бесплатно!

Просто спрятано в утилите «для цветопередачи» — ColorSync Utility.

Читать далее

От Excel‑макроса до RapidTag: как электрик с помощью ИИ собрал инструмент для маркировки проводов

Время чтения6 мин
Охват и читатели10K

История о том, как обычный электрик без профильного IT образования попытался автоматизировать рутинную задачу и в итоге собрал рабочий MVP для работы с PDF файлами.

Читать далее

Один язык документов, несколько форматов: как я отделил layout engine от PDFBox и Apache POI

Уровень сложностиСредний
Время чтения12 мин
Охват и читатели10K

Долгое время GraphCompose выглядел как PDF-движок. Но архитектурно PDF никогда не должен был быть центром системы: разработчик описывает документ на одном языке, движок один раз рассчитывает layout, а подключаемые backend’ы переводят готовую геометрию в нативные объекты нужного формата.

Читать далее

Невидимый слой PDF с инструкциями для ботов

Время чтения3 мин
Охват и читатели20K

Невидимый текстовый слой PDF можно редактировать и экспортировать в Markdown, JSON и TXT. Такие документы называются адаптивными PDF, они созданы для чтения и людьми, и роботами. Люди видят обычный PDF, а роботы — отдельный слой ActualText с текстом в Markdown и картинками в base64.

Читать далее

Защита QR сертификатов без сервера: Ed25519, GitHub Pages и ноль (почти) ежемесячных затрат

Уровень сложностиСредний
Время чтения6 мин
Охват и читатели8K

Хочу рассказать про недавний кейс из своей практики и своих трудовых будней.
Заказчик пришёл с задачей: «Хочу QR-код на сертификатах, чтобы можно было проверить подлинность». У него в голове это выглядело так: он дает мне гугл таблицу с перечнем фамилий, датой, и номером сертификата, скрипт генерирует QR единый для всех сертификатов и как бы этот вопрос закрывается по его мнению. Но при этом должна закрываться самая главная боль - защита от подделки путем переноса QR на другой сертификат. Фактически получалась фикция. С моими возражениями заказчик согласился и я расскажу как мы пришли к криптографическому решению без бэкенда, и покажу конкретный код.

Читать далее

Сжатие PDF-файлов онлайн. Тест 7 сервисов

Уровень сложностиПростой
Время чтения9 мин
Охват и читатели8.7K

Казалось бы, сжатие изображений или PDF-файлов в 2026 году не должно быть каким-то трудным или непонятным. Есть множество онлайн-сервисов, которые сделают это за пару минут. Но при необходимости в частом использовании какого-то сайта, хочется, чтобы процесс был максимально быстрым, удобным и безопасным.

Поэтому я решил проверить несколько аналогичных сайтов, которые позволяют выполнять разные операции с PDF-файлами.

Читать далее

Отказываемся от wkhtmltopdf: как мы искали решение для генерации нетривиальных PDF

Время чтения8 мин
Охват и читатели7.4K

wkhtmltopdf долгое время был одним из основных инструментов для генерации PDF из HTML. Мы столкнулись с ним на собственном проекте, но, когда потребовалось реализовать сложные макеты, колонтитулы и повторяющиеся заголовки в многостраничных документах — возникли проблемы.

В этой статье — краткий обзор альтернатив (Headless Chrome, Puppeteer, Playwright, WeasyPrint, Gotenberg), их плюсы и минусы, а также наш итоговый выбор и подводные камни, которые всплыли в процессе внедрения.

Читать далее

GraphCompose: как я приволок ECS из геймдева и снапшот-тесты из фронта в PDF-генерацию на Java

Уровень сложностиСредний
Время чтения12 мин
Охват и читатели10K

TL;DR

Я сделал библиотеку для генерации PDF на Java, в которой:

Документ описывается семантически (модули, секции, параграфы, таблицы, слои), а не через moveTo/lineTo/showText.

Layout и рендер — это два разных прохода. Геометрия резолвится один раз, потом её рисуют. Поэтому документ можно тестировать до того, как написан хотя бы один байт PDF.

Под капотом — ECS-архитектура в стиле игровых движков: Entity / Component / System. Сущности документа лежат в EntityManager, компоненты прицепляются и снимаются, системы (LayoutSystem, PaginationSystem, RenderingSystem) работают над ними.

Тестирование трёхуровневое: unit → layout-снапшоты (как у Jest для React) → визуальная регрессия по PNG-диффу.

На простом инвойсе библиотека идёт 2.45 мс (iText 5 — 1.57 мс, JasperReports — 4.45 мс). На стресс-тесте: 50 потоков, 5000 документов, 0 ошибок, ~2000 doc/sec.

Это статья про задумку и инженерные решения, которые получились нетривиальными. Если вам интересно, как декларативный UI, ECS и снапшот-тесты влезают в одну библиотеку для PDF — заходите.

Читать далее

Ближайшие события

ИИ для работы с документами: как меняются PDF-редакторы и куда все это движется

Уровень сложностиСредний
Время чтения7 мин
Охват и читатели6.1K

Привет, Хабр! Меня зовут Алена Ивличева, я менеджер продукта в Content AI. Мы делаем ContentReader PDF — редактор PDF, в который теперь встроен ИИ-ассистент. 

Сегодня я хочу поговорить о том, куда движутся технологии, как искусственный интеллект меняет наше привычное взаимодействие с документами и что все это значит для наших продуктов.

На рынке сейчас огромное количество трендов, но я выделю те, что реально меняют правила игры. 

Читать далее

Content AI объединила IDP и RPA в платформе ContentCapture

Время чтения2 мин
Охват и читатели6.8K

Компания Content AI, российский разработчик ИИ-решений для автоматизации бизнес-процессов, выпустила новую версию платформы ContentCapture, в которой объединены интеллектуальная обработка документов (IDP) и роботизация процессов (RPA). 

Раньше для таких задач требовались два отдельных продукта от разных вендоров; интеграция между ними увеличивала стоимость проекта на 30–50%. В новой версии оба инструмента доступны в рамках одного решения и одной лицензии. 

Читать далее

Adobe устранила критический баг в Acrobat Reader

Время чтения2 мин
Охват и читатели5.8K

Компания Adobe выпустила экстренное обновление безопасности для Acrobat Reader, устраняющее уязвимость CVE-2026-34621, которая использовалась в атаках нулевого дня как минимум с декабря.

Читать далее

Как гибрид IDP и VLM экономит миллионы на верификации данных

Уровень сложностиСредний
Время чтения7 мин
Охват и читатели5.7K

Последние 2 года мы в Content AI активно тестируем Vision Language Models (VLM) для обработки документов. Модели вроде Qwen2.5-VL или Gemini 2.5 отлично работают с простыми формами — чеками, типовыми договорами. Но на документах со сложными фонами, многоуровневыми таблицами или нестандартной версткой VLM часто галлюцинирует, теряет строки и путается в реквизитах.

В одной из предыдущих статей мы пришли к выводу, что будущее за комбинированным подходом, когда VLM усиливает IDP-решения.

В этот раз мы проверили гипотезу: пусть VLM не распознает документ с нуля, а проверяет черновик из IDP-системы и исправляет ошибки, опираясь на исходное изображение. Базовым OCR движком выступила наша платформа ContentCapture.

Практическая цель эксперимента — автоматизировать верификацию документов. Сейчас в крупных компаниях сотни операторов вручную сверяют распознанные данные с оригиналами. 

Читать далее

Как я научил ИИ читать советские ГОСТы и сократил подготовку карт контроля с 2 часов до 5 минут

Уровень сложностиПростой
Время чтения4 мин
Охват и читатели12K

Реальный кейс: как LLM заменяет трех технологов на металлургическом заводе - и почему универсальный подход не сработал.

Как я научил ИИ читать советские ГОСТы и сократил подготовку карт контроля
с 2 часов до 5 минут.

Читать далее

Почему PDF в России превратился в проблему для документооборота и ИИ

Время чтения3 мин
Охват и читатели8.9K

После массового перехода на разное отечественное ПО PDF в России из «финального» формата неожиданно стал рабочим. Если раньше документ создавали в одной экосистеме, согласовывали там же, а PDF использовали только для отправки или печати, то теперь всё иначе: у сотрудников и контрагентов разные ОС, разные офисные пакеты и разные PDF-редакторы. В итоге именно PDF часто становится единственным универсальным форматом, который можно открыть у всех.

Проблема в том, что разные программы по-разному читают и сохраняют один и тот же PDF. Для пользователя это выглядит просто: файл открылся, поправился, сохранился. Но внутри PDF — это не привычный документ, а набор команд вроде «нарисуй текст здесь» и «поставь объект в эти координаты». Один редактор дописывает изменения поверх старой структуры, другой полностью пересобирает файл, третий делает смешанный вариант. После нескольких циклов правок один и тот же документ может начать «плыть»: меняется верстка, съезжают таблицы, пропадают фрагменты, ломаются шрифты.

Из-за этого PDF из удобного обменного формата превращается в источник хаоса. Документ выглядит одинаковым не для всех. В одной программе он открывается нормально, в другой — уже с искажениями. Для бизнеса это давно не только техническая неприятность, а реальный операционный риск: договоры, кадровые документы, отчеты и служебные файлы могут терять структуру уже в обычной повседневной работе.

Читать далее

Как помочь вашему RAG адаптироваться? Принимайте DRAG with KNEE! Часть 1

Уровень сложностиСредний
Время чтения14 мин
Охват и читатели7.4K

Все мы проходили через это: скармливаешь RAG‑системе сложный PDF на 50 страниц, а она в ответ либо галлюцинирует, либо вываливает на LLM простыню нерелевантного текста, съедая ваш бюджет на токены быстрее, чем вы успеваете сказать «GPT-4o». Проблема в том, что классический подход со статическим top_k — это костыль, который либо не додает контекста, либо вызывает у модели информационное «ожирение» (заполняет контекст нерелевантным мусором). Нашему RAG нужно помочь адаптироваться к безжалостной среде разрозненных документов!

Я потратил выходные на то, чтобы решить эту проблему фундаментально. В итоге на свет появился DRAG with KNEE (Dynamic RAG with Knee‑point pruning) — алгоритм, который не просто ищет «похожее», а выстраивает иерархию документов и безжалостно отсекает лишнее с помощью геометрического анализа «колена». В этой статье я покажу, как с помощью Qdrant, Python и капли математики сделать ваш RAG адаптивным.

Читать далее?
1
23 ...