Комментарии 70

В этой подписке лимиты или просто поиграться с большими моделями, или нейронки, которые и так бесплатно доступны.

нет, это не так, того же дипсик флеша хватает на долгое кол-во времени
Так я так и написал, собственно - тот же дипсик и бесплатно можно погонять, вот, например (1М контекст):
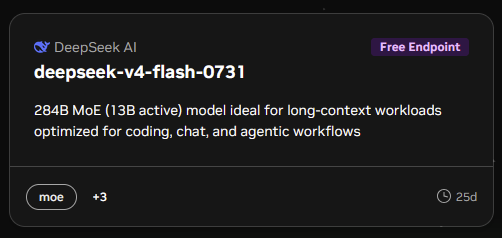

Разница в приватности. Для основных моделей заявлен ZDR. Для Free - запросы используются в обучении.
заявлен ZDR
Но по факту так:: https://habr.com/ru/news/1083926/
Тут, конечно харнесс, но и в нем нигде не говорилось что он все сливает.
Так и хернесс не OpenCode, а сторонний - от z.ai ) В OpenCode есть открытые модели от z.ai, но кто провайдер - мне во всяком случае неизвестно.

У нвидиа неюзабельные модели. Я даже купил номер уже не помню какой страны несколько месяцев назад, чтобы зарегаться, но подключив апи к опенкоду, наткнулся на то, что использовать это абсолютно невозможно. Ошибки появлялись на первой паре ответов модели, запрос уходил, а ответа нет, даже если ждать несколько минут, и т.д.

Привет, тут больше проблема в доступности моделей нвидиа, слишком много пользователей - и конечно у части все крашится, т.к. обеспечить бесперебойность они и не обязуются ( к примеру сейчас популярна там nm lighingt 3.5. nm 3 ultra, kimi 3 - к ним тяжело пробится, кое как к glm 5.3. в этоже время nm 3 super, nm 3 omni всегда свободны)… они ведя обязуются только что не более 40 запросов в минуту предоставлять будут, или ниже если пользователей много + к ним же но с меньшим контекстным окном лезут через openrouter, opencode go и т.п.
Да, я тестировал OpenCode, и флэш работал нормально. Вот pro-постоянно ошибки давала, но когда коннектилась - тоже шустро работала.

и где предлагают эту старую модель по цене free со стабильным api?

Подскажите, это у какого провайдера?

Это где?

Обычно бесплатные модели имеют сильно порезанную скорость, помимо того, что даешь право использовать свои данные для обучения.

"Учёный избил журналиста"
Дакс,буквально сказал что подписка вышла в 0.
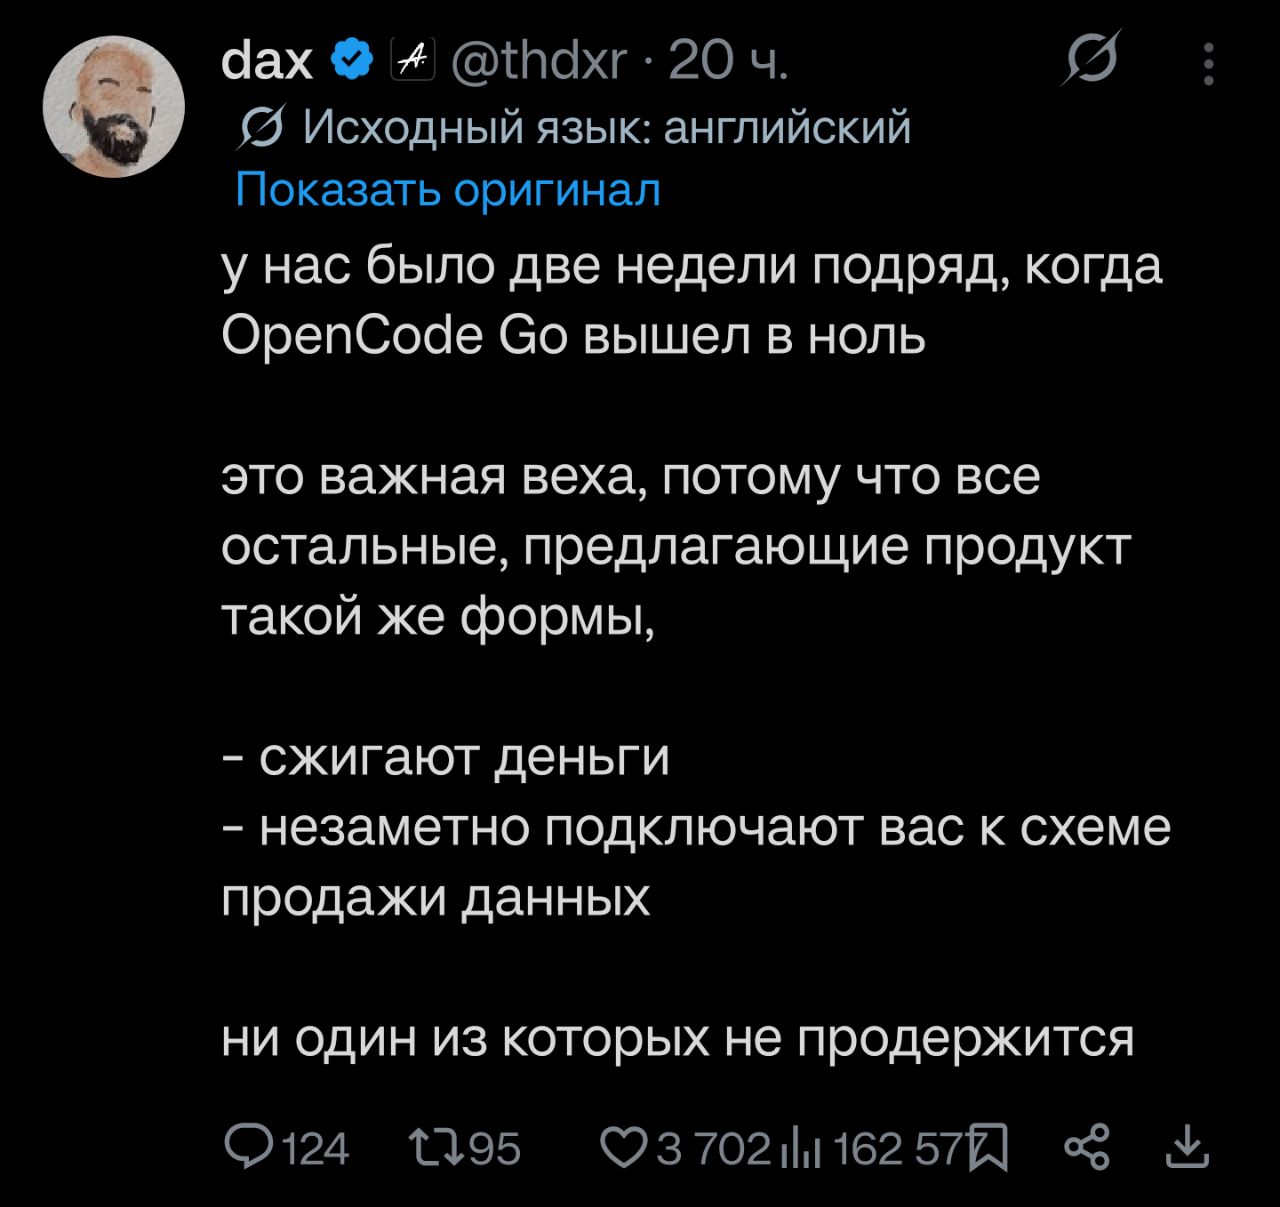
Она не окупается. Она вышла в ноль. И даже так, Дакс сказал,что требуется больше подписчиков на Go,что бы Opencode,могли требовать низких цен на инференс.

Так то выйти в ноль это и есть самоокупаемость... "Окупаемость" != "заработок". "Окупаемость" = "отсутствие финансовых потерь".

Дакс,буквально сказал
«Говорите и вы...» ©

Платишь 10 долларов в месяц и получаешь возможность потратить токенов на 15 долларов у более-менее сильных моделей (или 30 долларов на токены слабых/устаревших моделей). По-моему только выбивающиеся из этого правила акции (вроде glm5.3-flash или DeepSeek 4.1 flash) делают подписку выгодной.
Вообще, целевой лимит в $60 заявляется. Хотя много моделей с лимитом $15 или $30 (самые свежие и интересные).
P.S. Для glm5.3-flash лимит в $60 заявлен, для DeepSeek 4.1 flash - $15 (но с временным бонусом x4). Ради лимита в $15 действительно нет смысла в подписке. А вот glm5.3-flash ($60) или DeepSeek V4 flash ($30) уже дают смысл. Особенно когда подписка за $5 была )

Судя по описанию всё это и так есть в бесплатном cline.
Лимиты бесплатной версии DeepSeek 4.1 flash на всерьёз поиграться вполне достаточны. Непонятно, OpenCode даёт ли что то сверх этого и что именно, например GLM пишет программы неплохо, но так медленно, что имеет смысл запускать штук пять проектов параллельно и не меньше, а это съедает лимит за пару часов (или быстрее).


Но если источники его токенов демпингуют сейчас, а он вышел в ноль, то он просто сыграл на временном арбитраже. Что он будет делать, когда цены его источников поднимутся?

добавлю что opencode go тарифы/цены моделей почти всегда без скидок.
другие сервисы, например опенроутер имеет предложения со скидками на модели.
opencode go обещают суммарно 60$, то есть можно потратить на 4 модели по 15$ из категории тяжёлых/флагманских.
или же в несколько окон пользоваться моделями уровня glm flash, deepseek flash, Qwen Flash и за срок подписки не увидеть лимитов использования.
15$ - суммарный лимит на все модели. Он просто как x4 учитывается в 60$. Т.е. 4 таких лимита не потратить - 1й раз “съест” все что есть.
в таблице использования(в консоле в кабинете) у каждой модели отображается свои уровни использования.
но я не достигал ещё ограничений квот, так что могу ошибаться
Да, там недавно добавили статистику использования и % квоты. Я достигал и 5-часовых и недельных квот - это не особо сложно, особенно если какой-нибудь kimi k3 использовать хоть иногда.
qwen max умнее и дешевле и свежее чем kimi k3.
у меня несколько разных подписок и я использую гибридное использование: у агентов и субагентов разные модели.
Qwen свежее - это да. Но индекс интеллекта у Kimi K3 выше, стоимость выше не сильно, но он менее разговорчив - “цена за задачу” ниже выходит (по данным artificialanalysis.ai).
Пробовал один из прошлых Qwen max - как-то совсем не впечатлило, так что я и не смотрел на свежий Qwen.
P.S. а вот Kimi K3 как раз впечатлил - очень неплохие CodeReview делает. Практически все замечания по делу и хорошо ранжирует важность (а с этим у многих ИИ проблемы - куча замечаний “ни о чем”, но критических).

Kimi на русском гораздо лучше говорит, Qwen в сравнении с 3.6 сделал большой шаг назад в этом плане, зато в бенчмарках прибавил и код лучше пишет.
у qwen с 8 сентября для новых аккаунтов бесплатные квоты.(хватает только на потестить). там же есть Kimi K3 и k2.7 code.
начиная с qwen3.7 max и особенно qwen3.8 max заметно улучшилась для задач кодинга.
модели flash и plus у qwen слабые.

Ну и кто там говорил про ИИ пузырь? Все ещё ждете пока лопнет?)))

А что, есть доказательства обратного? Ни одна из ИИ компаний не является прибыльной и живёт за счёт новых инвесторов до сих пор. Классический МММ.

Ну раз перекуп токенов смог в ноль выйти, то и вся индустрия тоже вышла. По мнению @Jajaba это так работает.
самоокупаемость возможна только у инференса, но главная статья расходов у компаний это разработки новых моделей.
по этому поводу были статьи.
и в этом ключе интересно выглядит заявления об том что прогресс(разработку новых моделей) нужно замедлять.
все компании ускорили выпуски новых моделей, что наверняка плохо сказалось на финансовых показателях.
Разработчики новых моделей в минусе, т.к. участвуют в гонке и все деньги до которых могут дотянуться вкладывают в разработку.
Куча провайдеров, которые крутят открытые модели в облаках и продают токены через ОпенРоутер и другие площадки - они все в плюсе.
И? Объем инвестиций в ИИ уже примерно 2 триллиона долларов, какую часть этого рынка занимают мелкие провайдеры с Дипсиком на арендованных серверах? Полпроцента?
Когда говорят про "пузырь ИИ", имеют ввиду весь тот объем инвестиций, который был вкачан в ОпенАИ, Хаи, Антропики и строительство датацентров под них. Там прибылью или хотя бы самоокупаемостью не пахнет просто в обозримом будущем. Все существование этого безумного пузыря сейчас обеспечивается постоянными новыми инвестициями, без них Антропику нечем будет оплатить электроэнергию в кабинете СЕО.
Ок, давайте посмотрим куда эти два триллиона ушли. Во первых в разработку новых моделей. В строительство новых датацентров. В сверхприбыли производителей памяти - теперь они строят новые заводы. В сверхприбыли производителей полупроводников в целом, которые пошли на разработку новых технологий и строительство новых заводов. В сверхприбыли разработчиков чипов. Сколько десятилетий у нас был безальтернативный Интел, выдавая 5% прироста за великий прорыв? Теперь все кинулись в разработку новых чипов. У эпла прирост производительности между m1 и m5 где-то на порядок.
Китайцы сидящие под санкциями вкладываются в технологии позволяющие удешевить как обучение так и инференс: моделям квен и дипсик надо в несколько раз меньше места на kv кэш, чем западным, нграм позволяющий выгружать часть весов в ОЗУ или на диск без потери производительности и тд.
Лопни завтра пузырь, все это останется. Просто компании набравших больше долгов обанкротятся, их имущество пустят с молотка, рынок полихорадит и гонка моделей притормозится так чтоб новые владельцы не выходили за пределы самоокупаемости. Все. Вот и все будущие последствия лопнутости. Инференс как был дешевым, так дальше и будет дешеветь.
Пруфом мне будет какраз пузырь доткомов, который лопнув оставил после себя R&D, планету опутанную оптоволокном и датацентры. На всем этом выросли новые интернет компании, как было, что интернет компании самые дорогие, так и осталось, только названия компаний сменились.
Ну и кто там говорил про ИИ пузырь? Все ещё ждете пока лопнет?)))
Я ещё с полгода как отдал указание своему брокеру вылезти из всего, связанного с ИИ, и не влезать туда. А как насчёт Вас? Как у нас говорят, why won't you put your money where your mouth is?


Opencode go уже не торт. Имхо козёл от commandcode гораздо выгоднее сейчас, особенно в плане дикпика 4.1

tesla v100 16GB с алика стоит 300$, 32GB 600-700$, кластер на 128GB vRAM ~3500$
при цене подписки 200 долларов в месяц срок окупаемости с учетом ЭЭ и затрат на настройку и обслуживание два года....
За 200 долларов в месяц продают топовые закрытые модели, которые локально не запустить. А в новости речь про подписку за 10 долларов, срок окупаемости можете сами пересчитать.

Это конечно хорошо, а если некоторым нельзя пользоваться облачными моделями, либо предоставлять им обезличенные данные и тогда смысл от них теряется?
Кстати, tesla v100 это буквально худший выбор, даже какая-нибудь 3080, а ещё лучше 3090 будет быстрее нейронку крутить, не просто же так эта тесла так дёшево стоит. Мало того что архитектура устаревшая, так у неё ещё и тензорные ядра первого поколения и поддерживается только точность fp16. Единственный плюс - видеопамяти много и пропускная способность большая.


Если закинуть 200$ на deep seek platform, то можно получить намного больше токенов чем сможет сгенерировать эта машина за 2 года. Когда я начал инференсировать Laguna s2.1 на rx 7900xtx + 13900k@64ram у меня было + 500 рублей в платежку стабильно. Не считая времени на промт инжиниринг.
Так же в локалке нельзя отправить первый запрос на deep seek v4 pro, что бы потом добивать задачу на флеше.
ИМХО локальный инференс хорош, но не для работы

Хаа) ну блин, так то да-поддерживаю)) 200 баксов на дипсик довольно колласальная сумма)

Смотря для какой. Модельки ныне подтянулись. Тот же Qwen3.8 Flash Next можно на 32 гигах видеопамяти (да даже на 24х) запустить... Правда 64гб обычной памяти никто не отменял. И вполне себе приятные 30 токенов в секунду иметь. )

Можно, а зачем? (с)
Контекстное окно в млн токенов она вытянет? Эти локальные квантованные обрезки прикольны для поиграться и початиться. А стоит скормить ей какой-нибудь документ, и она начинает нести галлюцинационный бред, потому что пока читала уже забыла что ты просил с ним сделать.

Контекстное окно в млн токенов
А стоит скормить ей какой-нибудь документ
А что это за документы, которые в текстовом виде требуют миллион токенов на обработку? И что за задачи? Нужно проверять документацию по сдаче завода на соответствие земельному, строительному и еще какому-нибудь кодексу за один промпт?
При чем тут один промпт? Даже относительно простые агентские задачи легко набирают по 200К+ контекста. Локальная модель это не вывезет, она просто забудет свою задачу и что уже делала в процессе. При том, что и качество ее работы будет крайне посредственным, т.к. это однозначно будет сильно заквантованный обрезок. Чатиться - да, в какой-то мере будет работать. Можно хвастаться перед всеми, что запустил локально и гордо показывать количество токенов в секунду. Но при этом молчать что она несёт бред и не способна работать с серьёзными задачами. Это как в анекдоте про секретаршу: "Я умею печатать со скоростью 1000 знаков в минуту!.. Правда, такая х..ня получается 🤷"
Я пробовал запускать локально и qwen, и deepseek в режиме обычного чат-бота с RAG. Результат - хрень, они путают слова, путают языки, забывают инструкции, ломаются на вызовах инструментов. И если запускать такое не для поиграться, а в продакшн - то можно, а зачем? Чтобы что?
относительно простые агентские задачи легко набирают по 200К+ контекста
Контекстное окно в млн токенов она вытянет?
Qwen3.8 (Flash Next, упомянутый выше, а также 27B) позволяет держать контекстное окно в 262144 токена, а через YARN и до миллиона дотянуть можно.
Выше вы упомянули:
А стоит скормить ей какой-нибудь документ, и она начинает нести галлюцинационный бред, потому что пока читала уже забыла что ты просил с ним сделать
В связи с этим и мой вопрос: что это за документ который требует 1 миллиона токенов на контекст (включая размышления)? Если про агентские задачи (например, программирование), то удачное разбиение на подзадачи, использование Graphify и прочих RAG позволяет реализовывать даже сложные задачи, укладываясь в контекст 256k токенов (а иногда даже и всего 200k).
Я пробовал запускать локально и qwen, и deepseek в режиме обычного чат-бота с RAG.
Скажите пожалуйста, о каких именно моделях и квантованиях речь? Я с помощью DeepSeek v4 Flash 0731 (официальные веса) довольно много задач выполнил, связанных с реализацией функционала в объемном проекте на React / TypeScript (речь про программирование). Контекста в 350k зачастую хватало, сжатие контекста (context compaction) редко когда происходило. Перешел на GLM 5.3 Flash 4-битный из-за встроенной поддержки изображений, пришлось контекст до 200k урезать, но с задачами вроде справляется. От работы с Qwen 3.8 Flash Next (в том числе с 4-битным) тоже только положительные впечатления. Предыдущие версии очень капризными становились, когда заставлял их в рамках одного контекстного окна выполнять массив однотипных задач над длинным списком файлов — они все норовили углы срезать. С этим пока что подобного не замечено.
древняя tesla v100 не поддерживает множества современных аппаратных ускорений инференса и может быть интересна наверно только для научных или иных расчётов.
в 128GB vRAM не влезет целиком glm/qwen/deepseek уровня flash последних версий.
да и в цену нужно прибавить остальное железо для создания такого кластера.
то есть конкуренция с моделями по подпискам за ~10$.
для DeepSeek V4 Pro нужен кластер на 900+ GB vRAM. а эта модель кратно уступает возможностям подписок за 100$.
для локального инференса более менее подходят модели под 24/48/64 гб vram.
то есть под одиночные или пары 3090/4090/5090 - для нормальной скорости.
если скорости не критичны то есть варианты на ram.(NVIDIA DGX Spark, Mac Studio Max/Ultra, AMD Strix Halo / Gorgon Halo) - выйдет дешевле и производительней за те же 128GB.

В паре обычные видеокарты игрового сегмента не смогут нормально работать параллельно. Современные материнки не рассчитаны на такую нагрузку, только под тредриперы или серверные камни, и то не все материнки даже серверного уровня потянут карты на 500 ватт каждая. Лучше уж сразу покупать кучу DGX Spark. Он более мобильный и универсальный в применении.

А при чем материнка и 500ватт? Через pci-e питания копейки идут. 75 ватт, вроде
потолок у современных "обычных" материнских плат именно две видеокарты.
есть материнские платы у которых есть поддержка именно двух видеокарт по x8 + x8 PCiE, что более чем достаточно для инференса. почти все эти материнские платы из верхней ценовой категории.
в прошлом году средне-бюджетную плату с x8/x8 под intel ultra 265k брал, как раз в расчёт на поддержку двух rtx 5090.
в средне-бюджетном сегменте таких плат почти нету, в топ сегменте плат тоже не всегда присутствует.
то есть это НЕ про материнские платы рабочих станций или серверов.
rtx 3090 имеют поддержку NVLink 3.0
для объединения видеокарт нужны linux и vllm(или другая оптимизированя для работы с несколькими ускорителями). windows и llama.cpp плохо оптимизированы под объединение нескольких видеокарт под одну модель.
и напомню что речь шла об инференсе. современные x8 PCiE обеспечивают пропускную способность с запасом.
обучение моделей или научные(и близкие к ним точные вычисления) задачи имеют отдельную специфику.

Ребята, а в инфраструктуре opencode есть что-то типа Symphony(от OpenAI), или оно может умеет с ним работать(как Codex)? Чтобы флоу на основе тасок выстраивать?

Плохая новость. Значит использовать стало невыгодно. Будем искать тех, кто все еще субсидирует..

Интересно попробовать, учитывая, что долгое время пользовался относительно бесплатными нейронками. Сейчас для написания текстов и генерации картинок для этих самых текстов пользуюсь Ranvik. Быстро обрабатывает запросы и выдает результаты. Правда, нужно все довольно четко прописывать, но так с любой) А так пробовал и гигачат, и искру, и прочие российские.

Из подписок за 10$ самая выгодная сейчас это Command Code GOAT
Из подписок за 10$ самая выгодная сейчас это
Инфиз засчитан!

Мавроди тоже несколько раз выходил в 0, и даже приличный плюс ))
Зарегистрируйтесь на Хабре, чтобы оставить комментарий
Подписка OpenCode Go вышла на самоокупаемость