Мужик в клетке
В первой моей статье, я довольно скептически прошелся по карточкам Anki. Я говорил, что учат они не тому, что требует жизнь, они учат узнаванию, а нужно употребление. А вчера одна собака в парке заставила меня проектировать свою систему карточек, но получились они другими.
Идем мы вчера с женой по парку и видим посреди парка, мужика в клетке, мы такие, во блин, мужик плохо себя вел и ему за это персональную тюрьму в парке построили, поржали, и идем дальше. Потом дошло, что клетка, это площадка для дрессировки собак, а его собака, просто носилась где‑то в стороне, а мы её заметили только потом.
Я такой, жене говорю, а как собака на португальском, а то что то я забыл, она, блин я тоже. И давай вспоминать, перебирая варианты... В итоге минут через 20 вспомнили и начали перебирать всех остальных животных, которых мы знаем.
А сегодня утром проснулся, вспомнил вчерашнюю историю, и такой, собака — cão, без малейшей заминки. И сразу мысль, вот что мне не хватает на сайте, карточек Anki, которые я ругал.
Знаю, но не успеваю
Собака смешной случай, но именно он дал мне понять, чего нам не хватает для беглого общения, тебе говорят слово, ты точно знаешь, что учил его, и оно у тебя в голове точно есть, но пока вспомнил, собеседник уже сказал пару предложений, суть которых ты потерял, потому что твое внимание было занято вспоминанием знакомого слова. В итоге стоишь и хлопаешь глазами, вроде все знаешь, а суть потерял.
И эта проблема не потому, что не знаешь слово, а потому что знаешь, но медленно. Знание слов учат все, а скорость восприятия не учит никто. И я начал думать, как это лучше сделать. И утреннее cão показало путь по которому мне нужно идти, слово, которое вчера доставалось двадцать минут, сегодня выскочило мгновенно. Значит, скорость доступа к слову тренируется. Вопрос только в одном, как? И я сел копать, что про это думают господа ученые.
Что про это говорит наука
У психолога Роберта Бьорка есть модель, сила памяти, это две характеристики, сила хранения — как глубоко оно лежит, и сила доступа — как легко его можно достать, прям сейчас. И cão у меня лежало глубоко и достать его, было нелегко.
И сильнее всего сила хранения растет тогда, когда ты слово буквально выцарапываешь из памяти, как у меня получилось с собакой. Бьорк называет это желательными трудностями.
В 2006-м Рёдигер и Карпик показали в эксперименте, что попытка вспомнить даёт больше, чем повторное прочтение, хотя сразу после обучения, всё было наоборот. А Пайк и Роусон в 2009-м показали, что чем труднее извлечение, тем дольше слово держится в памяти. Корнелл, Хейс и Бьорк показали, что даже неудачная попытка вспомнить, после которой ты видишь правильный ответ, лучше, чем просто показать ответ.
Из этого получается, что у нас есть два вида восприятия: то, что ты видел в текстах, слышал в сериалах, но просто узнавал — это не влияет на скорость извлечения. И есть второе: то, что ты вытаскиваешь, когда пытаешься построить предложения. Значит нужно брать слова, которые ты давно не вытягивал из памяти и заставлять мозг их вытаскивать. Все просто.
Как часто повторять
Сепеда и коллеги, 2008 провели исследования влияния интервалов повторения на память. Больше 1350 человек учили факты. Потом повторяли их через разный промежуток времени, максимум 3,5 месяца, после чего, проходили финальный тест, через срок до года. И у них получилось, что короткий срок вредит сильнее чем длинный, 20–40% срока для недели, 5–10% для года.
Карпик и Бауэрншмидт в 2011-м сравнили растущие, равные и сужающиеся интервалы. Разнесенность повторений дала около 200% прироста в долгосрочную память, против повторов подряд. А преимущества какой либо схемы не нашлось, получается, что нужно просто не повторять подряд.
Почему одни слова быстрые, а другие нет
Эффект частотности, это один из самых старых результатов психолингвистики, частотные слова, обрабатываются быстрее, чем редкие. То есть, чем чаще будем давать слова, тем быстрее будем их обрабатывать. Берем то, что используем редко и заставляем мозг использовать часто. Тоже все просто.
А Норман Сегаловиц изучал автоматизацию лексического доступа во втором языке и выяснил, что время реакции продолжает падать, ещё долго после того, как точность дошла до предела. То есть знакомые слова, можно разгонять дальше и таким образом увеличивать беглость языка.
Где наука молчит
Я планирую делать систему увеличения скорости обработки слов, а все работы, которые я нашел, меряли бинарное, вспомнил или нет, поэтому главный вопрос, как часто нужно повторять и как при этом растет скорость я не нашел, поэтому буду делать свой эксперимент, и на своих данных это выяснять. Алгоритм ниже.
Почему не просто Anki
Логичный вопрос: так поставь Anki и не изобретай. Интервалы там есть, алгоритм FSRS замечательный, зачем городить велосипед. Но претензий к Anki у меня стало еще больше, чем было, когда писал первую статью.
Первая главная осталась без изменений, что мы тренируем узнаваемость, а не извлечение, и после всего того, что узнал выше и после случая с собакой, она стала только сильнее. Карточки Anki это тренировка новых собак в клетке, которые потом не можешь применять. Далее Anki не знает, что ты видишь в жизни. Он одинаково гоняет и частотные слова, и слово, которое попадается раз в месяц, а нужно как раз наоборот. Ну и естественно то, что я писал в первой статье: карточка это, португальское слово — русский перевод, тренирует, связь ярлыка с ярлыком а не смысл со смыслом. И к тому в живом разговоре нужен звук и ответ голосом а не текст. Поэтому система у меня будет в корне отличаться.
Карточка, которая звучит
В итоге я остановился на таком алгоритме моих карточек: главное отличие от Anki, откуда берутся слова и в каком порядке. Система знает все мои слова, насколько хорошо я его знаю, сколько раз повторял, частотность в моем контенте. Там где контент сам справляется, частотные слова выпадают из очереди сами, если слово залежалось без употребление, само попадет в карточку. А наверх всплывает слова, которые ты знаешь, но редко употребляешь, и всякий раз мимоходом. Именно на них ты и стоишь в разговоре с открытым ртом. Встреча в фильме, сдвигает таймер слова чуть‑чуть, но не обнуляет, это узнавание, а не вспоминание. А первая карточка по каждому слову, по сути не тренировка, а замер. По времени реакции на слово определяем на сколько оно глубоко лежит в памяти и вычисляем интервал.
Главное не текст а голос, берем фразу из своего контента, фильмы, просто уроки, блогеры то, где ты когда ни будь слышал эту фразу, вырезаем оттуда слово и пару слов по бокам, послушал, попытался вспомнить, перевернул. Все это время таймер тикает. На обороте не перевод слова, а фраза из твоего же контента, где оно встречалось, и ее перевод, причем перевод мелким шрифтом, что бы проще было читать фразу и вспоминать фразу. Слово связываем со смыслом а не с русским ярлыком. Каждый раз берем фразу из разных мест, если она встречалась несколько раз. Если слово попадалось в десяти местах, по очереди придут 10 разных фраз с разными голосами озвучки.
В обе стороны
Я гонял первые карточки и в какой‑то момент осознал, что сделал не то, что изначально собирался. В парке с собакой, было то наоборот, мы ведь не слово на слух не поняли, мы его сказать не могли. А я сделал систему, которая тренирует обратное: услышал — понял. То есть нужно делать два вида карточек, прямой и обратный перевод. Понимание и говорение разгоняются отдельно, и каждому направлению свой интервал.
Сколько ждать после провала
Я как то всегда думал что, если повторяешь раньше времени, хуже не будет, но как оказалось по Сепеде, это худший вариант. Чем тяжелее вытягиваем тем лучше. В моём случае новых слов в этих карточках нет, все уже прошло через диктовку и лежит в моих текстах. Слово которое долго не употреблялось, это слово с просевшим доступом, а такое по Бьорку переучивается быстро. Поэтому после провала оно возвращается минимум через день. Передержать дешевле, чем недодержать.
Как считается интервал
Новых формул для интервалов я не изобретаю, просто меняю метрику успеха. Классические методы, считают вероятность вспомнить слова. Я считаю, вероятность вспомнить его быстро. Цель, порог который успевает за живой речью. Ответил долго, интервал не растёт, быстро, увеличиваем.
У каждой карточки одно число, устойчивость S, которую пересчитываем после каждого показа. Вероятность быстро вспомнить слово падает с каждым днём после того, как ты его в последний раз вытащил, и карточка приходит, когда эта вероятность опускается до целевой, скажем 0,85. Чем ближе к порогу тем рост меньше, за порогом интервал не меняется. Нажал не знаю интервал режим вдвое, но не чаще чем сутки.
В формуле четыре параметра. q — скорость ответа от 0 до 1, на уровне быстрых — около единицы, на пороге — около нуля. a — как сильно растёт S при лучшем ответе. b — насколько больше награда за слово, которое почти ушло. c — какая доля S остаётся после ошибки.
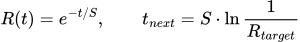
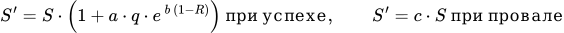
Подстраиваем под человека
Порог скорости считаем подстраиваем под каждого человека, кто то быстрый кто то медленный, берм самые частотные слова и из них пересчитываем коэффициент. Так же и с коэффициентами a, b, c — подбираем так, что бы лучше всего предсказывать реальные ответы, реального человека, аналогично как оптимизируют FSRS, только на секундомере.
Чего я пока не знаю
Пока я не знаю, как именно интервал должен зависеть от скорости. Наука тут молчит, так что для начала, коэффициенты беру на глаз, а дальше посмотрим, по прогрессу. Но субъективное ощущение от работы системы, могу сказать уже сей час (я тестирую карточки где то 2 недели). Я на верном пути.
Вопрос в зал
У вас бывает, что слово вроде знаешь, но пока вспоминаешь, разговор ушёл?
И если вы сидите на Anki или другой SRS: замечали, что карточка для вас легко, а в живой речи тяжело?