
Хабр Курсы для бэкендеров
РЕКЛАМА
Большая витрина: от крупнейших школ до частных авторов. Сравнивайте по цене, длительности, формату и выбирайте самый подходящий курс!

Спасибо за сравнение! Делаем открытый ботанический проект: бирки Data Matrix 10×10, модуль 1,2 мм, читаем телефоном в живом видео, в кадре сразу несколько кодов. По возможности поделитесь опытом:
С какими настройками zxing-cpp (tryRotate, tryDownscale, binarizer, isPure) получены 70%?
Открыт ли генератор синтетических кадров? Хотим прогнать свои 10×10.
Рассматривали ли кейсы, когда кодов в кадре 5–20, как библиотеки ведут себя в таких условиях?
Не сравнивали ли с Google ML Kit?

Спасибо за интерес!
Мерили Python обёртку zxing-cpp 3.1.1 вызов read_barcodes: formats=DataMatrix, try_rotate=True, try_invert=True, try_downscale=True, text_mode=Plain
binarizer — по умолчанию (LocalAverage), is_pure — по умолчанию (False)
Один поток, кадр уже в памяти в виде серого массива, считается время только самого вызова.
Генератор открыт. Ссылка на гитхаб есть в статье (https://github.com/libscanner/datamatrix-benchmark). В репо есть:
- synthetic/make_frames.py набор осей и значений (список AXES);
- synthetic/render_limits.py рисование: этикетка, свет, перспектива, изгиб, мятая бумага, пакет, повреждения;
- все кадры и expected.csv.
Символы для кадров делает наш генератор dmgen (pip install libscanner-dmgen). Размеры заданы в render_limits.py: SIZES = (16, 22, 40). 10×10 в таблице уже есть, так что для своих бирок хватит поставить SIZES = (10,). Если dmgen не нужен, замените Symbols.make на любой свой энкодер. Он должен вернуть картинку символа 8 пикселей на модуль (SRC_PX) с тихой зоной 2 модуля (QUIET) и строку данных. Подойдёт и энкодер самого zxing-cpp.
c Google ML Kit не сравнивали. ML Kit работает только внутри приложения под Android или iOS
по 3 пункту проведу сравнение с zxing-cpp. выложу чуть позже итог
Под ваш вопрос сняли отдельный опыт, от 5 до 2000 кодов на кадре.
Условия:
- символы 10×10, у каждого 6 случайных цифр, нарисованы энкодером zxing-cpp (а не нашим);
- каждый повёрнут на случайный угол, ровная бирка без перспективы;
- размытие 0,6 px, шум 3;
- 3 кадра на точку;
- кадр 1920×1080 для 5–300 кодов, 3840×2160 (4K) для 500–2000.
zxing-cpp с настройками из п. 1; dmr — в режиме «все коды» (Settings::multi). Замер на ноутбуке с процом intel i5 1335U.
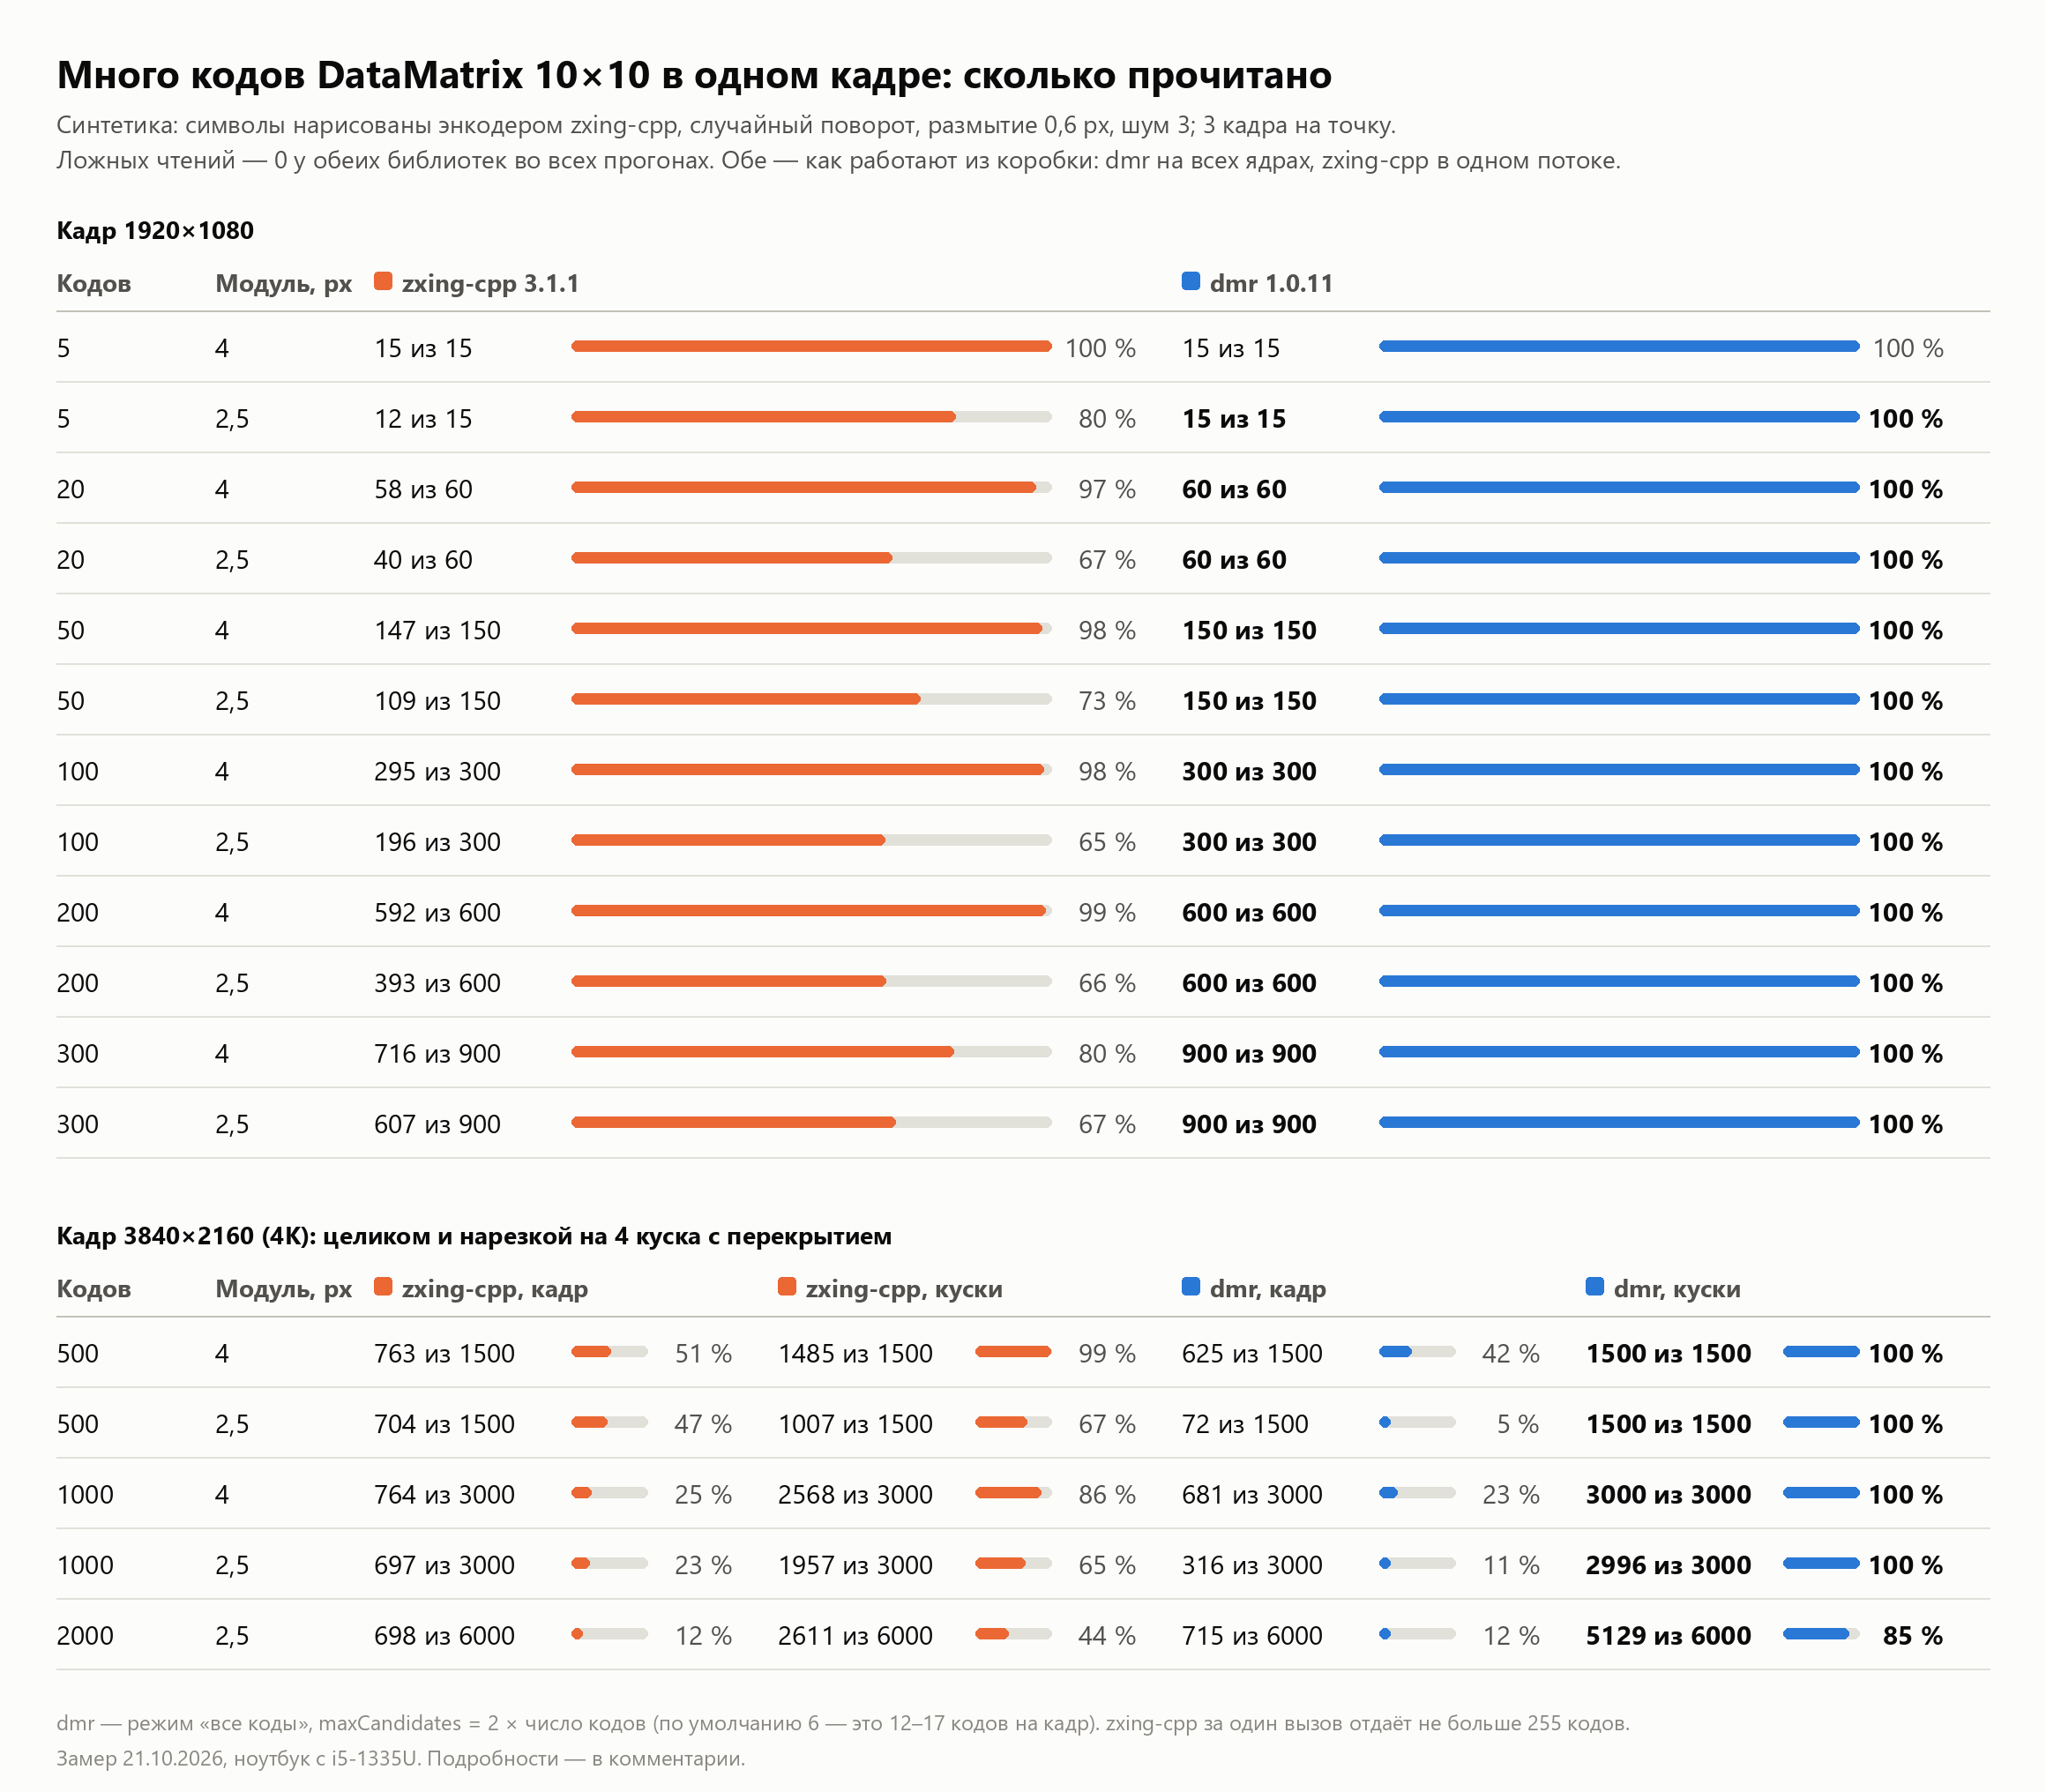
Ложных чтений не было ни в одном прогоне. У dmr в таблице maxCandidates поднято под число кодов. 4K-кадр нарезан на 4 куска с перекрытием 80 px, повторы на стыках сняты по тексту.
Что из этого следует:
- dmr, настроенный под число кодов, прочитал на 1080p каждый символ: 900 из 900 при 300 кодах на кадре, в том числе на мелком модуле в 2,5 пикселя. zxing-cpp на тех же кадрах — 716 из 900 при 4 px/модуль и 607 из 900 при 2,5.
- Мелкий модуль — главное слабое место zxing-cpp. При 2,5 px/модуль он теряет треть кодов уже на 20 кодах в кадре (40 из 60) и почти половину на 200 (393 из 600). dmr на тех же кадрах — 60 из 60 и 600 из 600.
- У zxing-cpp жёсткий потолок: за один вызов он отдаёт не больше 255 кодов. На 4K-кадрах с 500–2000 кодами выдача ровно 254–255, остальное теряется молча. В Python-обёртке 3.1.1 параметра для этого предела не нашел. У dmr такого потолка нет.
- На нарезанном 4K dmr прочитал 1500 из 1500 и 3000 из 3000 (500 и 1000 кодов), zxing-cpp — 1485 и 2568. На 2000 кодах при 2,5 px/модуль dmr прочитал вдвое больше: 5129 против 2611.
- Нарезку 4K на куски по 2 Мп я бы советовал для любого ридера.
- По умолчанию dmr в режиме «все коды» берёт 6 кандидатов детектора (плюс повторный проход) это рассчитано на этикетку с несколькими кодами. Для сотен кодов maxCandidates параметр надо поднять, иначе он прочитает 12–17 кодов на кадр.
- Цена полноты — время. Когда dmr ищет все коды до последнего, это секунды на кадр, и здесь помогает то, что он из коробки использует все ядра процессора: на многоядерной машине или сервере кадр разбирается быстрее, без какой-либо обвязки.
- Синтетика ровная. В живом видео добавится смаз от движения — в статье это отдельная ось, там видно, где кто сдаётся.
Про сам размер 10×10. В нём всего 3 кодовых слова данных (до 6 цифр) и 5 слов коррекции, это очень слабый символ DataMatrix. Если шесть цифр заполняют его целиком, исправить удаётся одно-два испорченных слова. Осторожный ридер (наш, например) без запаса проверки примет только одно иначе на маленьком символе растёт риск ложного чтения. Если бирки ещё не напечатаны и место позволяет 12×12 даёт 5 слов данных и 7 коррекции. Если номера короче шести цифр, у 10×10 остаётся дополнение, и коррекция работает в полную силу.
Алексей, огромное спасибо! Не ожидали, что вы прогоните отдельный тест под наш случай. Это очень ценно.
Что берём себе:
Ваши настройки zxing-cpp ставим как базовые: и на сервере, и в запасном декодере приложения.
Ваше замечание о слабой коррекции ошибок у 10×10 очень к месту. Мы выбрали 10×10 ради минимального размера бирки, но 12×12 с модулем 1,0 мм занимает ту жеплощадь. Сравним оба варианта на вашем генераторе.
Спасибо за находку про потолок ~254 кодов за вызов в zxing-cpp. Для больших групповых фото учтём и будем резать кадр на тайлы.
dmr по вашим цифрам выглядит очень сильно, мы бы с удовольствием его рассмотрели. Но проект у нас полностью открытый, так что держимся открытых декодеров.
Читаем DataMatrix с конвейера: открытое сравнение четырёх библиотек на 1368 синтетических кадрах