Это вторая часть рассказа о том, как я выиграл Кубок СЭРПАС 2026, соревнование по оптимизации программ под российские процессоры Эльбрус. В первой части я рассказывал, чем Эльбрус отличается от привычных процессоров, как мерил скорость и как решал первую задачу, а здесь речь пойдёт про задачи 2 и 3. Финал будет в третьей части.
Коротко напомню главное для тех, кто начал читать с этой части. На Эльбрусе параллельность заранее расписывает компилятор, а не сам процессор на ходу, поэтому выигрывает ровный, регулярный код с большим количеством независимой работы. Оценивались и время, и память, а все цифры ниже, как и в прошлый раз, это медианы прогонов на тестирующих машинах. Полные условия задач лежат в PDF, а исходники моих решений на GitFlic.
Оглавление
Задача 2: свёртки сигналов
Что спрашивали
Свёртку проще всего объяснить через эхо. Если хлопнуть в ладоши в комнате, пойдёт затухающий отклик, а если хлопать много раз и с разной силой, микрофон в каждый момент будет слышать сумму всех этих откликов. Это и есть свёртка, и встречается она буквально везде: в фильтрах звука, размытии картинок, обработке сигналов с датчиков.
В задаче  каналов, у каждого свой сигнал
 и своя импульсная характеристика
 длины
 (степень двойки), и нужно точно, в целых числах, посчитать сумму циклических свёрток:
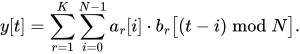
Самые тяжёлые тесты были с  при
 и
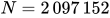 при
 , коэффициенты от −7 до 7, а лимит памяти жёсткий, всего 128 МБ. Если считать в лоб, это
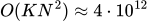 операций, так что без быстрого алгоритма тут делать нечего.
Почему NTT, а не FFT
Свёртка по сути то же самое, что умножение многочленов, а многочлены быстро умножаются через быстрое преобразование Фурье за 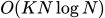 : переводишь их в значения в особых точках, перемножаешь поточечно и переводишь обратно.
Только обычный FFT считает в double, и в конце вместо целого числа получается что-нибудь с кучей девяток после запятой. Скорее всего, округлится оно правильно, но «скорее всего» меня не устраивало, потому что одной неверной цифры хватит, чтобы всё решение не прошло. Поэтому я взял NTT: это тот же алгоритм, только в остатках по модулю простого числа
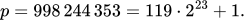
Там всё целое и точное, а корни из единицы нужных степеней существуют для всех из задачи. Ответ при этом получается по модулю, и из него ещё нужно восстановить знак. К счастью, максимальный модуль ответа можно оценить заранее: 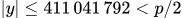 . Значит, если остаток меньше
 , ответ положительный, а если больше, отрицательный, и никакой путаницы не возникает. Одного модуля хватило, так что китайская теорема об остатках не понадобилась.
Что ещё срезал
Сам по себе NTT ещё не всё, дальше началась уже привычная работа по выкидыванию лишнего:
Один обратный NTT на всех. Преобразование Фурье линейно, поэтому произведения всех каналов можно накапливать в одном спектре
 и переводить обратно только сумму.
Одинаковые отклики. Условие намекало, что характеристики каналов могут совпадать, а тогда
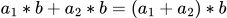 : сигналы складываются ещё до преобразования, и вместо двух свёрток считается одна.
Постоянные отклики. Если все значения
 одинаковые, свёртка вырождается в
 во всех точках, и NTT не нужен вовсе.
Без деления. Внутри преобразования очень много операций «взять остаток», а деление медленное. Поэтому для заранее известных корней из единицы я использовал умножение Шоупа, для произведения двух спектров Монтгомери, плюс ленивую редукцию в диапазоне
 . В горячем коде не осталось ни одного деления.
Под VLIW. Бабочки radix-4 делают две стадии за один проход по памяти и развёрнуты на четыре независимых индекса, а последние три стадии считаются на восьми значениях прямо в регистрах.
Память
Числа от −7 до 7 помещаются в четыре бита, так что я хранил их по два в байте. Потом заметил, что после первых двух стадий большое преобразование разваливается на четыре независимые четверти, и их можно считать по очереди. Все временные массивы от этого стали в четыре раза меньше, а распаковку из 4-битного формата я совместил с первыми стадиями, так что полный массив длины вообще нигде не появляется. Большие буферы выделялись через mmap/munmap, чтобы страницы действительно возвращались системе. В итоге память ушла с 53 до 34 МБ.
Чтение оказалось самым медленным
Когда математика стала быстрой, я посмотрел профиль и, честно говоря, удивился: из 826 мс целых 365 уходило просто на чтение чисел из текста. Пришлось делать параллельный разбор. Главный поток читает stdin большими блоками, остальные парсят свои куски, причём границы кусков сдвигаются до ближайшего пробела, чтобы не разрезать число пополам, а префиксная сумма раскладывает результат по местам без гонок. Вывод тоже сделан параллельным, через таблицу трёхзначных групп цифр. Вообще эта история повторялась во всех задачах: стоит ускорить основное, как начинают тормозить ввод, вывод и память.
Версия | Время | Память |
|---|---|---|
v1 | ~1042 мс | 53,2 МБ |
v4 | ~987 мс | 33,7 МБ |
v5 | 826 мс | 33,8 МБ |
v6 | 551,5 мс | 35,3 МБ |
Последняя строка взята уже из итоговой таблицы соревнования. Параллельные ввод и вывод сэкономили около 275 мс, а их буферы добавили полтора мегабайта памяти. Итого с 1042 до 551,5 мс, почти вдвое, и с 53 до 35 МБ памяти, а итоговое решение целиком лежит на GitFlic в файле task2.c.
Задача 3: карта и пункты выдачи
Что спрашивали
Из всех трёх отборочных задач эта понравилась мне больше всего. Город в клеточку, в некоторых клетках стоят пункты выдачи, и для каждой клетки нужен квадрат расстояния до ближайшего пункта. На выход при этом требуется только сводка: общая сумма, максимум, сколько клеток с максимумом и первая из них, а ещё суммы по каждой строке и каждому столбцу. Главная карта размером 7680×10240, это 78,6 млн клеток, а пунктов на ней 73 000.
Параболы
Классический алгоритм (Felzenszwalb–Huttenlocher) раскладывает расстояние на вертикальную и горизонтальную части и решает задачу по одной строке за раз. В строке каждый столбец  , в котором есть пункты, даёт параболу
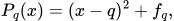
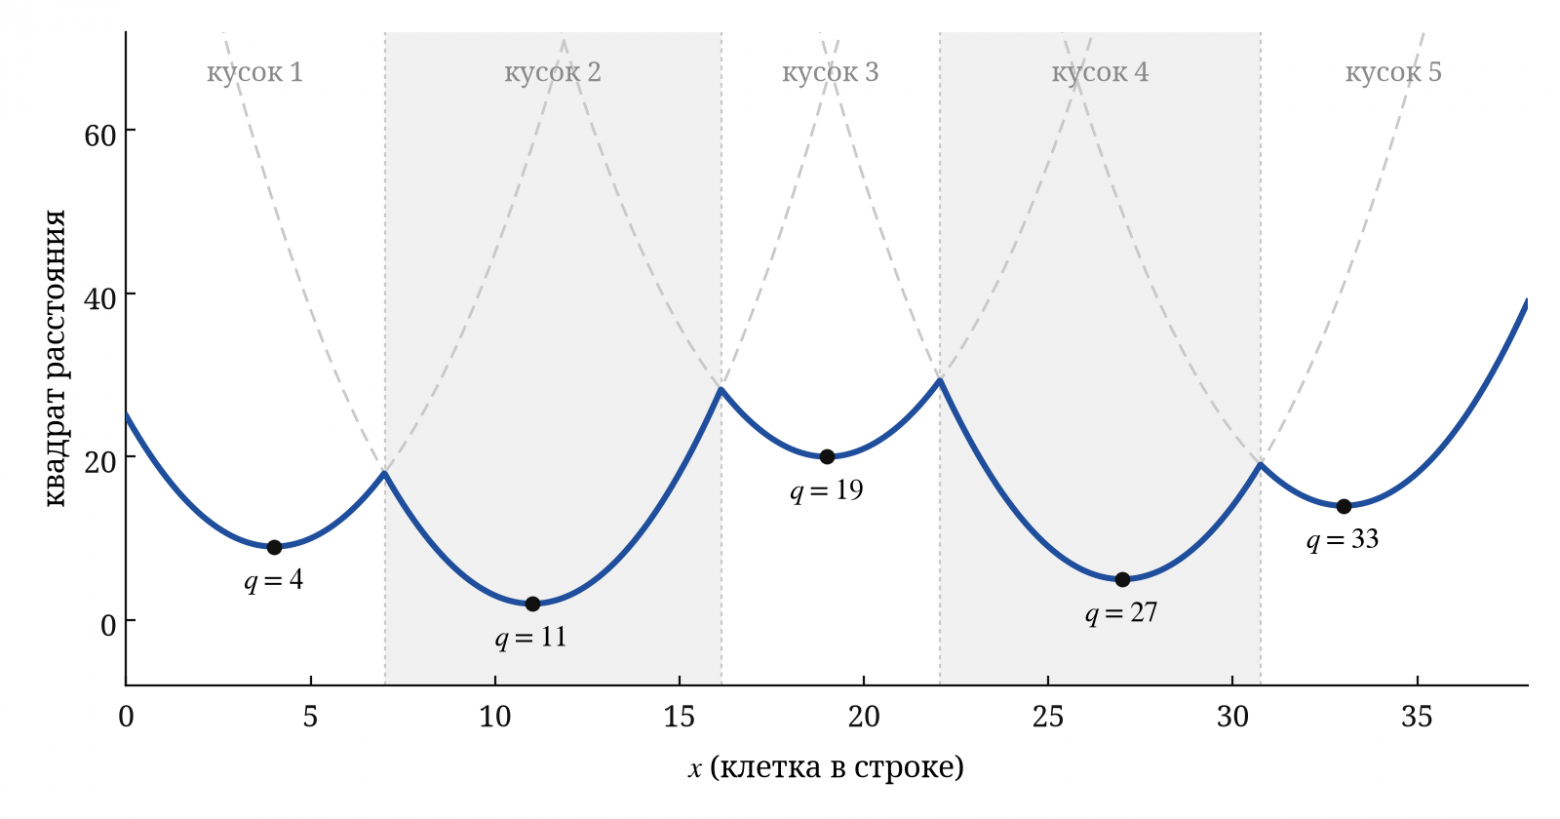
где  — квадрат вертикального расстояния до ближайшего пункта в этом столбце. Ответ в каждой точке определяется самой нижней из парабол. У нижней огибающей есть приятное свойство: каждая парабола выигрывает на одном сплошном куске, поэтому вся строка описывается коротким списком кусков и строится за один проход со стеком.
Карту можно не строить
Обычно дальше заполняют всю карту расстояний, а потом её суммируют. Мне же не хотелось держать в памяти 78 миллионов чисел только ради того, чтобы их сложить, и тут я заметил, что на каждом куске  огибающей расстояние оказывается обычным квадратным многочленом
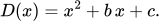
А значит:
сумма по куску считается формулой
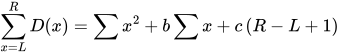 , где суммы
 и
 берутся из префиксных массивов;
максимум выпуклой параболы на отрезке всегда находится на краю, так что достаточно проверить
 и
 ;
суммы по столбцам получаются красивее всего. Если сложить многочлены всех строк для столбца
 , у них просто складываются коэффициенты, поэтому и
 копятся в разностных массивах на отрезке куска, а в конце
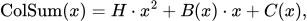
потому что коэффициент при  у каждой из
 строк равен единице. Получается по две записи на кусок и никакого второго прохода.
Выходит, что клеток 78 миллионов, а ни в одну из них я по-настоящему так и не зашёл. Уже первая версия работала так и укладывалась в единицы мегабайт памяти при лимите 350, правда, считала она 444 мс, потому что для каждой строки всё ещё перебирала все пункты.
Точное отсечение
Большинство пунктов, очевидно, ни при чём: пункт на другом конце города никогда не окажется ближайшим. Но отсекать их нужно так, чтобы это никогда не ошибалось, то есть без всяких эвристик.
Логика тут простая. Карта режется на полосы по 32 строки, а каждая полоса на прямоугольные участки по 64 столбца. Если я знаю, что из любой точки участка до какого-то пункта не больше  , то все пункты, до которых даже от ближайшей точки участка больше , можно смело выкинуть, потому что они всегда проиграют. Одна эта идея дала 444 → 187 мс.
Вороной
А дальше идёт то, чем я, наверное, горжусь больше всего во всём соревновании. Есть ячейки Вороного: для каждого пункта это все точки, для которых он ближайший, то есть его «район». Ячейки эти выпуклые и всегда содержат сам пункт.
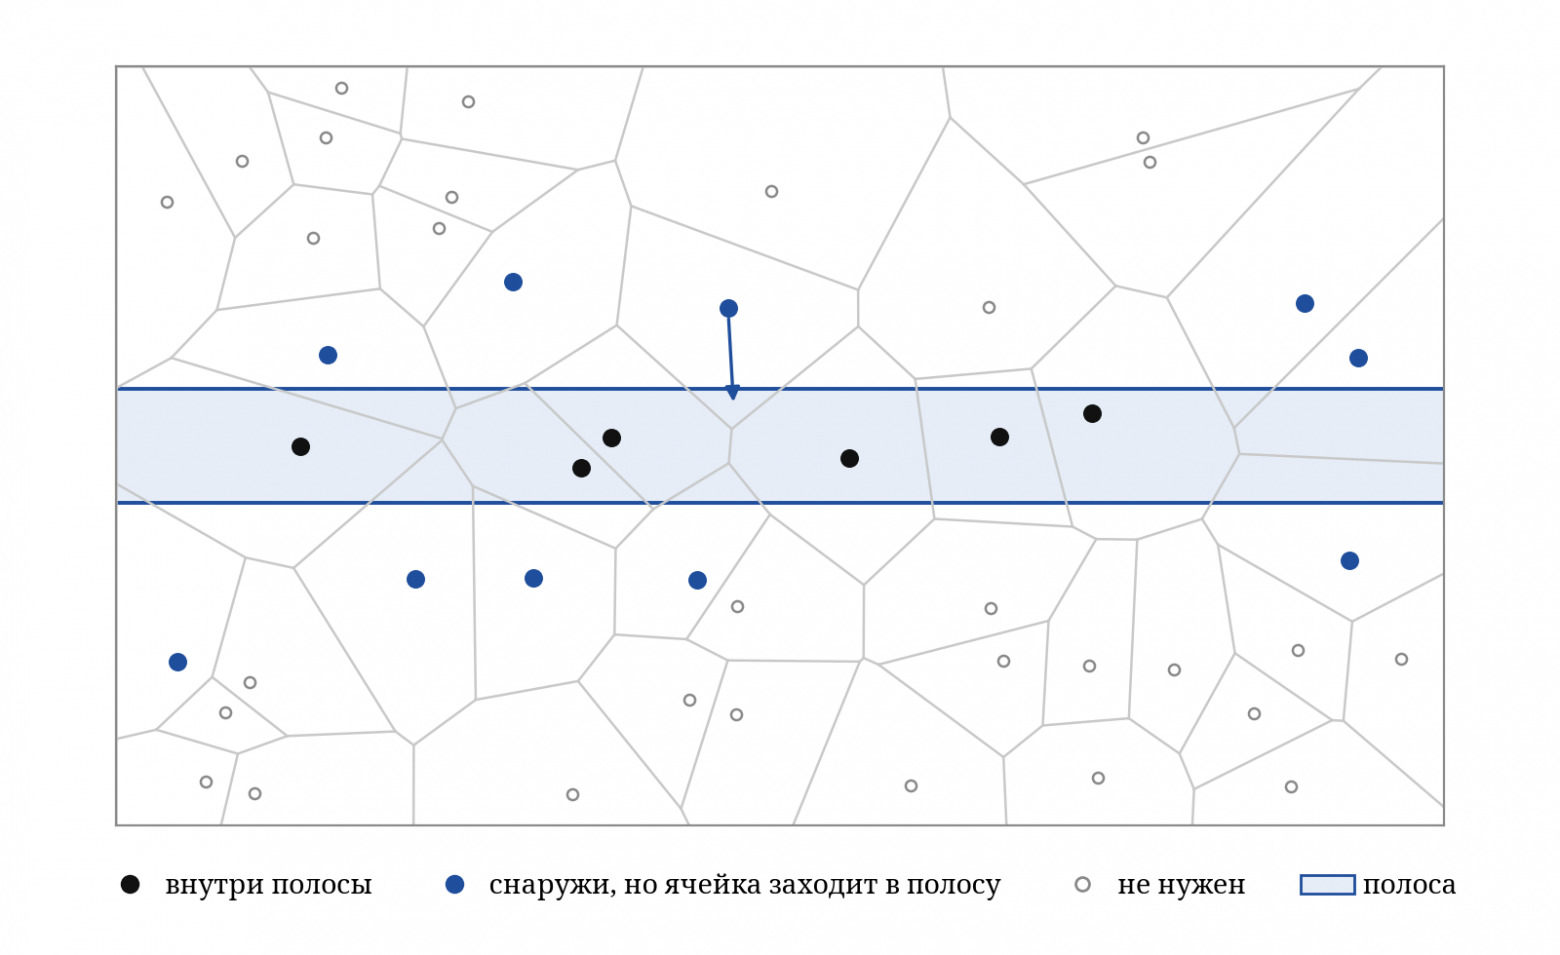
Возьмём горизонтальную полосу карты и пункт, который лежит снаружи неё, но чья ячейка всё-таки заходит внутрь. Отрезок от пункта до любой такой точки целиком лежит в ячейке, потому что она выпуклая, и при этом обязательно пересекает границу полосы. Значит, на границе полосы этот пункт тоже где-то оказывается ближайшим.
Отсюда вывод: кандидатами для полосы могут быть только пункты внутри неё плюс те, что появляются на непрерывных нижних огибающих её верхней и нижней границы, а всех остальных можно выкинуть, и это доказано. Касание ровно в одной точке я специально сохраняю, чтобы не потерять граничный случай. Кандидатов стало 172 834 вместо 265 061, а время упало со 137 до 110 мс.
Потом я повторил то же самое уже внутри полосы, на подполосах из 14, 10 и 6 строк. Без граничных строк это  , то есть ровно пачки по четыре строки, что как раз подходит под SIMD, о котором чуть ниже. Время 88 → 71 мс.
Четыре строки разом
В 128-битный регистр Эльбруса влезает четыре 32-битных числа, а для соседних строк вычисление вертикального минимума одинаковое. Поэтому через qpsubw, qpmullw и qpminuw я считал вертикальные составляющие сразу для четырёх строк, а дальше строил четыре независимые огибающие. Пробовал и восемь, и тридцать две строки, но выходило медленнее: опять не хватало регистров. Кстати, это те самые 128-битные операции, которые в первой задаче сделали только хуже (как подсказали в комментариях к первой части, 128-битного popcount у Эльбруса просто нет, и счёт битов всё равно приходилось дробить), а здесь, где нужны только вычитание, умножение и минимум, они наконец пригодились.
Профайлер против тестирующей системы
Под самый конец у меня было две версии. Мой профайлер говорил, что новая быстрее (48,6 против 51,1 мс на основном счёте), а тестирующая система упорно показывала, что быстрее старая. Отправил я в итоге старую. В моменте было обидно, но в конечном счёте считает именно тестирующая система, а не мой профайлер. Правильность я, как обычно, проверял перебором на 300 маленьких случайных картах, и все 5773 числа совпали.
Версия | Время | Идея |
|---|---|---|
V1 | 444 мс | огибающая без хранения карты, суммы формулами |
V2 | ~187 мс | пространственный индекс, точное отсечение |
V3 | ~137 мс | балансировка потоков, SIMD на 4 строки |
V5 | ~110 мс | фильтр Вороного по границам полосы |
V7 | ~88 мс | дешёвая подготовка индекса |
V8 | ~70 мс | иерархия подполос 14/10/6, быстрый парсер |
V10 | 70–75 мс | лучше по профайлеру, хуже на тестирующей системе, не отправлен |
С 444 до 70 мс, то есть в 6,3 раза, и это мой самый большой выигрыш за всё соревнование. Итоговое решение лежит на GitFlic в файле task3.c.
В третьей, заключительной части будет финал: бот, который бежит по лабиринту наперегонки с соперником, туман, зеркальная карта и то, почему двенадцать потоков оказались быстрее тридцати.